staging.inyokaproject.org

20. Juni 2018

Elasticsearch in Nextcloud 13 einbinden

Suchfunktionen im Allgemeinen sind manchmal mehr Schmerz als Hilfe (siehe Microsofts Bing 🤷‍♂️). Oft findet man Dinge die man sucht nicht, oder aber Dinge, die man gar nicht gesucht hat.
Wer viele Dateien in seiner Nextcloud nutzt, kann natürlich auch schnell den Überblick verlieren.

Mit Elasticsearch gibt es eine mächtige und trotzdem sehr schnelle auf Java basierende Suche, die sich mittels Erweiterungen auch in Nextcloud integrieren lässt.

Elasticsearch installieren

Elasticsearch benötigt zum ausführen eine Java-Umgebung. Folgende Anleitung beschreibt wie die Installation unter Debian aussieht.
Dort lässt sich ohne weiteres hinzufügen von Repositorys das OpenJDK installieren.

apt-get install openjdk-8-jre

Ein ausführen von java -version sollte anschließend wie folgt aussehen:

root@hive:/# java -version
openjdk version "1.8.0_171"
OpenJDK Runtime Environment (build 1.8.0_171-8u171-b11-1~deb9u1-b11)
OpenJDK 64-Bit Server VM (build 25.171-b11, mixed mode)

Anschließend richten wir das Repository für Elasticsearch ein und installieren die Suche. Dies geschieht mittels folgenden Befehlen.

wget -qO - https://artifacts.elastic.co/GPG-KEY-elasticsearch | apt-key add -
apt-get install apt-transport-https
echo "deb https://artifacts.elastic.co/packages/6.x/apt stable main" | tee -a /etc/apt/sources.list.d/elastic-6.x.list
apt-get update && sudo apt-get install elasticsearch

systemctl enable elasticsearch
systemctl start elasticsearch

Sofern die Installation von Elasticsearch erfolgreich war, sollte ein curl -X GET "localhost:9200/" nun folgendes ausgeben:

root@hive:/# curl -X GET "localhost:9200/"
{
  "name" : "fhCp22D",
  "cluster_name" : "elasticsearch",
  "cluster_uuid" : "LVEyx6SIREq5FPX1ee5TgA",
  "version" : {
    "number" : "6.3.0",
    "build_flavor" : "default",
    "build_type" : "deb",
    "build_hash" : "424e937",
    "build_date" : "2018-06-11T23:38:03.357887Z",
    "build_snapshot" : false,
    "lucene_version" : "7.3.1",
    "minimum_wire_compatibility_version" : "5.6.0",
    "minimum_index_compatibility_version" : "5.0.0"
  },
  "tagline" : "You Know, for Search"
}

Damit auch PDF, XML und weitere Dateien indexiert werden können, muss noch ein Plugin für Elasticsearch installiert werden:

/usr/share/elasticsearch/bin/elasticsearch-plugin install ingest-attachment

Öffnet nun die Konfiguration von Elasticsearch unter /etc/elasticsearch/elasticsearch.yml und setzt die Variable network.host auf 127.0.0.1

Anschließend Elasticsearch einmal neustarten und mittels netstat prüfen, ob Elasticsearch und Java auf den Ports 9200 und 9300 lauschen.

Nextcloud konfigurieren

Widmen wir uns nun der Nextcloud. Wir benötigen drei Erweiterungen aus dem Appstore.

Elasticsearch in Nextcloud 13 einbinden

Installiert werden müssen die folgenden drei:

Nach Aktivierung, wechselt in den Einstellungen in den Bereich der Volltextsuche.
Als Search Plattform wählt ihr Elasticsearch aus, die Address of the Servlet lautet http://localhost:9200/ und den Index könnt ihr frei benennen. Bei mehreren Nextcloud-Instanzen macht ein eindeutiger Index natürlich deutlich Sinn, bei mir lautet dieser beispielsweise nc_cloud1.

Abschließend muss die Indexierung einmalig mittels occ gestartet werden:

./occ fulltextsearch:index

Zudem ist es erforderlich, dass nach einer Aktualisierung der Erweiterung der Index einmal zurückgesetzt und neu indexiert wird:

./occ fulltextsearch:reset
./occ fulltextsearch:index
Elasticsearch in Nextcloud 13 einbinden

Suchfunktionen im Allgemeinen sind manchmal mehr Schmerz als Hilfe (siehe Microsofts Bing 🤷‍♂️). Oft findet man Dinge die man sucht nicht, oder aber Dinge, die man gar nicht gesucht hat.
Wer viele Dateien in seiner Nextcloud nutzt, kann natürlich auch schnell den Überblick verlieren.

Mit Elasticsearch gibt es eine mächtige und trotzdem sehr schnelle auf Java basierende Suche, die sich mittels Erweiterungen auch in Nextcloud integrieren lässt.

Elasticsearch installieren

Elasticsearch benötigt zum ausführen eine Java-Umgebung. Folgende Anleitung beschreibt wie die Installation unter Debian aussieht.
Dort lässt sich ohne weiteres hinzufügen von Repositorys das OpenJDK installieren.

apt-get install openjdk-8-jre

Ein ausführen von java -version sollte anschließend wie folgt aussehen:

root@hive:/# java -version
openjdk version "1.8.0_171"
OpenJDK Runtime Environment (build 1.8.0_171-8u171-b11-1~deb9u1-b11)
OpenJDK 64-Bit Server VM (build 25.171-b11, mixed mode)

Anschließend richten wir das Repository für Elasticsearch ein und installieren die Suche. Dies geschieht mittels folgenden Befehlen.

wget -qO - https://artifacts.elastic.co/GPG-KEY-elasticsearch | apt-key add -
apt-get install apt-transport-https
echo "deb https://artifacts.elastic.co/packages/6.x/apt stable main" | tee -a /etc/apt/sources.list.d/elastic-6.x.list
apt-get update && sudo apt-get install elasticsearch

systemctl enable elasticsearch
systemctl start elasticsearch

Sofern die Installation von Elasticsearch erfolgreich war, sollte ein curl -X GET "localhost:9200/" nun folgendes ausgeben:

root@hive:/# curl -X GET "localhost:9200/"
{
  "name" : "fhCp22D",
  "cluster_name" : "elasticsearch",
  "cluster_uuid" : "LVEyx6SIREq5FPX1ee5TgA",
  "version" : {
    "number" : "6.3.0",
    "build_flavor" : "default",
    "build_type" : "deb",
    "build_hash" : "424e937",
    "build_date" : "2018-06-11T23:38:03.357887Z",
    "build_snapshot" : false,
    "lucene_version" : "7.3.1",
    "minimum_wire_compatibility_version" : "5.6.0",
    "minimum_index_compatibility_version" : "5.0.0"
  },
  "tagline" : "You Know, for Search"
}

Damit auch PDF, XML und weitere Dateien indexiert werden können, muss noch ein Plugin für Elasticsearch installiert werden:

/usr/share/elasticsearch/bin/elasticsearch-plugin install ingest-attachment

Öffnet nun die Konfiguration von Elasticsearch unter /etc/elasticsearch/elasticsearch.yml und setzt die Variable network.host auf 127.0.0.1

Anschließend Elasticsearch einmal neustarten und mittels netstat prüfen, ob Elasticsearch und Java auf den Ports 9200 und 9300 lauschen.

Nextcloud konfigurieren

Widmen wir uns nun der Nextcloud. Wir benötigen drei Erweiterungen aus dem Appstore.

Elasticsearch in Nextcloud 13 einbinden

Installiert werden müssen die folgenden drei:

Nach Aktivierung, wechselt in den Einstellungen in den Bereich der Volltextsuche.
Als Search Plattform wählt ihr Elasticsearch aus, die Address of the Servlet lautet http://localhost:9200/ und den Index könnt ihr frei benennen. Bei mehreren Nextcloud-Instanzen macht ein eindeutiger Index natürlich deutlich Sinn, bei mir lautet dieser beispielsweise nc_cloud1.

Abschließend muss die Indexierung einmalig mittels occ gestartet werden:

./occ fulltextsearch:index

Zudem ist es erforderlich, dass nach einer Aktualisierung der Erweiterung der Index einmal zurückgesetzt und neu indexiert wird:

./occ fulltextsearch:reset
./occ fulltextsearch:index

19. Juni 2018

Mozilla hat die geplanten Termine für die Veröffentlichung der Firefox-Versionen des kommenden Jahres 2019 festgelegt. Damit wurde auch der Lebenszyklus von Firefox ESR 60 festgesetzt.

Neue Major-Versionen von Firefox erscheinen in unregelmäßigen, aber geplanten Abständen. Für das aktuelle Jahr 2018 bedeutet dies neue Firefox-Versionen alle sieben bis zehn Wochen. Die Release-Termine für das Jahr 2018 lassen sich hier nachlesen. Nun stehen auch die Release-Termine für das kommende Jahr 2019 fest. Für notwendige Verschiebungen bleibt Mozilla natürlich weiterhin flexibel.

Firefox Release-Termine 2019

Firefox 65
29. Januar 2019 (7 Wochen nach Firefox 64)

Firefox 66
19. März 2019 (7 Wochen nach Firefox 65)

Firefox 67
14. Mai 2019 (8 Wochen nach Firefox 66)

Firefox 68, neue Basis für Firefox ESR
9. Juli 2019 (8 Wochen nach Firefox 67)

Firefox 69
3. September 2019 (8 Wochen nach Firefox 68)

Firefox 70
22. Oktober 2019 (7 Wochen nach Firefox 69)

Firefox 71
10. Dezember 2019 (7 Wochen nach Firefox 70)

Firefox ESR 60 bekommt längere Lebensdauer

Mit Firefox 10 hat Mozilla parallel zur Mainstream-Version von Firefox eine Version mit Langzeitunterstützung eingeführt, auch Firefox ESR genannt. Bislang wurde eine ESR-Version immer sieben Major-Releases später abgelöst, d.h. nach Firefox ESR 10 kam Firefox ESR 17 mit neuen Features, dann Firefox ESR 24 usw. Eine Ausnahme gab es nach Firefox ESR 52: diese Version wurde nicht etwa durch eine Version Firefox ESR 59 abgelöst, sondern erst acht Major-Releases später durch Firefox ESR 60, um die neue ESR-Version mit der neuen Enterprise Policy Engine für Unternehmen ausliefern zu können.

Nun hätte man erwarten können, dass Mozilla zu den sieben Major-Releases zurückkehrt und auf Firefox ESR 60 die Version Firefox ESR 67 folgen lassen wird. Mozilla behält jedoch die acht Major-Releases bei und wird Firefox ESR 60 erst durch Firefox ESR 68 ablösen. Einschließlich der zwei Versionen Überlappung, die es bei jedem ESR-Wechsel gibt, wird Firefox ESR 60 damit bis zum 23. Oktober 2019 und dem Erscheinen von Firefox 70 sowie Firefox ESR 68.2 unterstützt.

Der Beitrag Firefox: Release-Termine 2019, längere ESR 60-Lebensdauer erschien zuerst auf soeren-hentzschel.at.

17. Juni 2018

Die Gerüchteküche brodelt derzeit aufgrund einer Vortragsbeschreibung im Rahmen eines halbjährlichen Zusammenkommens der Mozilla-Mitarbeiter aus aller Welt: arbeitet Mozilla unter dem Projektnamen Scout an einem Browser, der sich nur mit Sprache bedienen lässt?

Alle sechs Monate kommen die Mitarbeiter von Mozilla aus der ganzen Welt für mehrere Tage zu einem sogenannten All Hands-Meeting zusammen. Beim All Hands in der vergangenen Woche wurde intern ein Projekt vorgestellt, dessen öffentliche Beschreibung Raum zur Spekulation bietet.

Dort ist von einer „Scout“-App die Rede, welche das Browsing und das Konsumieren von Inhalten über die Stimme ermöglichen soll. Eingeleitet wird die Beschreibung mit folgender Frage, welche an die Alexas und Siris dieser Welt erinnert: „Hey Scout, lies mir den Artikel über Polarbären vor“. In dem Vortrag sollte es darum gehen, die Architektur und Schlüsselkomponenten zu diskutieren, welche für eine solche Sprachplattform benötigt werden.

Dass Sprachsteuerung für Mozilla ein Thema ist, das ist bereits bekannt. Mit Deep Speech arbeitet Mozilla an einer Open Source Sprache-zu-Text-Engine, vor wenigen Tagen hat man Common Voice in weiteren Sprachen gestartet, unter anderem Deutsch. Mit Common Voice versucht Mozilla, im Bereich der Sprachdatenbanken eine freie Alternative zu kommerziellen Anbietern wie Amazon und Google zu etablieren, damit Sprachsteuerung für jeden zugänglich und nicht den großen Anbietern vorbehalten ist.

Insofern erscheint es alles andere als abwegig, dass Mozilla an einem Produkt mit Spracherkennung arbeitet. Produkte wie Firefox Klar als spezialisierter Privatsphäre-Browser, Firefox Rocket als Browser, der speziell für den indonesischen Markt konzipiert ist, oder Firefox Reality als kommender VR-Browser zeigen außerdem, dass Mozilla mobil eine Mehr-Produkt-Strategie verfolgt und nicht nur mit Firefox als Browser für alle Zwecke plant.

In jedem Fall befindet sich ein solches Produkt wie „Scout“, wenn es denn in Arbeit ist, noch in einer ganz frühen Phase. Dementsprechend liegen auch noch keine weiteren Informationen darüber vor – auch ob es überhaupt Marktreife erreichen wird. Mozilla experimentiert häufiger mit Ideen, unter anderem im letzten Jahr mit Prox, einer App zum Entdecken neuer Orte und Events in der Nähe. Die Arbeiten daran wurden zwischenzeitlich eingestellt.

Der Beitrag Scout: Arbeitet Mozilla an einem Browser mit Sprachsteuerung? erschien zuerst auf soeren-hentzschel.at.

Wie heise online in diesem Bericht verkündet, will das Land Schleswig-Holstein die Abhängigkeit von Microsoft-Produkten verringern und die Verwaltung zukünftig komplett auf freie Software umrüsten.

Mir persönlich gefällt an dem Antrag der Fraktionen von
CDU, Bündnis`90/Die Grünen und FDP, dass diesmal nicht die Kostenreduzierung als oberstes Ziel formuliert wurde. Denn dass man mit freier Software durch den Wegfall von Lizenzgebühren IT-Kosten drastisch senken kann, ist ein häufiger Irrglaube.

Statt dessen formuliert der Antrag eindeutig die Absicht, die Abhängigkeit zu einzelnen Herstellern und deren Lizenzmodellen soweit wie möglich zu reduzieren. Dabei handelt es sich jedoch nicht um eine Umstellung um jeden Preis. Es soll nun nicht damit begonnen werden, alle etablierten Verfahren ohne besonderen Anlass auf freie Software umzustellen. Jedoch soll dies stets dann geprüft werden, wenn Neubeschaffungen anstehen, oder wesentliche Änderungen an bestehenden Verfahren/Programmen vorgenommen werden müssen.

Damit die Anwender nicht (wie so oft) auf der Strecke bleiben, sollen diese laut Antrag von Beginn an mit einbezogen werden. Frühzeitige Anwenderschulungen und eine Kommunikation von Sinn und Zweck einer Umstellung sollen die Akzeptanz bei den Mitarbeitern und Mitarbeiterinnen fördern.

Für mich klingt dieser Antrag durchdacht und schlüssig. Mir gefällt daran besonders, dass er die Punkte in den Mittelpunkt stellt, an denen bereits viele Open Source Projekte gescheitert sind. Dies sind in meinen Augen:

  • Keine Umstellung um jeden Preis, sondern sukzessive dort, wo dies sinnvoll und nachhaltig erscheint
  • Einbeziehung und Schulung der Mitarbeiterinnen und Mitarbeiter von Beginn an
  • Kein Versprechen, das mit einer Umstellung eine drastische Kostenreduzierung einhergeht

Ob es wirklich so kommt, bleibt natürlich abzuwarten. Es besteht jedoch Hoffnung, dass hier mit Verstand und Augenmaß gehandelt wird und freie Software Schritt für Schritt Einzug in die Verwaltung des Landes Schleswig-Holstein erhält. Auf jeden Fall klingt es nach einem spannenden Unterfangen, welches sich im Auge zu behalten lohnt.

Die leicht erregbare Internetöffentlichkeit hat mal wieder ihr nächstes Thema gefunden: Auch Linux ist böse! Konkret geht es um die Erhebung von Telemetriedaten durch Ubuntu seit Version 18.04 und - wie nun bekannt wurde - auch openSUSE. Bei genauerer Betrachtung sieht man, dass das gar kein Problem ist. Aber was nützen schon Fakten und Recherche, wenn paranoide Wutkommentatoren in die Tasten hauen.

Zu den Fakten: Ubuntu hat im Verlauf der Entwicklung von 18.04 beschlossen, dass man ein System einführen möchte, über das einige Telemetriedaten gesammelt werden können. Bei Installation und Upgrade wird der Anwender gefragt, ob er dieser Datensammlung zustimmt. Sofern der Anwender zustimmt, erhebt Ubuntu folgende Daten:

  • Ubuntu-Version
  • OEM/Manufacturer
  • Device model number
  • BIOS Info
  • CPU Details
  • GPU Details
  • Arbeitsspeicher
  • Partitionierungsinformationen
  • Displaydetails
  • Auto-login
  • Live Patching Status
  • Desktopumgebung
  • Displayserver
  • Zeitzone

Siehe dazu auch entsprechenden Bericht auf OMG!Ubuntu.

Passend zur Veröffentlichung von openSUSE Leap 15 kam nun heraus: Auch openSUSE sammelt Daten. Das kommt jetzt nicht sonderlich überraschend, da bekannte Vorträge zu openSUSE in Zahlen (Beispiel 2016) logischerweise eine Grundlage haben mussten. Dazu vergibt openSUSE eine eindeutige System-ID (UUID), die im Verzeichnis /var/lib/zypp gespeichert ist. Hinzu kommen Informationen über die bei der Basisinstallation gewählten Pakete, die Installationsmethode (z. B. FTP) und die gewählte Locale (z. B. de-DE).

Die openSUSE Entwickler können dadurch nachvollziehen, wie viele Benutzer Systemaktualisierungen von einer Version auf die nächste machen und wie viele aktive Installationen es gibt, auch getrennt nach Leap und Tumbleweed.

Eine ausgewogene Analyse kann man beispielsweise in diesem Youtube-Video anhören. Relevant ist der Teil bis Minute 8.57.

Der dortigen Bewertung ist wenig hinzuzufügen. Beide Beispiele, openSUSE und Ubuntu, zeigen einfach, dass hier Linux-Distributionen versuchen zu ermitteln, wie relevant sie in welchen Märkten sind. Hinzu kommen einige Hardwaredaten, die durchaus nachvollziehbar wichtig sind. Da geht es immerhin um Fragen, welche Treiber für die Anwender wichtig sind, wie viel Leistung ihre Systeme haben etc. pp.

In beiden Fällen täten die üblichen gleichermaßen ahnungslosen, wie lautstarken Wutkommentatoren gut daran ein bisschen vom Gaspedal zu gehen. Beide Distributionen erheben erst einmal keine personenbezogenen Daten (die IP-Erhebung bei openSUSE ist dafür zu unklar). Grundsätzlich ist es eine Binsenweisheit, dass auch Linux-Systeme Verbindungen nach außen aufnehmen und dabei zwangsläufig Informationen wie die IP-Adresse teilen. Aufnahme zu Updateserver, NTP etc. sind gar nicht anders möglich.

Bei Ubuntu wäre natürlich eine Opt-in Vorauswahl wünschenswert, bei openSUSE überhaupt eine grafische Wahlmöglichkeit für den Anwender. Das sind aber Feinheiten, die schon alleine deshalb irrelevant sind, weil die grafische Wahlmöglichkeit bei Ubuntu die üblichen Wutbürger nicht besänftigt hat.

Außerdem ist nicht jede Datenerhebung von vornherein bösartig. Entwickler brauchen Feedback um sinnvolle, datengestützte Entscheidungen treffen zu können. Problematisch wird es erst, wenn diese Daten zu großen Datenpools verbunden werden (Stichwort Weitergabe an Dritte), die dann umfassende Aussagen über ihre Verursacher zulassen. Beides ist bei den kleinen Linux-Distributoren weder aktuell der Fall, noch unmittelbar zu befürchten.

Mit solchen emotionsgeleiteten Debatten leitet man nur Wasser auf die Mühlen der großen IT-Giganten, die immer behaupten, was sie machen wäre nicht schlimm bzw. würden alle anderen sowieso auch tun. Wenn Microsoft mit Windows 10 viel umfassendere Telemetriedaten erhebt (Stichwort Suchbegriff, Browserverlauf etc. pp.), kann es diese Daten mit vielen anderen Datenquellen (z. B. Skype, Bing) zusammenführen und dies ist daher wesentlich problematischer. Der einordnende Vergleich ist somit notwendig und nicht relativierend.

Ganz im Gegenteil, es wäre wünschenswert, wenn viel mehr Linux-Distributionen das machen. Eventuell würde so manchem Entwickler dann mal klar werden, dass er sein einziger Anwender ist. Aber das nur am Rande.


Bilder: 

Einleitungsbild und Beitragsbild von von geralt via pixabay / Lizenz: CC0 Public Domain

"

14. Juni 2018

Die Klassifizierung Apples Betriebssystems als "Goldener Käfig" ist eine geläufige Formulierung und insbesondere im Linux-Umfeld weit verbreitet. Apples macOS wird als unfreies System dargestellt, das aber durch seine schöne Optik und reibungslose Funktionsweise dem Anwender Freiheit suggeriert. Dem gegenüber ist Linux vermeintlich wirklich frei.

Entgegen landläufiger Meinungen ist dieses Bild älter als das iPhone-Betriebssystem iOS und kommt noch aus der klassischen Mac OS X-Zeit. Den ältesten Verweis auf diese Darstellung konnte ich bisher in einem Vortrag von James Bottomley auf dem Linux Kongress 2008 finden. Pro-Linux berichtete damals:

"An dieser Stelle gab Bottomley eine Gefängnis-Analogie der Betriebssysteme wieder. Bei Microsoft-Systemen sind die Benutzer in einem Gefängnis eingesperrt, und diese Tatsache ist für alle Insassen offensichtlich. Bei Apples Mac OS X sind die Benutzer ebenso weggesperrt, das Gefängnis ist aber so luxuriös, dass man nicht merkt, dass man gefangen ist. Bei freien Systemen hingegen gibt es keine Gefängnisse, und das System lässt sich in jeder Hinsicht anpassen und ändern."

Quelle: Pro-Linux - Der Wert von Open Source

Vermutlich lassen sich noch deutlich ältere Passagen dieser Art finden. Gerne wird dieses Bild zudem ergänzt mit dem Verweis, dass Apples Produkte gut funktionieren, so lange man im Apple-Ökosystem bleibt, aber sobald man es verlässt, funktioniert es nicht mehr. Der Käfig ist halt nur so lange luxuriös, bis man versucht auszubrechen.

Doch warum soll dem so sein?

macOS vs. Linux 

Schnittstellen

MacOS unterstützt standardmäßig sehr viele Protokolle und Schnittstellen zum Informations- und Datenaustausch. PIM-Informationen kann man für die hauseigenene Programme Mail, Kalender und Kontakte über die folgenden Protokolle abgleichen:

  • Apple
  • MS Exchange
  • IMAP/POP
  • CalDAV
  • CardDAV
  • LDAP

Sowie zusätzlich eine Reihe von sozialen Netzwerken, was aber laut jüngsten Presseberichten mit der kommenden Version macOS 10.14 eingeschränkt wird und daher hier nicht berücksichtigt werden soll. MacOS unterstützt damit alle verbreiteten proprietären und freien Protokolle.

Ein ähnliches Bild gibt es beim Dateiaustausch. Neben den abgekündigten Protokollen wie AFS (Apple File System) unterstützt das System standardmäßig folgende Protokolle:

  • SMB/CIFS
  • WebDAV
  • NFS
  • FTP (lesend)

Zusammengefasst ist es somit einfach möglich macOS in ein heterogenes Umfeld einzubinden und Datei- und PIM-Daten zu synchronisieren. Einen Vor- oder Nachteil gegenüber Linux gibt es nicht.

Programme und Dateien

Neben den macOS-Basisprogrammen liefert das Betriebssystem von Haus aus ein umfangreiches BSD-Basissystem aus. Bekannte Editoren wie nano oder vim stehen ebenso zur Verfügung wie SSH, die Bash und zig weitere Lösungen. Mittels bekannter Lösungen wie Homebrew oder MacPorts lässt sich dieses Repertoire beliebig ergänzen.

Die meisten bekannten Open Source Programme wie Firefox, Thunderbird, GIMP, LibreOffice etc. pp. gibt es selbstredend auch für macOS. Allerdings auch proprietäre Alternativen, sowie bekannte Standardsoftware wie Microsoft Office oder die Adobe Suite.

Gegenwärtig ist es auch immer noch möglich und mitunter erforderlich Programme mittels einer herkömmlichen Installationsroutine zu installieren. Sicherheitsfunktionen wie eine Signaturprüfung sind zwar von Haus aus aktiv, lassen sich aber abschalten. Man kommt sogar gänzlich ohne App Store und Apple ID aus.

Linux-Distributionen schränken ihre Programmauswahl ebenfalls ein. Problemlos lassen sich lediglich die Inhalte der Paketquellen installieren, ansonsten ist man auf passende Fremdquellen angewiesen. Proprietäre Drittprogramme sind nur in geringer Anzahl verfügbar und liegen teilweise nicht für jede Distribution vor. Jedoch meist in den beiden verbreiteten Formaten DEB und RPM.

Beide Systeme setzen in hohem Maße auf standardisierte Dateiformate. Proprietäres Vendor-LockIn gibt es eigentlich nur bei der iWork-Suite, dessen Dateiformate durch kein Drittprogramm unterstützt wird. 

Sowohl Linux, als auch macOS schneiden oft alte Zöpfe ab, weshalb Programme meist nicht zuverlässig über viele Versionen hinweg funktionieren, ohne das Anpassungen vorgenommen werden. Die Freiheit wirklich alte Programme zu nutzen haben Anwender also meist nur unter Windows.

Eingriffe in das System

Apple beschränkt den Zugriff auf das Basissystem durch eine Integritätsprüfung (SIP). Das ist durchaus sinnvoll, da hierdurch ungewollte Veränderungen durch z. B. Schadprogramme verhindert werden. Diese lässt sich aber abschalten und anschließend hat man alle gewohnten Freiheiten und kann bei Bedarf sein System sogar irreparabel beschädigen.

Im Gegensatz zu Linux sind zentrale Bestandteile wie das Initsystem, der Desktop und ähnliches bei macOS nicht austauschbar. Hier ist bei Linux - abgesehen vom Desktop - aber auch viel Illusion. Wenn man mal einen Blick über den Tellerrand zu FreeBSD wirft (siehe: FreeBSD 11 mit Plasma 5 installieren) merkt man, wie homogen die zahllosen Linux-Distributionen eigentlich sind. In den letzten Jahren haben sich um Linux-Umfeld immer mehr zentrale Bestandteile entwickelt, die sich nicht mehr ohne weiteres austauschen lassen oder deren Entfernung zumindest erhebliche Folgen hat. Beispiele hierfür sind systemd, udev und PolicyKit.

Peripherie-Schnittstellen

Einen regelmäßigen Aufschrei lösen die Veränderungen an den Hardware-Schnittstellen aus. Zuletzt der USB-C Anschluss in der jüngsten MacBook Pro-Serie. Diese Brüche sind für Anwender nervig, weil sie Adapter oder neue Peripherie erforderlich machen. Bis auf wenige Alleingänge wie beispielsweise Lightning sind das aber standardisierte Lösungen oder zumindest mit etablierten Standards kompatible Verfahren wie z. B. Thunderbolt.

Apple schreitet hier schneller voran als andere Hersteller, möglicherweise weil die Kundschaft treuer ist oder weil man weniger Kompromisse beim Design machen möchte. Die meisten radikalen Brüche bei den Schnittstellen haben aber die anderen Hardwarehersteller mit etwas zeitlichem Abstand ebenfalls vollzogen.

Propietär vs. Open Source

Die Lizenzfrage ist der Klassiker im Vergleich. Linux-Distributionen bestehen in der Regel fast nur aus quelloffener Software. Ausnahmen sind meist nur Firmware-Pakete und individuell zusätzlich installierte proprietäre Programme. MacOS ist eine Mischung aus proprietären und quelloffenen Bestandteilen. Der Betriebssystemkern Darwin ist quelloffen aber nicht eigenständig lauffähig. Das Userland stammt von FreeBSD und unterliegt den dortigen Lizenzen.

Die FSF nimmt für die GPL zwar in Anspruch Freiheit zu schützen, die GPL wird aber im Gegenzug zur MIT-Lizenz oder BSD-Lizenz nicht unter den freizügigen Lizenzen geführt. Es ist also ein sehr eingeschränkter Freiheitsbegriff, der hier zu Grunde liegt.

Zusammengefasst

MacOS ist in einigen Bereichen standardmäßig restriktiv, aber lässt erfahrenen Benutzern auch sehr viele Freiheiten. Es ist nicht so modular aufgebaut wie die meisten Linux-Distributionen, was einige Einschränkungen mit sich bringt. Linux ist hier durch vielfältige Interdependenzen aber auch nicht mehr so flexibel, wie noch vor einigen Jahren.

Bei den Schnittstellen zum Informations- und Datenaustausch gibt es es kaum Unterschiede, weshalb es vollkommen problemlos möglich ist von einem System zum anderen zu wechseln oder beide gleichzeitig zu nutzen. Beide Systeme setzen in hohem Maße auf standardisierte Dateiformate. Insellösungen sind einfach nicht mehr zeitgemäß.

Große Teile von macOS sind propietäre Software und nicht einsehbar, das schränkt die Freiheit theoretisch ein. Faktisch ist die GPL aber auch keine freiheitliche Lizenz. Die Freiheitlichkeit wird hier oft mit der Freiheit den Code zu lesen, zu verändern und weiterzugeben gleichgesetzt. Ein Privileg, das die meisten Anwender mangels entsprechender Kenntnisse faktisch nicht haben dürften.

Wenn macOS also der goldene Käfig ist, dann ist Linux der GPL-Käfig.

Wirklich geschlossen sind hingegen die Mobilsysteme und hier allen voran iOS, wobei viele Hardwarehersteller von Android-Smartphones momentan einige Anstrengung unternehmen um dieses Ideal auch zu erreichen.


Bilder:

Beitragsbild Käfig: Bild von Gellinger via pixabay / Lizenz: CC0 Creative Commons

Einleitungsbild Waage: Bild von Mediamodifier via pixabay / Lizenz: CC0 Creative Commons

"

13. Juni 2018

Das Adventure Layers of Fear ist z.Z. kostenlos bei Steam erhältlich. Linux und ein Steam-Account sind nötig, um das Spiel zu installieren. Das Spiel bleibt dauerhaft im Account.

Wikipedia schreibt:

Die Entwickler beschreiben das Horrorspiel als „psychedelische Reise in eine bröckelnde Psyche, die von den tragischen Ereignissen der Vergangenheit zerrissen wurde“. Als Spieler steuert man einen allmählich dem Wahnsinn verfallenden Künstler aus der Egoperspektive durch ein großes Herrenhaus, erkundet „die Trümmer eines einst beneidenswerten Lebens“ und ergründet die tragische Familiengeschichte, „die der wahnhafte Perfektionsdrang des Künstlers nach sich gezogen hat“.

Siehe auch: https://store.steampowered.com/news/41044/, https://store.steampowered.com/app/391720/

Vor gut 90 Tagen schrieb ich bereits über die neue Funktion der Wildcard-Zertifikat bei Let’s Encrypt. Nun steht – wie auch bisher – der renew an.

Hier nur zwei Anmerkungen: wer die Prozedur zur Erstellung genau nach meiner Anleitung durchgeführt hat, wird (wie ich vor einigen Wochen) merken, dass der Renew nicht geht. Grund: ein renew kann nur durchgeführt werden, wenn das Verfahren unattended läuft – und das ist bei manueller Erstellung nicht möglich. Es gibt aber zwei Lösungen:

Lösung 1: nochmal das exakt gleiche Kommando ausführen. Überraschend: so wie ich das probiert habe, verzichtet certbot auf ein -0001-Verzeichnis. Wäre gut, wenn mir ein Dritter das evtl. bestätigen kann (info@v-gar.de you know :))

Lösung 2: DNS-Plugin einsetzen. Das ist etwas komplizierter und hängt auch wirklich vom Anbieter ab. Kurz zusammengefasst: hiermit ist es möglich, dass die TXT-Records für die Challenge per Provider-API gesetzt werden und der Prozess somit keinem manuellen Eingriff bedarf. Wie genau das funktioniert werde ich evtl. gesondert behandeln. Für den Moment kann ich aber nur einen Verweis auf die Dokumentation geben.

Vor gut 90 Tagen schrieb ich bereits über die neue Funktion der Wildcard-Zertifikat bei Let's Encrypt. Nun steht - wie auch bisher - der renew an.

Hier nur zwei Anmerkungen: wer die Prozedur zur Erstellung genau nach meiner Anleitung durchgeführt hat, wird (wie ich vor einigen Wochen) merken, dass der Renew nicht geht. Grund: ein renew kann nur durchgeführt werden, wenn das Verfahren unattended läuft - und das ist bei manueller Erstellung nicht möglich. Es gibt aber zwei Lösungen:

Lösung 1: nochmal das exakt gleiche Kommando ausführen. Überraschend: so wie ich das probiert habe, verzichtet certbot auf ein -0001-Verzeichnis. Wäre gut, wenn mir ein Dritter das evtl. bestätigen kann (info@v-gar.de you know :))

Lösung 2: DNS-Plugin einsetzen. Das ist etwas komplizierter und hängt auch wirklich vom Anbieter ab. Kurz zusammengefasst: hiermit ist es möglich, dass die TXT-Records für die Challenge per Provider-API gesetzt werden und der Prozess somit keinem manuellen Eingriff bedarf. Wie genau das funktioniert werde ich evtl. gesondert behandeln. Für den Moment kann ich aber nur einen Verweis auf die Dokumentation geben.

12. Juni 2018

Alexa, Siri, Google, Cortana – Spracherkennung ist in aller Munde. Und in den festen Händen kommerzieller Anbieter. Dies macht Mozillas Common Voice-Projekt so wichtig. Mozilla hat Common Voice auf Deutsch gestartet und benötigt nun eure Hilfe, um auch auf Deutsch eine hochwertige Sprachdatenbank für jeden zur Verfügung stellen zu können.

Mozilla Common Voice-Webseite aufrufen

Mozillas Arbeit im Gebiet der Spracherkennung kann neben der Arbeit an Firefox durchaus zu einem der wichtigsten Projekte der Not-for-Profit-Organisation Mozilla gezählt werden. Immer mehr Geräte sind miteinander vernetzt und lassen sich über Sprache steuern. Was vor Jahren noch nach Science Fiction geklungen hätte, ist mittlerweile für immer mehr Menschen Realiät. Der Erfolg eines Gerätes mit Spracherkennung steht und fällt dabei natürlich vor allem mit der Qualität der Spracherkennung.

Der Markt für Spracherkennung wird von den ganz großen Namen kommerzieller Anbieter dominiert: Amazon, Apple, Google, Microsoft. Darum hat Mozilla im vergangenen Jahr das Projekt Common Voice gestartet. Mit Common Voice versucht Mozilla, eine kostenlose Alternative zu etablieren, zu der jeder beitragen kann und die jedem zur Verfügung steht, denn nach Ansicht von Mozilla sollte diese Technologie für jeden zugänglich sein und nicht den großen Anbietern vorbehalten sein. Common Voice ergänzt damit ein weiteres Projekt von Mozilla, nämlich ein Open Source Spracherkennungsmodell, welches unter dem Namen Deep Speech von Mozilla entwickelt wird.

Bislang stand Common Voice nur für englischsprachige Nutzer zur Verfügung. Nun hat Mozilla Common Voice zusätzlich in den Sprachen Deutsch, Französisch und Walisisch gestartet. Dabei wird es nicht bleiben: es sind bereits mehr als 40 weitere Sprachen in Arbeit, die bald starten sollen. Darunter sollen nicht nur am meisten verbreitete Sprachen sein, sondern auch kleinere wie unter anderem Friesisch, welche von den großen kommerziellen Anbietern häufig vernachlässigt werden.

Technik alleine bringt keine gute Spracherkennung, dafür braucht es vor allem eine große Datenmenge an Sprachaufnahmen. Und an dieser Stelle kommt die Community ins Spiel: über die Webseite oder die iOS-App kann jeder helfen, indem er oder sie die Sätze in das Mikrofon seines Computers spricht, oder die Sätze anderer auf Korrektheit überprüft.

Optional kann ein Profil auf der Webseite angelegt werden, um mit Angaben über Akzent, Alter und Geschlecht eine bessere Zuordnung der Sprachaufnahmen zu ermöglichen.

Seit dem Start von Common Voice vor gut einem Jahr wurden bereits mehrere hunderttausend englischsprachige Aufnahmen gesammelt und im November 2017 schließlich eine erste Version des Datensatzes kostenlos bereitgestellt – was zu dem Zeitpunkt bereits den zweigrößten öffentlichen Datensatz für Sprachaufnahmen dargestellt hat. Mozillas Arbeit im Bereich der Spracherkennung wird bereits von Open Source-Projekten wie Kaldi aber auch von kommerziellen Produkten wie Mycroft genutzt.

Mozilla Common Voice-Webseite aufrufen

Der Beitrag Mozilla startet Common Voice auf Deutsch erschien zuerst auf soeren-hentzschel.at.

Einleitungsbild: © Rogatnev / Fotolia.com

Die mediale Aufmerksamkeitsspanne ist kurz, Sicherheitslücken sind langlebig. Die Berichterstattung mag abgeklungen sein, aber EFAIL hat nichts von seiner Brisanz verloren. GnuPG erhält nun allerdings ein Update, womit mittelfristig Besserung in Aussicht steht, da GnuPG als zentrale Instanz in vielen Programme fungiert.

Das Update verschärft die Integritätsprüfung (MDC), die bisher nur optional war. So viel im übrigen zu der Verteidigungslinie, dass es sich lediglich um ein clientseitiges Problem handelt (siehe: Kommentar: EFAIL - Nebelkerzen und was ist eigentliche eine Lücke?).

Sobald alle Clients bzw. Addons für Outlook & Co nachgezogen haben, dürfte die Lücke etwas weniger kritisch sein. Grundsätzlich behoben ist sie jedoch nicht. Weiterhin ist vollkommen unklar, ob der ebenfalls schwer beschädigte S/MIME Standard aktualisiert wird. Dieser ist standardmäßig in quasi allen Mailprogramme enthalten und insbesondere im Businessumfeld verbreitet.

10. Juni 2018

Ehrlich gesagt ist diese Woche (außer der "einschlagenden" ersten Meldung) nicht viel passiert. Trotzdem ein kleiner Überblick:


Ehrlich gesagt ist diese Woche (außer der "einschlagenden" ersten Meldung) nicht viel passiert. Trotzdem ein kleiner Überblick:


9. Juni 2018

Bild von 3dman_eu via pixabay / Lizenz: CC0 Creative Commons

Die beherrschenden Technikthemen unterliegen einem schnellen Wandel. Vor wenigen Jahren war Cloud das alles beherrschende Thema, nun liest man überall von künstlicher Intelligenz. Manche mögen dabei an Roboter und den legendären Terminator denken, aber die Themen sind inzwischen viel greifbarer.

Bei den proprietären Betriebssystemen gewinnen so genannte selbstlernende Systeme immer mehr an Bedeutung. Dabei geht es nicht nur um die smarte Sprachsteuerung durch Siri & Co, sondern auch um maschinelles Lernen. Ganz praktisch kann man das bei Software wie Pixelmator Pro auf macOS betrachten, bei dem das Programm mit der Zeit Motive selbstständig erkennt und in Ebenen einteilt. Andere Funktionen sind die Steuerung per Gesichtserkennung oder auch nur Spielereien wie Animojis. Hinzu kommen eigene Geräteklassen mit smarten Funktionen, oftmals zusammengefasst im Bereich IoT. Der Fantasie sind jedoch fast keine Grenzen gesetzt, die Entwicklung verläuft rasant und lässt sich kaum vorher sagen.

Die Implikationen hinsichtlich des Datenschutzes sind unterschiedlich. Wenn diese Systeme die notwendige Leistung per Cloudanbindung extern auslagert ist das ein erhebliches Problem - nicht zuletzt wegen des quasi unbeschränkten Zugriffs auf die Daten. Noch schlimmer ist das, wenn die Geräte von Firmen kommen, die exzessives Datensammeln zum Geschäftsmodell erhoben haben. Hier dürfte eine Zusammenführung und Auswertung der Daten fest im Geschäftsmodell verankert sein. Manche Firmen wie Apple haben dies erkannt und verlagern deshalb die Verarbeitung zunehmend auf das Gerät und geben sich ein bewusst datenschutz-freundliches Image.

Die ganze Entwicklung passiert jedoch bisher vor allem im Kreis der Anbieter proprietärer Systeme. Manche Firmen positionieren sich datenschutzfreundlicher als andere, aber letztlich müssen wir ihnen immer vertrauen. Viele dieser Geräte lassen nur noch minimale haptische Benutzerinteraktion zu, weshalb man kaum kontrollieren kann, was der kleine Kasten so macht. Das ist bei klassischen Betriebssystemen schon problematisch, aber wenn man bedenkt, in welche Richtung sich smarte Geräte mit KI entwickeln (siehe auch: Kommentar: Der Siegeszug der smarten Lautsprecher) waren die früheren Debatten wie Microsoft vs. Linux harmlos.

Die Open Source-Gemeinschaft konnte bisher mit dieser Entwicklung überhaupt nicht Schritt halten. Schon Spracherkennung wie beispielsweise Simon ist auf dem Linux-Desktop im experimentellen Stadium, von weiterführenden Funktionen ganz zu schweigen.

Sehen wir hier die Grenzen des Open Source Entwicklungsmodells? Open Source hat großartiges hervorgebracht, nicht zuletzt Linux als universales Betriebssystem. Dazu hat man gar nicht so lange gebraucht, bereits um 2006 herum hatte man in vielen Bereichen aufgeholt zur proprietären Konkurrenz. GNU/Linux ist jedoch - abgesehen vom Kernel - vor allem die Komposition vieler kleiner Einzelprojekte mit wenigen Entwicklern. Großprojekte mit zahlreichen Entwicklern sind absolute Mangelware, selbst die großen Desktopprojekte KDE und GNOME sind in Subprojekte gegliedert, die nicht immer reibungslos miteinander interagieren.

Dieses Entwicklungsmodell hat für die Welt klassischer Betriebssysteme mit letztlich doch limitierten Funktionen ausgereicht. Möglicherweise lässt sich mit diesen beschränkten Ressourcen nicht mit dieser Entwicklung Schritt halten. Im mobilen Sektor kann man ähnliche Schwierigkeiten beobachten (siehe: Freie Mobilbetriebssysteme - Ein Trauerspiel). Namhafte Open Source-Player wie beispielsweise Red Hat fokussieren sich zudem inzwischen immer stärker auf den Cloud- und Serverbereich, während die - bisher sichtbaren - Entwicklungen im KI-Sektor eindeutig Consumerbereich verortet sind.

Sofern sich nicht ein Sponsor findet, der entweder die Entwicklung freier Alternativen massiv fördert oder bestehende Entwicklungen öffnet, muss man wohl fürchten, dass hier der Anschluss verloren geht.

Bild von mcmurryjulie via Pixabay / Lizenz: CC0 Creative Commons
Smarte Lautsprecher sind hinsichtlich des Datenschutzes eine unfassbare Katastrophe. Faktisch handelt es sich dabei um eine Wanze, die permanent in den Raum horcht und auf ein Signalwort hin aktiv wird. Bisher gibt es ausschließlich proprietäre Lösungen, weshalb eine transparente Analyse der Funktionen unmöglich ist. Der erzwungene Cloudzugang ist unkontrollierbar.

Hinzu kommt, dass bisher fast alle verbreiteten Lösungen von den größten Datenkraken entwickelt und dann zu Dumpingpreisen auf den Markt geworfen werden - ein Schelm der dahinter anderweitigen Profit vermutet.

Die neuen Lautsprechen waren hier bereits letztes Jahr Thema (siehe: Wanzen für das Wohnzimmer mit Firmen-Branding). Damals konnte man noch hoffen, dass die Geräte sich außerhalb eines kleinen Kreises technischer Enthusiasten nicht verbreiten würden. Die Kampfpreise von Amazon haben jedoch eine erhebliche Verbreitung gefördert und inzwischen integrieren auch immer mehr Anbieter Amazons und Googles Lösungen in ihre Geräte.

Das Ausmaß der Datenschutz-Katastrophe ist eigentlich kaum zu beschreiben. Diese Geräte sind nämlich eigentlich nicht smart, sondern immer noch unfassbar dumm. Das liegt einfach am Stand der KI-Forschung. Kurz gesagt: Fällt das Schlüsselwort, springt das Gerät an. Der Lautsprecher kann nämlich nicht unterscheiden, ob er gemeint ist oder eventuell nur über ihn gesprochen wird. Mal abgesehen davon, dass z. B. Alexa in manchen Ländern auch einfach ein gängiger Vornahme ist.

Hinzu kommt, dass die Geräte scheinbar mit der heißen Nadel entworfen wurden - oder die dahinter stehenden Firmen Datenschutz und -sicherheit keine besondere Priorität beimessen. Anders kann man die nicht abreißenden Meldungen über ungewollte Datenübertragung nicht interpretieren. So versendet Alexa auch mal Privatgespräche oder die Konkurrenzlösung interpretiert das Signalwort sehr weitläufig.

Die obligatorische Cloudanbindung und massenhafte Datenversand an Herstellerserver ist selbstverständlich. Keine der Lösungen besitzt genug Leistung um die notwendigen KI-Vorgänge auf dem Gerät vorzunehmen.

Im Grunde genommen kann man nur fassungslos sein bei diesen Geräten. Wer sich so etwas freiwillig in die Wohnung stellt scheint jeden Bezug zu Datenschutz verloren zu haben. Als Google vor einigen Jahren mit der Google Glass experimentierte, gab es unzählige Debatten, wo man die Brille tragen darf und wo nicht. Manche Betreiber wollten Leute mit der Brille nicht in ihre Cafés und Kneipen lassen.

Im politischen Diskurs bezeichnete man das permanente Überschreiten roter Linien, als kalkulierten Tabubruch. Nichts anderes machen die großen IT-Giganten: Permanente Missachtung des Datenschutzes und unzählige Debatten bis die Öffentlichkeit völlig abgestumpft ist und eine Wanze im Wohnzimmer auch noch als technische Errungenschaft feiert.

"

New Tab Override ist eine Erweiterung zum Ersetzen der Seite, welche beim Öffnen eines neuen Tabs in Firefox erscheint. Die beliebte Erweiterung mit mehr als 140.000 aktiven Nutzern ist nun in Version 13.0 erschienen.

Was ist New Tab Override?

Seit Firefox 41 ist es nicht länger möglich, die Seite anzupassen, welche beim Öffnen eines neuen Tabs erscheint, indem die Einstellung browser.newtab.url über about:config verändert wird. Da diese Einstellung – wie leider viele gute Dinge – in der Vergangenheit von Hijackern missbraucht worden ist, hatte sich Mozilla dazu entschieden, diese Einstellung aus dem Firefox-Core zu entfernen. Glücklicherweise hat Mozilla nicht einfach nur die Einstellung entfernt, sondern gleichzeitig auch eine neue API bereitgestellt, welche es Entwicklern von Add-ons erlaubt, diese Funktionalität in Form eines Add-ons zurück in Firefox zu bringen.

New Tab Override war das erste Add-on, welches diese Möglichkeit zurückgebracht hat, und ist damit das Original. Mittlerweile hat New Tab Override mehr als 140.000 aktive Nutzer, wurde im Dezember 2016 sogar auf dem offiziellen Mozilla-Blog vorgestellt und schon mehrfach im Add-on Manager von Firefox beworben.

Download New Tab Override (WebExtension) für Firefox

Die Neuerungen von New Tab Override 13.0

Eine Änderung in Firefox 60 hat verursacht, dass die Option, eine komplett leere Seite als neuen Tab anzuzeigen, nicht mehr ordnungsgemäß funktioniert hat. Statt einer leeren Adressleiste stand in jedem neuen Tab „about:blank“ in der Adressleiste. Es wurde ein Workaround implementiert, welcher dieses Problem umgeht.

Ein weiteres Problem dieser Option war, dass diese nicht funktioniert hat, wenn das URL-Feld der Option „Benutzerdefinierte Adresse“ nicht leer war. Dies konnte zum Beispiel dann auftreten, wenn der Nutzer zunächst eine benutzerdefinierte URL als neuen Tab ausgewählt hatte und später dann auf „about:blank“ gewechselt ist, ohne das URL Feld vorher zu leeren. Auch dieses Problem wurde behoben.

Neben all den funktionalen Optionen gab es in New Tab Override auch eine Pseudo-Option „Standard-Seite für den neuen Tab“, welche dem Nutzer erklärt hat, dass zur Verwendung dieser Seite die Erweiterung im Add-on Manager deaktiviert werden muss. Diese Pseudo-Option wurde mit dem Update entfernt und Nutzer, welche diese Option ausgewählt hatten, automatisch zu „about:blank“ migriert.

Ein Danke geht nach China an den neuen Contributor tiansh, welcher die Lokalisierungs-Architektur so verbessert hat, dass bessere Übersetzungen in andere Sprachen möglich sind, in denen die Satzstellung von der verwendeten Satzstellung abweicht.

Eben jener tiansh war es auch, der die chinesische Übersetzung wieder zurück nach New Tab Override gebracht hat. Das ist großartig, weil chinesische Nutzer im Ranking der Nutzer von New Tab Override auf Platz 4 stehen. Weitere Dankeschöns gehen an MissingUser für die spanische Übersetzung sowie an Sopor- für die schwedische Übersetzung. Damit steht New Tab Override derzeit in zehn Sprachen zur Verfügung – und weitere werden kommen!

Außerdem wurden mit dem Update wieder sämtliche Abhängigkeiten auf den neuesten Stand gebracht. Neue Mindestanforderung ist Firefox 60, ältere Firefox-Versionen werden von New Tab Override nicht länger unterstützt.

Der Beitrag New Tab Override 13.0 (WebExtension) veröffentlicht erschien zuerst auf soeren-hentzschel.at.

7. Juni 2018

Mozilla hat mit Firefox 60.0.2 ein Update für Firefox 60 veröffentlicht und behebt damit eine Sicherheitslücke sowie mehrere Probleme der Vorgängerversion.

Download Mozilla Firefox 60.0.2 für Microsoft Windows, Apple macOS und Linux

Mit dem Update auf Firefox 60.0.2 behebt Mozilla eine Sicherheitslücke in Zusammenhang mit SVG-Grafiken. Ein Update ist daher bereits alleine aus Gründen der Sicherheit für jeden Nutzer ratsam.

Außerdem behebt Mozilla ein Problem mit der Darstellung von Schrift, welches ausschließlich Nutzer von Apple OS X 10.11 und älteren Versionen betrifft, die außerdem eine Drittanbieter-Software zur Schrift-Verwaltung auf dem Computer installiert haben.

Darüber hinaus wurde ein Fehler in den Entwicklerwerkzeugen behoben, der verursachte, dass unter bestimmten Umständen Elemente, teilweise sogar der komplette Inhalt des body-Elements, im Inspektor fehlen konnten.

Weiter wurde die sporadisch auftretende Fehler-Meldung SSL_RX_MALFORMED_SERVER_HELLO behoben, welche auf Webseiten auftreten konnte, die auf den Sicherheits-Standard TLS 1.3 aktualisiert haben.

Schließlich wurde noch ein Hängenbleiben des Browsers bei Verwendung eines Gerätes zur Zwei-Faktor-Authentifizierung behoben. Dieses Problem betraf ausschließlich Nutzer des Apple-Betriebssystems.

Der Beitrag Mozilla veröffentlicht Sicherheits- und Bugfix-Update Firefox 60.0.2 erschien zuerst auf soeren-hentzschel.at.

6. Juni 2018

CloudPets sind sogenannte smarte Plüschtiere. Das Spielzeug kann Sprachaufnahmen machen und ist mit dem Internet verbunden. Auf Druck von Mozilla haben diverse Online-Händler wie Amazon den Verkauf nun aufgrund von Sicherheits-Defiziten gestoppt.

Die smarten Plüschtiere CloudPets haben bereits in der Vergangenheit negative Schlagzeilen gemacht. So erlangten im Februar 2017 Angreifer Zugriff auf die Datenbank der Herstellerfirma und damit auf E-Mail-Adressen, Passwörter, Profilbilder sowie Sprachaufzeichnungen von Kindern. Betroffen waren damals 800.000 Kunden, sogar Lösegeld-Forderungen gab es in mehreren Fällen.

Die US-Ketten Walmart und Target sowie Amazon haben den Verkauf der CloudPets nun gestoppt, um einer Kampagne von Mozilla zuvorzukommen. Anlass hierfür ist eine Sicherheits-Prüfung, welche Mozilla beim deutschen Sicherheits-Dienstleister Cure53 in Auftrag gegeben hat, mit denen Mozilla häufiger im Rahmen seines Secure Open Source-Programms zusammenarbeitet. Demnach seien Sicherheitslücken, welche dem Hersteller bereits vor mehr als einem Jahr gemeldet worden sind, immer noch vorhanden.

Während Amazon in den USA keine CloudPets-Plüschtiere mehr anbietet, sind diese über die deutsche Amazon-Webseite bislang noch verfügbar. Ob Amazon auch außerhalb der USA reagieren wird, ist bislang unklar.

Der Beitrag Nach Sicherheitsprüfung von Mozilla: Amazon und weitere Händler stoppen Verkauf von CloudPets-Plüschtieren erschien zuerst auf soeren-hentzschel.at.

5. Juni 2018

Unter dem Namen Test Pilot betreibt Mozilla eine Möglichkeit für Firefox-Nutzer, potentielle neue Funktionen vorab zu testen und Feedback zu geben. Mit Firefox Color und Side View hat Mozilla nun zwei neue Experimente gestartet.

Über testpilot.firefox.com können Firefox-Nutzer mögliche Neuerungen vorab testen, indem entsprechende Erweiterungen installiert werden. Ab sofort stehen mit Firefox Color und Side View zwei neue Experimente zum Testen bereit.

Firefox Color

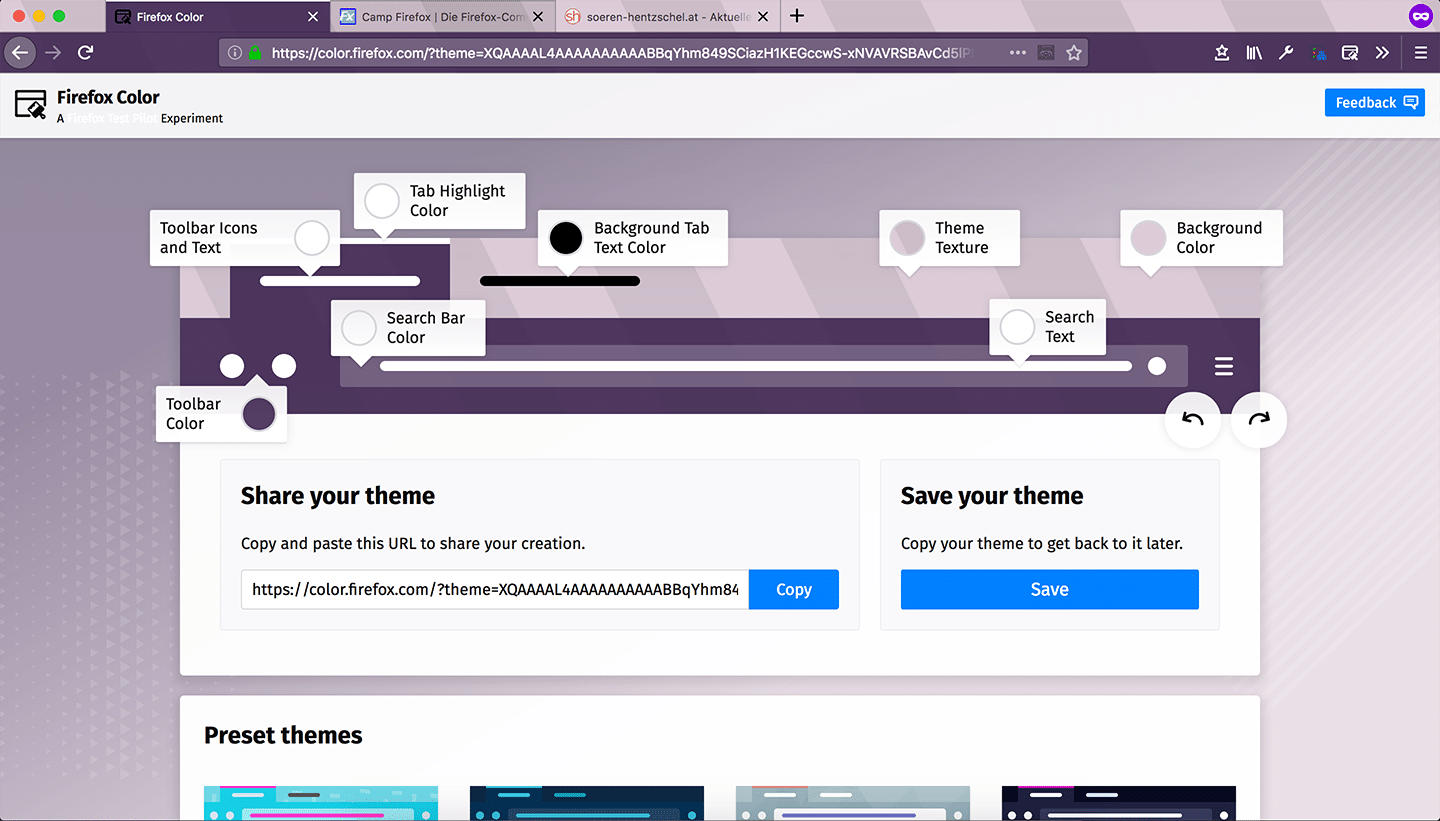
Die Theming-API von Firefox erlaubt optische Anpassungen der Firefox-Oberfläche. Doch was ist noch besser als verfügbare Themes zu durchforsten und sich davon eines auszusuchen? Die Oberfläche von Firefox selbst anzupassen. Das ist mit Mozillas neuem Experiment Firefox Color möglich.

Firefox Color kommt mit 24 vorkonfigurierten Themes, deren Farben und Textur der Anwender ganz einfach und nach Belieben selbst verändern kann.

Praktisch: mit jeder Änderung ändert sich auch die URL. Wer mit seinem Theme zufrieden ist, kann dieses ganz einfach an andere Nutzer weitergeben, indem die URL geteilt wird. Auch können erstellte Themes lokal gespeichert und zu einem späteren Zeitpunkt wieder geladen werden.

Firefox Color

Side View

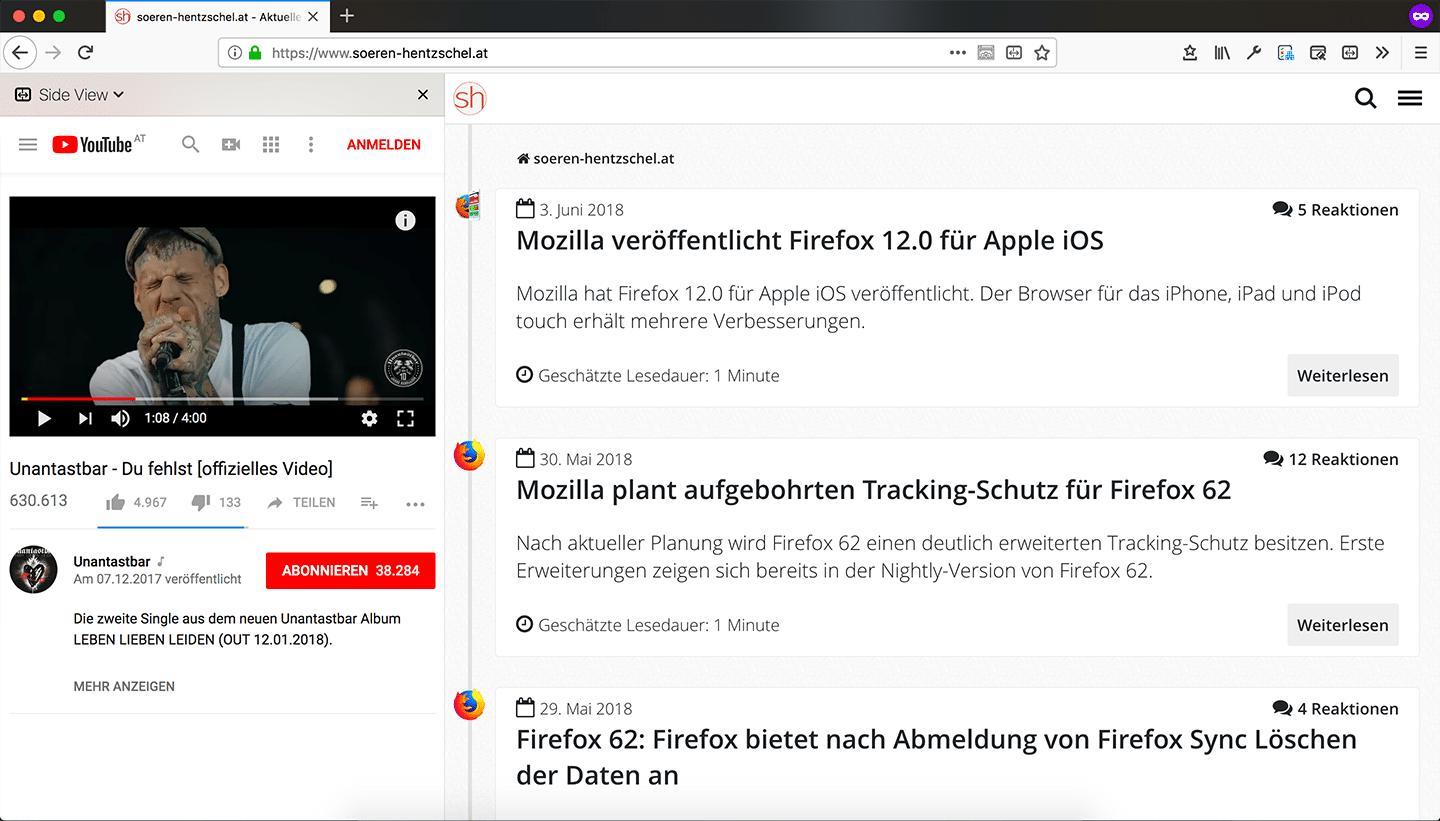
Side View erlaubt das parellele Betrachten einer zweiten Webseite innerhalb der Firefox-Sidebar. Die Seite, welche in der Sidebar geladen werden soll, kann entweder über die Schaltfläche in der Symbolleiste ausgewählt werden oder über einen entsprechenden Kontextmenü-Eintrag eines Links. Standardmäßig wird dabei die mobile Version einer Webseite geladen, sofern vorhanden. Über die Schaltfläche kann allerdings auch die Desktop-Version angefordert werden.

Anwendungsfall für Side View ist das Multitasking. So kann Side View beispielsweise genutzt werden, um seinen Twitter-Feed immer parallel geöffnet zu haben oder Videos zu schauen, während man etwas anderes macht.

Side View

Der Beitrag Test Pilot: Mozilla startet Firefox Color und Side View erschien zuerst auf soeren-hentzschel.at.

Der folgende Artikel wird meine Reihe Grundlagen Server Absicherung um einen weiteren Artikel erweitern. In diesem Artikel werde ich mich auf die Konfiguration von SSH und rkhunter konzentrieren.

SSH

Vorraussetung

Um die SSH Konfiguration umsetzen und nutzen zu können und vor allem damit man weiter Zugriff auf den Server hat, müssen die folgenden Vorraussetzung erst umgetzt werden.

Benutzer anlegen

Auf dem Server legen wir einen Arbeitsnutzer an, wir nennen ihn einfach mal "workuser"

adduser workuser

Vergebt ein sicheres Passwort, der Rest ist egal wie es befüllt wird. Jetzt erzeugen wir auf dem Client einen SSH Key, wenn ihr noch keinen habt.

ssh-keygen -t ed25519

ed25519 ist ein neuer Algorithmus, der sicher ist als der alte RSA Standard. Als nächstes wird der SSH Public Key auf den Server kopiert.

ssh-copy-id workuser@example.org

Mit der Option -i könnt ihr den genauen Schlüssel angeben. Jetzt testen wir die Konfiguration

ssh workuser@example.org

Wenn ihr jetzt nach dem Passwort gefragt werdet, dann stimmt was nicht. Beachtet auch hier könnt ihr mit der Option -i den Key angeben.

SSH Koonfiguration

Den SSH Server konfigurieren wir in der Datei /etc/ssh/sshd_config, dazu löschen wir alle Zeilen raus und fügen die folgende ein:

Protocol 2
Port 3458
LogLevel Verbose

PermitRootLogin no
MaxAuthTries 2
MaxSessions 2
IgnoreRhosts yes

PasswordAuthentication no
PermitEmptyPasswords no
ChallengeResponseAuthentication no

UsePAM yes

AllowAgentForwarding no
AllowTcpForwarding no
X11Forwarding no
PrintMotd no
TCPKeepAlive no
Compression no
ClientAliveCountMax 2
UseDNS no

AcceptEnv LANG LC_*
Subsystem	sftp	/usr/lib/openssh/sftp-server

Die Konfiguration wird von Lynis als "sicher" anerkannt. Was wird genau gemacht? Ich erwähne nur die wichtigsten Punkte.

  • Das Protocol wird auf Version 2 beschränkt

  • Der Standardport wird angepasst

    • Achtung: Der ssh Befehlt sieht jetzt so aus: ssh workuser@example.org -p 3458 bei scp sieht wie folgt aus scp -P 3458 workuser@example.org:/srv/test.html .
  • Root SSH Login wird unterbunden

  • Passwort Login wird unterbunden, nur Key Login möglich

    Mit dieser Konfiguration haben wir ein min. Maß an Sicherheit für unseren SSH Zugriff gewährleistet. Ich habe bewusst dem Nutzer workuser keine sudo Rechte gegeben, so das bei einem unerlaubten Zugriff, der Angreifer keine Adminrechte hat.

rkhunter

rkhunter ist ein Rookit Hunter der nach bekannten Rootkits, Hintertüren und bekannten Exploits auf dem Server sucht. Dazu werden von den wichtigen lokalen Dateien MD5 Hashes angelegt und verglichen.

Installation

Leider gibt es in der aktuellen Debian Version einen Bug, der dazu führt das sich rkhunter nicht updaten lässt. Daher installieren wir das Paket direkt von der Webseite.

Wir laden die aktuelle Version herrunter

wget https://netix.dl.sourceforge.net/project/rkhunter/rkhunter/1.4.6/rkhunter-1.4.6.tar.gz

Entpacken

tar -xvzf rkhunter-1.4.6.tar.gz

Wechselten in den Ordner und führen folgenden Befehl als root aus

./installer.sh --layout /usr/local --install
rkhunter --propupd --update

Jetzt haben wir die aktuelle Version installiert.

Scannen

Mit dem folgenden Befehl führen wir einen Stillen Scan durch, wo nur uns die Fehler angezeigt werden.

rkhunter -c --rwo

Jetzt sollten eine Menge Fehlermeldung ausgegeben werden, das liegt daran dass jede Distribution natürlich ein wenig ihre Datei anpasst. Damit diese Fehler nicht jedesmal angezeigt werde, bzw. uns per Mail zugeschickt werden, werden wir eine Whitelist erstellen. Dazu legen wir die folgenden Datei an, /etc/rkhunter.conf.local und fügenden folgenden Inhalt hinzu

SCRIPTWHITELIST=/usr/sbin/adduser
SCRIPTWHITELIST=/usr/bin/ldd
SCRIPTWHITELIST=/bin/egrep
SCRIPTWHITELIST=/bin/fgrep
SCRIPTWHITELIST=/bin/which

Ein erneuter Scan sollte keine Fehler mehr anzeigen.

Einstellungen

Jetzt werden wir noch die Default Einstellungen von rkhunter bearbeiten, die in der Datei /etc/default/rkhunter sich befinden.

# Defaults for rkhunter automatic tasks
# sourced by /etc/cron.*/rkhunter and /etc/apt/apt.conf.d/90rkhunter
#
# This is a POSIX shell fragment
#

# Set this to yes to enable rkhunter daily runs
# (default: false)
CRON_DAILY_RUN="yes"

# Set this to yes to enable rkhunter weekly database updates
# (default: false)
CRON_DB_UPDATE="yes"

# Set this to yes to enable reports of weekly database updates
# (default: false)
DB_UPDATE_EMAIL="yes"

# Set this to the email address where reports and run output should be sent
# (default: root)
REPORT_EMAIL="info@example.org"

# Set this to yes to enable automatic database updates
# (default: false)
APT_AUTOGEN="yes"

# Nicenesses range from -20 (most favorable scheduling) to 19 (least favorable)
# (default: 0)
NICE="0"

# Should daily check be run when running on battery
# powermgmt-base is required to detect if running on battery or on AC power
# (default: false)
RUN_CHECK_ON_BATTERY="false"

Die oben stehende Konfiguration ist schon angepasst, ihr könnt diese kopieren müsst nur noch die REPORT_EMAIL anpassen. Jetzt wird die Datenbank automatisch geupdatet und wir werden automatisch darüber benachrichtigt.

Cronjob

Als letztes legen wir noch einen Cronjob an, damit alles funktioniert /etc/crontab:

10 3    * * *   root    /usr/bin/rkhunter --cronjob 

Lynis

Als letztes führen wird jetzt nochmal den Lynis check aus

lynis audit system

Der Hardening Index sollte jetzt deutlich besser sein.

4. Juni 2018

Kurz angemerkt: es wurde schon am Wochenende gemunkelt, jetzt ist es in trockenen Tüchern: der US-Softwarekonzern kauft GitHub, einen bekannten Anbieter für das Hosting von Code-Repositories mittels Git-SCM, für sage und schreibe 7,5 Milliarden US-Dollar. Starkes Stück.

Über GitHub werden viele Open Source-Projekte gehostet, zumal die zugrunde liegende Software Git als Open Source-Software für die Entwicklung des Linux-Kernels entwickelt wurde. GitHub hat seit längerem eine ähnliche Bedeutung wie Sourceforge.net bisher.

GitHub soll unabhängig weiterarbeiten, so der Blogbeitrag vom Portal zu dem Thema. Neuer GitHub-CEO wird Nat Friedman, Xamarin-Gründer (bekannt für Mono).

Wer mehr dazu lesen möchte: GitHub Blog, Microsoft Blog, Heise online

Für meinen Websever nutze ich ein kleines Backupscript was ich euch hier mal zeigen möchte. Da ich meinen Server bei Servercow habe, bekomme ich kostenlos 150GB einer Sambafreigabe zur Verfügung gestellt, wo ich meine Backups auslagere.

Hier mal das Script

#!/bin/bash

date=$(date +%Y%m%H%M)

cd /opt/backup/

###
# delete all files older than 10 days
###

delete_files() {
    find /backups/KS1/* -mtime +10 -exec rm {} \;
    return 0
}

###
# Backup important files
###
do_backup() {
    tar -cvzf tmp/gitRepoBackup.tar.gz /srv/git/
    tar -cvzf tmp/sitesBackup.tar.gz /var/www/html/
    tar -cvzf tmp/etcBackup.tar.gz /etc/

    ###
    # do prosody backup
    ###

    /usr/sbin/service prosody stop
    tar -cvzf tmp/prosodyBackup.tar.gz /var/lib/prosody/
    /usr/sbin/service prosody start
    
    ###
    # Create main archive
    ###

    tar -cvzf /backups/KS1/KS1-Backup-$date.tar.gz tmp/*

    ###
    # Remove all old files
    ###
    rm -rf tmp/*

    return 0
}
###
# Mail admin about backupsystem
###

report() {
    [ "$1" = "ok" ] && /usr/sbin/ssmtp -t < mail/mail.eml
    [ "$1" != "ok" ] && echo $1 >> mail/errmail.eml && /usr/sbin/ssmtp -t < mail/errmail.eml
    return 0
}

###
# do backup
###

delete_files && do_backup && report ok || report err
  1. Löschen aller Backups älter als 10 Tage
  2. Dann tar ich alle Dateien aus den wichtigen Ordner in einem tmp Ordner
  3. Dann werden die einzelnen tars in einem Gesamtarchiv zusammen gefasst
  4. Wenn alles gut war eine Mail als Erfolgsmeldung an mich
  5. Wenn nicht Fehlermeldung an mich

Ordnerstruktur

mkdir -p backup/{tmp,mail}

In dem Ordner mail, sind zwei Dateien enthalten:

cat errmail.eml

From: KS1 Server < root@example.org >
To: info@example.org
Subject: !!! BACKUP ERROR !!!
MIME-Version: 1.0

cat mail.eml

From: KS1 Server < root@example.org >
To: info@example.org
Subject: Server Backup Done
MIME-Version: 1.0

The backup system has done his work.
All files have successfully backuped

Das Script direkt in den Backup Ordnerlegen. Dann noch ein kleiner Cronjob:

 0 */4 * * * /bin/bash /opt/backup/backup.sh

Jetzt wird alle 4 Stunden ein Backup gemacht.