staging.inyokaproject.org

9. Februar 2018

Diese Frage wurde bereits von Scott in seinem englischsprachigen Blog beantwortet. Ich gebe sie an dieser Stelle wieder, um nicht immer wieder danach suchen zu müssen.

Das Kommando lautet:

tcpdump -c 20 -s 0 -i eth1 -A host 192.168.1.1 and tcp port http

Die Parameter bedeuten:

  • -c 20: Beendet den Vorgang, nachdem 20 Pakete aufgezeichnet wurden.
  • -s 0: Die mitgeschnittenen Nutzdaten sollen ungekürzt wiedergegeben werden.
  • -i eth1: Zeichne nur Pakete an der Netzwerkschnittstelle eth1 auf.
  • -A: Gebe alle Pakete in ASCII aus.
  • host 192.168.1.1: Zeichne nur Pakete auf, die von Host 192.168.1.1 kommen.
  • and tcp port http: Zeichne nur HTTP-Pakete auf.

Ergänzt man den Befehl noch um -w DATEINAME wird die Aufzeichnung in eine Datei statt auf die Standardausgabe geschrieben.

Wer häufiger mit Git arbeitet und dort auf Merge-Konflikte stößt, hat bei größeren Konflikten keinen sonderlich großen Spaß diese aufzulösen. Häufig bietet es sich dabei an, ein Mergetool zu verwenden, der einem die Arbeit erleichtern soll. Einige Mergetools existieren für die Kommandozeile, andere auch als grafische Tools.

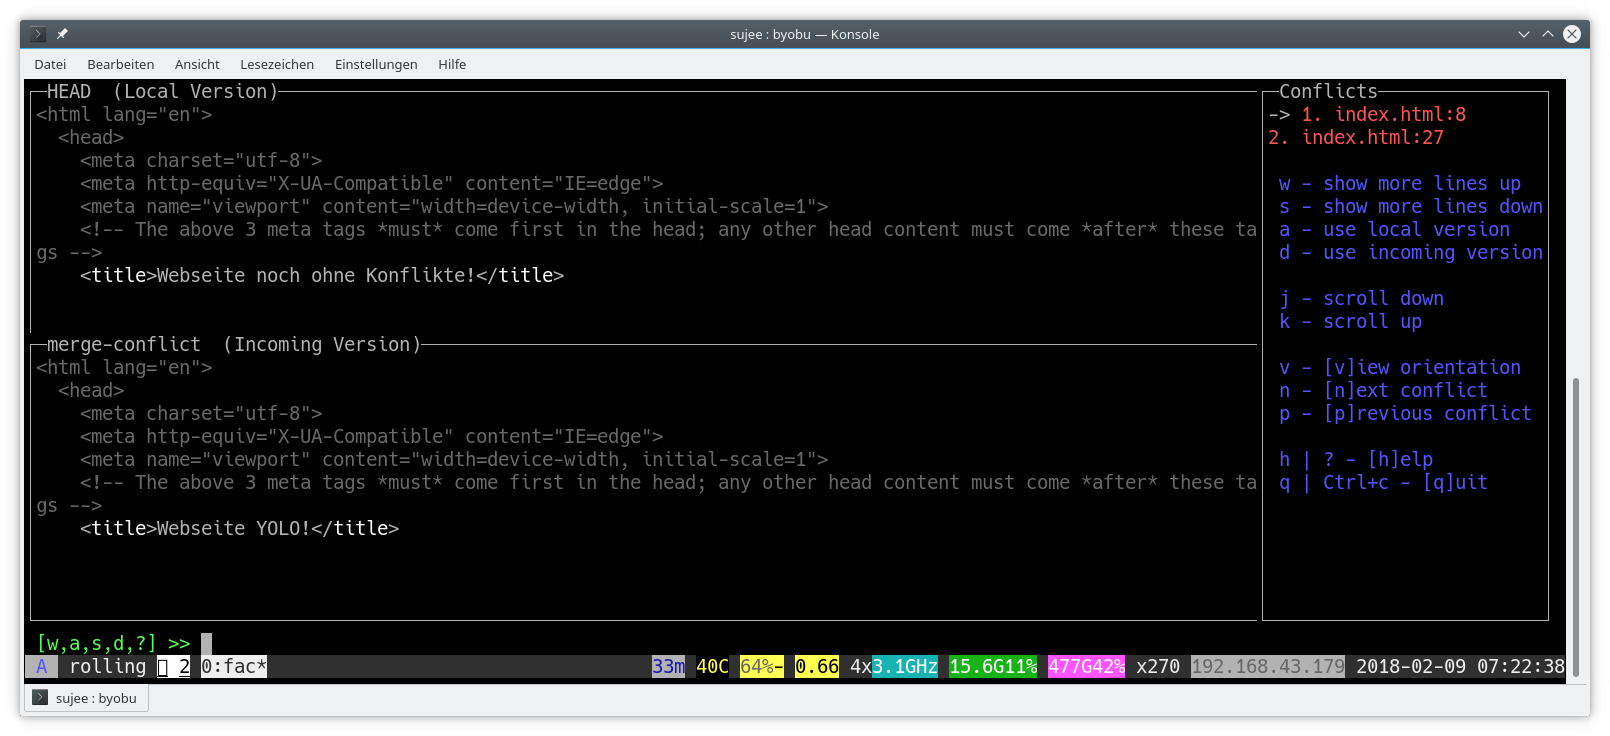
Kürzlich bin ich auf das kleine Tool „fac“ gestoßen, was kurz für „Fix All Commits“ steht. „fac“ ist ein in Go geschriebenes CUI, also ein Commandline User Interface, um Merge-Konflikte aufzulösen.

Das Schöne daran ist die einfache Nutzung und die übersichtliche Darstellung im Terminal, der zunächst erstmal nur die benötigten und relevanten Zeilen anzeigt. Zusätzliche Zeilen lassen sich allerdings mit wenigen Tastendrücken anzeigen.

Aussehen tut dies etwa so:

„fac“ ist in Go geschrieben und kann über go auch heruntergeladen werden:

$ go get github.com/mkchoi212/fac

Die Binärdatei liegt anschließend unter ~/go/bin/fac. Den Pfad sollte man dann entweder zu seiner $PATH Variable hinzufügen oder direkt aufrufen. Leider gibt es noch keine Unterstützung als Git Mergetool. Dazu existiert aber ein Issue.

Natürlich gibt es auch andere Mergetools, die man verwenden kann. Mir gefällt in diesem Fall die einfache Benutzung und die geringe Einstiegshürde, die das Tool mit sich bringt. Verbesserungspotenzial ist da natürlich auch da, da eine schönere Diff-Ansicht des Konfliktes begrüßenswert wäre.

Wer häufiger mit Git arbeitet und dort auf Merge-Konflikte stößt, hat bei größeren Konflikten keinen sonderlich großen Spaß diese aufzulösen. Häufig bietet es sich dabei an, ein Mergetool zu verwenden, der einem die Arbeit erleichtern soll. Einige Mergetools existieren für die Kommandozeile, andere auch als grafische Tools.

Kürzlich bin ich auf das kleine Tool „fac“ gestoßen, was kurz für „Fix All Commits“ steht. „fac“ ist ein in Go geschriebenes CUI, also ein Commandline User Interface, um Merge-Konflikte aufzulösen.

Das Schöne daran ist die einfache Nutzung und die übersichtliche Darstellung im Terminal, der zunächst erstmal nur die benötigten und relevanten Zeilen anzeigt. Zusätzliche Zeilen lassen sich allerdings mit wenigen Tastendrücken anzeigen.

Aussehen tut dies etwa so:

Git Merge fac

„fac“ ist in Go geschrieben und kann über go auch heruntergeladen werden:

$ go get github.com/mkchoi212/fac

Die Binärdatei liegt anschließend unter ~/go/bin/fac. Den Pfad sollte man dann entweder zu seiner $PATH Variable hinzufügen oder direkt aufrufen. Leider gibt es noch keine Unterstützung als Git Mergetool. Dazu existiert aber ein Issue.

Natürlich gibt es auch andere Mergetools, die man verwenden kann. Mir gefällt in diesem Fall die einfache Benutzung und die geringe Einstiegshürde, die das Tool mit sich bringt. Verbesserungspotenzial ist da natürlich auch da, da eine schönere Diff-Ansicht des Konfliktes begrüßenswert wäre.

7. Februar 2018

Nach längerer Zeit folgt an dieser Stelle mal wieder eine Buchrezension. In diesem Artikel wird das Buch „Machine Learning mit Python“ mit dem Untertitel „Das Praxis-Handbuch für Data Science, Predictive Analytics und Deep Learning“ vom Autor Sebastian Raschka besprochen. Erschienen ist das Buch beim mitp Verlag. Zu dem handelt es sich bei diesem Buch um eine Übersetzung aus dem Englischen.

Hinweis: Der mitp Verlag stellte mir für die Rezension ein Rezensionsexemplar frei zur Verfügung. Das Buch erschien in der deutschen Übersetzung bereits am 30. November 2016, am 22. Dezember 2017 folgt dann schon die zweite Auflage, in dem der Fokus um TensorFlow erweitert wurde. Diese Rezension richtet sich explizit auf die erste Auflage des Buches. Genannte Kritik-Punkte können durchaus korrigiert bzw. verbessert worden sein.

Was steht drin?

Das Buch unterteilt sich in 13 Kapiteln, die insgesamt 424 Seiten umfassen. Das Buch beginnt zunächst mit einem in das maschinelle Lernen, dabei wird auf die drei verschiedenen Arten eingegangen und beispielhaft erläutert, sowie in die Notation und Terminologie in dem Fachbereich eingegangen. Im zweiten Kapitel folgt direkt schon die erste Übung, in der ein Lernalgorithmus programmiert und erläutert wird, der für die Klassifizierung trainiert wird. Weiter geht es im dritten Kapitel über die Verwendung von scikit-learn, welches die Bibliothek ist, die in diesem Buch verwendet wird, um Machine Learning Algorithmen zu implementieren. Die ersten Kapitel setzten noch auf vorgefertigte Datensätze, die man nicht selbst ermitteln musste. In Kapitel 4 und 5 geht es daher um die Datenvorverarbeitung und die Datenkomprimierung, damit man das in den selbst geschriebenen Klassifizierern verwenden kann.

Je weiter man in dem Buch liest, desto tiefer gehen auch die Themen, so werden in den darauf folgenden Kapiteln Hyperparameter-Abstimmung und die Kombination verschiedener Modelle thematisiert. Das achte Kapitel führt wiederum in das Thema des Natural Language Processings ein, wo erklärt wird, wie man Stimmungsanalysen ableiten kann.

Das Buch führt aber auch in die Praxis ein, denn die bisherigen Kapitel erläuterten nur an Hand von Skripten, die bei jedem Lauf von vorne aus den Daten gelernt haben. Im neunten Kapitel wird exemplarisch gezeigt, wie man eine Web-Anwendung implementieren kann, welches die zuvor implementierten Algorithmen nutzt und während der Nutzung auch weiter lernt und anwendet. Die übrigen Kapitel umfassen weiterhin eine Regressionsanalyse, Clusteranalyse, die Verwendung neuronale Netze zur Bildererkennung, sowie neuronale Netze mit der Bibliothek Theano.

Kritik

Das Buch ist sehr umfangreich und bietet sehr viele Informationen zu dem doch großen Bereich des Machine Learnings. Der größte Kritik-Punkt meinerseits ist, dass es nicht wirklich einsteigerfreundlich ist. Für viele Themen sind zwar Beschreibungen und Erklärungen da, allerdings sind diese zumeist relativ knapp und nicht immer ganz nachvollziehbar. Das Buch ist zwar schon relativ umfangreich, doch könnte dies einen Tick umfangreicher sein, um vor allem Einsteiger abzuholen. In dem Fall müssen für einige Themenbereiche nämlich noch zusätzliche Quellen bezogen werden, um auch die Gedankengänge der Umsetzung besser nachvollziehen zu können. Auch Erfahrung im Umgang mit Python ist sehr vorteilhaft. Wer keine Erfahrung in beiden Gebieten mitbringt, wird mit dem Buch eher nicht glücklich.

Hier sollte man allerdings noch beachten, dass die zweite Auflage erschienen ist, die nicht nur scikit-learn verwendet, sondern auch tiefer in die populäre Bibliothek TensorFlow einführt. Das Buch ist in der zweiten Auflage somit auch noch umfassender geworden.

Unabhängig davon gilt es hervorzuheben, dass das Buch für die Zielgruppe von Personen mit Erfahrung mit Python und den Grundzügen von Machine Learning sehr viele Informationen und praxisrelevante Informationen vermittelt. Dass es eine Übersetzung aus dem Englischen ist, merkt man dem Buch nicht an. Man sieht auch sehr deutlich, dass der Autor viele Kenntnisse und Erfahrung in dem Bereich hat, da er an vielen Stellen auf mögliche Probleme eingeht und passende Lösungen parat hat.

Buchinfo:

Titel: Machine Learning mit Python

Autor: Sebastian Raschka

Verlag: mitp

Umfang: 424 Seiten

ISBN: 3958454224

Preis: 49,99€

Hier gehts zur zweiten Auflage!

6. Februar 2018

Seit längerem bin ich auf der Suche nach einem guten Desktop-Client, der sowohl Twitter als auch die freie alternative GnuSocial möglichst umfänglich unterstützt. Leider gibt es da kaum Lösungen für. Auf meinem Android-Smartphone bin ich mit Twidere sehr zufrieden. Da lag die Idee nahe zu versuchen Twidere auf meinem Desktop zu benutzen.

Dank ChromeOS ist es seit längerem mit dem Chrome-Browser möglich Android-Apps auf fast allen Plattformen im „Testmodus“ auszuführen. Genau hier setzen die beiden Erweiterungen ARChon Runtime und ARC Welder an, die diesen Prozess sehr vereinfachen. Zunächst müsst ihr allerding den Chrome Webbrowser auf eurem System installieren. Ubuntuusers hält hier wie für so viele Programme im Wiki eine ausführliche Anleitung bereit.

Wenn ihr Chrome bei euch installiert habt, dann könnt ihr zunächst der Anleitung von tricksuniversity folgen. Ich zähle hier nur die entsprechenden Schritte auf. Die Details findet ihr in der mit Screenshots ausgestatteten detaillierten Anleitung.

  1. Chrome öffnen
  2. ARChon Runtime downloaden
  3. ARChon Zip-File entpacken
  4. Erweiterungs-Seite (chrome://extensions/) in Chrome aufrufen
  5. Entwicklermodus aktivieren
  6. Entpackte Erweiterung laden…
  7. den eben entpackten ARChon-Ordner wählen
  8. ARC Welder installieren
  9. ARC Welder starten

Hier verlassen wir die Anleitung zunächst für einen kurzen Hinweis: Beim ersten Start von ARC Welder bittet euch die Anwendung um einen Ort mit Lese- und Schreibzugriff. Hier solltet ihr einen Pfad wählen, der keine Sonderzeichen (Umlaute, Leerzeichen, Punkte) enthält. Letzteres ließ mich mehrmals ins Stocken kommen. Am besten legt ihr euch einen Unterordner arc in eurem home-Verzeichnis an (also ~/arc bzw /home/user/arc).

Abschließend müsst ihr euch noch das APK von Twidere besorgen. Ihr findet das unter den Releases auf der GitHub-Seite des Projektes. Speichert diese auf eurem Rechner und folgt den letzten Punkten der Anleitung von tricksuniversity.

Über das +-Zeichen fügt ihr die APK hinzu und wählt die Einstellung entsprechend eurer Bedürfnisse. Bei mir haben die vorgeschlagenen Standard-Einstellungen auf Anhieb funktioniert. Nun startet Twidere in einem neuen Fenster und ihr könnt es mit euren Accounts verknüpfen. Die Bedienung mit der Maus ist manchmal etwas unintuitiv, da die App für Finger-Wisch-Bedienung und nicht für die Maus entwickelt wurde. Mit etwas Gewöhnung gelingt die Bedienung allerdings immer leichter.

Im Maximierten Modus (Fenster Bildschirm-füllend) ist es manchmal schwer die Kanten gut zu treffen. Ich benutze Twidere deswegen nie ganz Maximiert. Das erleichert das Interagieren mit den Schaltflächen durchaus. Leider wird das Tastatur-Schema eurer Ubuntu-Installation nicht automatisch erkannt und verwendet. Statt dessen wird von einem US-Layout ausgegangen. Das ist etwas umständlich. Bisher habe ich hierfür noch keine Lösung gefunden.

5. Februar 2018

Gestern habe ich im Wochenrückblick Thomas Leisters aktuelle Mailserveranleitung angesprochen. Heute habe ich für euch zu dieser Anleitung eine kleine Ergänzung, die aus einem Spezialfall entstand.

Mein Mailserver verfügt nicht nur über eine, sondern über zwei IPv4-Adressen. Dadurch kann ich die erste Adresse fürs Management nutzen und die andere für die Kommunikation zwischen Mailservern und -clients. Im DNS ist als MX-Record ausschließlich die Mail-IP gesetzt. Das ist durchaus sinnvoll (Firewall, Flexibilität,…), führt aber insbesondere beim empfohlenen Einsatz des Sender Policy Frameworks zu einem Problem, da Postfix zwar auf der richtigen Mail-IP lauscht, aber möglicherweise über die Management-IP Mails verschickt. Als Folge failt der SPF-Check und die Mail wird entsprechend behandelt.

Nun kann man die Management-IP als erlaubte Adresse im SPF-TXT-Record setzen, so richtig schön ist das aber nicht.

Die Lösung sind die Optionen smtp_bind_address (IPv4) und smtp_bind_address6 (IPv6). In der main.cf gesetzt führen Sie dazu, dass Postfix zum Versenden diese Adressen nutzt und der SPF-Check erfolgreich verläuft.

Für IPv6 mag das sogar noch interessanter sein, da viele Provider dem Server einen /64er-Block zur Verfügung stellen und mit der Option Mails auf einer Adresse abgefertigt werden können.

Zwei Jahre sind seit dem letzten Release vergangen. Letztes Wochenende fand ich nun endlich die Zeit, mich wieder mit dem Projekt Raspi-SHT21 zu befassen. Herausgekommen ist die BETA der Version 2.

Alle Informationen zur neuen Version gibt es in den Versionsinformationen auf GitHub und in der README-Datei des Projekts.

Bei mir daheim läuft die neue Version bisher stabil. Da ausführliche Tests fehlen, habe ich sie als BETA markiert. Falls ihr Fehler findet, Fragen habt oder der Meinung seid, dass noch etwas fehlt (Code, Doku, Spendenbutton), eröffnet bitte einen GitHub-Issue oder hinterlasst mir hier einen Kommentar.

In Zukunft soll das Projekt um Remote-Messstationen erweitert werden. Der Raspberry Pi dient dabei als Zentrale zur Speicherung und Visualisierung der Messdaten. Diese werden zukünftig nicht mehr nur ausschließlich vom direkt angeschlossenen SHT21-Sensor geliefert, sondern auch von weiteren Sensoren, die ihre Daten per WLAN übertragen. Sobald es etwas zu zeigen gibt, werde ich in diesem Blog darüber berichten.

Verwandte Artikel

  1. Überwachung von Temperatur und Luftfeuchtigkeit mit dem SHT21
  2. Visualisierung von Umweltdaten

Foto: © pico / Fotolia.com

E-Mail Verschlüsselung ist nach wie vor ein sehr problematischer Bereich. Gegenwärtig sind fast alle mobilen Messenger sicherer als die herkömmliche E-Mail - selbst wenn der Besitzer des Messengers Facebook, Apple oder Microsoft heißt. Die technischen Grundlagen zur Mailverschlüsselung sind über 20 Jahre alt, nur durchsetzen konnte sie sich nie. Hinzu kommt die Konkurrenz von S/MIME und PGP, wodurch Interessenten zwei unterschiedliche Systeme parallel betreiben müssen.

S/MIME und PGP sind älter als die Konkurrenz zwischen Linux und Windows und beide sind standardisiert. OpenPGP nutzt das in PGP 5 standardisierte Format, festgelegt in RFC 4880. S/MIME ist in RFC 2633 spezifiziert. Neben technischen Unterschieden ist das größte Unterscheidungsmerkmal das Schlüsselsystem. PGP basiert auf einem "Web of Trust" genannten Verfahren, bei dem vertrauenswürdige Dritte Schlüssel zertifizieren können. S/MIME basiert hingegen auf einem hierarchischen Zertifikatssystem, wie man es - etwas simplifiziert ausgedrückt - auch von den TLS-Zertifikaten (HTTPS) kennt.

Interessanterweise wird dieser Dualismus primär durch die Open Source Gemeinschaft am Leben erhalten. Normalerweise ist es eben jene Gemeinschaft, die Sonderwege proprietärer Hersteller ablehnt und auf freien Formaten beharrt (siehe z.B. die Kontroverse um OASIS und OOXML). Bei S/MIME vs. PGP muss man aber eigentlich konstatieren, dass ersteres sich längst flächendeckend durchgesetzt hat. Alle verbreiteten Betriebssysteme (Windows, macOS, Linux, iOS, Android) und alle großen Mailclients (Outlook, Apple Mail, Thunderbird, Evolution, KMail) haben S/MIME implementiert. PGP ist hingegen nur bei Linux vorinstalliert und noch nicht einmal Thunderbird unterstützt dies ohne Addon.

Maßgeblich liegt dies an der Ablehnung der Zertifikatshierarchie durch die Open Source-Gemeinschaft. Das "Web of Trust"-Verfahren passt hier halt deutlich mehr zum Gemeinschaftsgedanken. Technisch gesehen sind beide Verfahren sicher und die verbreitete Implementierung von S/MIME zeigt, dass es hier auch keine proprietären Hürden gibt oder das Protokoll zu schwer umzusetzen ist.

Dieser Sonderweg der Open Source Gemeinschaft könnte man als bedeutungslos abtun. Durch die starke Vernetzung von Datenschutz-Aktivisten und Open Source-Gemeinschaft basieren Empfehlungen zur E-Mail Verschlüsselung jedoch fast immer auf PGP - ein System, das nirgendwo vorinstalliert ist. Dies erhöht massiv die Einstiegsschwelle in das Thema Mailverschlüsselung. Ein Bereich, der durch komplexe Verfahren mit öffentlichen und privaten Zertifikaten, sowie viel manueller Tätigkeit beim Austausch, sowieso nicht leicht zu durchdringen ist.

Die große Hürde beim S/MIME Zertifikatssystem sind die, für Außenstehende, undurchsichtigen Zertifizierungsstellen und vielfältigen, teils kostenpflichtigen, Angeboten. Let'S Encrypt hat im TLS-Bereich jedoch gezeigt, dass man eine zuverlässige, transparente und kostenlose Zertifizierungsstelle erschaffen kann, die sich sehr schnell durchsetzt. Was es braucht ist ein ähnliches System für S/MIME - und die Unterstützung durch die Open Source-Gemeinschaft, die ihr gescheitertes GnuPG endlich aufgeben muss.

4. Februar 2018

Die Themen der Woche vom 29. Januar bis 04. Februar 2018, diesmal im Schnelldurchlauf.

Wochengeschehen

Top-Thema: LibreOffice 6.0

Gut zwei Jahre ist letzte Major-Release von LibreOffice her. Am 31. Januar 2018 hat The Document Foundation nun die Version 6.0 der freien Bürosuite veröffentlicht. LibreOffice entstand 2011 aus einem Fork von OpenOffice und wurde in Version 3.3 erstmals veröffentlicht, da die Versionsgeschichte von OpenOffice übernommen wurde.

In der neuen Version wurde die neue, noch experimentelle Navigationsleiste “Notebookbar” verbessert und verfügt nun über zwei Layouts. Viele Dialoge wurden wie der Sonderzeichen- oder Anpassungsdialog verbessert und neue Dialoge kamen für Formulare hinzu. Bilder können erstmals komplett in jedem Winkel rotiert werden. Calc wird um die Funktionen SEARCHB, FINDB and REPLACEB erweitert, die aus dem ODF 1.2-Standard entstammen und somit konform gehen. Impress, die Präsenationsanwendung verwendet nun standardmäßig das 16:9-Format für neue Folien und wurde um 10 Vorlagen bereichert. Die Hilfeseite wird nun aus dem Internet über ein neues System geladen. Ist eine PGP-Implementation auf dem System vorhanden, können nun ODF-Dokumente mit OpenPGP signiert werden.

Weitere Themen

Artikeltipps

Diese Woche wird der Schwerpunkt mehr auf den Artikeltipps liegen. Beginnen möchte ich hier mit dem Grund, warum der Wochenrückblick so verspätet kommt: ich hatte gestern eine größere Wartung meines Mailservers. Allen die einen neuen Mailserver auf Debian einrichten wollen, kann ich die tolle Anleitung von Thomas Leister dazu nur ans Herz legen.

Ich habe bereits öfter schon mit der OpenStreetMap gearbeitet und weiß, dass man damit sehr schöne Dinge realisieren kann. Kostprobe gefällig? Deutschlands Orte der Unzugänglichkeit von Hans Hack, präsentiert von seeseekey.net. Thematisch passt das übrigens zum Konzept der Pole der Unzugänglichkeit – für alle, die sich mehr dafür interessieren.

Markus hat diese Woche seine Meinung zum Firefox >=57 geschrieben. Vielleicht kann ich eine neue Kategorie einführen… Beef der Woche? 😀

Des Weiteren hat Jörg Kastning seinen Ansatz zur Fotosortierung anhand von EXIF-Daten gebloggt.

Bis zur nächsten Woche!

Bild von IO-Images via pixabay / Lizenz: CC0 Creative Commons

Im Frühjahr 2018 ist die Trennung von ownCloud und Nextcloud zwei Jahre her. Anfangs haben viele das schnelle Ende von ownCloud und den Übergang zu Nextcloud vorhergesagt. In einer kürzlich verschickten Pressemitteilung stellt ownCloud klar, dass dem nicht so ist. Ganz im Gegenteil: Man konnte im vergangenen Jahr ordentlich zulegen und Subscriptionen von vielen Unternehmen einwerben.

Nextcloud veröffentlicht leider keine Zahlen (oder die Suchmaschine meiner Wahl wollte sie mir nicht zeigen?!), daher fehlt der direkte Vergleich. Funktional geben sich beide Projekte nicht viel, auch wenn Nextcloud medienwirksam andauernd neue Versionen veröffentlicht (siehe auch: Kommentar: Warum ownCloud statt Nextcloud?)

Die Zahlen von ownCloud passen aber zu meinen persönlichen Erfahrungen. In der, gewohnt gut informierten und an Forks gewöhnten Linux-Community vollzog sich der Wechsel schnell, aber Open Source-Entwickler unterschätzen oft die Wirkung einer etablierten Marke. OwnCloud war bereits fest etabliert, als Nextloud sich abspaltete und letzteres konnte diese Position bisher nicht übernehmen. Das Verhältnis OpenOffice zu LibreOffice zeigt ja sogar wie schwer dies ist, selbst wenn der Fork funktional deutlich überlegen sein sollte. Nextcloud hat aber gegenüber ownCloud nicht viel zu bieten, tut sich also noch schwerer mit der Durchsetzung.

Bild von stevepb via pixabay / Lizenz: CC0 Creative Commons

Im Jahr 2018 veröffentlicht nicht nur Ubuntu seine neue LTS Version (Kubuntu 18.04 LTS - Ein Ausblick), sondern das openSUSE Projekt hat nun ebenfalls die Betaphase für die Version 15 seiner stabiles LTS-Variante "Leap" eingeleitet. Die nun kommende Version 15 ist erst die zweite Hauptversion des Leap-Zweiges. Die letzte Hauptversion mit der Versionsnummer 42 stammt noch von 2015 (siehe: openSUSE Leap 42.1 im Test).

Leap und Tumbleweed sind die komplementären Veröffentlichungen von openSUSE. Während Tumbleweed als Rolling-Release Distribution konzipiert ist und die fortlaufenden Entwicklungen in der Linux-Communty widerspiegelt, ist Leap auf Stabilität ausgerichtet. Jede Hauptversion von Leap wird ca. 3 Jahre mit Updates versorgt. Die aktuell veröffentlichte Minorversion mindestens 18 Monate lang. Das System von Haupt- und Minorversionen kennt man von anderen Enterprise-Distributionen wie RHEL/CentOS.

Große Veränderungen erfolgen immer nur mit den Hauptversionen, während die Minorversionen lediglich der Produktpflege dienen und selektive Updates einspielen. Leap 42.2 und Leap 42.3 lieferten z.B. KDE Plasma in der LTS-Version 5.8 aus. Lediglich die Programmsammlung KDE Applications erhielt ein Versionsupgrade zwischen den Versionen.

Bedingt durch die Entscheidung der SUSE GmbH die Versionsnummern 13 und 14 für die Enterprise Version zu überspringen nutzt das openSUSE Projekt diese Gelegenheit und harmonisiert die Versionsnummern mit der Basis. Auf Leap 42 folgt daher Leap 15.

Versionen

Basisversionen

OpenSUSE Leap übernimmt, wie auch die Vorgängerversion, einen großen Kernbestand an Paketen von SUSE Linux Enterprise 15. Die neue Version basiert daher auf dem bereits recht abgehangenen Kernel 4.12. Was für die Besitzer brandaktueller Hardware eventuell problematisch ist, dürfte sich für eingefleischte Leap-Anwender als Fortschritt erweisen, immerhin nutzt man bisher noch Kernel 4.4 in Leap 42.3. Hinzu kommen Mesa 17.2, GCC 7 und eine moderne Wayland-Implementierung.

Desktop

Im Desktopbereich hebt man die Version des Standarddesktops auf KDE Plasma 5.12 an, der sich aktuell ebenfalls in der Betaphase befindet und die nächste LTS-Version des KDE Projekts ist. Hinzu kommen GNOME 3.26, MATE 1.18, Xfce 4.12, sowie LXDE und eine Vorschau auf LXQt. OpenSUSE Leap folgt also dem bewährten Prinzip aktuelle Desktopversionen mit einer LTS-Basis zu verknüpfen.

Programme

Das Paket wird komplettiert durch KDE Applications in der aktuellen Version 17.12, LibreOffice 6 und viele weitere Programme. Die Paketquellen sind nicht so umfangreich wie bei Debian und Ubuntu, aber es gammeln durch den Releaseprozes von openSUSE auch deutlich weniger ungepflegte Programmleichen in diesem herum.

Neuerungen

Die Veröffentlichung von openSUSE Leap 15 wird, gemessen an der aktuellen Betaversion, keine umstürzenden Neuerungen enthalten. Abgesehen von den angehobenen Versionsnummern in allen Bereichen gibt es moderate Anpassungen am Design. Manche Upstream-Neuerung wie die neuen KDE Systemeinstellungen hat man sogar standardmäßig abgeschaltet. Unklar ist noch in welchem Umfang Wayland eingesetzt wird. Bei der SLE-Basis hat SUSE sich entschieden standardmäßig auf Wayland umzusteigen. Bei der deutlich größeren Desktopauswahl von openSUSE wäre dies sowieso nur für KDE Plasma und die GNOME Shell möglich. Alle anderen Desktopumgebungen haben noch keine funktionsfähigen Wayland-Implementierungen.

Installationsroutine

Die Installationsroutine folgt den gewohnten SUSE-Richtlinien. Auffällig ist lediglich die neue Routine für die Partitionierung.

Hier hat man die Informationen deutlich reduziert und schafft dadurch mehr Übersichtlichkeit. Zusätzliche Bereiche wie Btrfs-Subvolumes sind beispielsweise standardmäßig ausgeblendet, was die Aufmerksamkeit auf die echten Partitionen lenkt.

Ebenfalls neu ist die Routine für ein "Geführtes Setup".

In einem ersten Schritt kann man sich sehr leicht für ein verschlüsseltes System entscheiden, was sehr erfreulich ist. OpenSUSE hat es hier schon immer viel leichter gemacht ein vollverschlüsseltes System einzurichten, als z.B. Ubuntu, aber dies ist nochmal ein Fortschritt.

Im nächsten Schritt kann man sich zusätzlich noch für ein Dateisystem entscheiden. Zur Auswahl stehen ext2/3/4, sowie Btrfs und XFS. Letztere beiden sind nach wie vor Standard für die root- und home-Partition.

Programmauswahl

Frühere Versionen von openSUSE zeichneten sich durch eine teils widersprüchliche Standard-Programmauswahl aus. Teilweise auch unabsichtlich durch zirkuläre Abhängigkeiten der Pakete. Hier hat man deutlich aufgeräumt. Noch immer liefert openSUSE einen sehr umfangreichen Desktop aus. So sind neben den obligatorischen KDE Programmen auch solche wie LibreOffice, GIMP, DigiKam etc. pp. vorausgewählt. Im Unterschied zu Debian oder Ubuntu kann man hier aber in der Installationsroutine bereits viel abwählen, wenn man lieber einen minimalistischen Desktop einrichten möchte.

Doppelungen von Programmen oder gar die Nachinstallation eines anderen Desktops über Abhängigkeiten erfolgen aber nicht mehr.

KDE hat zudem den endgültigen Abschied von KDE SC 4 vollzogen, weshalb die KDE Applications nun durchweg auf Qt 5 und den KDE Frameworks basieren. Etwaige Fehlfunktionen oder Unstimmigkeiten sind somit nun auch behoben.

Fazit

OpenSUSE Leap läuft bereits jetzt sehr stabil und repräsentiert die Upstream-Fortschritte der vergangenen Jahre. Letzte Unstimmigkeiten werden in der Betaphase sicher noch beseitigt. Leap bietet weiterhin einen konventionellen Linux-Desktop ohne ideologischen Überhang wie bei den puristischen KDE oder GNOME-Implementieren, wie sie z.B. KaOS oder Fedora ausliefern.

Trotz der abgehangenen Basis schafft man den Sprung auf zeitgemäße Technologien wie Wayland.

OpenSUSE Leap hat bei mir sowohl als Server, wie auch für Desktopsysteme und virtuellem Maschinen einen festen Platz - Leap 15 wird daran nichts ändern, sondern eher die ein oder andere Migration anstoßen.

Synology Diskstations stellen Anwendungen bereit, um Bilder, Musik und Videos verwalten zu können. Dies sind im einzelnen

  • die Photo Station,
  • die Audio Station und
  • die Video Station.

Damit die Medien in den jeweiligen Anwendungen angezeigt werden können, müssen diese zuvor indiziert werden. Die Indizierung erfolgt automatisch, wenn Medien über die entsprechende Anwendung hinzugefügt werden. Fügt man sie jedoch auf anderem Wege hinzu, z.B. durch rsync, startet die Medienindizierung nicht und die Medien können in der jeweiligen Anwendung nicht wiedergegeben werden.

Die Benutzeroberfläche „DSM“ bietet lediglich die Möglichkeit, ganz allgemein eine Medienindizierung zu starten. Dabei werden jedoch sämtliche Medien neu indiziert und nicht nur die neu hinzugefügten. Je nach Umfang dauert die Indizierung mehrere Stunden bis Tage. Es gibt jedoch eine Möglichkeit, die Indizierung manuell zu starten und dabei auf ein einzelnes Verzeichnis zu beschränken.

Dazu meldet man sich per SSH an der Diskstation an und führt folgendes Kommando aus:
/usr/syno/bin/synoindex -R /Pfad/zum/Verzeichnis/

Damit lässt sich eine Menge (Rechen-)Zeit sparen.

3. Februar 2018

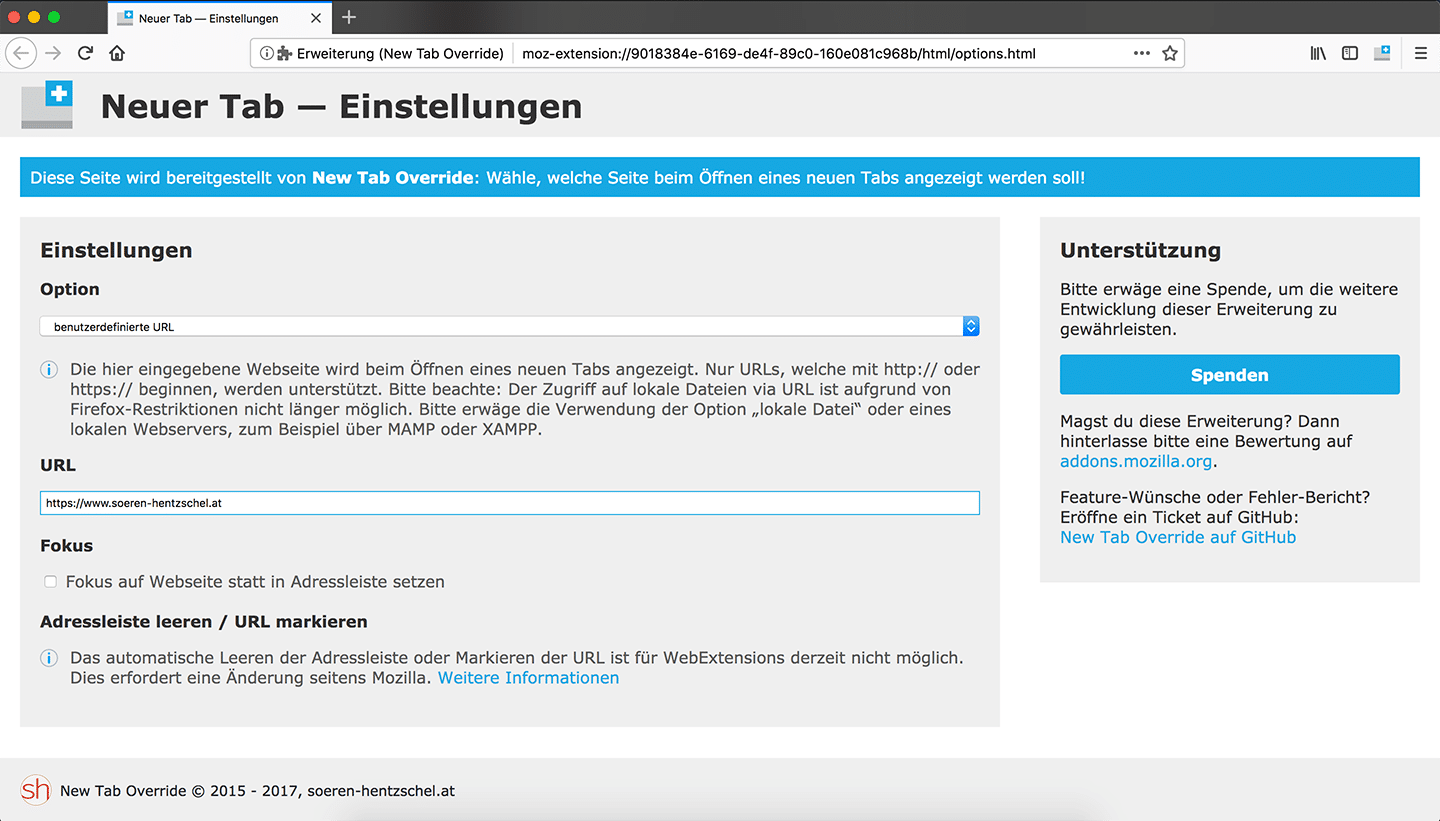
New Tab Override ist eine Erweiterung zum Ersetzen der Seite, welche beim Öffnen eines neuen Tabs in Firefox erscheint. Die beliebte Erweiterung mit mehr als 150.000 aktiven Nutzern ist nun in Version 12.0 mit weiteren Verbesserungen erschienen.

Was ist New Tab Override?

Seit Firefox 41 ist es nicht länger möglich, die Seite anzupassen, welche beim Öffnen eines neuen Tabs erscheint, indem die Einstellung browser.newtab.url über about:config verändert wird. Da diese Einstellung – wie leider viele gute Dinge – in der Vergangenheit von Hijackern missbraucht worden ist, hatte sich Mozilla dazu entschieden, diese Einstellung aus dem Firefox-Core zu entfernen. Glücklicherweise hat Mozilla nicht einfach nur die Einstellung entfernt, sondern gleichzeitig auch eine neue API bereitgestellt, welche es Entwicklern von Add-ons erlaubt, diese Funktionalität in Form eines Add-ons zurück in Firefox zu bringen.

New Tab Override war das erste Add-on, welches diese Möglichkeit zurückgebracht hat, und ist damit das Original. Mittlerweile hat New Tab Override mehr als 150.000 aktive Nutzer, wurde im Dezember 2016 sogar auf dem offiziellen Mozilla-Blog vorgestellt und im Oktober 2017 im Add-on Manager von Firefox beworben.

Download New Tab Override (WebExtension) für Firefox

Die Neuerungen von New Tab Override 12.0

Bei Verwendung der Option, eine lokale Datei als neuen Tab zu verwenden, wird nun der Inhalt des <title>-Elements aus dem Dokument extrahiert und als Seitentitel für den neuen Tab verwendet.

Die Option, den Fokus auf die Webseite statt auf die Adressleiste zu legen, steht nun auch für die leere Seite about:blank zur Verfügung. Dies kann vor allem im Zusammenspiel mit anderen Add-ons wie Vimium-FF nützlich sein.

Die Hintergrundfarbe der Einstellungsseite wurde im CSS nun explizit gesetzt, so dass es zu keinen Darstellungsproblemen kommt, wenn die Firefox-Einstellung browser.display.background_color auf einem Nicht-Standard-Wert steht.

Die russische sowie die chinesische Übersetzung wurden aufgrund von Inaktivität der Übersetzer entfernt. Außerdem wurden wieder sämtliche Abhängigkeiten auf den aktuellen Stand gebracht. Neue Mindestvoraussetzung ist Firefox 58, ältere Firefox-Versionen werden nicht unterstützt.

New Tab Override 11.0

Der Beitrag New Tab Override 12.0 (WebExtension) veröffentlicht erschien zuerst auf soeren-hentzschel.at.

31. Januar 2018

Im Privaten Modus merkt sich Firefox keine Surf-Spuren wie Chronik oder Cookies. Außerdem werden standardmäßig Tracking-Scripts blockiert. Mit Firefox 59 verbessert Mozilla weiter die Privatsphäre in diesem Modus.

Besuchte Webseiten, Eingaben in das Suchfeld und Logins sind Dinge, die sich Firefox, neben anderen Dingen, merkt. Was häufig praktisch ist, ist nicht immer erwünscht. Daher gibt es mit dem sogenannten Privaten Modus eine Betriebsart, bei der sich Firefox all dies nicht merkt. Auch liefert der Private Modus standardmäßig mehr Privatsphäre. Bekannte Tracking-Scripts von Drittanbietern werden nämlich blockiert. Neben einer Verbesserung der Privatsphäre sorgt dies ganz nebenbei für deutlich weniger Werbung auf den Webseiten und für eine spürbar bessere Webseiten-Performance.

Mit Firefox 59 geht Mozilla einen Schritt weiter. Bisher ist es üblicherweise so, dass der Browser gemäß HTTP-Protokoll bei jedem Aufruf einer Webseite einen sogenannten Referrer sendet. Dies bezeichnet die URL, von der ein Nutzer zur Zielseite navigiert ist, und zwar in der Regel die komplette URL. Diese Information steht auch sämtlichen Sub-Ressourcen wie eingebetteter Werbung oder Social Media-Widgets zur Verfügung. Solche Informationen werden häufig für Statistiken genutzt. Während dies vergleichsweise harmlos ist, ist es weit problematischer, wenn der Referrer sensible Informationen preisgibt. So hat die EFF berichtet, dass healthcare.gov über den Referrer sensible Informationen an mindestens 14 Domains geleakt hat. Ein solcher Referrer konnte beispielsweise so aussehen:

https://www.healthcare.gov/see-plans/85601/results/?county=04019&age=40&smoker=1&pregnant=1&zip=85601&state=AZ&income=35000

Aus diesem Referrer lässt sich nicht nur ableiten, welche Seite der Anwender zuvor besucht hat. In diesem konkreten Fall beinhaltet der Referrer das Alter, den Wohnort, ob der Anwender Raucher ist, und sogar das Einkommen, weil all diese Informationen auf der Webseite als URL-Parameter vorhanden und beim direkten Navigieren auf eine andere Webseite dann im Referrer vorhanden sind.

Im Privaten Modus wird Firefox ab Version 59 den Referrer standardmäßig kürzen und den kompletten Pfad sowie zusätzliche Parameter entfernen. Im obigen Beispiel würde damit nur noch Folgendes als Referrer übrig bleiben:

https://www.healthcare.gov/

Damit wird für Webseiten-Betreiber verhindert, dass sensible Daten versehentlich geleakt werden, zumindest für Nutzer des Privaten Modus von Firefox. Im Idealfall sollten Webseiten natürlich von sich aus für alle Nutzer gewährleisten, dass solche Informationen nicht via Referrer weitergegeben werden.

Firefox besitzt darüber hinaus einige Einstellungen, um das Referrer-Verhalten detailliert, unabhängig vom Privaten Modus, zu konfigurieren.

Der Beitrag Firefox 59: Noch mehr Privatsphäre für den Privaten Modus erschien zuerst auf soeren-hentzschel.at.

Open Source in der Schule – ein Thema, bei dem sich häufig die Geister scheiden. Ist es wirklich sinnvoll Open Source Software (OSS) in der Schule zu verwenden? Gibt es gerade für Schulen nicht viel geeignetere Alternativen? Welche Argumente gibt es für und gegen den Einsatz von OSS in der Schule, d.h. im Unterricht, im Computerraum oder auf auf dem Schulserver? Gibt es Schulen, die erfolgreich auf OSS setzen oder ist das nur ein Wunschtraum?

Ich möchte versuchen Argumente für und gegen Open Source Software in der Schule aufzulisten. Diese Liste ist sicher nicht vollständig und ich werde sie deshalb von Zeit zu Zeit aktualisieren. Wer noch weitere Ideen und Gründe für oder gegen den Einsatz von Open Source in der Schule hat, ist hiermit ermutigt einen Kommentar zu schreiben 🙂

Warum man Open Source in der Schule verwenden sollte – die Chancen

  • Sensibilisierung für informationelle Freiheit vs. Monopole – Der Einsatz von Open Source Software leistet einen großen Beitrag in der Medienerziehung. Dazu zählt die Sensibilisierung für die Tatsache, dass heutzutage der Großteil meiner Daten nur einer handvoll Unternehmen gehört. Weiterhin das Aufzeigen von Möglichkeiten und Alternativen, die es neben den großen Anbietern proprietärer Software gibt.
  • Freiheit –  Dieser Begriff ist sehr weit und umfasst sowohl die Freiheit von kommerziellen Interessen, als auch im Sinne von Weitergabe von Software. Dazu zählt auch, dass die meiste OSS lizenzkostenfrei ist. Der Einsatz von OSS bricht Abhängigkeiten von Herstellern, von Supportverträgen oder Sicherheitsupdates, die nur gegen Aufpreis verfügbar sind. LibreOffice stellt z.B. sicher, dass ich Dokumente aus vielen kommerziellen Produkten weiterverwenden und importieren (teilweise auch exportieren) kann.
  • keine Lizenzkosten – In der Regel zahlt man für OSS keine Lizenzkosten. Dadurch kann langfristig sehr viel Geld gespart werden. Weiterhin können Unterrichtsprojekte/-methoden, welche teure Programme oder deren flächendeckende Installation erfordern, mit OSS-Alternativen realisiert werden. Aus finanziellen Gründen wären diese oft nicht möglich. Man muss z.B. Grafikbearbeitung nicht mit Adobe Photoshop lernen.
  • Sicherheit – Der Quelltext von OSS ist für jeden frei zugänglich. Schwachstellen werden i.d.R. schnell behoben. Hintertüren sind dadurch nur schwer einzuschleusen – wenn überhaupt. Bei (L)Unix – Systemen gibt es eine klare Rechteverteilung. Das erhöht die Sicherheit zusätzlich. Derzeit gibt es recht wenig bekannte Viren und Malware für Linux-Betriebsysteme.
  • größeres Verständnis für Funktionsweise von Programmen – Dadurch, dass Schüler die Möglichkeit haben, andere Software neben den marktbeherrschenden Programmen kennenzulernen, können sie ein größeres Verständnis für die Funktionsweise bekommen, z.B. einer Textverarbeitung oder Tabellenkalkulation. Es wird weniger „Klick-Wissen“ angeeignet, sondern man stattet die Schüler mit einer größeren Flexibilität im Umgang mit unbekannter Software aus.
  • Gleichheit – OSS leistet einen großen Beitrag zur Gleichheit zwischen den Schülern. Die Software kann jeder frei für die meisten Betriebssysteme herunterladen und auch weitergeben. Es herrscht kein Zwang eine bestimmte Software zu kaufen, um die Inhalte des Unterrichts zu Hause zu vertiefen. Finanzschwächere Familien werden nicht benachteiligt.
  • Werte – Die Werte, die hinter der OSS-Bewegung stehen passen gut zu Schule und zu dem, was sie eigentlich vermitteln will. Konkret meine ich (Wissen) teilen, zusammen arbeiten, Offenheit, Transparenz, freier Zugang zu Informationen. Diese Praxis und die Kultur des Weitergebens und Teilens fördern Kompetenzen, die ethisch und gesellschaftlich von hoher Bedeutung sind.
  • Lokalisierung – OSS Software ist oft in der Muttersprache vorhanden. Diese Argument zählt vielleicht nicht so sehr in der westlichen Welt, in der jede Software meist noch in anderen Sprachen neben Englisch verfügbar ist. In Asien oder Afrika, in denen es sehr viele verschiedene Sprachen gibt, ist das ein großer Vorteil. Auch wenn Englisch sehr weit verbreitet ist, gibt es viele Teile auf der Welt, in denen diese Sprache nicht gesprochen oder verstanden wird.
  • Verwaltung / Administration – Nach mehreren Jahren Erfahrung mit OSS im privaten sowie im schulischem Umfeld kann ich persönlich bestätigen, dass die Verwaltung von vielen Rechnern mit OSS wesentlich einfacher und zeitsparender ist. Die Möglichkeiten zur Automatisierung sind riesig. Wir verwenden auch Windowsrechner bei uns, aber deren Pflege und Wartung ist ca. 80% aufwendiger als unsere Ubuntu-Rechner.
  • alte Hardware kann länger verwendet werden – Ein Vorteil, den man nicht unterschätzen sollte, gerade für Schulen. Die meisten Dinge, die Schüler in der Schule an einem Computer lernen und wozu sie ihn benutzen, erfordern keine hohe Systemvoraussetzungen. Ein alter Rechner, ausgestattet mit einer kleinen SSD, lässt sich noch viele Jahre einsetzten. Gebrauchte Hardware kann man günstig erwerben oder man erhält sie u.U. auch als Spende. Mit OSS, die oft weniger Ressourcen braucht, kann man Hardware noch lange einsetzten. Wir haben z.B. noch Rechner im Betrieb, die schon fast 8-10 Jahre im Betrieb sind.

Was spricht gegen die Verwendung von Open Source in der Schule?

Trotz der oben genannten Punkte, gibt es auch Argumente gegen den Einsatz von Open Source in der Schule. Generell muss man unterscheiden, in welchem Umfang man OSS verwenden möchte. Geht es nur darum eine Anwendung auszutauschen oder eine Schule komplett, d.h. vom Betriebssystem an, mit OSS zu betreiben? Oder möchte man OSS nur auf einem Server einsetzen? Je nach Anwendungsfall kommen weitere Argumente dazu oder fallen weg.

  • weniger Support durch Unternehmen – Es gibt faktisch weniger Unternehmen und Dienstleister, welche OSS unterstützen, v.a. auch abseits der westlichen Welt. Das ist ein großes Problem, wenn man z.B. von Windows zu Ubuntu wechseln möchte. In vielen Fällen gibt es vielleicht eine engagierte Lehrkraft, aber das ist keine langfristige Lösung bzw. eigentlich auch nicht Aufgabe eines Lehrers.
  • kaum Lernsoftware vorhanden – Lernsoftware ist zu 99% für Windows konzipiert. Für Linux oder macOS gibt es von den Schulbuchverlagen kaum Anwendungen. Sicher kann man über den Sinn und Zweck von Lernsoftware streiten, aber es gibt kaum eine Lernsoftware für Linux. Wer Lernsoftware einsetzen will / muss, braucht i.d.R. einen Windowscomputer (physisch oder virtuell).
  • kleinere Community, wenige Referenzen – Es gibt einige Schulen in Deutschland, aber auch weltweit, die Open Source in der Schule verwenden, aber man findet wenig Informationen darüber. Das ist v.a. ein Nachteil, wenn man den (geplanten) Einsatz von OSS vor der Schulleitung oder dem Vorstand begründen muss.
  • weiterer Bildungs- und Berufsweg verwendet andere Software – Dies ist ein weit verbreitetes Argument gegen OSS. Später müsse man doch sowieso Mircosoft Office verwenden, warum sollen die Schüler dann den Umgang mit LibreOffice lernen? Eigentlich kein richtiges Argument gegen OSS, denn m.M.n. hat dieses Argument auch mit dem nächsten zu tun:
  • Bequemlichkeit und allgemeine Abwehrhaltung gegen OSS – Ich erlebe immer wieder eine gewissen Abneigung gegen OSS. Man befindet sich oft in einer Rechtfertigungshaltung, wenn man OSS einsetzen möchte. Das hat zum Teil mit der Qualität und Stabilität einiger Open Source Projekte zu tun, aber auch mit der mangelnden Flexibilität vieler Lehrkräfte. Das kann ein großes Hindernis für den erfolgreichen Einsatz von OSS sein!
  • Unsichere Weiterentwicklung – Für die Weiterentwicklung von OSS gibt es keine Garantie, weil sie vom freiwilligen Engagement der Community sowie der Nachfrage abhängt. Das gilt vor allem für viele kleine Projekte.
  • Anwendungsintegration – Im Zusammenspiel mit anderen Applikationen, insbesondere kommerzieller Software, kann es zu erheblichen Problemen kommen. Dieses Argument spielt in Schulen eine kleinere Rolle im Vergleich zu Unternehmen.

Was nötig ist – die Herausforderungen

Die größten Herausforderungen beim Einsatz von Open Source in der Schule sehe ich im Abbau von Berührungsängsten und den damit verbunden Schulungen sowie der Gewinnung von einem geeigneten Dienstleister oder eigenem Personal. Diese beiden Punkte sind kritisch, wenn man OSS im Unterricht oder in der IT-Infrastruktur einsetzen möchte. Ich erlebe immer wieder, wie Kollegen und Mitarbeiter OSS ablehnen oder kritisch gegenüberstehen, weil es anders ist und nicht so aussieht bzw. funktioniert, wie sie es gewohnt sind. Hier kann man mit internen Fortbildungen und Schulungen entgegenwirken. Deshalb muss eine Migration z.B. von MS Office zu LibreOffice oder Windows zu Ubuntu gut geplant und vorbereitet werden. Trotz allem wird es aber immer Leute geben, die dem kritisch gegenüber stehen, getreu nach dem Motto „Was er Bauer nicht kennt, isst er nicht!“.

Damit der Einsatz von Open Source Software in der Schule gelingt, braucht es unbedingt auch kompetentes Personal bzw. Dienstleister. Ohne so einen Person oder Partner ist es schwierig(er) die Kollegen für OSS zu gewinnen. Oft muss individuelle Hilfe geleistet oder zusätzliche Dokumentation erstellt werden, v.a. in der Übergangszeit. In Europa und der westlichen Welt sind die Chancen größer einen solchen Partner zu finden, aber in anderen Teilen der Welt kennt man fast nur Windows. Dessen muss man sich bewusst sein.

Fazit

Als Schule im Ausland sind wir den Schritt Richtung Open Source vor ca. 2 Jahren gegangen und haben es nicht bereut. Im Gegenteil: Wir haben unsere bisherige Infrastruktur stark ausgebaut – ohne größere Mehrkosten. Mit Hilfe von Open Source Software konnten wir so in vielen Bereichen einen Mehrwert schaffen. Unsere Schüler haben die wenigsten Probleme mit unseren Ubuntu-Rechner und auch viele Kollegen arbeiten gern damit. Als Schulserverlösung verwenden wir linuxmuster.net – eine freie Musterlösung – hinter der eine super Community steht – nett, hilfsbereit, kompetent.

Setzt du Open Source in der Schule ein? Wo siehst du die größten Chancen und Herausforderungen?

Quellen (1,2)

9 Kommentare

Der Beitrag Open Source in der Schule – Was dafür und was dagegen spricht erschien zuerst auf .:zefanjas:..

30. Januar 2018

Meinen ersten Kontakt zu Paketmanager unter Linux hatte ich zu Synaptic. Ich kam sehr gut zurecht und habe es gerne genutzt. Unter Debian (Version 4-6) war aptitude die bevorzugte Software zur Paketverwaltung und das Programm funktionierte sehr gut.
Nachdem sich das Softwarecenter aus Ubuntu verabschiedet hat viel mein Blick auf apt-get und das neue APT. Und was soll ich sagen? Ich bin begeistert. Das vereinheitlichte APT wirkt modern und erledigt selbst komplexe Updates zuverlässig.

Ich kann jedem nur empfehlen mal einen Blick auf APT in der Konsole zu werfen.

Ein guter Anfang ist: man apt

29. Januar 2018

Mozilla hat mit Firefox 58.0.1 ein außerplanmäßiges Sicherheits-Update veröffentlicht. Außerdem addressiert Mozilla damit ein durch Sicherheits-Software ausgelöstes Problem.

Download Mozilla Firefox 58.0.1 für Microsoft Windows, Apple macOS und Linux

Mozilla hat ein Update außer der Reihe für Firefox 58 veröffentlicht. Mit dem Update auf Firefox 58.0.1 behebt Mozilla ein kritisches Sicherheitsproblem. Außerdem konnten diverse Sicherheits-Softwares auf Windows auslösen, dass Firefox nicht länger dazu in der Lage war, Webseiten zu laden. Ursächlich hierfür war ein Konflikt mit einem in Firefox 58 neu eingeführten DLL-Blockier-Mechanismus, welcher – ironischerweise – problematische Sicherheits-Software blockieren soll, die bekannt dafür ist, Stabilitäts-Probleme zu verursachen.

Der Beitrag Mozilla veröffentlicht Sicherheits-Update Firefox 58.0.1 erschien zuerst auf soeren-hentzschel.at.

Bild von andries48 via pixabay / Lizenz: CC0 Creative Commons

Der klassische Desktop steckt in der Krise, das betrifft Linux genau so wie Windows und macOS. Die Absatzzahlen von stationären und mobilen Geräten wie klassischen PCs, Notebooks & Co stagnieren in guten Jahren und brechen in schlechten Jahren massiv ein. Gleichzeitig boomen die Absatzzahlen von mobilen Geräten wie Smartphones & Co. Apple hat mit iOS mehr als nur einen Fuß in der Tür, Microsoft hat neben dem wenig erfolgreichen Windows Mobile eine App-Landschaft für Android und iOS veröffentlicht und Linux?

Klassische Linux-Anhänger sagen oft, dass Linux erfolgreicher denn je sei, wegen "Android" ode IoT. Dahinter steckt die simple Feststellung, dass Android und viele IoT-Produkte auf einem Linux-Kernel basieren und das reicht schließlich um von Linux zu sprechen.

Doch reicht Android um die Zukunft von Linux zu sichern? Google könnte theoretisch jederzeit einen eigenen Kernel entwickeln und Linux in Android ersetzen. Der dort eingesetzte Linux Kernel ist zudem stark modifiziert und wird seit Jahren versionsstabil gehalten, weshalb die Verbindung zur Linux-Entwicklung eher als lose bezeichnet werden muss.

Doch was ist eigentlich Linux? Meiner Meinung nach ist Linux in einer weniger eng geführten Definition eine Kombination von verschiedenen Produkten und Ideen. Linux sind neben dem Kernel auch die GNU-Werkzeuge, durch die fast alle Distributionen auf der Konsole so ähnlich sind. Wer mal mit FreeBSD und seinen Abkömmlingen gearbeitet hat, merkt diese Unterschiede. Hinzu kommen die klassischen Linux-Desktops und die Idee eines modularen Systems, das eben z.B. jene Desktops nicht fest mit dem Basissystem verbindet, wie das bei macOS oder Windows der Fall ist.

Linux ist aber auch eine Idee wie Software entwickelt wird. Quelloffen und transparent, gegliedert in unterschiedliche Projekte, die aufeinander aufbauen und teilweise auch konkurrieren. Zusammen gestellt von Distributoren, die eine Betriebssystemvariante aus diesem riesigen Pool an Möglichkeiten erschaffen. Sei es für den klassischen Desktop oder für Server unterschiedlicher Leistungsfähigkeit. Alles aus von und für eine riesige Community, in der neben vielen hauptberuflichen Menschen auch viele ehrenamtlich tätig sind.

Android ist dagegen ein Google-Geheimnis. In regelmäßigen Abständen schmeißt man der Community eine neue Version AOSP vor die Füße, die diese dann mühsam lauffähig bekommen muss. Dazwischen gibt es wolkige PR-Meldungen. LineageOS arbeitet nicht von ungefähr immer noch an Android 8.0 "Oreo", welches bereits im vergangenen August das Licht der Welt erblickte. Das Verhältnis von Android zur Community gleicht daher eher dem von macOS/Darwin zu FreeBSD.

Wenn Linux mehr ist als der Kernel - und das ist wie gesagt definitionssache - ist Android weder die Zukunft, noch die Rettung. Gleiches gilt für den boomenden IoT-Bereich.

Linux ist momentan wie ein Lebewesen auf einer Eisscholle. Die Ränder brechen unaufhaltsam weg, viele nennenswerte statische Daten weisen nach unten, aber bisher hat die zerfaserte Community keine Idee entwickelt, wie es weitergehen könnte.

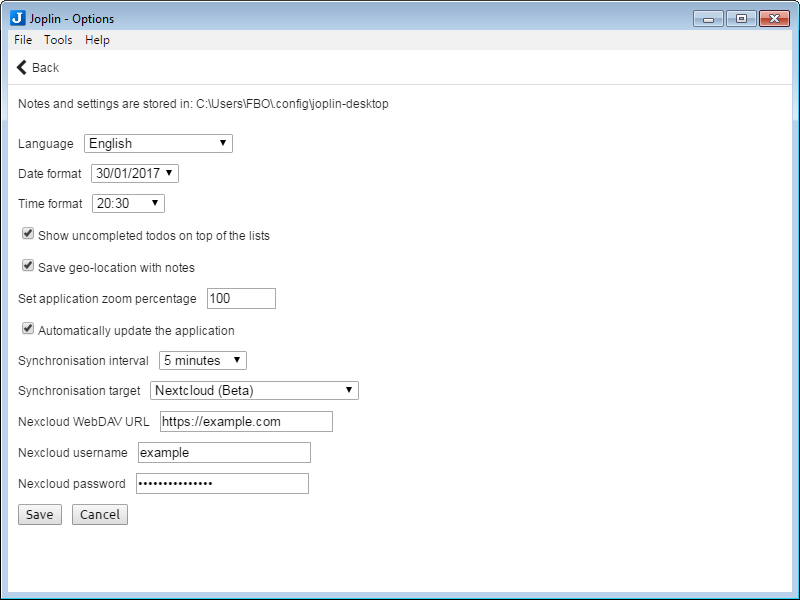
Seit einigen Stunden ist die Version 0.10.51 der freien Evernote-Alternative Joplin erschienen. Die große Neuerung dieser Version ist die Unterstützung der Synchronisation zu Nextcloud. Dazu muss die WebDAV-URL der jeweiligen Nextcloud-Instanz eingetragen werden. Die URL entspricht dem Schema:

https://example.com/remote.php/webdav/Joplin

Nach dem webdav/ wird der Ordner spezifiziert. Anschließend kann die Synchronisation gestartet werden.

Die Einstellungen unter Windows

Das Feature selbst ist zur Zeit noch als Beta gekennzeichnet, läuft aber nach Aussage des Entwicklers bereits stabil. Das Update für die iOS wird demnächst nachgereicht. Heruntergeladen werden können die Versionen für Linux, macOS, Windows und Android über die offizielle Seite des Projektes. Auf dieser finden sich auch weiterführende Informationen zur Synchronisierung über Nextcloud.

28. Januar 2018

Bild von johnyksslr via Pixabay / Lizenz: CC0 Creative Commons

Im vergangenen Juli wurde hier die Sicherheit und Datenschutzfreundlichkeit von Android schon mal thematisiert (siehe: Android - Keine sichere Alternative!) und weil das Thema potenzial zu einer Serie hat kommt hier nun der zweite Teil. Vergangene Woche kam heraus, dass Google nicht nur über das - vermeintlich abgeschaltete - WLAN den Standort erfasst, sondern auch über das - ebenfalls vermeintlich abgeschaltete - Bluetooth.

Meiner Meinung nach ist das eine Meldung in der Kategorie "In China ist ein Sack Reis umgefallen". Wie bereits im letzten Jahr geschrieben ist es Fakt, dass die Google-Mutterfirma Alphabet ihre Umsätze größtenteils mit Werbung erzielt. Werbung im digitalen Bereich ist bereits seit einiger Zeit untrennbar mit massivem Tracking der Anwender verbunden (siehe auch: Tracking - Wenn dein eigener Browser dich verfolgt). Wen überrascht nun, dass eine solche Firma erstens diese Prinzipien auch in ihrem Mobilsystem unterbringt und zweitens wenig Sinn für die Privatsphäre der Anwender hat?

Man muss sich einfach mal klar machen: Google verdient mit Android - gemessen an den Gesamtumsätzen - erst einmal nicht wirklich viel Geld, weil man nur wenige Geräte selbst produziert und sonst lediglich das System für die Hersteller bereit stellt. Verglichen mit dem Hauptkonkurrenten Apple ist das ein massiver Unterschied, denn Apple erwirtschaftet seine Umsätze in einem erheblichen Maße durch den Verkauf von iPhones. Angeblich bekommt Microsoft für verkaufte Android-Geräte mittels Patente genau so viel Geld wie Google. Letztere erhalten für manche sogar gar nichts weil sie nicht offiziell zertifiziert sind, insbesondere bei so genannten China-Phones ist das der Fall. Wirkliche Einnahmen werden vor allem durch die Provision bei App-Verkäufen im Google Play Store erzielt, wo man jedoch auch im Wettbewerb mit Apple um Entwickler steht.

Android ist vor allem Mittel zum Zweck. Man möchte nah am Verbraucher bleiben. Die hohe Verbreitung von Android gewährleistet, dass Google Dienste ungefiltert und prominent für Millionen von Menschen zur Verfügung stehen. Diese Kenntnis des Verbrauchers lässt sich mittelbar in zielgruppenorientierte Werbung umsetzen, andere Konzerne wie Facebook verdienen so auch ihr Geld. Genaue Kenntnis über den Standort ermöglicht eben nicht nur personifizierte Werbung, sondern auch noch ortsbezogene Anzeigen. Interessensbasierte Werbung ist der Markt schlechthin in diesem Bereich. Niemand schaltet mehr Spots im Fernsehen in der Hoffnung die Zielgruppe möge diese zufällig sehen. Abgesehen davon gewährleistet die Entwicklerposition, dass keine Funktionen einfließen, die negative Auswirkungen auf die Werbeeinahmen haben, wie jüngst bei Apple.

Aus genau diesem Grund hat Google kein Interesse an zu viel Datenschutz. Es reicht ein Niveau zu halten, bei dem die Anwender nicht vertrieben werden. Wenn man mittels Android nichts über die Nutzer in Erfahrung bringen kann und die Google-Dienste sogar abschaltbar machen müsste, hätte man keinen Grund das System zu entwickeln, sondern könnte ähnlich wie Microsoft einfach bei fremden Systemen über Apps präsent sein.

Natürlich kann man argumentieren, dass der Kern von Android, das so genannte AOSP, sich mittels Custom Roms frei von Google Diensten auf die Geräte bringen lässt und somit ein google-freies Nutzungserlebnis ermöglicht - ohne jene Bluetooth- und WLAN-Datenabflüsse. Die größte Custom Rom ist LineageOS, vormals als Cyanogenmod bekannt. Dort hat man insgesamt etwas mehr als 1,5 Mio. Anwender. Was sich nach viel anhört ist gemessen an den riesigen Android-Nutzerzahlen lächerlich wenig. 2016 wurden ca. eine Milliarde Smartphones verkauft, davon mehrheitlich Android-Geräte. Von den LineageOS-Geräten sind zudem viele von den Anwendern nachträglich mit den GApps versehen worden. Der Anteil an google-freien Smartphones ist also verschwindend gering.

Der potenziell so freien Open Source-Variante AOSP steht also ein riesiger Pool von Android-Geräten gegenüber die mit Google-Diensten und meist zusätzlich noch Hersteller-Diensten verknüpft sind. Hinzu kommen die vollkommen veralteten Versionen. Insgesamt ein absoluter Sicherheits- respektive Datenschutzalbtraum. Wir werden also immer wieder Meldungen dieser Art hören so lange die Kunden auf dieses Angebot eingehen.

Der neue Editor für WordPress wird Gutenberg heißen. Für Blogger die einen Text schreiben möchten und eventuell noch ein Bild einfügen möchten ist er, aus meiner Sicht gesehen, unbrauchbar.

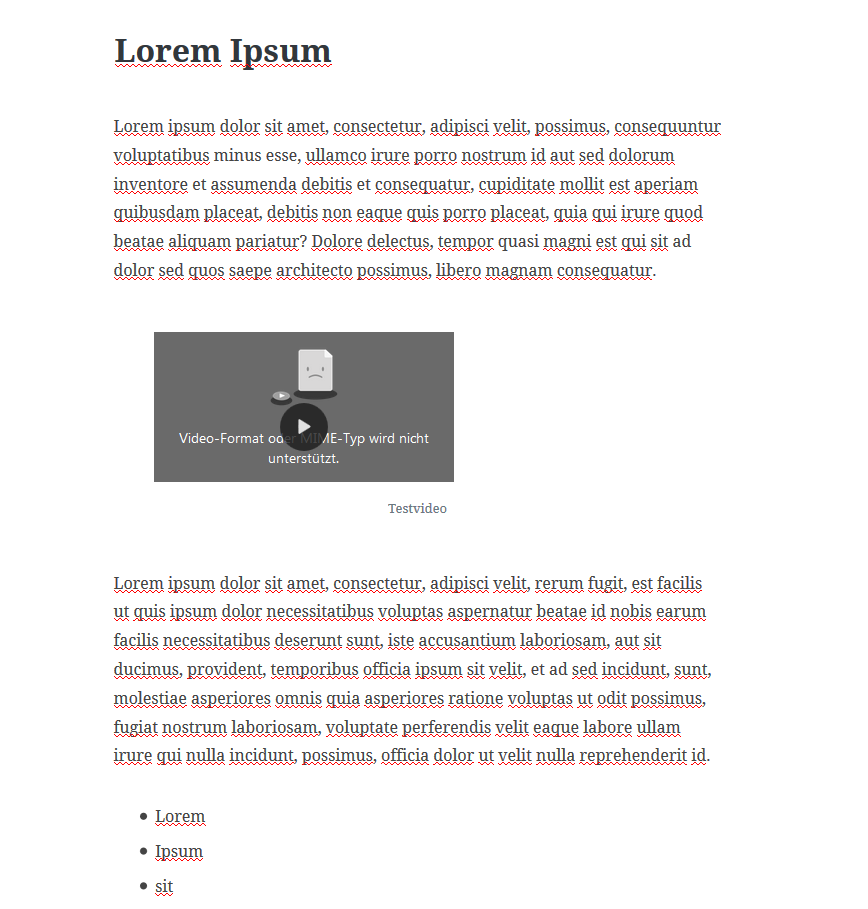
Der Gutenberg-Editor in seiner aktuellen Plugin-Version

Veröffentlicht werden soll Gutenberg offiziell mit WordPress 5.0. Diese Version wird zirka April 2018 erscheinen. Zur Zeit kann der Editor als Plugin installiert und getestet werden.

Gutenberg (Kostenlos, WordPress) →

Während Markdown seinen Siegeszug angetreten hat und dafür sorgt das wir ablenkungsfrei schreiben können, baut Automatic einen Editor der den Pagebuildern aller Wix und Konsorten entgegen kommt. Alles in Gutenberg ist ein Block. Es gibt Textblöcke, Bildblöcke, Videoblöcke, Listenblöcke und so weiter. Für denjenigen der täglich versucht ablenkungsfrei Text zu produzieren, ist das Ding in seiner jetzigen Form unbrauchbar. Ich möchte keine Blöcke und hunderte Möglichkeiten meine Seite zu gestalten, ich möchte ein großes weißes Blatt Papier und dieses mit meinem Text füllen. Man vernichtet mit Gutenberg praktisch die Trennung zwischen Design und Inhalt.

Aktivieren Sie JavaScript um das Video zu sehen.
Video-Link: https://www.youtube.com/watch?v=Xcxtno1bdg0

Ja WordPress ist mittlerweile ein vollwertiges CMS. Aber die Entwickler sollten die Ursprünge als Werkzeug für Blogger und Autoren nicht vergessen. Wenn man sich denn Quelltext der Blöcke anschaut, wird einem als Markdown-Fan leicht übel:

<!-- wp:core/paragraph -->
<p>Lorem ipsum dolor sit amet, consectetur, ...</p>
<!-- /wp:core/paragraph -->

<!-- wp:core/video -->
<figure class="wp-block-video"><video controls="" src="https://www.youtube.com/watch?v=Xcxtno1bdg0"></video>
<figcaption>Testvideo</figcaption>
</figure>
<!-- /wp:core/video -->

<!-- wp:core/paragraph -->
<p>Lorem ipsum dolor sit amet, consectetur, ...<br/></p>
<!-- /wp:core/paragraph -->

<!-- wp:core/list -->
<ul>
<li>Lorem </li>
<li>Ipsum</li>
<li>sit </li>
<li>dolor </li>
<li>amet</li>
</ul>
<!-- /wp:core/list -->

Die Bewertungen des Gutenberg-Plugins reichen von Begeisterung bis hin zu strikter Ablehnung. Ich kann durchaus beide Seiten verstehen. Auf der einen Seite ist es ein einfacher und visueller Editor mit welchem die Textentwürfe umgesetzt werden können. Natürlich kann man nun schöne Beiträge bauen. Das ist allerdings aus meiner Sicht ein Problem. Viele Autoren und Blogger möchten keine Beiträge bauen, sondern Texte schreiben. Buchstabe für Buchstabe, Wort für Wort, Satz für Satz. Stattdessen darf ich mich bei Gutenberg mit den Blöcken herumschlagen.

Es bleibt nur zu hoffen, dass es, wie schon jetzt, eine Möglichkeit geben wird direkt einen Text zu schreiben. Interessant zu der Thematik ist eine entsprechende Diskussion auf der Review-Seite. In der FAQ wird eine solche Möglichkeit angesprochen:

We are looking at ways to make Gutenberg configurable for many use cases, including disabling different aspects (like blocks, panels, etc.). There is also be a “Classic” block, which is virtually the same as the current editor, except in block form. There’s also likely to be a very popular plugin in the repository to replace Gutenberg with the classic editor.

Auch den klassischen Editor, gibt es mittlerweile in Form eines Plugins:

Classic Editor (Kostenlos, WordPress) →

Es wird spannend zu sehen in welche Richtung Automattic mit seinem Page-Builder-Ansatz steuert und wie die Community darauf reagieren wird. Wie man den Bewertungen des Gutenberg-Editors entnehmen kann, ist sie im Moment gespalten.

Heute ist europäischer Datenschutztag.

Der Europäische Datenschutztag ist ein auf Initiative des Europarats ins Leben gerufener Aktionstag für den Datenschutz. Er wird seit 2007 jährlich um den 28. Januar begangen. Dieses Datum wurde gewählt, weil am 28. Januar 1981 die Europäische Datenschutzkonvention unterzeichnet worden war.

Ziel des Europäischen Datenschutztages ist es, die Bürger Europas für den Datenschutz zu sensibilisieren. Dies soll durch Aktionen aller mit dem Datenschutz betrauten Organisationen erfolgen.1

Ergänzend zum “üblichen” Datenschutz möchte ich euch heute noch zwei Tipps auf den Weg geben, die Datenschutz im größeren Sinne betreffen.

Schaut, welche Anwendungen ihr nicht benötigt. Deinstalliert unbenutzte Anwendungen auf euren Computern oder Smartphones. Unter Debian/Ubuntu könnt ihr alle über den Paketmananger installierten Anwendungen über

dpkg-query -l
, bei ArchLinux über
pacman -Q
auflisten. Jede zusätzliche Anwendung kann ein Datenschutz- und Sicherheitsrisiko sein.

Schützt eure Daten vor unautorisiertem Zugriff. Nutzt Zwei-Faktor-Authentifizierung. Nur 10 % der Gmail-Nutzer nutzen dies. Die Seite twofactorauth.org gibt eine kleine Übersicht, welche Webdienste dies unterstützten.

Einen schönen Sonntag!

Quellen

Zitat: Seite „Europäischer Datenschutztag“. In: Wikipedia, Die freie Enzyklopädie. Bearbeitungsstand: 3. Februar 2017, 18:54 UTC. URL: https://de.wikipedia.org/w/index.php?title=Europ%C3%A4ischer_Datenschutztag&oldid=162292087 (Abgerufen: 28. Januar 2018, 14:18 UTC)

Foto: © Style-Photography / Fotolia.com

Heute ist weltweiter Datenschutztag, sogar Google bewirbt dies prominent auf seiner Startseite - welch Ironie. Anlässlich des Ereignisses ist Threema für aktuell 1,09 € zu haben. Sollte man bisher mit einem Umstieg geliebäugelt haben, ist das nun sicherlich die Gelegenheit.

Bereits vor einigen Tagen waren Messenger und Alternativen zu WhatsApp hier ein Thema (siehe: WhatsApp und seine Alternativen - Herdentrieb oder steuerbare Bewegung?). Theoretisch halte ich Signal für die, hinsichtlich des Datenschutzes, beste Lösung. Praktisch nutzt das niemand und unter allen Alternativen haben ich die meisten Kontakte in Threema.

Threema ist ein Produkt der Threema GmbH aus der Schweiz. Er kam bereits ein Jahr vor der globalen Überwachungs- und Spionageaffäre auf den Markt, welche ihn dann 2013 an die Spitze der Verkaufscharts in den App Stores katapultierte. Die Firma finanziert sich über den Verkauf der App, die schon immer kostenpflichtig war. Funktional bietet man das was im Messengerbereich üblich ist: Text-, Video, Sprach und Bildernachrichten sind möglich und seit einiger Zeit auch Telefonie.

Es ist für die Anmeldung keine SIM-Karte notwendig, weshalb eine anonyme Registrierung gewährleistet ist. Die Verbindung mit einer Mobilfunknummer oder E-Mail-Adresse ist genau so optional wie die Kontaktesynchronisation. Threema speichert zudem keine Metadaten und nicht abgerufene Nachrichten sind nur maximal 14 Tagen verfügbar bevor Threema sie verwirft.

Das große Manko an Threema ist der proprietäre Code. Weder die Apps, noch die Server sind Open Source und lassen sich daher nicht unabhängig verifizieren. Es gab 2015 aber eine offizielle Überprüfung (Audit Security Statement), der keine Schwächen in der Verschlüsselung zu Tage förderte.

Die Threema-App steht zudem nur für die großen Drei zur Verfügung: iOS, Android und Windows. Nischensysteme wie Sailfish OS, Ubuntu Touch etc. pp. sind nicht unterstützt.

In der Abwägung zwischen Sicherheit auf der einen Seiten und Praktikabilität und Verbreitung auf der anderen Seite würde ich gegenwärtig jedoch immer Threema empfehlen. Sicherere Alternativen haben vor allem den Charakter theoretische Studien, während so manche halb-quelloffene Alternative im direkten Sicherheitsvergleich abfällt.

Links: