staging.inyokaproject.org

2021 Woche 46

21. November 2021

Erstmal ein paar Sätze zu meinem beruflichen Hintergrund:

Seit Ende meines Studiums arbeite ich bei einem kleinen Unternehmen, welches IT-Forensik bzw. e-Discovery betreibt. Dort entwickle ich, zusammen mit meinen Kollegen, eine Pipeline zur Analyse von Kommunikationsdaten (Vorrangig in Python und Java). Ein wichtiges Merkmal unserer IT-Infrastruktur ist, dass unsere Server und Entwickler-PCs keinen Internetzugang besitzen. Zum Surfen und E-Mails schreiben haben alle Mitarbeiter einen zusätzlichen Laptop oder PC zur Verfügung. Jedes Programm muss also ohne Internetzugang funktionieren und darf auch keine externen Daten nachladen.

Was nach einer trivialen Anforderungen klingt, stellte sich z.B. beim Finden einer Alternative zu Jira als ein sehr großes Problem heraus. Wenn man rein auf OSS-Programme setzen will, kommt man irgendwann an einen Punkt an dem das Programm einen normalen Internetzugang verlangt (Weil z.B. Javascript-Bibliotheken von externen Servern nachgeladen werden). In der Welt von nahezu allen OSS-Entwicklern gibt es anscheinend die Einstellung, dass jeder Server einen Zugang zum Internet haben muss, egal wie sensibel die darauf abgelegten Daten auch sein mögen. Das ist aber ein anderes Thema.

Das Problem

Ich suchte eine einfache und unkomplizierte Möglichkeit die diversen Statusnachrichten unserer Server bzw. NAS an einer zentralen Stelle zu sammeln.

Einfach und unkompliziert heißt folgendes:

  1. Kein SNMP, da dessen Einsatz den Kosten/Nutzenfaktor in unserem kleinen Netzwerk übersteigt. Unsere Infrastruktur ist aktuell noch recht überschaubar (Ca. ein Dutzend Server und NAS).
  2. Kein interner Mail-Server, da er auch zu pflegen und er nur für den Versand und Empfang von Statusmeldungen vorhanden wäre. Dazu käme dann noch ein E-Mail-Client auf meinem Rechner, der nur für diese Meldungen da wäre und sonst nichts weiteres.
  3. Die einzelnen Programme sollten einfach so ihre Statusmeldungen versenden können, ohne dass man den Quellcode verändern muss.

Die Lösung

Da wir zur internen Kommunikation RocketChat einsetzen, lag es nahe die Statusmeldungen direkt an diesen Server zu senden. Leider konnte ich keine Software finden, welches es ermöglicht auf einfache Weise eine E-Mail an einen RocketChat-Server zu senden. Es gibt zwar Tools, welche z.B. nach Nachrichten auf normalen E-Servern lauschen und diese dann an RocketChat weiterleiten. Aber das führt dann wieder zu Ausschlusskriterium #2 (Kein zusätzlicher E-Mail-Server).

Am Ende blieb mir nichts anderes übrig als das Gateway selbst zu programmieren. Ich wollte dies zuerst in Python erledigen, da es eine brauchbare API für RocketChat gibt. Leider hat Python immer noch Riesenprobleme, wenn es um die Handhabung von EML-Dateien (Sprich E-Mails) und UTF-8 geht (Die Kodierung eines HTML-formatierten E-Mail-Body löste reproduzierbar eine Exception aus, welche ich nicht ohne Weiteres beseitigen konnte).

Der einzig sinnvolle Weg war die Teile der RocketChat-API in Java zu implementieren, welche ich zwingend benötigte (Senden von Nachrichten und Anhängen an einzelne Benutzer oder Gruppen). Unter Java hatte ich nämlich noch nie Probleme beim Verarbeiten von E-Mails (Die Zahl der verarbeiteten E-Mails in unserer Pipeline dürfte sich langsam auf eine Milliarde zubewegen).

Zusätzlich gibt es in Java eine sehr gute Bibliothek namens SubEthaSMTP bzw. deren Fork zum Implementieren eines SMTP-Servers:

https://github.com/davidmoten/subethasmtp

Der Riesenvorteil an dieser Bibliothek ist, dass sie sehr einfach einzusetzen ist und sie auch die Möglichkeit anbietet eine Authentifizierung zu aktivieren (z.B. Benutzername und Passwort). Denn einige Programme oder Serverdienste (z.B. TrueNAS) verlangen einen Benutzernamen und ein Passwort beim Einrichten der SMTP-Verbindung. Auch SSL bzw. TLS stellen in Verbindung mit einer Zusatzbibliothek kein großes Problem dar.

Das Gateway macht am Ende nichts anderes als einen SMTP-Server bereitzustellen und die ankommenden E-Mails je nach Empfänger an den passenden RocketChat-Benutzer oder die passende Gruppe weiterzuleiten. Dabei werden HTML-Nachrichten in Textnachrichten konvertiert und die originale HTML-Nachricht als Datei versendet. Das wurde deshalb so implementiert, da RocketChat aus Sicherheitsgründen keine HTML-Nachrichten darstellen kann und der Markdownparser nicht alle benötigten Tags (z.B. Tabellen) unterstützt. Normale Dateianhänge werden ebenfalls als Datei versendet.

Zwei Voraussetzungen hat das Gateway:

  1. Man muss einen Bot-Nutzer auf dem RocketChat-Server anlegen.
  2. Dieser muss das Recht haben die E-Mail-Addressen aller Benutzer auszulesen. Am besten legt man dafür eine zusätzliche Bot-Gruppe an, welche nur vom Gateway-Bot benutzt wird.

Optional kann eine „spam“-Gruppe angelegt werden. Dort landen dann, wenn man möchte, alle E-Mails deren Empfänger nicht bekannt ist. So sieht man sehr schnell, bei welchen Diensten man noch nachbessern muss.

Jetzt reicht es in den jeweiligen Programmen bzw. Webdiensten den SMTP-Server des Gateways und eine passende Empfängeraddresse anzugeben um E-Mails als RocketChat-Nachrichten zu empfangen.

Download des Programms

Ich habe das Gateway auf meinem Github-Account gehostet:

https://github.com/glasen/rocketgateway

„Digitale Souveränität“ und solche Abkömmlinge wie „souveräner Arbeitsplatz“ gehören seit einiger Zeit zum politischen Wortschatz. Dieser Artikel thematisiert, warum die aktuell anvisierten Maßnahmen dieses Ziel nicht erreichen können und allen ein verbales Abrüsten im Sinne eines allgemeinen Realismus guttäte.

Digitale Souveränität gehört zu jenen Grundbegriffen, die gerne in einem Atemzug mit Datenschutz oder Datensicherheit genannt werden, aber im Grunde genommen nur wenige Schnittmengen haben.

Wikipedia enthält folgendes zur Bedeutung des Begriffes:

Abgeleitet von dem Begriff der Souveränität versteht man unter digitaler Souveränität selbstbestimmtes Handeln unter vollständiger, eigener Kontrolle im Hinblick auf die Nutzung digitaler Medien. Der Begriff beschreibt zum einen die Notwendigkeit des souveränen Handelns in direktem Umgang mit digitalen Medien (z. B. Smartphones, Tablets, Internet etc.). Zum anderen erwarten Experten, dass die Entwicklung von digitaler Souveränität auch in verschiedenen anderen Bereichen (z. B. Kultur, Bildung, Politik und Forschung) indirekt „zukünftig stark über Nutzung und Erfolg“ entscheiden wird.

Wikipedia Artikel „Digitale Souveränität“, abgerufen am 21.11.2021

Das ist ein eher unscharfer Zugriff, deshalb lohnt sich noch ein Blick in den Artikel zur Souveränität. Dort steht:

Unter dem Begriff Souveränität (französisch souveraineté, aus mittellateinisch superanus ‚darüber befindlich‘, ‚überlegen‘) versteht man in der Rechtswissenschaft die Fähigkeit einer natürlichen oder juristischen Person zu ausschließlicher rechtlicher Selbstbestimmung. Diese Selbstbestimmungsfähigkeit wird durch Eigenständigkeit und Unabhängigkeit des Rechtssubjektes gekennzeichnet und grenzt sich so vom Zustand der Fremdbestimmung ab. In der Politikwissenschaft versteht man darunter die Eigenschaft einer Institution, innerhalb eines politischen Ordnungsrahmens einziger Ausgangspunkt der gesamten Staatsgewalt zu sein.

Wikipedia Artikel „Souveränität“, abgerufen am 21.11.2021

Das Vorhaben wird aus mindestens fünf Gründen nicht gelingen und bestenfalls in Teilen umgesetzt werden können:

  1. Markenrechte
  2. (Unfreie) Treiber
  3. (Unfreie) Firmware
  4. Souveräne Infrastruktur
  5. Dienstleister

1. Rechte und ihre Folgen

Open Source klingt immer so ganz wunderbar frei. Code von einer weltweiten Community gemeinsam geschrieben unter einer freien Lizenz usw. usf. Leider ist dem nicht so, weil sich Open Source in ein festgefügtes (juristisches) System einfügen musste. Das Problem hatte ich in einem anderen Kontext schon am Beispiel von Fedora deutlich gemacht. Auf der Webseite von Fedora steht im Abschnitt Download:

Durch das Herunterladen von Fedora, erklären Sie sich mit den folgenden Nutzungsbedingungen einverstanden.

Indem Sie Fedora Software herunterladen, bestätigen Sie, dass Sie das Folgende verstehen: Fedora Software und technische Informationen kann Exportkontrollvorschriften der USA (U.S. Export Administration Regulations, “EAR”) und weiteren Gesetzen der USA und anderer Länder unterliegen und darf nicht ausgeführt, wieder ausgeführt oder weitergeleitet werden (a) in irgendein Land, das in Ländergruppe E:1 des Supplement No. 1 zu EAR Part 740 aufgeführt ist (momentan Kuba, Iran, Nordkorea, Sudan und Syrien); (b) an irgendein Ziel oder irgendeinen Endbenutzer, dem die Teilnahme an US Exporttransaktionen durch irgendeine Bundesbehörde der US Regierung untersagt ist; oder (c) zum Gebrauch in Verbindung mit der Konstruktion, der Entwicklung oder Herstellung von nuklearen, chemischen oder biologischen Waffen oder Raketensystemen, Trägerraketensystemen oder Höhenforschungsraketen oder unbemannten Luftfahrzeugsystemen. Sie dürfen Fedora Software oder technische Informationen nicht herunterladen, wenn Sie sich in einem der genannten Länder befinden oder auf eine andere Weise diesen Einschränkungen unterliegen. Sie dürfen Fedora Software oder technische Informationen weder Personen noch Einrichtungen zur Verfügung stellen, die sich in einem dieser Länder befinden oder auf eine andere Weise diesen Einschränkungen unterliegen. Weiterhin sind Sie für die Einhaltung rechtlicher Anforderungen anderer Länder bezüglich Einfuhr, Ausfuhr und Benutzung von Fedora Software und technischer Informationen verantwortlich.

Fedora Workstation herunterladen, abgerufen am 21.11.2021

Von der Nutzung sind also alle jene Staaten ausgeschlossen, die sich gerade in einem tiefer gehenden Konflikt mit den USA befinden und die Verwendung wird auch stark beschränkt. Souveränität wäre das nicht. Das betrifft jedwede Software bzw. Marken, deren Rechteinhaber in den USA sitzen. Die meisten davon sind halt nur nicht so transparent und schreiben das auf der Webseite.

Für einen „souveränen Arbeitsplatz“ bräuchte man also mindestens eine Distribution, die nur Software enthält, deren (Marken-)rechteinhaber auch in Deutschland sitzen. Alle anderen Projekte müssten geforkt und von problematischen Bestandteilen bereinigt werden. So wie Debian das lange bei Firefox und Thunderbird getan hat. Faktisch läuft das auf eine eigene Distribution hinaus.

2. (Unfreie) Treiber

Diese Distribution müsste man auf Hardware installieren. Leider ist es mit der freien Treiberversorgung nicht so weit her, wie wir alle gerne glauben. Das liegt daran, dass die allermeisten Distributionen standardmäßig unfreie Treiber bzw. sogenannte Firmware-Blobs mitliefern. Jeder, der mal seine Hardware nur mit Debian main oder Trisquel zum Laufen bringen wollte, weiß worum es geht.

Ein „souveräner Arbeitsplatz“ mit unfreien Treibern schließt sich aus, weil die Hardware- bzw. Treiberhersteller im Fall der Fälle die Zusammenarbeit einstellen würden und man vor dem gleichen Problem stünde wie nun mit Microsoft. Ausgenommen Hardwarehersteller mit Sitz in Deutschland – ein sehr vielfältiges Angebot also.

3. (Unfreie) Firmware

Ein Betriebssystem ist nett, aber längst nicht mehr alles, was heute so auf einem normalen Gerät läuft. Unter dem saloppen Begriff „Firmware“ verbirgt sich bei den meisten Herstellern quasi ein Betriebssystem unter dem Betriebssystem. UEFI, Intel Active Management Technology (früher „Intel Management Engine“). usw. usf. Ich erzähle hier wahrlich nichts Neues.

Ein kleines Beispiel: Mein HP EliteBook kann im UEFI selbstständig über eine Internetverbindung Updates für die Firmware beziehen, ohne dass mein Betriebssystem gestartet ist.

Ein „souveräner Arbeitsplatz“ dürfte nur Hardware beinhalten, über die man auch wirklich die Kontrolle hätte. Also dürfte man eigentlich nur aus dem reichhaltigen Pool an deutschen Hardwareproduzenten schöpfen.

4. Souveräne Infrastruktur

Ein „souveräner Arbeitsplatz“ existiert nicht ohne souveräne Infrastruktur. Inklusive einer vollständigen Hoheit über die Rechenzentren und Datenübertragung. Das führt auch in Bereiche, wie die Auseinandersetzung, um den Einsatz von Huawei-Hardware im Mobilfunknetz. Es gibt hier somit Schnittstellen zu anderen strittigen Themen.

In den vollständig „souveränen Rechenzentren“ dürfte natürlich keine Hardware mit unfreien Treibern und unfreier Firmware (siehe oben) stehen, um auch wirklich die Kontrolle über Hard- und Software zu haben.

Diese umfassende Infrastruktur müsste entweder direkt von staatlichen Stellen oder von vertrauenswürdigen Dienstleistern betrieben werden, womit wir beim nächsten Problem wären.

5. Dienstleister

Es dürfte unstrittig sein, dass es der öffentlichen Hand unmöglich ist, das komplette Portfolio eines „souveränen Arbeitsplatzes“ selbst anzubieten. Spätestens durch die Einbeziehung der Hardware wäre hier eine Grenze erreicht.

Deshalb benötigt man Dienstleister und hier beginnt das Problem. Wenn der „souveräne Arbeitsplatz“ dann wie die Corona Warn App von SAP oder T-Systems programmiert wird, mag das noch klappen, aber hinter der jüngst spektakulär gescheiterten ID wallet stand letztlich IBM. Wie souverän ist ein Arbeitsplatz, der letztlich doch wieder von amerikanischen IT-Konzernen programmiert wird?

Natürlich, es soll alles freie und offene Software sein, aber jedem dürfte klar sein, dass man hier im Fall der Fälle nicht einfach den Git-Zugang einem anderen Dienstleister geben und sagen kann „mach da weiter“.

Es bedürfte also umfassender Kriterien und Sicherheitsüberprüfungen, um herauszufinden, wer als Dienstleister für den „souveränen Arbeitsplatz“ infrage käme. Insbesondere kleinere Dienstleister mit unzureichenden Sicherheitsstandards könnten sonst ein Einfallstor für Spionage usw. usf werden.

Zusammengefasst

Es wird keinen „souveränen Arbeitsplatz“ geben. Dabei handelt es sich nur um einen politischen Modebegriff, auf den zu viele gerade anspringen. Letztlich gibt es bestenfalls einen in Teilen quelloffenen Arbeitsplatz. Also wenn man so will einen „Open Source Arbeitsplatz“, von dem man auch noch abwarten muss wie „Open“ der sein wird und ob nicht letztlich doch wieder die großen IT-Konzerne mitarbeiten. Hört sich gleich viel weniger sexy an.

Der Artikel Warum ein „souveräner Arbeitsplatz“ Utopie bleibt erschien zuerst auf [Mer]Curius

20. November 2021

Irgendwie hat das Thema nun zu Jahresende Konjunktur. Vermutlich weil man sich langsam über die guten Neujahrsvorsätze Gedanken machen kann. Der Staat will mal wieder auf Open Source umsteigen. Anstelle digitaler Zukunftsthemen reden wir aber über LibreOffice.

Ich möchte das gleich vorweg schreiben, weil das in den bisherigen Blogbeiträgen zu dem Thema vielleicht nicht so deutlich wurde:

Natürlich bin ich für den Einsatz von Open Source im Staatseinsatz. Mir fällt auch gar kein Grund ein, warum man dagegen sein sollte. Ich finde es auch gut, wenn der Staat hier die Initiative ergreift, langfristige Konzepte entwirft, daraus Strategie entwickelt und dem auch Taten folgen lässt. Der Trend zu Open Source-Lösungen ist ungebrochen und ich kann keine Organisation verstehen, die sich im Jahr 2021 sehenden Auges bei gleichwertigen Open Source-Alternativen auf proprietäre Software einlässt. Allerdings sehe ich auch nicht, dass dies blindlings irgendwo passieren würde.

Das ist auch für das Kernthema dieses Blogs – Datenschutz und digitale Privatsphäre – ein sehr relevantes Thema, weil jedwede Absicherung im privaten Umfeld wenig Sinn macht, wenn die staatlicherseits erhobenen Daten völlig unzureichend gesichert z. B. in die AWS-Cloud übertragen werden.

Was ich nicht leiden kann – und deshalb schreibe ich diese Blogartikel – sind weltfremde Debatten von IT-Redakteuren, die keine Ahnung vom Staatsbetrieb haben, auf jede PR-Meldung unhinterfragt aufspringen und keine Mühe auf Recherche verwenden. Flankiert von Kommentatoren, bei denen man sich bei der einen Hälfte wirklich fragen muss, ob sie überhaupt schon mal in einem ernst zu nehmenden Großunternehmen (denn nichts anderes ist der Staat) tätig waren und bei der anderen ob ihr Renteneintritt schon vor dem Jahr 2000 war. Das ganze Thema dann noch befeuert, von einer Open Source-Community, die in substanziellen Teilen im Gestern lebt und die Zukunft geflissentlich ignoriert.

Denn genau das konnte man diese Woche wieder mal beobachten. Schleswig-Holstein hat als einziges Bundesland eine ernst zu nehmende Open Source-Strategie. Die Absichtserklärung kann man hier nachlesen. Diese Erklärung ist durchaus interessant zu lesen, es werden Verweise auf die Bedeutung von Daten im 21. Jahrhundert und eine zunehmende Digitalisierung der öffentlichen Verwaltung geschrieben. Es geht um Webauftritte, Intranet-Services, Kollaborationsplattformen usw. usf.

Dabei ist es nicht so, dass sich die Projekte Schleswig-Holsteins in dieser Absichtserklärung erschöpfen würde – so wie das bei vielen anderen Ländern und dem Bund gegenwärtig der Fall ist. Einen ausführlicheren neueren Bericht mit verlinkten Videos kann man hier lesen. Da geht es dann um Projekte wie die dPhoenixSuite oder Nextcloud in der Verwaltung. Das sind meiner Meinung nach die wirklich interessanten Open Source-Projekte für den öffentlichen Dienst. Denn hier geht es auch um die Frage, welche Dienstleister man betraut und was man durch Firmen der öffentlichen Hand abdecken möchte. Das sind keineswegs triviale Fragen, weil ein Dienstleister nicht automatisch vertrauenswürdig wird, nur weil er aus Deutschland kommt. Der Bund muss das gerade schmerzlich erfahren, denn der Chef des Dienstleisters für die Absicherung der Kommunikation steht im Verdacht Verbindung zum flüchtigen Jan Marsalek gehabt zu haben (s. schriftliche Anfrage der Linkspartei und Bericht des SPIEGEL).

Und worüber berichtet die „Presse“: Die geplante Migration auf LibreOffice und die lose anvisierte Umstellung auf Linux in ferner Zukunft. Echt jetzt? Zumal bei LibreOffice bzw. The Document Foundation nicht mal klar ist, ob es ein offizielles Supportvertragsverhältnis gibt.

Ich bin mir nicht sicher, ob diese Berichte mehr über die Community oder das Staatsbild der Berichterstatter aussagt. Hängt die Open Source-Community wirklich noch so am Desktop und irgendwelchen an Anciennität kaum zu überbietenden Softwarelösungen wie LibreOffice, dass man unfähig ist, die Gegenwart, geschweige denn die Zukunft zu sehen? Oder glaubt man wirklich, der Staat wäre so wenig digitalisiert, dass es ein bisschen Desktop und eine Office-Suite schon tut? Oder schreibt man einfach nur Pressemitteilungen der TDF ab, weil die auch dringend mal wieder positive Neuigkeiten brauchen? Immerhin taumelt das LibreOffice-Projekt in der jüngeren Vergangenheit eher als eine zielgerichtete Projektentwicklung zu kommunizieren.

Ganz nebenbei kann man das Projekte auch mal einordnen. Das ist bisher auch vollständig ausgeblieben. Schleswig-Holstein ist ein Bundesland, das hört sich natürlich erst mal groß an. Deshalb ist eine Zahl sehr interessant, die nur in einem einzigen Artikel – nämlich bei Golem – erwähnt wurde: 25.000. Das sind alle Arbeitsplätze, um die es geht. Das beinhaltet alle Landesbeamten und -angestellten inklusive der Lehrkräfte. Jeder kann diese Zahl wohl einordnen. Das Projekt ist nicht klein, klein wären die Vorhaben von z. B. Dortmund, aber groß ist auch was anderes. Nur mal so zum Vergleich, die Stadt München – um mal an ein früheres Projekt zu erinnern – hat ausweislich offizieller Informationen fast 40.000 Mitarbeiter. Viele Firmen oder auch nur Universitäten mit angeschlossenen Unikliniken kommen auf Mitarbeiter- bzw. Arbeitsplatzzahlen, die von den Zahlen in Schleswig-Holstein nicht so weit entfernt sind. Es ist eben auch „nur“ Schleswig-Holstein – nicht gerade das flächen- oder bevölkerungsmäßig größte deutsche Bundesland. Die Reichweite solcher Maßnahmen ist deshalb auch begrenzt. Ein umtriebiger, öffentlichkeitswirksamer und in der Community gut gelittener Digitalminister kann das auch nur begrenzt ausgleichen.

Das führt zu einem weiteren Punkt. Es gibt zig interessante Projekte im Staatsumfeld, wo Open Source evaluiert oder die Migration bereits angestoßen ist. Das sind teilweise riesige Unterfangen mit großen Budgets, vielen betroffenen Mitarbeitern und noch mehr betroffenen Bürgern. Ich hatte da mal für einen Spezialfall berichtet. Diese Projekte werden selten thematisiert, weil sie ganz offenkundig den Horizont der Journalisten der großen IT-Medien und der Community übersteigen. Die kennen nur „Linux“ und „LibreOffice“. Und damit will man die Zukunft repräsentieren?

Trotzdem wäre es natürlich schön, wenn Schleswig-Holstein Erfolg haben sollte und 2026 wirklich Microsoft Office ablöst und anschließend die Linux-Migration auf dem Desktop startet. Mal sehen, ob es 2030-2035 noch Desktopsysteme nach heutigem Vorbild gibt. Denn das sind die Zeiträume, von denen wir hier reden.

Der Artikel Staat und Open Source – Diese Woche Schleswig-Holstein erschien zuerst auf [Mer]Curius

19. November 2021

Die MZLA Technologies Corporation hat mit Thunderbird 91.3.2 ein Update für seinen Open Source E-Mail-Client veröffentlicht.

Neuerungen von Thunderbird 91.3.2

Mit dem Update auf Thunderbird 91.3.2 hat die MZLA Technologies Corporation ein Update außer der Reihe für seinen Open Source E-Mail-Client veröffentlicht und behebt damit mehrere Fehler der Vorgängerversion. Diese lassen sich in den Release Notes (engl.) nachlesen.

Der Beitrag Thunderbird 91.3.2 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

17. November 2021

Mo, 15. November 2021, @65536@troet.cafe

Die Installation von NixOS stelle eine gewisse Hürde dar. NixOS verfügt nicht über einen komfortablen GUI-Installer wie Calamares oder Anaconda. Es stehen ISO-Images für Livesysteme zur Verfügung, welche eine ausführliche Anleitung und die Kommandozeilenwerkzeuge zur Installation beinhalten. Allerdings ist auch nicht allzu viel Vorwissen zur Installation nötig. Neben Englischkenntnissen zum Lesen der Anleitung ist lediglich das händische Partitionieren und Mounten wichtig, falls man von dem vorgegebenen Beispiel abweichen möchte.

Wichtig: diese Artikelserie soll weniger eine Anleitung darstellen, als eine grobe Vorstellung davon zu vermitteln, was den Interessierten bei NixOS erwartet.

Dokumentation finden

Es sind einige Dokumentationen verfügbar, um mit den zahlreichen Optionen der Konfigurationsdatei und den Nix-Befehlen etwas anfangen zu können. NixOS bringt die besagte Anleitung mit, die wahlweise mit nixos-help, als Eintrag im Anwendungsmenü oder unter https://nixos.org/manual/nixos/stable zu finden ist. Darüber hinaus gibt es https://search.nixos.org zum Finden von Paketen und Konfigurationsoptionen sowie das inoffizielle Nixos-Wiki, welches zwar bei einigen Dingen weiterhilft, an manchen Stellen aber etwas knapp oder veraltet ist. Das liegt an der vergleichsweise kleinen NixOS-Community.

Festplatte partitionieren

Die Partitionierung erfolgt manuell im Terminal, beispielsweise mit parted. Im Live-System ist dazu sudo su ohne Passwort möglich, da hier ein Passwort sinnlos wäre. Sofern man mit der Beispielpartitionierung der Anleitung zufrieden ist (boot, Swap und eine grosse unverschlüsselte ext4-Partition), kann man der Anleitung folgen, andernfalls sollte man die nötigen Befehle kennen oder nachschlagen. Die Partitionen müssen dann passend formatiert und so eingehängt werden, dass /mnt/ die Wurzel der neuen NixOS-Instanz darstellt.

Konfiguration generieren

Mit nixos-generate-config --root /mnt werden automatisch zwei Dateien in /mnt/etc/nixos/ angelegt. configuration.nix ist diejenige der beiden, die bearbeitet werden sollte. Es ist empfehlenswert, dazu insbesondere die Anleitungsabschnitte '13. Networking' sowie wahlweise '9. X Window System', '10. Wayland', oder einen gesonderten Abschnitt zu Gnome, Pantheon oder XFCE anzusehen. Definitiv sollte die Konfigurationsdatei auch einmal samt Kommentaren sorgfältig durchgelesen werden, um Dinge wie Zeitzone, Tastaturschema, Sound und zusätzliche Software korrekt zu deklarieren. Selbstverständlich sollte die Konfiguration anschliessend gespeichert und geschlossen werden.

NixOS installieren

nixos-install ist nun alles, was zur Installation nötig ist. Das System wird so aufgesetzt, wie es die Konfiguration vorschreibt, und keinerlei manuelles Kopieren oder weiteres Installieren und Konfigurieren ist nötig. All das wurde ja schon im vorherigen Schritt getan. Zum Abschluss des Installationsbefehls fragt dieser nach dem gewünschten Rootpasswort, und ein zweites Mal zur Bestätigung. Dann kann neu gestartet werden, anstatt ins Livemedium in die frische Installation. Sofern nicht bereits deklarativ geschehen, sollte man nun im Textmodus den Alltagsbenutzer erstellen und ein Passwort vergeben, um nicht den Rootaccount nutzen zu müssen. Das ist auch imperativ mit den klassischen Befehlen useradd und passwd möglich.

Konfiguration ändern

Die Datei /etc/nixos/configuration.nix kann jederzeit angepasst werden, um die verfügbare Software, aktivierten Dienste und vieles mehr zu ändern. sudo nixos-rebuild boot wendet die Datei neu auf das System an, so, dass beim nächsten Systemstart die neue Konfiguration gilt. Ungeduldige können sie stattdessen mit sudo nixos-rebuild switch sofort anwenden. Manche Desktopumgebungen benötigen dann jedoch wenigstens ein Ab- und Anmelden, um neue Software wahrzunehmen.

Sehr hilfreich ist hierbei die Suchseite von NixOS nicht nur zum Finden der richtigen Pakete, sondern auch um die benötigten Einstellungsoptionen zu ermitteln.

Booteinträge verstehen

Jeder nixos-rebuild legt einen neuen Eintrag im Bootmenü an. Geht etwas schief, kann man somit einfach einen älteren, funktionierenden Systemzustand auswählen. Diese Systemstände sind alle im Nix-Store abgelegt. Wie man ältere Stände loswird, um Speicherplatz freizugeben, wird im nächsten, dritten Teil dieser Artikelserie behandelt werden.

Links

https://nixos.org/
https://nixos.org/manual/nixos/stable/
https://nixos.wiki/
https://search.nixos.org/options

16. November 2021

Firefox Relay ist ein kostenloser Dienst von Mozilla, der die persönliche E-Mail-Adresse vor Spam und unerwünschter Offenlegung schützt. Nun hat Mozilla mit Firefox Relay Premium ein kostenpflichtiges Zusatz-Angebot gestartet.

Was ist Firefox Relay?

E-Mail-Adressen sind gleichzusetzen mit einer persönlichen Adresse. Sie sind einmalig und viele Nutzer besitzen nur eine einzige E-Mail-Adresse, die sie teilweise auf dutzenden, wenn nicht gar auf hunderten Websites verwenden. Findet auf einer Website, auf der man mit seiner E-Mail-Adresse registriert ist, ein Datendiebstahl statt, wird damit in vielen Fällen auch die persönliche E-Mail-Adresse offengelegt. Und haben Spammer erstmal eine E-Mail-Adresse in ihrem System, darf man sich auf viele unerwünschte E-Mails ohne realistische Hoffnung einstellen, dass der Spam abnehmen wird.

Mit Firefox Relay können Alias-Adressen angelegt werden, die der Nutzer für Newsletter-Anmeldungen und Website-Registrierungen angeben kann. Firefox Relay leitet diese E-Mails dann an die persönliche E-Mail-Adresse weiter.

Die Nutzung von Firefox Relay ist kostenlos. Stand der Dienst bisher nur in englischer Sprache verfügbar, gibt es Firefox Relay jetzt auch in deutscher Sprache.

Firefox Relay Premium

Außerdem bietet bietet Mozilla ab sofort in diversen Ländern, darunter auch Deutschland, Österreich und die Schweiz, Firefox Relay Premium an. Der zeitlich begrenzte Einführungspreis beträgt 0,99 EUR respektive 1,00 CHF pro Monat.

Mit Firefox Relay Premium können unendlich viele statt wie bisher maximal fünf Alias-Adressen angelegt werden. Weiter ist es mit Firefox Relay Premium möglich, seine eigene E-Mail-Domain zu erhalten. Statt <id>@relay.firefox.com werden die Adressen dann <id>@<eigene_domain>.mozmail.com heißen. Außerdem ermöglicht es Firefox Relay Premium im Gegensatz zur kostenfreien Basis-Version, auf weitergeleitete E-Mails zu antworten.

Firefox Relay Premium

Firefox Relay Premium

Firefox Relay Premium

Firefox Relay Premium

Der Beitrag Mozilla startet Firefox Relay Premium erschien zuerst auf soeren-hentzschel.at.

Die MZLA Technologies Corporation hat mit Thunderbird 91.3.1 ein Update für seinen Open Source E-Mail-Client veröffentlicht.

Neuerungen von Thunderbird 91.3.1

Mit dem Update auf Thunderbird 91.3.1 hat die MZLA Technologies Corporation ein Update außer der Reihe für seinen Open Source E-Mail-Client veröffentlicht und behebt damit mehrere Fehler der Vorgängerversion. Diese lassen sich in den Release Notes (engl.) nachlesen.

Der Beitrag Thunderbird 91.3.1 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

Di, 16. November 2021, Lioh Möller

Kurz nach der Veröffentlichung von AlmaLinux 8.5 (wir berichteten) zieht das Rocky Linux Projekt mit einer neuen Minor-Version nach.

Diese beinhaltet erstmals Secure Boot Unterstützung und die bereits im Upstream Red Hat Enterprise Linux enthaltenen Neuerungen:

  • Ruby 3.0
  • nginx 1.20
  • Node.js 16
  • PHP Version 7.4.19
  • Squid Version 4.15
  • Mutt Version 2.0.7
  • GCC 11
  • LLVM 12.0.1
  • Rust 1.54.0
  • Go 1.16.7
  • OpenJDK 17 und aktualisierte Versionen von OpenJDK 11 sowie OpenJDK 8

Darüber hinaus wird nun bei einer Netzwerkinstallation automatisch mithilfe des FastestMirror DNF Plugins der schnellste Spiegelserver gewählt.

Das sogenannte plus Repository, welches Zusatzsoftware enthält, beinhaltet neu Thunderbird mit PGP Unterstützung und OpenLDAP Serverpakete.

Das rockypi Repository wurde um einen rasperrypi2-Kernel für Raspberry Pi spezifische AArch64 Unterstützung erweitert.

Mithilfe von pkgcompare lassen sich Abweichungen im Projekt im Vergleich zum Upstream auf einfache Weise ermitteln.

Release Notes: https://docs.rockylinux.org/release_notes/8.5/
Download: https://rockylinux.org/download/

15. November 2021

In vielen Blogbeiträgen schreibe ich wie selbstverständlich von der „verschränkten Datenschutz- und Open Source-Community“. Doch was meine ich damit eigentlich?

Das war eine berechtigte Frage, die mich erreichte und ich habe das tatsächlich noch nie erklärt. Wohl, weil es mir (nichts für ungut) trivial erschien. Mit dieser Bezeichnung möchte ich niemanden herabwürdigen oder irgendetwas konstruieren.

Es gibt rund um die Themen „Datenschutz“ und „Open Source“ Gemeinschaften, die sich mit den Themen befassen und sie voranbringen wollen. Das kann man z. B. sehr schön bei den vielen gegenseitigen Referenzierungen bei Twitter beobachten. Teilweise sind das professionelle Akteure (im Sinne, dass diese damit ihren Lebensunterhalt bestreiten), teilweise ehrenamtliche Aktivsten.

Meiner Meinung nach handelt es sich dabei zwar um zwei Communitys, aber die Überlappungszonen sind sehr ausgeprägt. Auf Akteursebene heruntergebrochen heißt das, viele Personen sind in unterschiedlicher Intensität in beiden Themenfeldern aktiv. Vermutlich könnte man das mit einer Netzwerkstudie sogar belegen, aber der Aufwand wäre natürlich enorm.

Also stark vereinfacht: Viele Open Source Enthusiasten finden, dass Datenschutz ein wichtiges Thema ist und viele Datenschutz-Aktivisten glauben, dass Open Source ein wichtiger bzw. der wichtigste Baustein bei der digitalen Selbstverteidigung ist.

Diese Verschränkung kann man beispielsweise bei den Themenfeldern sehen, mit denen sich die Electronic Frontier Foundation befasst.

Das bedeutet natürlich nicht, dass dies bei allen Akteuren so ist. Manche Open Source-Aktivisten scheren sich nicht um Überwachung (und arbeiten dann für Google…), andere Datenschutz-Aktivisten halten Open Source für ein nachrangiges Thema.

Auf diesem Grund schreibe ich häufiger mal von der „verschränkten Datenschutz- und Open Source-Community“ wenn mal wieder beide Phänomene zusammen treffen.

Der Artikel Verschränkte Datenschutz- und Open Source-Community? erschien zuerst auf [Mer]Curius

Mo, 15. November 2021, Lioh Möller

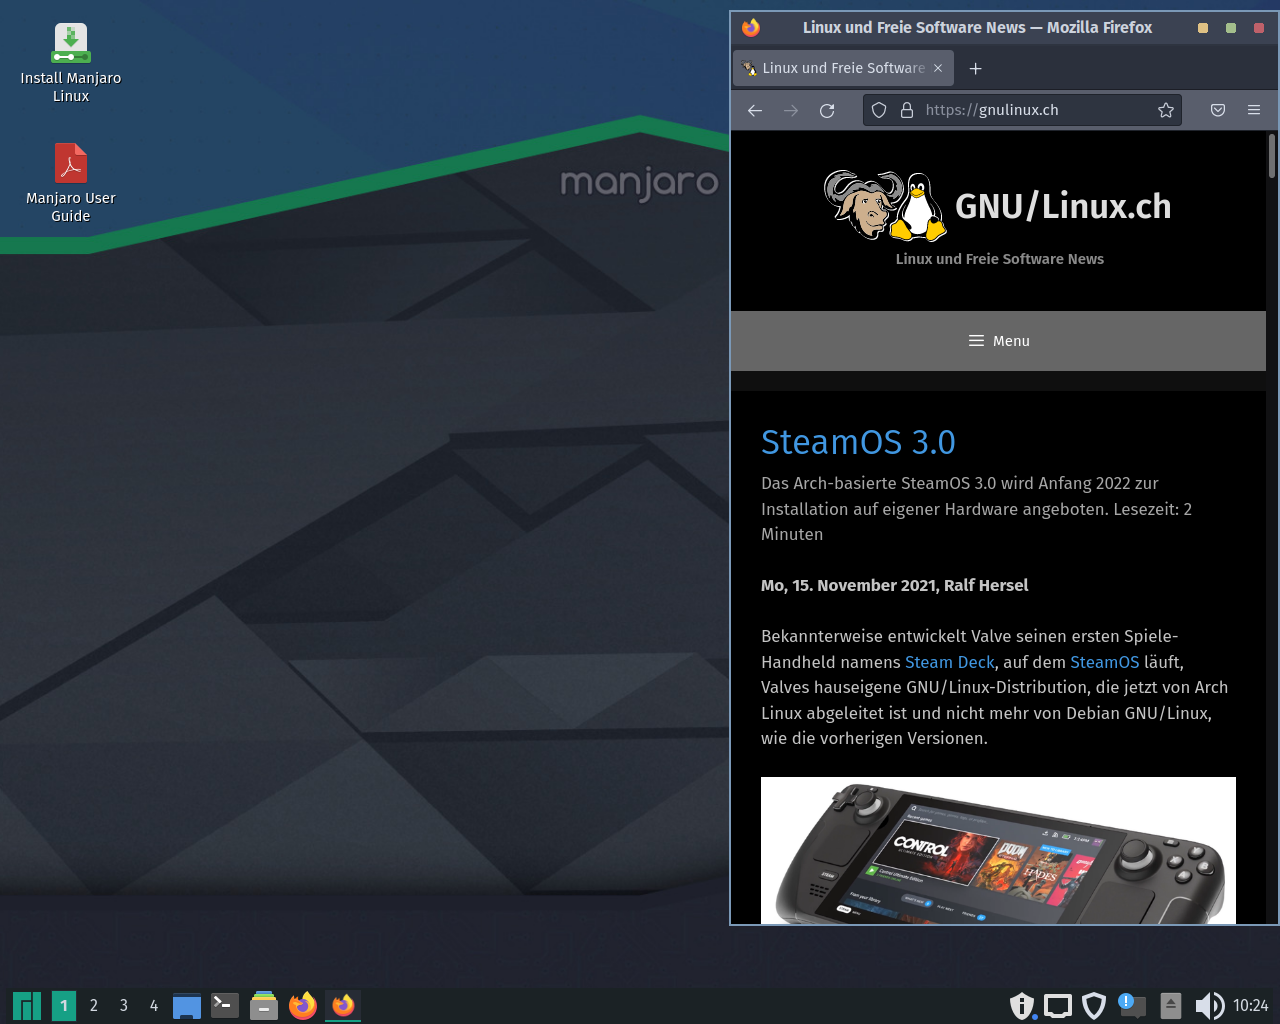
Der Manjaro Community Member Frede (auch bekannt als linux-aarhus) hat sich die Mühe gemacht einen Spin mit der aktuellen LXQt Version zu erstellen.

Dabei hat er die Installationsmedien so angepasst, dass nur Freie Treiber zum Einsatz kommen. Darüber hinaus wurden nur essenzielle Programme integriert, wodurch sich die Distribution sehr gut eignet, um ein angepasstes und leichtgewichtiges Desktopsystem zu erstellen.

Wie von Manjaro gewohnt, kommt auch beim LXQt-Spin ein ansprechendes dunkles Erscheinungsbild zum Einsatz. Das aktuell vorliegende Live-ISO eignet sich für die Nutzung auf einem Computer der x86_64 Architektur. Es bleibt zu hoffen, dass in naher Zukunft auch eine Variante für AArch64 bereitgestellt wird, da insbesondere auf Einplatinenrechnern eine leichtgewichtige Desktopumgebung sinnvoll sein kann.

Quelle: https://forum.manjaro.org/t/lxqt-unofficial-minimal-norse-root/90306
Download: http://iso.uex.dk/lxqt/

Mo, 15. November 2021, Ralf Hersel

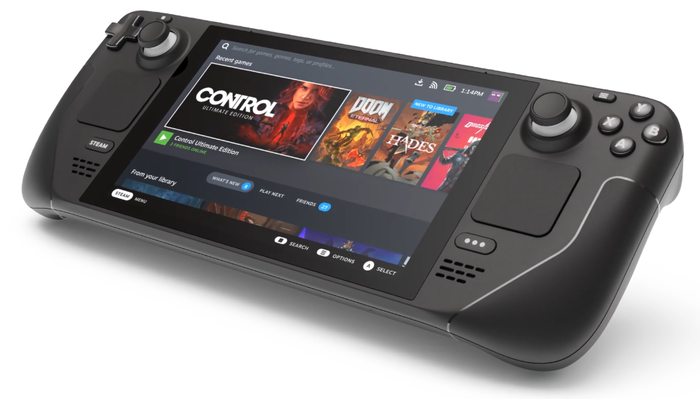
Bekannterweise entwickelt Valve seinen ersten Spiele-Handheld namens Steam Deck, auf dem SteamOS läuft, Valves hauseigene GNU/Linux-Distribution, die jetzt von Arch Linux abgeleitet ist und nicht mehr von Debian GNU/Linux, wie die vorherigen Versionen.


SteamOS konnte wie viele andere GNU/Linux-Distributionen kostenlos heruntergeladen und auf jedem beliebigen Rechner installiert werden, wenn man ihn in einen vollwertigen Spielecomputer verwandeln wollte. Valve hat seine SteamOS-Distribution auf Arch Linux umgestellt, eine leistungsstarke und flexible Rolling-Release-Distribution, wahrscheinlich um den Benutzern die neuesten Sicherheits- und Software-Updates zur Verfügung zu stellen, sobald sie im Vorfeld verfügbar sind. Ausserdem kommt der KDE Plasma Desktop auf Wayland zum Einsatz.

Aktuell ist SteamOS 3.0 noch nicht final, wird aber nach dem (verschobenen) Erscheinen des Steam Desks ab Februar 2022 als Download und für die Installation auf eigenen PCs zur Verfügung stehen. Die Distribution wird ein unveränderliches Root-Dateisystem haben, um unbefugten Zugriff zu verhindern und System-Aktualisierungen zu erleichtern. Darüber hinaus wird in Zukunft PipeWire für Audio zum Einsatz kommen.

Quelle: https://9to5linux.com/valve-says-steamos-3-0-will-be-available-for-everyone-to-download-and-install

Unter elementaryOS nutze ich neben der integrierten Paketverwaltung unter anderem auch Snappy und Flatpak. Es ist zwar unschön das sich die zentrale Paketverwaltung dadurch etwas zersplittert, aber leider existieren nicht alle benötigen Pakete in der Paketverwaltung. Bedingt dadurch fand ich den Update-Prozess allerdings etwas umständlich, sodass ich das Ganze in ein kleines Skript gegossen habe:

#!/bin/bash
apt autoremove -y && apt autoclean -y && apt update -y && apt dist-upgrade -y && apt autoremove -y && apt autoclean -y
flatpak update -y
snap refresh 
checkrestart

Mit dem Skript wird die zentrale Paketverwaltung aktualisiert, anschließend Snappy und dann Flatpak. Für die Nutzung des Kommandos checkrestart muss das Paket debian-goodies installiert werden.

Dieses Tutorial führt ein in:

Viel Spaß beim Lesen und Freude beim Nachmachen. Falls euch das Tutorial gefällt, freue ich mich über einen Kommentar. Falls ich etwas ausgelassen oder falsch dargestellt habe, freue ich mich ebenfalls über einen Hinweis in den Kommentaren oder per E-Mail.

Vorwort

Um sich im Container-Dschungel zurechtzufinden, ist eine fundierte Kenntnis der Terminologie unerlässlich. Die Einführung in die Terminologie ist jedoch nicht Bestandteil dieses Tutorials, da es den Umfang sprengen würde.

Unter folgenden Links kann man sich mit der Terminologie vertraut machen:

Leider wird die Terminologie selbst von jenen nicht stringent verwendet, die sie eigentlich kennen müssten. Dies sorgt gerade beim Einstieg in dieses komplexe Thema häufig für Verwirrung. Ich versuche in diesem Artikel so stringent wie möglich zu sein.

Umgebung

Für dieses Tutorial habe ich eine Installation mit Debian 11.1 (Bullseye) verwendet. Auf dem Host existieren die beiden User Alice und Bob, welche für die Nutzung von rootless-Podman vorbereitet werden.

Die Einrichtung von rootless-Podman unter Debian Bullseye

Rootless-Container haben die Eigenschaft, dass sie in User Namespaces (siehe user_namespaces(7) und namespaces(7)) ausgeführt werden. UIDs und GIDs, welche innerhalb des Containers existieren, werden dabei auf UIDs/GIDs des Hosts abgebildet. So besitzt ein Prozess, welcher innerhalb eines Containers mit der UID 0 (root) läuft, außerhalb des Containers bspw. die UID 165537 und damit die Rechte eines normalen Benutzers.

Damit dies funktioniert, wird jedem Benutzer, welcher in der Lage sein soll rootless-Podman-Container auszuführen, ein disjunktes Intervall sogenannter SUBUIDs und SUBGIDs zugewiesen. Dazu werden zuerst das Paket uidmap installiert und anschließend die Dateien /etc/subuid und /etc/subgid erzeugt, wie in folgendem Codeblock dargestellt.

sudo apt install uidmap
[...]
$ cat /etc/subuid
alice:100000:65536
bob:165536:65536

$ cat /etc/subgid
alice:100000:65536
bob:165536:65536

Ich habe mich hier an der RHEL 8 Dokumentation orientiert, welche am Ende des Artikels verlinkt ist. Darüber hinaus ist das Vorgehen in der Manpage podman(1) im Abschnitt „Rootless mode“ dokumentiert.

Nun werden podman und skopeo installiert, welche im weiteren Verlauf dieses Tutorials zum Einsatz kommen werden.

sudo apt install podman skopeo

Die Konfiguration von Container-Registries

In der Datei /etc/containers/registries.conf befindet sich die systemweite Konfiguration für Container-Registries. Jeder Benutzer kann abweichend von dieser eine eigene Konfiguration unter $HOME/.config/containers/registries.conf pflegen.

Bevor nun die ersten Container-Registries konfiguriert werden, möchte ich kurz auf voll-qualifizierte Image-Namen und Präfixe eingehen.

Im Internet findet man häufig Beispiele für Befehle wie podman pull ubuntu. Dabei ist podman das Kommando, pull ein Subkommando und ubuntu der Kurzname des herunterzuladenden Images.

Obige Kurznamen haben das Problem, dass durch ihre Verwendung nicht spezifiziert wird, aus welcher Container-Registry das Image heruntergeladen werden soll. Existiert ein Image mit gleichem Namen in diversen Container-Registries, wird es aus der ersten heruntergeladen, in der es gefunden wurde. Dies stellt ein potenzielles Sicherheitsrisiko dar!

Nehmen wir an, auf einem System sind die Container-Registries registry-1.de und registry-2.de konfiguriert. Das ubuntu-Image befindet sich unter registry-2.de/canonical/ubuntu. Stellt nun jemand ein Image gleichen Namens unter registry-1.de/boeserbube/ubuntu ein, wird bei Ausführung des oben genannten Kommandos mit Image-Kurznamen das falsche Container-Image heruntergeladen. Dies birgt die Gefahr, dass auf diesem Wege mit Schadcode angereicherte Container-Images ihren Weg ins System finden.

Es wird daher dringend empfohlen, stets den voll-qualifizierten Image-Namen zu verwenden, um vorstehend beschriebenes Sicherheitsrisiko auszuschließen. Der voll-qualifizierte Name hat dabei folgende Form:

host[:port]/namespace[_namespace_...]/repo(:_tag|@digest)
  • host spezifiziert den FQDN unter dem eine Container-Registry erreichbar ist, z. B. registry.fedoraproject.org.
  • port ist optional und wird verwendet, wenn die Registry nicht den Port 443/tcp nutzt.
  • namespace spezifiziert den Namensraum, in dem Container-Repos bereitgestellt werden.
  • repo bezeichnet ein Repository, aus dem konkrete Container-Images heruntergeladen werden können.
  • _tag|@digest optional können spezifische Tags oder Digests mit angegeben werden, um eine spezifische Version eines Container-Images herunterzuladen. Standardmäßig wird immer die letzte Version mit dem Tag latest heruntergeladen. Nur wenn man explizit einen Tag angibt, kann man sicher sein, welche Version man bekommt (Vielen Dank an Dirk für diesen Hinweis).

Statt einem podman pull ubuntu wird also ein podman pull registry-2.de/canonical/ubuntu empfohlen. Dabei stellt registry-2.de den Host, canonical den Namespace und ubuntu das Repository dar. Bei Verwendung der Docker-Registry führt man so nicht podman pull ubuntu aus, sondern stattdessen podman pull docker.io/library/ubuntu.

Für dieses Tutorial werden mehrere Registries durch folgenden Eintrag in der Datei /etc/containers/registries.conf konfiguriert:

unqualified-search-registries = ['registry.fedoraproject.org', 'registry.access.redhat.com', 'registry.centos.org', 'quay.io', 'registry.opensuse.org', 'registry.suse.com', 'docker.io']

Diese habe ich dem englischsprachigen Artikel unter 2 entnommen und um die Registries aus /etc/containers/registries.conf.d/shortnames.conf ergänzt. Letztere Datei stammt aus dem Paket golang-github-containers-common und stellt Aliase/Shortnames bereit, mit denen man sich einige Tipparbeit ersparen kann, da sie die Shortnames mit den entsprechenden Registries verknüpft. So sorgt z. B. der folgende Eintrag dafür, dass der Befehl podman pull rhel7 das Image ausschließlich aus der Registry „registry.access.redhat.com/rhel7“ herunterlädt und aus keiner anderen.

[aliases]
 "rhel7" = "registry.access.redhat.com/rhel7"

Auf diese Weise können Shortnames gefahrlos verwendet werden.

Bitte beachtet, dass für die Nutzung folgender Registries eine Authentifizierung notwendig ist, für die ein Account bei der jeweiligen Registry erforderlich ist:

  • registry.suse.com
  • registry.access.redhat.com
  • quay.io

Wie man sich an einer Registry authentisiert, wird im Abschnitt Anmeldung an einer Container-Registry erläutert.

Jetzt, da einige Registries konfiguriert sind, können wir zum nächsten Abschnitt übergehen und mit Podman nach Images suchen.

Die Suche von Container-Images mit Podman

Mit folgendem Kommando durchsucht man die konfigurierten Registries nach einem Image für ‚debian‘:

$ podman search debian
INDEX      NAME                                                        DESCRIPTI
ON                                      STARS   OFFICIAL  AUTOMATED
docker.io  docker.io/library/debian                                    Debian is
 a Linux distribution that's compos...  4036    [OK]      
docker.io  docker.io/smartentry/debian                                 debian wi
th smartentry                           6                 [OK]
docker.io  docker.io/library/ubuntu                                    Ubuntu is
 a Debian-based Linux operating sys...  12971   [OK]
[Ausgabe gekürzt]

Auf meinem System lieferte die Suche nach ‚debian‘ 271 Treffer zurück. Die Ausgabe wurde zur besseren Übersicht gekürzt. In der Spalte ‚INDEX‘ findet sich der Name der Registry, aus der ein Suchergebnis stammt, gefolgt von der Spalte ‚NAME‘, welche den Namen des gefundenen Repositorys enthält. Nutzer können für einzelne Repos Sterne vergeben, wenn sie diese besonders toll finden. Dies wird in der Spalte ‚STARS‘ ausgedrückt.

Laut Manpage podman-search(1) drückt ein „[OK]“ in Spalte ‚OFFICIAL‘ aus, dass es sich hierbei um ein offizielles Image handelt. Mir ist Stand heute noch unklar, wer diesen Status in den einzelnen Registries vergibt. Er ist in meinen Augen mit etwas Vorsicht zu genießen.

Die Spalte ‚AUTOMATED‘ gibt an, ob das Image automatisiert erstellt wurde und ‚DESCRIPTION‘ sollte selbsterklärend sein.

Die Suche bietet einige Filtermöglichkeiten. So kann man mit folgender Suche nach offiziellen Images filtern:

$ podman search --filter is-official debian
INDEX      NAME                      DESCRIPTION                                      STARS   OFFICIAL  AUTOMATED
docker.io  docker.io/library/debian  Debian is a Linux distribution that's compos...  4036    [OK]      
docker.io  docker.io/library/ubuntu  Ubuntu is a Debian-based Linux operating sys...  12971   [OK]

Damit ist die Ausgabe schon übersichtlicher, viele Informationen bietet sie allerdings nicht. Der folgende Abschnitt zeigt eine Möglichkeit auf, sich etwas mehr Informationen zu verschaffen.

Die Inspektion von Remote-Repos mit Skopeo

Mit skopeo können aus dem Terminal heraus weitere Informationen über ein Remote-Repo abgerufen werden, z.B. für den ersten Suchtreffer von oben:

skopeo inspect docker://docker.io/library/debian

Die Ausgabe obigen Kommandos wird hier stark gekürzt dargestellt. Neben dem Namen befinden sich darin u.a. Informationen zu vorhandenen Tags, das Erstellungsdatum, Layer und Angaben zum Environment:

{
    "Name": "docker.io/library/debian",
    "Digest": "sha256:4d6ab716de467aad58e91b1b720f0badd7478847ec7a18f66027d0f8a3
29a43c",
    "RepoTags": [
        "10.11",
[...]
       "bookworm-20211011",
        "bookworm-20211011-slim",
        "bookworm-backports",
        "bookworm-slim",
        "bullseye",
        "bullseye-20190708",
        "bullseye-20190708-slim",
        "bullseye-20190812",
        "bullseye-20190812-slim",
        "bullseye-20190910",
[...]
        "bullseye-20211011",
        "bullseye-20211011-slim",
        "bullseye-backports",
        "bullseye-slim",
        "buster",
[...]        
    ],
    "Created": "2021-10-12T01:20:30.89167925Z",
    "DockerVersion": "20.10.7",
    "Labels": null,
    "Architecture": "amd64",
    "Os": "linux",
    "Layers": [
        "sha256:bb7d5a84853b217ac05783963f12b034243070c1c9c8d2e60ada47444f3cce04
"
    ],
    "Env": [
        "PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"
    ]
}

Probiert dieses Kommando ruhig einmal selbst aus und blättert durch die sehr umfangreiche Tag-Liste. Hier wird deutlich, dass es sich um ein Repository und nicht um ein einzelnes Image handelt. Neben Bullseye lassen sich hier noch Images für Buster, Stretch, Jessie und weitere herunterladen.

Ich selbst verwende skopeo primär, um mir einen Überblick über die verfügbaren Tags zu verschaffen, um darüber das für mich am besten geeignete Image auswählen zu können.

An dieser Stelle sei darauf hingewiesen, dass zu den meisten Repos eine Webseite existiert, auf der sich weitere Informationen zu einem Repo bzw. Image finden lassen. Hier finden sich oft auch Hinweise, wie ein Image bei der Instanziierung zu parametrisieren ist.

Es braucht dann leider doch mehr als ein Werkzeug, um einen guten Überblick zu bekommen.

Anmeldung an einer Container-Registry

Bisher wurde in diesem Tutorial nur die frei zugängliche Registry „docker.io“ verwendet. Neben dieser existieren noch viele weitere Registries. Auf einige davon darf man erst nach erfolgreicher Authentifizierung zugreifen bzw. sind einige Inhalte erst nach erfolgreicher Authentifizierung zugänglich.

Meist muss man sich zuerst über die Webseite einer Registry registrieren, um Zugangsdaten zu erhalten, welche man dann im Terminal verwenden kann.

$ podman login quay.io
Username: alice
Password:
Login Succeeded!

Vorstehender Code-Block zeigt ein einfaches Beispiel für einen Login-Vorgang. Die Manpage podman-login(1) verrät, dass Benutzername und Passwort base64-codiert in der Datei ${XDG_RUNTIME_DIR}/containers/auth.json gespeichert werden. Dabei löst ${XDG_RUNTIME_DIR} zu /run/user/ auf, welches von der entsprechenden UID und Prozessen mit root-Rechten zugreifbar ist.

Hinweis: Bei Base64-Codierung handelt es sich um keine Sicherheitsfunktion, zum Schutz der Zugangsdaten. Diese werden quasi als Klartext gespeichert.

Die Zugangsdaten werden in der Datei auth.json gespeichert, bis man sich wieder abmeldet (z.B. mit podman logout) oder der Host neu gestartet wird. Weitere Informationen dazu bieten die Manpages podman-login(1) und containers-auth.json(5).

Den Download (Pull) von Container-Images mit Podman

Der folgende Befehl zeigt, wie das Container-Image für Debian Bullseye aus dem Repo ‚debian‘ der Registry ‚docker.io‘ heruntergeladen wird:

$ podman pull docker.io/library/debian:bullseye
Trying to pull docker.io/library/debian:bullseye...
Getting image source signatures
Copying blob bb7d5a84853b done  
Copying config f776cfb21b done  
Writing manifest to image destination
Storing signatures
f776cfb21b5e06bb5b4883eb15c09ab928a411476b8275293c7f96d09b90f7f9

Das Image wird im lokalen Image-Speicher abgelegt. Dieser befindet sich bei Rootless-Podman unterhalb von .local/share/containers/storage/overlay-images/. Die lokal gespeicherten Images kann man sich mit dem folgenden Kommando auflisten lassen:

$ podman images
REPOSITORY                TAG       IMAGE ID      CREATED      SIZE
registry.access.redhat.com/ubi8  latest    b1e63aaae5cf  7 days ago   233 MB
docker.io/library/debian         bullseye  f776cfb21b5e  3 weeks ago  129 MB

Auf meinem Beispielsystem existiert aktuell nur das soeben heruntergeladene Debian-Image sowie ein UBI8-Image.

Container starten, stoppen und entfernen mit Podman

An dieser Stelle möchte ich in Erinnerung bringen, dass es sich bei Linux-Containern um zustandslose Prozesse handelt, welche in Kernel-Namespaces ausgeführt werden. Für wen dies eine völlig neue Erkenntnis ist, der sei auf die Artikel unter 3, 4 und 5 verwiesen.

In den folgenden Unterpunkten führe ich noch einige wenige Beispiele exemplarisch auf. Für weitere Optionen sie auf die Manpage podman(1) verwiesen, welche einen Überblick über allgemeine Optionen und Verweise zu verfügbaren Podman-Kommandos bietet.

Befehl in einem Container ausführen

Dieses Beispiel zeigt, wie ein Container von einem lokal gespeicherten Image instanziiert wird, einen einzigen Befehl ausführt, dessen Ausgabe nach STDOUT schreibt und danach beendet und entfernt wird:

$ podman run --rm ubi8 cat /etc/os-release
NAME="Red Hat Enterprise Linux"
VERSION="8.4 (Ootpa)"
ID="rhel"
ID_LIKE="fedora"
VERSION_ID="8.4"
PLATFORM_ID="platform:el8"
PRETTY_NAME="Red Hat Enterprise Linux 8.4 (Ootpa)"
ANSI_COLOR="0;31"
CPE_NAME="cpe:/o:redhat:enterprise_linux:8.4:GA"
HOME_URL="https://www.redhat.com/"
DOCUMENTATION_URL="https://access.redhat.com/documentation/red_hat_enterprise_linux/8/"
BUG_REPORT_URL="https://bugzilla.redhat.com/"

REDHAT_BUGZILLA_PRODUCT="Red Hat Enterprise Linux 8"
REDHAT_BUGZILLA_PRODUCT_VERSION=8.4
REDHAT_SUPPORT_PRODUCT="Red Hat Enterprise Linux"
REDHAT_SUPPORT_PRODUCT_VERSION="8.4"

Der Container existierte nur für die Zeit, die zur Ausführung des Befehls cat /etc/os-release erforderlich war. Die Ausgabe lässt erkennen, dass das Image ubi8 ein Userland aus RHEL 8.4 bereitstellt.

Einen Dienst in einem Container starten

Möchte man einen Dienst in einem Container laufen lassen, so gibt es dafür die Option ‚-d‘, mit welcher man den Container im Hintergrund startet. Ich demonstriere dies an einem kleinen Webserver:

$ podman run -d -p 8080:80 httpd
✔ docker.io/library/httpd:latest
Trying to pull docker.io/library/httpd:latest...
Getting image source signatures
Copying blob 462e88bc3074 done  
Copying blob 21d69ac90caf done  
Copying blob ca52f3eeea66 done  
Copying blob 7d63c13d9b9b done  
Copying blob 448256567156 done  
Copying config 1132a4fc88 done  
Writing manifest to image destination
Storing signatures
3893630d276a7bfb4a3d8c74c5be8ad353b82c1f45081dec0d31b599a5856944

Da noch kein Image für ‚httpd‘ im lokalen Image-Speicher existiert, wird dieses automatisch heruntergeladen. Mit der Option -p 8080:80 wird der TCP-Port 8080 des Host-Betriebssystems mit dem Port 80 des Containers verknüpft.

Folgender Code-Block zeigt, dass nun ein einfacher Webserver läuft, welcher die Standard-HTML-Seite „It works!“ ausliefert:

$ curl http://localhost:8080
<html><body><h1>It works!</h1></body></html>

Der Container läuft, bis er durch einen Neustart des Betriebssystems oder manuell durch den Benutzer beendet wird.

Container stoppen

Um einen im Hintergrund laufenden Container zu stoppen, wird zunächst dessen ID benötigt. Diese ist in der ersten Spalte der Ausgabe des Kommandos podman ps enthalten:

$ podman ps
CONTAINER ID  IMAGE                           COMMAND           CREATED         STATUS            PORTS                 NAMES
3893630d276a  docker.io/library/httpd:latest  httpd-foreground  16 minutes ago  Up 2 minutes ago  0.0.0.0:8080->80/tcp  optimistic_visvesvaraya

Gestoppt wird der Container mit folgendem Befehl:

$ podman container stop 3893630d276a
3893630d276a7bfb4a3d8c74c5be8ad353b82c1f45081dec0d31b599a5856944

Es wird die vollständige ID des Containers ausgegeben. Diese kann genutzt werden, um den Container zu entfernen (podman rm ID) oder um ihn wieder zu starten (podman start ID).

Wird ein Container nur gestoppt, bleibt seine Konfiguration erhalten, sodass er mit den gleichen Optionen wieder gestartet werden kann. Eine Übersicht über gestoppte oder anderweitig beendete Container bietet das folgende Kommando:

$ podman ps --all
CONTAINER ID  IMAGE                           COMMAND           CREATED         STATUS                     PORTS                 NAMES
3893630d276a  docker.io/library/httpd:latest  httpd-foreground  13 minutes ago  Exited (0) 16 seconds ago  0.0.0.0:8080->80/tcp  optimistic_visvesvaraya

Die Verwaltung von Container-Prozessen und -Images

Eine Übersicht über laufende Container bietet das folgende Kommando:

$ podman ps
CONTAINER ID  IMAGE                           COMMAND           CREATED         STATUS            PORTS                 NAMES
3893630d276a  docker.io/library/httpd:latest  httpd-foreground  16 minutes ago  Up 2 minutes ago  0.0.0.0:8080->80/tcp  optimistic_visvesvaraya

Möchte man einen Container entfernen, so geschieht dies mit dem Kommando podman rm ID. Dabei wird nur die Konfiguration des Containers entfernt, nicht das lokal gespeicherte Image. Folgender Code-Block verdeutlicht dies:

$ podman rm 4476cb9d7eec939281abfe0b12bdb8f2083154dbfbc138492b811e0389ad5bfa
4476cb9d7eec939281abfe0b12bdb8f2083154dbfbc138492b811e0389ad5bfa

$ podman ps --all
CONTAINER ID  IMAGE   COMMAND  CREATED  STATUS  PORTS   NAMES

$ podman images
REPOSITORY                       TAG       IMAGE ID      CREATED      SIZE
registry.access.redhat.com/ubi8  latest    b1e63aaae5cf  7 days ago   233 MB
docker.io/library/httpd          latest    1132a4fc88fa  11 days ago  148 MB
docker.io/library/debian         bullseye  f776cfb21b5e  3 weeks ago  129 MB

Möchte man auch das Image entfernen, so geschieht dies mit folgendem Befehl:

$ podman rmi b1e63aaae5cf
Untagged: registry.access.redhat.com/ubi8:latest
Deleted: b1e63aaae5cffb78e4af9f3a110dbad67e8013ca3de6d09f1ef496d00641e751

Bei ‚b1e63aaae5cf‘ handelt es sich um die Image-ID, welche in der Ausgabe von podman images zu sehen ist.

Die persistente Speicherung von Daten in Podman-Volumes

Container sind, wie bereits erwähnt, zustandslose Objekte. Möchte man Daten persistent speichern, können dafür sogenannte Podman-Volumes verwendet werden.

So ist es bspw. möglich, ein Verzeichnis vom Host in einen Container hinein zu mounten. Schreibt der Container-Prozess nun Daten in diesem Mountpoint, bleiben diese erhalten, nachdem der Container gelöscht wurde. Sie können später in eine neue Container-Instanz hinein gemountet werden.

Beispiel: Verzeichnis vom Host in Container einhängen

Im folgenden Code-Block wird ein Verzeichnis im HOME-Verzeichnis eines normalen Nutzers erstellt und anschließend in einen Container eingehängt. Der Einhängepunkt im Container muss dabei bereits im Container-Image existieren. Der Container erstellt eine Datei namens TEST in diesem Volume. Anschließend wird der Container beendet und entfernt. Die erstellte Datei befindet sich weiterhin in dem Verzeichnis auf dem Host.

$ mkdir testdir
$ podman run --rm -v ~/testdir:/tmp:Z debian touch /tmp/TEST
$ ls -l testdir/
total 0
-rw-r--r--. 1 alice alice 0  7. Nov 14:01 TEST

Die Option ‚Z‘ sorgt dafür, dass der SELinux-Datei-Kontext für das Verzeichnis korrekt gesetzt wird, sodass der Container auf dieses Volumen zugreifen kann. Für weitere Details siehe Option ‚-v‘ in podman-run(1).

Podman-Volume erstellen und einhängen

Mit podman-volume(1) stellt Podman ein einfaches Verwaltungswerkzeug für Podman-Volumes zur Verfügung. Folgendes Code-Beispiel zeigt, wie mit podman-volume-create(1) ein Volume mit einem eindeutigen Beizeichner (testdir2) erstellt wird. Anschließend wird dieses, wie im vorangehenden Beispiel, in einen Container eingehängt und die Datei TESTDATEI hineingeschrieben.

$ podman volume create testdir2
testdir2
$ podman run --rm -v testdir2:/tmp:Z debian touch /tmp/TESTDATEI

Doch wo findet man nun die TESTDATEI außerhalb des Containers wieder? Wo befindet sich der Speicherort des zuvor erstellten Volumes ‚testdir2‘? Auskunft darüber gibt das Kommando podman volume inspect VOLUMENAME:

$ podman volume inspect testdir2
[
    {
        "Name": "testdir2",
        "Driver": "local",
        "Mountpoint": "/home/alice/.local/share/containers/storage/volumes/testdir2/_data",
        "CreatedAt": "2021-11-07T14:39:56.557400855+01:00",
        "Labels": {},
        "Scope": "local",
        "Options": {}
    }
]

Der Schlüssel Mountpoint gibt den Volume-Pfad an. Und tatsächlich findet sich dort die TESTDATEI:

$ ls -l /home/alice/.local/share/containers/storage/volumes/testdir2/_data
total 0
-rw-r--r--. 1 alice alice 0  7. Nov 14:40 TESTDATEI

Die TESTDATEI gehört Alice, welche den Container-Prozess gestartet hat. Möchte man den Inhalt eines Volumes sichern, kann man die enthaltenen Verzeichnisse und Dateien mit bekannten Mitteln kopieren oder mittels podman-volume-export(1) in ein TAR-Archiv verpacken:

$ podman volume export testdir2 -o testdir2.tar

Benötigt man das Volume nicht mehr, kann man es inkl. seines Inhalts mit dem folgenden Befehl löschen:

$ podman volume rm testdir2
testdir2

Möchte man sich die existierenden Volumes anzeigen lassen, gelingt dies mit dem folgenden Befehl:

$ podman volume ls
DRIVER      VOLUME NAME
local       vol1
local       vol2
local       vol3

Der Spalte DRIVER ist zu entnehmen, dass alle diese Volumes im lokalen Dateisystem gespeichert sind. Über weitere Storage-Backends kann ich an dieser Stelle leider noch keine Aussage treffen, da mir hierzu noch das notwendige Wissen fehlt.

Zum Abschluss dieses Abschnitts noch der Befehl, mit dem sich alle ungenutzten Volumes entfernen lassen:

Achtung: Bei folgendem Kommando ist Vorsicht geboten. Ein genauer Blick darauf, welche Volumes entfernt werden sollen, lohnt sich. Andernfalls droht Datenverlust.

$ podman volume prune
WARNING! This will remove all volumes not used by at least one container. The following volumes will be removed:
vol1
vol2
vol3
Are you sure you want to continue? [y/N] y
vol1
vol2
vol3

An dieser Stelle möchte ich den kurzen Überblick über die Podman-Volume-Befehle beenden. Wer sich weitergehend damit auseinandersetzen möchte, findet über die Manpage podman-volume(1) einen guten Einstieg.

Fazit

Am Ende dieses Tutorials sollte man in der Lage sein, Rootless-Podman auf Debian Bullseye einzurichten. Mit ein wenig Abstraktionsvermögen sollte dies auch auf weiteren Distributionen gelingen.

Die grundlegenden Befehle zur Bedienung und Nutzung wurden kurz vorgestellt, sodass man nun über das nötige Wissen verfügt, die ersten eigenen Schritte mit dieser noch recht jungen Technologie zu unternehmen.

Für eure ersten Versuche mit Podman wünsche ich euch viel Spaß und Erfolg.

Quellen und weiterführende Links

  1. RHEL 8 Building, running, and managing containers. Chapter 1.5. Upgrading to rootless containers URL: https://access.redhat.com/documentation/en-us/red_hat_enterprise_linux/8/html/building_running_and_managing_containers/assembly_starting-with-containers_building-running-and-managing-containers#proc_upgrading-to-rootless-containers_assembly_starting-with-containers
  2. How to manage Linux container registries. Valentin Rothberg (Red Hat). Enable Sysadmin. 2021-02-16.
  3. Architecting Containers Part 1: Why Understanding User Space vs. Kernel Space Matters; [Scott McCarty (fatherlinux)}(https://www.redhat.com/en/authors/scott-mccarty-fatherlinux); July 29, 2015
  4. Architecting Containers Part 2: Why the User Space Matters; Scott McCarty (fatherlinux); September 17, 2015
  5. Architecting Containers Part 3: How the User Space Affects Your Application; Scott McCarty (fatherlinux); November 10, 2015
  6. Beginn der Artikelserie „Kanboard im Container…“; My-IT-Brain; Jörg Kastning; 2021-01-04