staging.inyokaproject.org

2022 Woche 03

23. Januar 2022

Vor über vier Jahren schrieb ich einen Blogpost über „Schönere Git Diffs im Terminal mit diff-so-fancy“. Mit diff-so-fancy ist es möglich schönere bzw. bessere Diffs mit Git anzeigen zu lassen. Als Vergleich dient hier natürlich das klassische diff Kommandozeilentool, was vom System mitgeliefert wird und nur sehr wenig optisch die Unterschiede zwischen zwei Versionen hervorhebt.

Kürzlich bin ich auf delta gestoßen, was noch einmal deutlich besser als diff-so-fancy ist und zwar für mich vor allem für die bessere farbliche Hervorhebung und für die Nutzung von Syntaxhervorhebung, die abhängig der verwendeten Programmiersprache ist. Darüber hinaus gibt es auch noch Zeilennummerierungen und ein optionales Side-by-Side View.

Ein git diff mit delta

Ich kann jeder Person, die git diff auf der Kommandozeile ausführt, nur empfehlen mal ein Blick darauf zu werfen. Die Dokumentation und das GitHub-Repository listen alle Funktionen auf, zeigen mehr Screenshots und listet auf, wie man es installiert. Unter den gängigen Linux-Distributionen, Windows und macOS ist das Tool unter delta bzw. git-delta in den Paketquellen enthalten. Einzig in Ubuntu und Debian muss man sich das Debian-Paket händisch installieren. Mehr dazu in der Dokumentation zur Installation und Konfiguration.

Wer viel im Terminal arbeitet, stolpert mit Sicherheit auch regelmäßig über (Git) Diffs. Leider ist die standardmäßige Ausgabe des diff-Tools eher für Maschinen als für Menschen geeignet, und darunter leidet auch die Lesbarkeit.

Diff-so-fancy behebt diesen relativ kleinen, aber dennoch störenden Makel, indem es die Ausgabe des diff-Tools deutlich aufhübscht. Bilder sagen bekanntlich mehr als tausend Worte, deshalb hier zum Vergleich:

alt
Links git diff, rechts diff-so-fancy

Für viele Distributionen gibt es bereits fertige Pakete (siehe Installationshinweise), teils in den offiziellen Paketquellen, teils durch von der Community betreute Repos.

Nur für Fedora hatte ich keines gefunden, weshalb ich mich fix selbst darum gekümmert habe. Installiert werden kann das Paket über mein Fedora COPR Repository, unterstützt werden immer die letzten zwei aktuellen Fedora-Versionen.

Nachtrag: Der Vollständigkeit halber sei noch erwähnt, dass es auch das Tool delta gibt, was im Prinzip das gleiche wie diff-so-fancy versucht. Svij hat dazu einen kurzen Artikel verfasst.

Aktuell gilt bei Linux auf dem Desktop: Ganz oder gar nicht. Entweder eine Vollverschlüsselung mit LUKS oder ein unverschlüsseltes System. Ältere Lösungen wie eCryptFS werden nicht weiter entwickelt, aber mit systemd-homed steht mehr als ein Ersatz in den Startlöchern.

Abgrenzung zu anderen Lösungen

Linux hat für die Verschlüsselung von Partitionen und Systemen eine hervorragende Lösung namens LUKS (dm-crypt). Mit LUKS kann man einzelne Partitionen oder externe Festplatten verschlüsseln und die meisten Distributionen bieten an, damit das komplette Betriebssystem zu verschlüsseln.

LUKS ist eine gute und sichere Lösung, aber sie hat ein paar Nachteile bzw. Bereiche, die sie einfach nicht abdeckt. Durch die Vollverschlüsselung verlagert sich die Passwortabfrage an den Start des Betriebssystems. Je nach Konfiguration vor oder nach dem Bootloader GRUB. Ist das System während des Startvorgangs einmal entschlüsselt, liegen die Daten offen. Das ist nicht nur bei der heutzutage verbreiteten Nutzung von Standby ein Problem, sondern auch bei Mehrbenutzersystemen. Man kann LUKS dann mit verschiedenen Passwörtern ausstatten und andere Workarounds vornehmen. Das Kernproblem bleibt: LUKS liegt konzeptionell quer zum Displaymanager-System der Desktopumgebungen, weshalb diese von vielen dann bei Einzelnutzersystemen per Autologin übersprungen werden oder eine doppelte Passwortabfrage notwendig ist. Bei Mehrbenutzersystemen kommt man um eine doppelte Passwortabfrage nicht umhin.

Neben dieser „Komfortproblematik“ schützt eine Vollverschlüsselung mittels LUKS die Benutzer auch nicht gegeneinander. Hier greifen dann wieder nur die üblichen Dateirechte der Distributionen.

Zur Benutzerdatenverschlüsselung gab es früher eCryptFS, das lange Zeit von Ubuntu favorisiert wurde (hier eine ältere Anleitung). Mit dem Weggang des Hauptentwicklers von Canonical liegt eCryptFS nun faktisch brach. Es gibt zahlreiche offene Bugs und zeitweilig gab es ernste Sicherheitsprobleme, die jedoch zuletzt noch behoben wurden. Aber klar sein dürfte auch, dass es keine substanzielle Weiterentwicklung von eCryptFS mehr gibt. Die Zukunft gehört nicht eCryptFS.

systemd-homed – Verschlüsselung und mehr

Konzept – Home-Verzeichnis im Container

systemd-homed zählt zu den neueren Entwicklungen im systemd-Umfeld. 2019 skizzierte Lennart Poettering grob das geplante Konzept und 2020 stellt er es auf der FOSDEM 20 vor. Die Gemeinschaft diskutierte das Konzept vor allem im Kontext sogenannter portabler Home-Verzeichnis.

Der Hintergrund, warum systemd-homed vor allem in diesem Kontext wahrgenommen wurde, liegt in seiner Konzeption. So bietet systemd-homed die Möglichkeit, das Home-Verzeichnis eines Benutzers beispielsweise in einer Loopback-Datei abzulegen oder auf einen USB-Stick zu speichern. Dieses Desiderat griffen viele dankbar auf.

Langfristig gehört systemd-homed aber zu einer ganzen Reihe von Maßnahmen, um Linux sicherer zu machen und überkommene Methoden und ihre Limitationen abzuschütteln. In seinem Artikel von 2021 stellte Lennart Poettering Ideen und Ansätze vor, um Linux hier voranzubringen. Dazu gehören Konzepte wie eine ein verifizierter Startvorgang (woran nicht nur Poettering arbeitet) oder die stärkere Einbeziehung von Secure Boot und TPM. Erst beim Login sollen dann das Home-Verzeichnis des Anwenders entschlüsselt werden, dessen Schutz nicht an die restlichen Schutzmaßnahmen des Systems gekoppelt ist.

Genau an diesem Punkt bietet systemd-homed bereits jetzt spannende Funktionen. Es kann nämlich das Homeverzeichnis mit verschiedenen Mechanismen verschlüsseln, die über das hinausgehen, was bisher mit Linux möglich ist und bietet ebenso die Möglichkeit, die Authentifizierung an einen FIDO2-Keys (z. B. ein YubiKey) oder eine Smartcard zu koppeln. Hier zahlen sich andere Entwicklungen im systemd-Kontext wie systemd-cryptsetup aus.

Unterschiedliche Möglichkeiten: LUKS, fscrypt oder ohne Verschlüsselung

Es gibt unterschiedliche Optionen, ein Home-Verzeichnis mit systemd-homed zu betreiben. Eine davon ist ansonsten für Linux noch überhaupt nicht verbreitet. Grundsätzlich basieren alle Lösungen auf einem verschlüsselten Verzeichnis /home/<benutzername>.homedir. Beim Login wird dies regulär als /home/<benutzername> eingehängt.

  • Nicht verschlüsseltes Btrfs-Subvolume: Obwohl Verschlüsselung konzeptionell in systemd-homed vorgesehen ist, kann man auch einfach das Home-Verzeichnis auf einem Btrfs-Subvolume ohne Verschlüsselung ablegen.
  • Verschlüsselung mit ext4 und fscrypt: Google hat für Android vor einiger Zeit eine native Dateisystemverschlüsselung namens fscrypt entwickelt. Diese existiert für die Dateisysteme ext4, F2FS und UBIFS. Relevant für Linux ist hier primär ext4. Die Verschlüsselung erfolgt als transparente dateibasierte Verschlüsselung und ist nicht so sicher wie z. B. LUKS.
  • Verschlüsselung mit LUKS: Hier wird dateisystemunabhängig ein LUKS-Volume in einer Loopback-Datei erzeugt. Innerhalb des LUKS-Volume findet ext4, Btrfs oder XFS Verwendung. Diese Lösung ist mit Abstand die sicherste Variante.

Ein nicht verschlüsseltes Home-Verzeichnis bringt aktuell keine Vorteile und macht meiner Ansicht nach erst als Option Sinn, wenn systemd-homed mal „Standard“ in der Linux-Welt ist.

Die transparente Verschlüsselung mit fscrypt und die containerbasierte LUKS-Variante haben beide Vor- und Nachteile. LUKS ist sicherer und ein etablierter Standard. Der Container hat aber eine definierte Größe, die entweder konkret in GB oder in Prozent angegeben wird. Die Partition mit den Home-Verzeichnissen ist dann entsprechend belegt, selbst wenn innerhalb des Containers noch viel Platz ist. Fscrypt ist hier viel flexibler und orientiert sich einfach an der Partitionsgröße, aber dafür nicht so sicher, weil die Metadaten der Dateien offen liegen. Dafür ist der LUKS-Ansatz flexibler, was die Wahl des Dateisystems betrifft, während fscrypt quasi ext4 vorschreibt.

Die Möglichkeit, fscrypt zu nutzen, ist zudem momentan das größte Alleinstellungsmerkmal von systemd-homed.

Es ist also eine Abwägung des notwendigen Schutzbedarfs. Wenn man z. B. bereits ein vollständig mit LUKS verschlüsseltes System nutzt und nur noch zusätzlich die einzelnen Benutzer gegeneinander abschirmen möchte oder wenn man nicht besonders schutzwürdige Daten hat und nur neugierige „Gelegenheitsspione“ aussperren möchte, dann ist fscrypt mehr als ausreichend.

Grundsätzlich ist das Schutzniveau, wenn man nur die Benutzerdaten verschlüsselt und nicht das gesamte System, nicht so hoch, wie bei einer vollständigen Verschlüsselung des Systems mit LUKS, weil unverschlüsselte Daten in anderen Bereichen gespeichert sein könnten, wie z. B. in /tmp. Das war auch bei eCryptFS schon so und ist somit nicht neu.

Einrichtung mit fscrypt am Beispiel von openSUSE Tumbleweed

systemd-homed ist immer noch neu und experimentell. Es sollte noch nicht für Produktivsysteme genutzt werden und es werden tiefergehende Linux-Kenntnisse vorausgesetzt.

systemd-homed steht noch nicht für alle Distributionen zur Verfügung. Paketiert haben es moderne Distributionen wie Arch Linux (inkl. dem Abkömmling Manjaro), Fedora und openSUSE Tumbleweed. Distributionen wie Debian müssen vermutlich erst noch einige Jahren Diskussionen über „Unix-Principles“ führen, bevor sie nachziehen.

Im folgenden Szenario gehe von einem openSUSE-System aus, das wie folgt partitioniert ist.

  1. EFI
  2. Systempartition mit Btrfs
  3. Homepartition mit ext4

Wirklich wichtig ist die Homepartition mit ext4. Ob es Auswirkungen hat, wenn z. B. alle Partitionen in einem verschlüsselten LVM sind, wurde aber nicht getestet. Wenn man ein frisches System für den Test verwendet, kann man auch in der Installationsroutine auf das Anlegen eines Benutzers verzichten.

Die Einrichtung geschieht auf einem TTY. Hier wechselt man auf dem Loginbildschirm (z. B. SDDM oder GDM) per Strg + ALt F1 auf die Konsole.

Für die Verwendung von systemd-homed sind zusätzliche Pakete und Veränderungen an PAM notwendig.

# zypper in systemd-experimental nss-systemd

Anschließend verändert man die PAM-Einstellungen für systemd-homed. Hierzu ist keine manuelle Bearbeitung notwendig, sondern das geschieht mit folgendem Befehl:

# pam-config -a --systemd_home

Anschließend ist noch manuell eine Datei zu bearbeiten: /etc/nsswitch.conf Hier folgende zwei Zeilen wie folgt um den Zusatz systemd ergänzen:

passwd: compat systemd
group: compat systemd

Hiernach aktiviert man den homed-Service:

# systemctl enable --now systemd-homed

Wenn man ein LUKS-Homeverzeichnis anlegen möchte, reicht das bereits, für fscrypt muss das ext4-Dateisystem ggf. angepasst werden. Dazu muss die Partition zuerst ausgehängt werden.

# umout /home

Nun muss noch das Dateisystem optimiert, der Checksums-Support aktiviert und das Dateisystem auf 64bit konvertiert werden. Pfadangaben sind entsprechend auf das ext4-Dateisystem für das Home-Verzeichnis anzupassen. Je nach Standardkonfiguration sind manche Schritte davon vielleicht nicht notwendig, das Dateisystem meldet dann, dass die Funktion bereits aktiviert ist. Das ist also nicht schädlich.

# e2fsck -Df /dev/<disk>
# resize2fs -b /dev/<disk>
# tune2fs -O metadata_csum /dev/<disk>

Nun muss noch fscrypt aktiviert werden:

# tune2fs -O encrypt /dev/<disk>

Anschließend überprüfen, ob alle notwendigen Funktionen aktiviert sind.

# dumpe2fs -h /dev/<disk>| grep features:

Die Ausgabe sollte wie folgt aussehen. Wichtig ist vor allem encypt bei den Filesystem Features.

dumpe2fs 1.46.4 (18-Aug-2021)
Filesystem features:      has_journal ext_attr resize_inode dir_index filetype needs_recovery extent 64bit flex_bg encrypt sparse_super large_file huge_file dir_nlink extra_isize metadata_csum
Journal features:         journalLinux_incompat_revoke journal_64bit journal_checksum_v3

Nun muss man entweder die Home-Partiton wieder einhängen oder zur Sicherheit einmal komplett neustarten und auf das TTY zurückkehren.

Benutzer verwaltet man für systemd-homed mittels des Tools homectl. Mit folgendem Befehl legt man einen neuen Benutzer an und nutzt fscrypt ohne Quota.

# homectl create <username> --storage=fscrypt

Anschließend neustarten und sich wie gewohnt z. B. via SDDM einlogen.

Probleme und Grenzen

Aktuell gibt es natürlich noch einige Limitationen, schließlich ist das Ganze kaum zwei Jahre alt. Grafische Tools wie die Benutzerverwaltung von KDE, SDDM oder auch der YaST Usermanager erkennen den mittels homectl angelegten Benutzer nicht. Das hat z. B. zur Folge, dass man beim Loginbildschirm Benutzername und Passwort eingeben muss und keinen Benutzer per Icon auswählen kann.

Die Verwaltung der Benutzer erfolgt ebenso nur über homectl, weshalb Tipps im Internet oder Informationen über Systemmeldungen, wie man Benutzer zu Gruppen hinzufügt und ähnliches, nicht funktionieren.

Abgesehen davon sind im Test bisher keine Probleme aufgetreten.

Zusammengefasst

Wie so oft haben die Entwickler rund um systemd ein Desiderat erkannt und es erfolgreich geschlossen. Hier passiert seit Jahren viel von dem, was Linux substanziell voranbringt.

Das noch ziemlich neue systemd-homed ist jetzt schon stabiler und ausgereifter als eCryptFS es nach Jahren der Entwicklung war. Die Integration in die grafischen Lösungen ist vermutlich nur eine Frage der Zeit. Ähnlich wie bei allen Entwicklungen im Kontext von systemd wird homed einen starken Vereinheitlichungsschub für die diversen Linux-Distribtionen und ihre verschiedenen, historisch gewachsenen Lösungen bringen.

Was heute noch experimentell ist, wird morgen schon Standard sein.

Weiterführende Informationen

Der Artikel systemd-homed – Verschlüsselte Home-Verzeichnisse und mehr erschien zuerst auf [Mer]Curius

22. Januar 2022

Auf meinem Heimserver war der eMail Versand von einem auf dem anderen Moment nicht mehr möglich. Ich habe die Log-Dateien durchforstet und bin auf folgenden Eintrag in der /var/log/mail.log gestossen:

Jan 20 09:13:37 server2004 postfix/smtp[2154]: send attr reason = SASL authentication failed; server smtp.1blu.de[178.254.4.101] said: 535 Incorrect authentication data

Der erste Verdacht hatte sich auch bestätigt, der Internet-Anbieter hatte das unverschlüsselte Anmelden abgestellt. Bisher hatte ich immer als Methode “Plain” verwendet und das klappte nicht mehr.

Ich habe die Postfix-Einstellungsdatei /etc/postfix/main.cf um folgende Zeilen ergänzt:

smtp_tls_security_level = may
smtp_tls_session_cache_database = btree:${data_directory}/smtp_scache
smtp_tls_CAfile = /etc/ssl/certs/ca-certificates.crt
# optional zur Fehlersuche
smtp_tls_loglevel = 1

Anschliessend konnten die eMails wieder versendet werden. Mittels dem Befehl “mailq” habe ich nachgeschaut wie viele Nachrichten in der Warteschlänge hängen und diese dann mit folgenden Befehl versendet:
“postqueue -f“

21. Januar 2022

Gegenwärtig ist die Luca App wieder häufiger in den Schlagzeilen, da die Bundesländer sukzessive ihre Verträge auslaufen lassen. Vermutlich wird aber nicht die Corona Warn App übernehmen, sondern stattdessen das Konzept Kontaktnachverfolgung komplett fallen gelassen. Trotzdem lassen sich daraus interessante Sachen lernen.

Luca vs. CWA – Ein kurzer Abriss

Die gesamte Geschichte ist aus einem anderen Blickwinkel sehr interessant: Der Open Source-Welt. Der Misserfolg der Corona Warn App (CWA) zeigt nämlich einige Probleme gleichsam unter einem Brennglas.

Die Rollen in diesem Drama waren nach einigem anfänglichen hin- und her sehr schnell klar verteilt. Nachdem sich die Bundesregierung im Frühjahr 2020 auf einen dezentralen Ansatz bei der Kontaktnachverfolgung festlegte und dem Datenschutz im Sinne der Vertrauensbildung höchste Priorität beimaß, flogen der Corona Warn App die Herzen der Datenschutz-, Open Source und Tech-Szene zu. Nicht mal der CCC hatte etwas an der Kontaktnachverfolgung via CWA auszusetzen. Datenschutzbedenken kamen im Kontext mit der CWA nur als vorgeschobenes Argument von jenen, die sich unter gar keinen Umständen irgendetwas installiert hätten.

Die Corona Warn App hatte nur ein Problem: Sie erreichte nie die Verbreitung, die sie gebraucht hätte. Sie war auch kein völliger Flop, aber eine wirksame Waffe in der Pandemiebekämpfung wurde sie eben auch nicht.

Die Pandemie ging gerade in ihr zweites Jahr und Deutschland steckte mitten in dem, was man hierzulande Lockdown nannte und worüber man in anderen Regionen der Welt nur müde lächeln konnte und es setzt sich im Frühjahr 2021 die Erkenntnis durch, dass die Kontaktdatenerhebung mit Papierzetteln und Gästelisten vielleicht nicht das geeignete Mittel wären, um Deutschland gut durch die Pandemie zu bringen.

Diese Marktlücke erkannte man bei der Culture4Life GmbH und sorgte mithilfe des „Botschafters“ Smudo – für unsere „Boomer“-Entscheider braucht es halt den richtigen Frontmann – für die notwendige Aufmerksamkeit für ihr Produkt Luca. Die Lösung geriet ziemlich schnell in die Kritik von Fachleuten. Die gesammelte Liste der Kritikpunkte und ihre Entwicklung kann man bei Wikipedia nachlesen. Die Ironie für den, in diesem Artikel hier aufgemachten Gegensatz: Anfangs war es keine direkte Konkurrenz, denn die CWA konnte schlicht nicht das, was Luca vermeintlich bot: Kontaktnachverfolgung für ein konkretes Ereignis an einem definierten Ort zu einer bestimmten Zeit.

Heute wissen wir, dass die meisten Vorbehalte über den Sinn der App und begründeten Sorgen über den Datenschutz berechtigt waren. Luca war teuer für die Länder und damit für den Steuerzahler. Doch Geld in eine sinnvolle Maßnahme zu investieren, wäre vielleicht noch berechtigt gewesen, nur hat Luca vermutlich kaum etwas gebracht. Außer natürlich den Polizeien der Länder, die vielleicht sogar die Hauptnutznießer der App waren und zigfach illegal Daten abgefragt haben.

Die meisten Länder lassen nun die Verträge für Luca auslaufen und die Betreiber überlegen bereits, wie sie weiter Geld verdienen können. Eine millionenfach installierte App ist dafür keine schlechte Grundlage.

Hier nähern wir uns dem Problem. Luca war in der Pandemiebekämpfung nicht besonders sinnvoll. Die Akzeptanz war jedoch nicht nur bei der Politik groß, sondern erstaunlicherweise auch in der Bevölkerung. Millionen Bürger haben die Luca App installiert und zumindest aus meinem Umfeld (was natürlich nicht repräsentativ ist) kann ich berichten, dass darunter viele sind, die sich niemals die CWA installiert haben oder das sogar bewusst ablehnten. Dabei lebe ich sogar in einem Bundesland, in dem man schon sehr früh die CWA anstelle der Luca App nutzen durfte.

Welchen Lehren sich ziehen lassen

Genau hier kommen wir zum Kernproblem. Wir sehen hier im Kleinen den alten Gegensatz: Proprietäre, qualitativ unterlegene Lösung ist kommerziell erfolgreich, während das (öffentlich finanzierte) Open Source-Produkt im Wettbewerb unterliegt. Sich das näher anzuschauen, kann durchaus interessant sein – auch nach der Pandemie.

Meiner Ansicht nach lassen sich Punkte feststellen, die sich so auch anderswo in der Open Source-Welt finden. Die Punkte sind weder abschließend noch wertend geordnet.

Marketing

Schon der Name Corona Warn App hört sich nach Bürokratie an. Luca klingt hingegen locker, cool und leicht. Das ist mit Sicherheit kein Zufall, den sich der Geschäftsführer von Culture4Life mal eben ausdachte. Der Erfolg durch die Werbetour von Smudo ist belegt. Das Marketing-Dauerfeuer ebenso. Doch warum ist das eigentlich schlecht? Warum nicht ebenfalls mit den passenden Leuten Werbung für das Produkt CWA machen. Marketing ist nicht nur dem Staat, sondern auch vielen Open Source-Produkten völlig fremd.

Losgelöst von Luca und CWA muss man sich in der Open Source-Community halt mal fragen, ob Leute mit Zottelbärten, die optisch das Klischee erfüllen, das die Öffentlichkeit von Open Source hat, die richtigen Aushängeschilder für das Marketing sind. Solche Veranstaltungen wie der CCC oder irgendwelche (hoffentlich mal wieder in Präsenz stattfindenden) Sachen wie FOSDEM wirken nur in die eigene Blase.

Die Open Source-, Datenschutz und weiter gefasste Tech-Szene stand sehr schnell hinter der CWA und war genau so schnell gegen die Luca-App. Es geht aber nicht darum, die eh schon Überzeugten hinter sich zu versammeln, sondern es Marketing muss die Masse adressieren. Öffentlichkeitsarbeit in einem weiteren Sinne adressiert bei Open Source zu oft die eigene Blase.

Qualität nicht das Wichtigste

Die CWA war und ist die bessere App. Das Datenschutzkonzept ist gut, sie funktioniert zuverlässig, ist inzwischen von den Funktionen her betrachtet eine eierlegende Wollmilchsau und durch die Konzeption im Kontext der aktuellen Überlastung des Gesundheitssystems sogar überlegen in der Kontaktnachverfolgung.

Das Problem ist nur: Das ist egal! Das qualitativ bessere Produkt gewinnt nicht automatisch. Es gewinnt auch nicht das Produkt, das am meisten Funktionen hat oder sich am vielfältigsten konfigurieren lässt. Diese Erkenntnis ist alles andere als neu. In der Linux-Szene haben das viele – glaube ich – bis heute nicht verinnerlicht und deshalb lohnt es sich, einen Blick auf die letzten 2 Jahre CWA vs. Luca zu werfen. Mit ein bisschen innerer Distanz zum Beobachtungsgegenstand, den wir alle vermutlich bei CWA und Luca haben, kommt man vielleicht zu mehr Erkenntnis.

Letztlich zählt Masse und Dominanz. Im digitalen Zeitalter leider mehr denn je. Ein Produkt muss leicht zu bedienen sein, darf nicht andauernd die Funktion und Design ändern und muss Wiedererkennungswert haben. Wenn dann fast alle Bundesländer das Tool einsetzen und der QR-Code auf jedem Kneipentisch klebt, dann setzt sich das Produkt durch. Egal, ob es qualitativ gut ist oder nicht. Vielfalt und Konkurrenz sind für „Looser“, denn hat man erst mal kritische Masse erreicht, sitzt man sehr fest im Sattel.

Keine Konkurrenz aus dem eigenen Haus

Anstelle sich vollständig auf die CWA zu fokussieren, schuf man sich auch noch Konkurrenz im eigenen Haus in Form der CovPass App des RKI. Diese App, die ebenso wie die CWA digitale Impfnachweise vorhält und ist wegen der im Vergleich deutlich reduzierten Funktion viel beliebter als die CWA ist. Dadurch hat man einen wesentlichen Hebel bei der Verbreitung der CWA nicht genutzt und sich verzettelt. Die CWA-kritische Bevölkerung hatte ja eine zweite App zur Auswahl und konnte ihre Impfzertifikate trotzdem einer vertrauenswürdigen Lösung anvertrauen. Hinzu kamen noch ein paar weitere Apps mit teils anderen Funktionen, was aber viele nicht auseinander halten konnten und schon war das Chaos perfekt. Verzettelung in Alternativen ohne Strategie und Fokus war hier ein Problem. Den Vergleich zur Open Source-Welt muss ich hier kaum explizit ziehen.

Entwicklung im Staatskapitalismus

Luca nutzte eine Lücke aus, die fast ein Jahr nach dem Start der CWA immer noch klaffte. Die Ursache dafür ist einfach: SAP und die Telekom entwickelten und betrieben eine App mit genau den Funktionen, die vertraglich fixiert waren. Das machten sie nicht schlecht, immerhin funktionierte die App. Eine Weiterentwicklung war allerdings nicht vorgesehen und bis der Staat eine solche in Auftrag gab, verging entsprechend Zeit. Zeit, die ein agiler privater Mitbewerber natürlich nutzte.

Das sollten sich all jene genau ansehen, die von Public Money, Public Code träumen und Projekte wie in Schleswig-Holstein & Co feiern. Ich arbeite schon einige Jahr für den Öffentlichen Dienst, ich arbeite gerne für den Öffentlichen Dienst. Aber diese Probleme sind systemimmanent und lassen sich nicht wirklich lösen. Der Staat mag jetzt im Sinne einer aufholenden Entwicklung die Migration betreiben, aber wenn sie mal geschafft ist, wird man stehen bleiben. Weil es teuer war, weil zig Überstunden aufgelaufen sind und sich alle erst mal von der Kraftanstrengung erholen müssen. In diese Lücke springen dann nicht nur private Anbieter, sondern sie sind als Innovationstreiber vielleicht sogar unerlässlich.

Zusammengefasst

Es gibt bestimmt noch viele weitere Punkte, aber diese drei Aspekte lassen sich auf andere Projekte im Open Source-Bereich umlegen und erklären zumindest teilweise die chronische Erfolglosigkeit vieler Initiativen in dem Bereich und sollte bei einigen laufenden Projekten wie Open Source im Staatseinsatz berücksichtigt werden, wenn es um die Zukunftsplanung geht.

Besseres Marketing bzw. weiter gefasste Öffentlichkeitsarbeit, mehr Fokussierung und Nachhaltigkeit und nicht zu viele Hoffnungen auf Kooperation mit dem Staat kann man aus einem guten Jahr Luca vs. CWA mitnehmen. Auch wenn in 5 Jahren hoffentlich niemand mehr weiß, was Luca war und Corona hoffentlich auch nur noch in Rückblicken auf das vergangene Jahrzehnt vorkommt.

Der Artikel Luca vs. Corona Warn App – Was wir daraus lernen können erschien zuerst auf [Mer]Curius

20. Januar 2022

Mozilla hat mit Firefox 96.0.2 ein Update außer der Reihe für seinen Desktop-Browser veröffentlicht.

Download Mozilla Firefox 96.0.2

Mit dem Update auf Firefox 96.0.2 behebt Mozilla ein Problem, welches für manche Linux-Nutzer zu einer veränderten Tab-Höhe führen konnte, wenn ein Tab geöffnet war, in welchem Audio abgespielt wurde.

Ein Fehler im WebExtension-Framework wurde behoben, der verursachte, dass die LastPass-Erweiterung in privaten Fenstern nur ein leeres Panel bei Klick auf den Toolbar-Button anzeigte.

Zwei mögliche Absturzursachen wurden behoben, ebenso wie die Möglichkeit, dass der Code der HTTP/3-Implementierung unter fehlerhaften Umständen in eine Endlosschleife gerät.

Die seit Firefox 96 auf true gesetzte Option network.cookie.sameSite.schemeful wurde mit dem Update temporär auf false gesetzt, da es zu Problemen auf Websites kommen konnten.

Weiter wurde ein Fehler behoben, der verursachte, dass unter bestimmten Umständen der Suchmodus der Adressleiste nicht mittels ESC-Taste verlassen werden konnte.

Außerdem wurden diverse Verbesserungen in Zusammenhang mit Firefox Suggest vorgenommen, einem Experiment, welches derzeit nur für einen Teil der Nutzer in den USA aktiv ist.

Der Beitrag Mozilla veröffentlicht Firefox 96.0.2 erschien zuerst auf soeren-hentzschel.at.

Do, 20. Januar 2022, Lioh Möller

Aufgrund der hohen Stabilität und Sicherheit erfreuen sich sogenannte immutable Linux-Distributionen immer grösserer Beliebtheit. Das wohl bekannteste und erste Projekt dieser Art stellt Fedora Silverblue dar.

Mit dem Projekt Sodalite ist es nun möglich auf Basis von Silverblue den aus elementaryOS bekannten Pantheon Desktop zu nutzen.

Dazu muss zunächst die Standardvariante von Silverblue mit dem GNOME Desktop installiert werden. Daraufhin lässt sich Sodalite mit wenigen Schritten aktivieren:

sudo ostree remote add --if-not-exists sodalite https://ostree.sodalite.rocks --no-gpg-verify
sudo ostree pull sodalite:sodalite/stable/x86_64/base
sudo rpm-ostree rebase sodalite:sodalite/stable/x86_64/base

Da in Silverblue neben der rpm-ostree Basis einige GNOME-Applikationen als Flatpak vorinstalliert sind, können diese mit folgendem Befehl deinstalliert werden:

sudo sodalite-uninstall-gnome-apps

Laut Angaben des Entwicklers befindet sich das Projekt noch in einem frühen Stadium, die wichtigsten Funktionen zur täglichen Nutzung, seien allerdings bereits gegeben.

Projektseite: https://sodalite.rocks
Git-Repository: https://github.com/sodaliterocks/sodalite

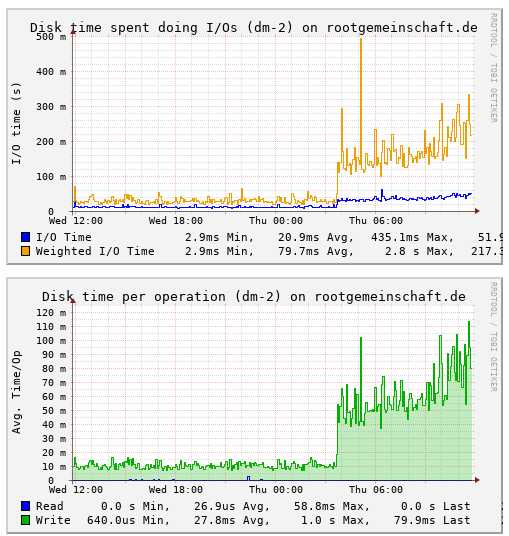
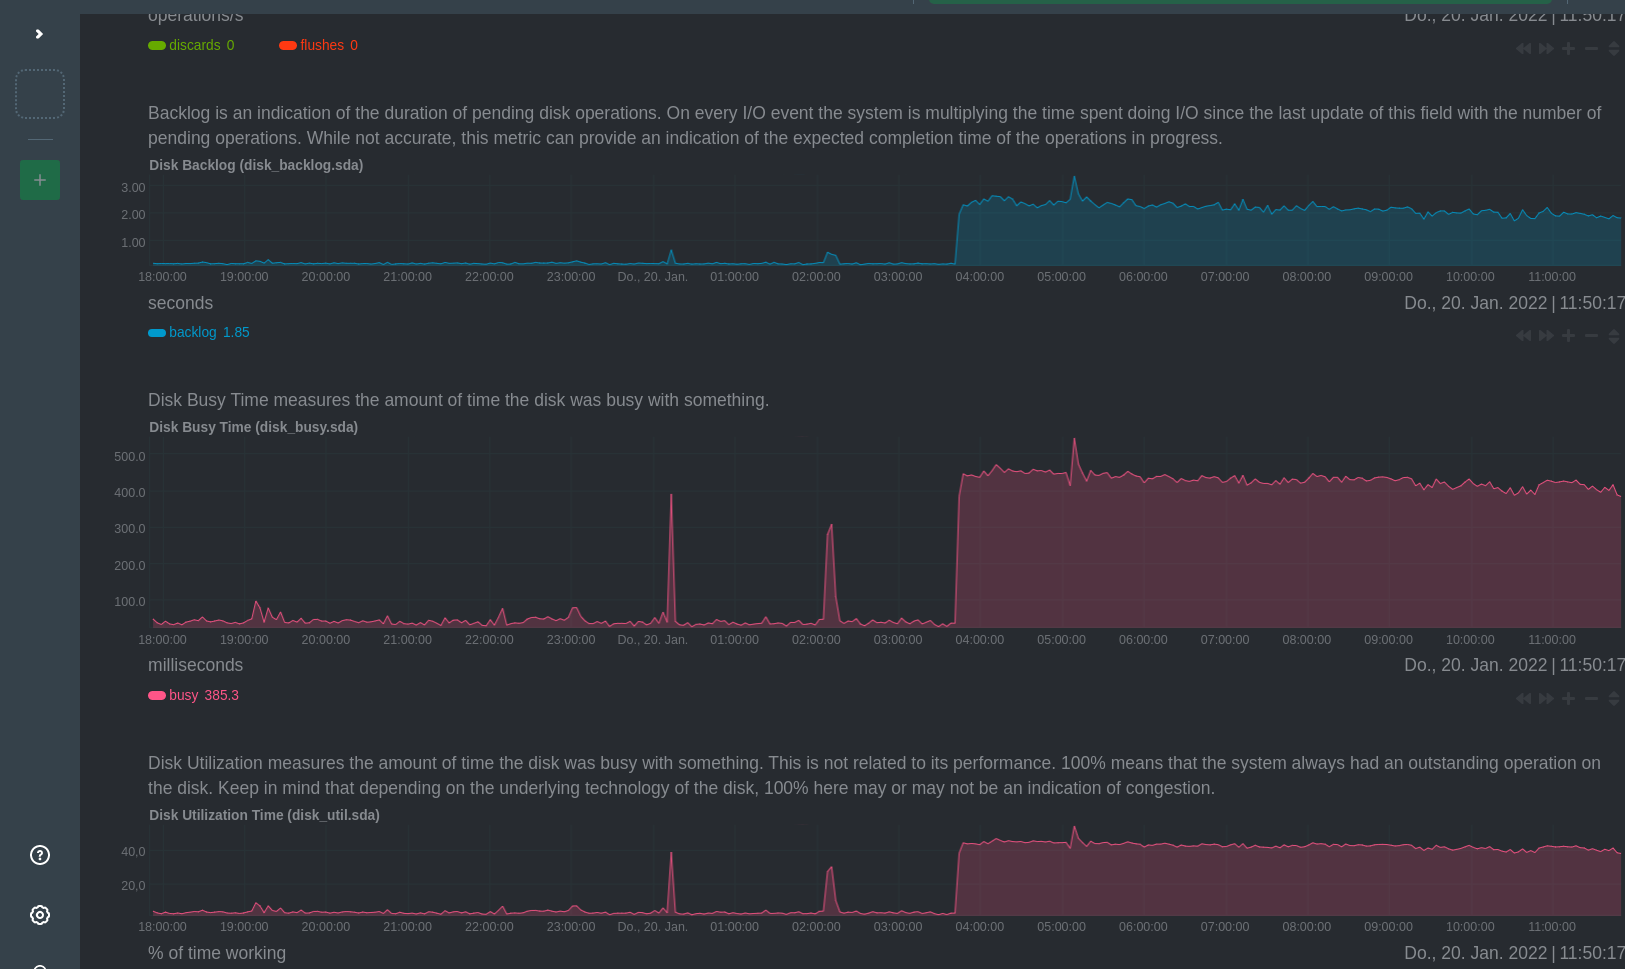
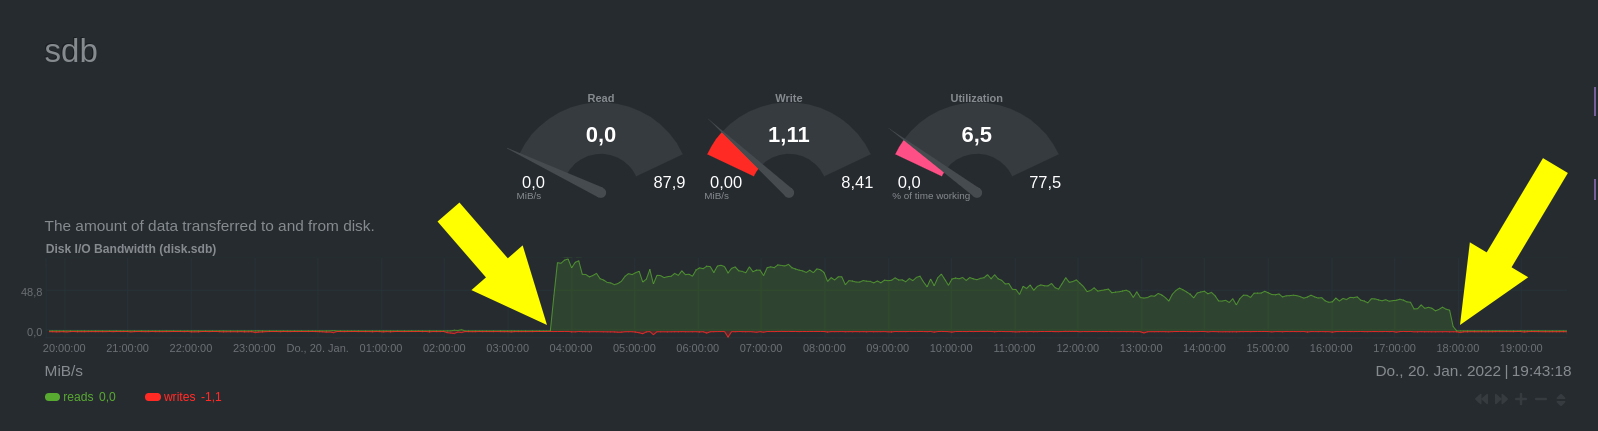
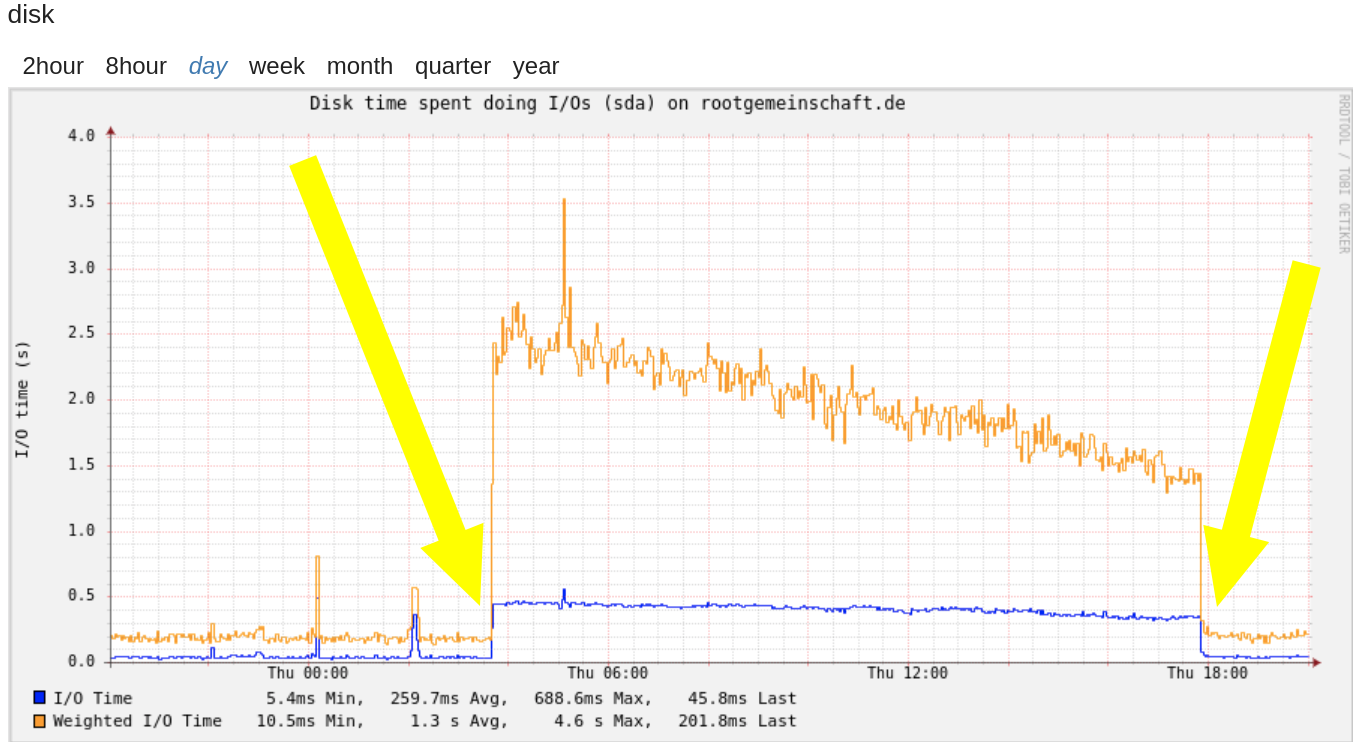
Wenn man Softraid verwendet, sollte einem klar sein, dass da eine monatliche Prüfung die Daten im Monitoring versaut.

Zum Unterschied von collectd und netdata hier ein Beispiel.


Ausgangssituation: In beide Tools wird auffallend hoher Load angezeigt, die Ursache liegt aber nicht an wild gewordenen Prozessen, eingeschleppte Schädlinge, sondern lediglich am 4 Wöchentlichen Rebuild des Raid1. Man muss halt nur wissen, welche Grafiken einem das verraten.

cat /proc/mdstat 
Personalities : [raid1] [linear] [multipath] [raid0] [raid6] [raid5] [raid4] [raid10] 
md1 : active raid1 sdb2[1] sda2[2]
      2929609152 blocks super 1.2 [2/2] [UU]
      [==============>......]  check = 70.0% (2050771840/2929609152) finish=222.2min speed=65892K/sec
      bitmap: 5/22 pages [20KB], 65536KB chunk

md0 : active raid1 sdb1[1] sda1[2]
      523712 blocks super 1.2 [2/2] [UU]
      
unused devices: <none>

Hier sieht man es auch sehr schön. Na klar, sda zeigt es genauso


Siehe auch http://zockertown.de/s9y/index.php?/archives/1630-Den-UEberblick-behalten-collectd-update.html


Hier noch das Ende. Leider kann man nicht minutengenau die Start und Ende Punkte erkennen. Aber das ist jammern auf hohem Niveau. Allerdings ist es bei netdata einfacher den Zeitpunkt zu erfassen.

Gelegentlich hat Linux bzw. Ubuntu Fehler, bei denen man sich einfach denkt: Das darf nicht passieren! Das verhindert die Alltagstauglichkeit. Gestern war es mal wieder so weit.

Es klingelte mein Smartphone und dran war der Anwender eines Kubuntu-Systems. Ich betreue ja kaum noch Geräte, beruflich bin ich da schon länger raus, aber ein paar Bekannte, Freunde und Familienmitglieder sind in den letzten Jahren glücklich auf Linux migriert und da hilft man natürlich weiter. Das Kubuntu-System war mal ein 16.04 und ist dann über 18.04 auf 20.04 aktualisiert worden. Sauber ist also was anderes, aber es funktioniert und der Anwender ist glücklich mit dem System. So viel zum Szenario.

Das Problem: Das System startet bis zum Loginscreen SDDM, aber nach dem Login landet der Anwender vor einem schwarzen Fehler mit einem X-Session Error:

Xsession: warning: unable to write to /tmp; Xsession may exit with an error

Zum Glück keine große Herausforderung, das Internet ist voll mit Berichten, die teils 10 Jahre und älter sind. Folglich ist das Problem auch ebenso lange ungelöst.

Die Ursache war eine volle Festplatte bzw. Systempartition. Das System ist getrennt in eine Home- und eine Root-Partition. Das kommt langsam aus der Mode, war aber 2016 noch Quasi-Standard. Die Systempartition ist mit 20 GB großzügig genug dimensioniert.

Wenn da nicht Ubuntu wäre, das stoisch jedes heruntergeladene Paketupdate bis zum Sanktnimmerleinstag zwischenspeichert. Und irgendwann nach einigen Jahren ist dann halt mal voll. Keine Aufräumroutine, kein Cronjob, kein Automatismus – nichts. Das letzte Mal manuell aufgeräumt hatte ich 2020 beim Upgrade auf 20.04.

Ohne grafische Oberfläche geht natürlich keine Fernwartung via AnyDesk und folglich mussten wir es per Telefonanweisung lösen. Der Anwender musste mit Strg + Alt + F3 auf ein anderes TTY wechselt und dort den Benutzer einloggen und anschließend beherzt eintippen:

$ sudo apt clean

Nach einem weiteren Neustart ging wieder alles. Die Paketverwaltung war allerdings wegen eben jener vollen Festplatte im Vorgang abgebrochen und musste erst wieder in einen benutzbaren Zustand versetzt werden. Ebenfalls kein besonders schwieriges Problem, aber ebenso nur auf der Konsole zu lösen.

Das hört sich trivial an, aber für viele Menschen ist das nicht trivial und sie kriegen einen Nervenzusammenbruch. Das ist umso ärgerlicher, weil ein so doofer Fehler so einfach zu vermeiden wäre – entweder durch einen intelligenteren Paketmanager oder durch einen Aufräumautomatismus – und deshalb einfach nicht passieren darf.

Um das ein wenig zu generalisieren und auch auf die Gefahr hin, dass mir viele mal wieder Meckerei vorwerfen. Solche Probleme sind es, die den Einsatz von Linux bei der Masse der Anwender erschweren und nicht irgendwelche Installationsprobleme oder jene eine fehlende Funktion im Mailprogramm etc. Es bleibt nämlich der Eindruck haften: Linux ist fehleranfällig. Bei einem Anwender, der bereits seit vielen Jahren glücklich mit Linux arbeiten, ist der natürlich nicht so nachhaltig, wie bei einem Anwender, der nach wenigen Minuten, Stunden, Tagen oder Wochen in so ein Problem läuft und schnell wieder zu einem Ursprungssystem zurück migriert.

Als versöhnliche Worte zum Schluss: Genau deshalb finde ich es toll, dass KDE die 15-Minuten-Bug-Initiative gestartet hat. Es muss mehr Fokus auf die Fehler, die normale Anwender andauernd haben. Der fiktive eine Fehler in Kate, der in Dokumenten mit mehr als 1 Mio Zeilen auftritt und Programmierer nervt, ist dagegen eher nachrangig. Leider wird der Programmierer aber lieber einen Arbeitstag damit verbringen, diesen einen Fehler in Kate zu beheben. Der hier beschriebene Fehler passiert zwar nicht binnen 15 Minuten, aber ist derart trivial zu lösen und derart gravierend für normale Anwender: So etwas muss prioritär behoben werden.

Und wer jetzt mit Systempflege kommt, sollte sich ernstlich fragen, ob er weiß, wie normale Menschen mit ihren Geräten arbeiten und ob er zweitens das Prinzip des Workarounds schon zu sehr verinnerlicht, um Probleme bewerten zu können. Denn obligatorische manuelle Systempflege ist letztlich nur ein Workaround, wenn Systeme nicht in der Lage sind, sich per Automatismen selbst langfristig funktionsfähig zu halten.

Der Artikel Ubuntu – Fehler, die nicht existieren dürften erschien zuerst auf [Mer]Curius

19. Januar 2022

Mi, 19. Januar 2022, Lioh Möller

Die chinesische Linux-Distribution deepin wurde in Version 20.4 veröffentlicht. Der LTS-Kernel wurde auf Version 5.10.83 aktualisiert und der Stable-Kernel ist in Version 5.15.6 enthalten.

Die Logik zur Erstellung von Partitionen wurde überarbeitet. Bei einer bereits vorhandenen EFI Partition wird diese nicht neu erstellt. Der mitgelieferte Chromium-basierte Browser wurde aktualisiert und erweitert. Es lassen sich erstmals Sammlungen von Webseiten erstellen und Tabs gruppieren.

Das bereits zuvor integrierte Monitoring zur Feststellung der Systemlast, erlaubt es Maximalwerte festzulegen, bei deren Überschreitung eine Warnung generiert werden soll.

Die integrierte Suche erlaubt es bei einem Klick mit gehaltener Ctrl-Taste den Speicherort einer Datei zu öffnen.

Eine vollständige Übersicht der Änderungen ist in der Release-Ankündigung zu finden.

Download: https://www.deepin.org/en/download/

17. Januar 2022

Mo, 17. Januar 2022, Lioh Möller

Das openSUSE Projekt hat seine jährliche Community Umfrage gestartet. Sie richtet sich an Nutzer und Entwickler der Distribution. Eigentlich hätte diese bereits Ende letzten Jahres veröffentlicht werden sollen, aufgrund der sonst parallel laufenden openSUSE Board Umfrage wurde dies allerdings verschoben.

In der Umfrage wird unter anderem abgefragt, welche openSUSE Variante (Leap, Tumbleweed, microOS) am häufigsten genutzt wird, welche Paketformate bevorzugt verwendet werden (RPM/Zypper, Flatpak, AppImage ...) und in welchem Kontext die Distribution auf Desktops und Servern zum Einsatz kommt.

Wie üblich können direkt Verbesserungsvorschläge eingegeben werden. Das Projekt bemüht sich sehr diese zu analysieren und in zukünftige Entwicklungen einfliessen zu lassen.

Ankündigung: https://news.opensuse.org/2022/01/17/os-begins-annual-survey/
Umfrage: https://survey.opensuse.org/

Inspiriert durch die Artikel von Ricardo Geradi [1] und Alex Callejas [3] schreibe ich diesen, um zu erklären, wie mithilfe von Ansible eine Labor-Umgebung bestehend aus einer oder mehreren virtuellen Maschinen (VMs) auf einem KVM-Hypervisor provisioniert werden kann.

Dabei handelt es sich weniger um ein Tutorial, sondern mehr um eine exemplarische Beschreibung einer möglichen Vorgehensweise, die euch als Vorlage für die eigene Umgebung dienen kann.

Ich gehe nicht darauf ein, wie KVM oder Ansible installiert werden. Hierzu verweise ich auf die Dokumentation der jeweiligen Projekte und der verwendeten Linux-Distributionen.

Motivation

Um Anwendungen zu testen, benötigt man in der Regel ein Betriebssystem, auf welchem diese ausgeführt werden können. Ein Betriebssystem läuft dieser Tage meist innerhalb einer virtuellen Maschine (VM). Um bei Tests stets gleiche Rahmenbedingungen zu haben, wird empfohlen, für jeden Test eine neue VM mit einer definierten Konfiguration zu provisionieren, die geplanten Tests durchzuführen, die Ergebnisse zu sichern und die VM zu dekommissionieren.

Möchte man Infrastrukturdienste testen, werden häufig gleich mehrere VMs benötigt. Diese werden auch als Labor-Umgebung bezeichnet.

Um nicht unnötig Zeit mit der Provisionierung der VMs zu verlieren — immerhin möchte man ja seine Anwendungen bzw. Dienste testen — bietet es sich an, diesen Prozess zu automatisieren.

Doch warum mit Ansible und nicht mit [hier Lieblings-Werkzeug eurer Wahl einsetzen]?

Viele Wege führen nach Rom. Und es gibt vermutlich ähnlich viele Werkzeuge, um eine Labor-Umgebung in KVM zu provisionieren. Ich habe mich in diesem Fall für Ansible entschieden, da:

  • Ich fast täglich damit arbeite.
  • Mit ansible-galaxy role init erstellte Rollen meiner bescheidenen Meinung nach (mbMn) eine schöne Struktur zur Organisation des Codes vorgeben.
  • Mit ansible-vault ein Werkzeug dabei ist, um Dateien mit sensiblen Informationen zu verschlüsseln und diese im weiteren Verlauf einfach zu nutzen.
  • Ich meine YAML-Dateien nächstes Jahr leichter lesen und verstehen kann als meine Shell-Skripte.
  • Ich in einem zukünftigen Artikel zeigen möchte, wie man mit Ansible eine Labor-Umgebung in einem VMware vSphere Cluster provisioniert.

Umgebung

KVM-Hypervisor: Debian 11 Bullseye

Die .qcow2-Image-Dateien für die VMs werden auf dem KVM-Hypervisor im Verzeichnis /var/lib/libvirt/images/ vorgehalten.

Getestete Ansible Versionen:

  • ansible 2.10.8 ( auf Debian 11 Bullseye)
  • ansible [core 2.12.1] (auf Fedora 35)

Die Verzeichnisstruktur für meine Ansible-Umgebung entspricht der aus dem Artikel Linux-Benutzerkonten mit Ansible verwalten, wie sie im dortigen Abschnitt Vorbereitung beschrieben ist.

Die im Laufe dieses Artikels provisionierte Labor-Umgebung wird aus einer RHEL-7 und einer RHEL-8-VM bestehen. Selbstverständlich ist es möglich, durch einfache Anpassungen weitere VMs sowie andere Linux-Distributionen zu provisionieren.

Vorarbeit

Ricardo Geradi [1] und Alex Callejas [3] beziehen in ihren Artikeln die qcow2-Images, welche sie als Vorlage (engl. Template) für weitere VMs verwenden, aus diversen Internet-Quellen. Ich bin kein Freund davon, mir Images aus dem Netz zu laden und zu nutzen, für die es keine ordentliche Dokumentation gibt, mit welchen Paketen und Einstellungen diese erzeugt wurden.

Wer kauft schon gern die Katze im Sack? Daher erstelle ich mir meine Vorlagen selbst. Dazu führe ich für jede Distribution, für die ich eine Vorlage erstellen möchte, eine manuelle Installation durch. Um die Vorlagen unter all den anderen VMs leicht identifizieren zu können, gebe ich ihnen Namen wie z.B.:

  • rhel7-template
  • rhel8-template
  • debian11-template

Dabei hinterlege ich beim User root bereits den SSH-Public-Key, den ich später mit Ansible verwenden möchte, um diese Systeme weiter zu konfigurieren. Dies tue ich zwar bisher. Es ist für die Verwendung der hier beschriebenen Rolle nicht erforderlich.

Möchte ich eine Vorlage aktualisieren, fahre ich die dazugehörige VM hoch, führe ein Paket-Update durch, fahre die VM wieder herunter und bin fertig. Dies mache ich in der Regel alle paar Monate, wenn mir das Paket-Update bei neu provisionierten VMs zu lange dauert und spätestens nach Erscheinen eines neuen Minor-Release.

Die Ansible-Rolle

Eine Ansible-Rolle wird mit dem Befehl ansible-galaxy role init role_name initialisiert. In meinem Fall sieht dies wie folgt aus:

$ ansible-galaxy role init kvm_provision_lab
- Role kvm_provision_lab was created successfully
$ tree kvm_provision_lab
kvm_provision_lab
├── defaults
│   └── main.yml
├── meta
│   └── main.yml
├── README.md
├── tasks
│   └── main.yml
├── templates
└── vars
    └── main.yml

In obiger Ausgabe fehlen die Verzeichnisse Files und Handlers. Diese hatte ich bereits gelöscht, da sie nicht benötigt werden. Die erstellte Verzeichnisstruktur kann, je nach verwendeter Version von ansible-galaxy, leicht unterschiedlich aussehen. Benötigt werden in diesem Beispiel nur die oben dargestellten Verzeichnisse und Dateien. Streng genommen können das Verzeichnis meta und die Datei README.md ebenfalls entfernt werden, wenn man nicht vorhat, die Rolle zu veröffentlichen. Ich behalte beide bei und nutze die Dateien zur Dokumentation der Rolle.

Variablen

Es ist gute Praxis alle Variablen, die von einer Ansible-Rolle verarbeitet werden, in der Datei defaults/main.yml zu dokumentieren und mit Standardwerten zu versehen. Genannte Datei hat hier folgenden Inhalt:

$ cat -n defaults/main.yml 
     1	---
     2	libvirt_pool_dir: "/var/lib/libvirt/images"
     3	vm_root_pass: "123456"
     4	ssh_key: "/path/to/ssh-pub-key"
     5	
     6	guests:
     7	  test:
     8	    vm_ram_mb: 512
     9	    vm_vcpus: 1
    10	    vm_net: default
    11	    os_type: rhel7
    12	    file_type: qcow2
    13	    base_image_name: rhel7-template
    14	    vm_template: "rhel7-template"
    15	    second_hdd: false
    16	    second_hdd_size: ""
    17	  test2:
    18	    vm_ram_mb: 512
    19	    vm_vcpus: 1
    20	    vm_net: default
    21	    os_type: rhel8
    22	    file_type: qcow2
    23	    base_image_name: rhel8-template
    24	    vm_template: "rhel8-template"
    25	    second_hdd: true
    26	    second_hdd_size: "100M"

In Zeile 2-4 werden Variablen definiert, die unabhängig von einzelnen VMs für die gesamte Rolle gelten. Dies sind der Speicherort für Image-Dateien, das Passwort für den Root-Benutzer der VMs, sowie der Pfad zu dem SSH-Public-Key, welcher beim Root-Benutzer hinterlegt werden soll.

In Zeile 6 beginnt ein sogenanntes Ansible-Dictionary (siehe [6]) namens guests. Es enthält als Keys die Namen der VMs (hier test und test2) und ordnet diesen diverse Variablen als Werte zu (z.B. vm_ram_mb). Die hierfür gewählten Strings müssen gültige Ansible-Variablen sein (siehe [7]).

Die einzelnen Variablen kurz erklärt:

  • vm_ram_mb gibt die Größe des Gast-Arbeitsspeichers in Megabyte (MB) an.
  • vm_vcpus spezifiziert die Anzahl CPUs der VM.
  • vm_net bezeichnet das KVM-Netzwerk, mit dem die VM verbunden wird.
  • os_type wird aktuell noch nicht verwendet.
  • file_type gibt den Typ der Image-Datei an.
  • base_image_name verweist auf den Namen der zu verwendenden Vorlage, die zuvor manuell installiert wurde.
  • vm_template referenziert eine Jinja2-Template-Datei, welche wir uns im nächsten Abschnitt anschauen werden.
  • second_hdd kann auf true oder false gesetzt werden und bestimmt, ob einer VM eine zweite Festplatte hinzugefügt werden soll.
  • second_hdd_size gibt die Größe der zweiten Festplatte in Megabyte (MB) an.

Führt man diese Rolle mit einem Playbook aus, ohne eigene Variablen zu definieren, werden also zwei VMs mit den Namen test und test2 sowie den obigen Parametern erstellt.

Um die Rolle möglichst flexibel einsetzen und wiederverwenden zu können, werden die gewünschten Labor-Umgebungen in separaten Dateien definiert. Für mein RHEL-Lab habe ich die benötigten Variablen in die Datei vars/rhel_lab.yml geschrieben, welche ich mit ansible-vault create vars/rhel_lab.yml erstellt habe. So bleiben mein gewähltes Passwort sowie Pfad zu und Name von meinem SSH-Public-Key vor neugierigen Blicken geschützt. Der Inhalt der Datei entspricht vom Aufbau her jedoch dem aus obigem Code-Block der defaults/main.yml. Wie die Datei rhel_lab.yml genutzt wird, wird in Abschnitt „Das Playbook“ erläutert.

Templates

In der KVM-Terminologie wird eine VM auch als Gast-Domain (engl. guest domain) bezeichnet. Die Definition der Gast-Domain kann in Form einer XML-Datei erfolgen. In diesem Abschnitt werde ich zeigen, wie man die Konfiguration einer bestehenden VM in eine XML-Datei schreibt, um diese anschließend als Template für neue VMs zu benutzen.

Im Vorfeld habe ich die VMs rhel7-template und rhel8-template manuell installiert. Diese werde ich nun nutzen, um daraus Jinja2-Templates abzuleiten, welche ich innerhalb der Rollen-Verzeichnisstruktur im Verzeichnis templates ablege. Der folgende Codeblock zeigt den Befehl exemplarisch für das rhel7-template:

$ sudo virsh dumpxml rhel7-template >templates/rhel7-template.xml.j2

Das rhel8-template.xml.j2 wird auf die gleiche Weise erzeugt. Der Inhalt wird im Folgenden auszugsweise dargestellt:

<domain type='kvm'>
  <name>rhel8-template</name>
  <uuid>cb010068-fe32-4725-81e8-ec24ce237dcb</uuid>
  <metadata>
    <libosinfo:libosinfo xmlns:libosinfo="http://libosinfo.org/xmlns/libvirt/domain/1.0">
      <libosinfo:os id="http://redhat.com/rhel/8-unknown"/>
    </libosinfo:libosinfo>
  </metadata>
  <memory unit='KiB'>2097152</memory>
  <currentMemory unit='KiB'>2097152</currentMemory>
  <vcpu placement='static'>1</vcpu>
[...]
  <devices>
    <emulator>/usr/bin/qemu-system-x86_64</emulator>
    <disk type='file' device='disk'>
      <driver name='qemu' type='qcow2'/>
      <source file='/var/lib/libvirt/images/rhel8-template.qcow2'/>
      <target dev='vda' bus='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x06' function='0x0'/>
    </disk>
    <disk type='file' device='cdrom'>
      <driver name='qemu' type='raw'/>
      <target dev='hdb' bus='ide'/>
      <readonly/>
      <address type='drive' controller='0' bus='0' target='0' unit='1'/>
    </disk>
[...]
    <interface type='network'>
      <mac address='52:54:00:0c:8d:05'/>
      <source network='default'/>
      <model type='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x03' function='0x0'/>
    </interface>
[...]
  </devices>
</domain>

Die Template-Dateien sind zu bearbeiten, um aktuell statisch konfigurierte Werte durch Variablen zu ersetzen. Die zu bearbeitenden Zeilen sehen anschließend wie folgt aus:

  • <name>{{ item.key }}</name>
  • <memory unit='MiB'>{{ item.value.vm_ram_mb }}</memory>
  • <vcpu placement='static'>{{ item.value.vm_vcpus }}</vcpu>
  • <source file='{{ libvirt_pool_dir }}/{{ item.key }}.qcow2'/>
  • <source network='{{ item.value.vm_net }}'/>

Darüber hinaus sind weitere Zeilen, welche für jede VM einmalig sind, aus den Template-Dateien zu löschen:

  • <uuid>...</uuid>
  • <mac address='...'/>

In der fertigen rhel8-template.xml.j2-Datei sieht es dann wie folgt aus:

<domain type='kvm'>
  <name>{{ item.key }}</name>
  <metadata>
    <libosinfo:libosinfo xmlns:libosinfo="http://libosinfo.org/xmlns/libvirt/domain/1.0">
      <libosinfo:os id="http://redhat.com/rhel/8-unknown"/>
    </libosinfo:libosinfo>
  </metadata>
  <memory unit='MiB'>{{ item.value.vm_ram_mb }}</memory>
  <vcpu placement='static'>{{ item.value.vm_vcpus }}</vcpu>
[...]
  <devices>
    <emulator>/usr/bin/qemu-system-x86_64</emulator>
    <disk type='file' device='disk'>
      <driver name='qemu' type='qcow2'/>
      <source file='{{ libvirt_pool_dir }}/{{ item.key }}.qcow2'/>
      <target dev='vda' bus='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x06' function='0x0'/>
    </disk>
[...]
    <interface type='network'>
      <source network='{{ item.value.vm_net }}'/>
      <model type='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x03' function='0x0'/>
    </interface>
[...]
  </devices>
</domain>

Solltet ihr zu diesem Abschnitt noch Fragen haben, weil z.B. etwas unverständlich ist, stellt diese bitte in den Kommentaren oder meldet euch per E-Mail. Ich werde den Abschnitt dann je nach Bedarf ergänzen.

Tasks

Als Nächstes stelle ich die Tasks vor, welche von dieser Rolle ausgeführt werden. Dabei beginne ich mit dem Inhalt der Datei tasks/main.yml, deren Inhalt ich nach dem folgenden Codeblock erläutern werde.

$ cat -n tasks/main.yml 
     1	---
     2	# tasks file for kvm_provision_lab
     3	- name: Ensure requirements are in place
     4	  apt:
     5	    name:
     6	      - libguestfs-tools
     7	      - python3-libvirt
     8	    state: present
     9	  become: yes
    10	
    11	- name: Get VMs list
    12	  community.libvirt.virt:
    13	    command: list_vms
    14	  register: existing_vms
    15	  changed_when: no
    16	
    17	- name: Copy base image
    18	  copy:
    19	    dest: "{{ libvirt_pool_dir }}/{{ item.key }}.{{ item.value.file_type }}"
    20	    src: "{{ libvirt_pool_dir }}/{{ item.value.base_image_name }}.{{ item.value.file_type }}"
    21	    force: no
    22	    remote_src: yes
    23	    mode: 0660
    24	    group: libvirt-qemu
    25	  register: copy_results
    26	  with_dict: "{{ guests }}"
    27	
    28	- name: Create VMs if not exist
    29	  include_tasks: create_vms.yml
    30	  when: "item.key not in existing_vms.list_vms"
    31	  with_dict: "{{ guests }}"

Der Task in Zeile 3-9 stellt sicher, dass die notwendigen Voraussetzungen erfüllt sind, um sich mit libvirt verbinden zu können. Der Paketname libguestfs-tools existiert unter CentOS Stream, Debian und RHEL. Unter Fedora heißt das Paket guestfs-tools. Der Name muss an die entsprechende Distribution angepasst werden.

In Zeile 11-15 wird das Modul community.libvirt.virt verwendet, um die Liste der bereits existierenden VMs abzurufen und in der Variablen existing_vms zu speichern. Diese wird später genutzt, um nur dann eine VM zu provisionieren, wenn nicht bereits eine VM mit dem gleichen Namen existiert. Es ist quasi ein schmutziger Trick, um der Rolle ein wenig Idempotenz einzuhauchen. Da mit diesem Task nur Informationen abgefragt werden, jedoch keinerlei Änderungen vorgenommen werden, setzt man changed_when: no.

Das Copy-Modul in Zeile 17-26 kopiert die qcow2-Image-Dateien an den vorgesehenen Zielort und setzt Zugriffsrechte entsprechend. Zeile 19 sorgt dafür, dass die Zieldatei den Namen der neuen VM beinhaltet. Da das Copy-Modul bereits idempotent arbeitet, werden die Dateien nur kopiert, wenn das Ziel nicht bereits existiert. Das Ergebnis des Kopiervorgangs wird in copy_results gespeichert.

Der letzte Task führt die Task-Datei create_vms.yml für die VMs aus, die nicht bereits existieren. Dafür sorgt die Bedingung when: "item.key not in existing_vms.list_vms", die diesem Task zu Idempotenz verhilft. Das Playbook selbst hat folgenden Inhalt:

$ cat -n tasks/create_vms.yml 
     1	---
     2	- name: Configure the image
     3	  command: |
     4	    virt-customize -a {{ libvirt_pool_dir }}/{{ item.key }}.qcow2 \
     5	    --hostname {{ item.key }} \
     6	    --root-password password:{{ vm_root_pass }} \
     7	    --ssh-inject 'root:file:{{ ssh_key }}' \
     8	    --uninstall cloud-init --selinux-relabel
     9	  when: copy_results is changed
    10	
    11	- name: Define VMs
    12	  community.libvirt.virt:
    13	    command: define
    14	    xml: "{{ lookup('template', '{{ item.value.vm_template }}.xml.j2') }}"
    15	
    16	- name: Create second disk images if needed
    17	  command: |
    18	    qemu-img create -f {{ item.value.file_type }} \
    19	    {{ libvirt_pool_dir }}/{{ item.key }}-vdb.{{ item.value.file_type }} {{ item.value.second_hdd_size }}
    20	  become: yes
    21	  when: item.value.second_hdd|bool == true
    22	
    23	- name : Attach second disk image to domain
    24	  command: |
    25	    virsh attach-disk {{ item.key }} \
    26	    --source "{{ libvirt_pool_dir }}/{{ item.key }}-vdb.{{ item.value.file_type }}" \
    27	    --target vdb \
    28	    --persistent
    29	  become: yes
    30	  when: item.value.second_hdd|bool == true
    31	
    32	- name: Ensure VMs are startet
    33	  community.libvirt.virt:
    34	    name: "{{ item.key }}"
    35	    state: running
    36	  register: vm_start_results
    37	  until: "vm_start_results is success"
    38	  retries: 15
    39	  delay: 2

Der Task in Zeile 2-9 konfiguriert den Inhalt der qcow2-Image-Datei. Die Bedingung when: copy_results is changed stellt sicher, dass dies nur passiert, wenn die Image-Datei zuvor an ihren Zielort kopiert wurde. Damit wird sichergestellt, dass nicht eine bereits vorhandene Image-Datei einer existierenden VM nochmals verändert wird. Der Task konfiguriert den Hostnamen, setzt das Root-Passwort und hinterlegt den SSH-Public-Key.

Der nächste Task ab Zeile 11 definiert/erstellt die neue VM aus den XML-Template-Dateien.

Die beiden Tasks in den Zeilen 16-30 fügen einer VM eine zweite Festplatte hinzu, wenn dies in defaults/main.yml bzw. vars/rhel_lab.yml entsprechend definiert wurde.

Der letzte Task sorgt schließlich dafür, dass die neu erstellten VMs eingeschaltet werden.

Das Playbook

Im Vergleich zu den Dateien mit den einzelnen Tasks fällt das Playbook eher kurz aus:

 cat -n kvm_provision_rhel_lab.yml 
     1	---
     2	- name: Provision RHEL lab VMs
     3	  hosts: localhost
     4	  vars_files:
     5	    - roles/kvm_provision_lab/vars/rhel_lab.yml
     6	  tasks:
     7	    - name: Run role kvm_provision_lab
     8	      include_role:
     9	        name: kvm_provision_lab

In Zeile 3 ist der KVM-Hypervisor anzugeben, auf dem die Rolle ausgeführt werden soll. Dies kann, wie in meinem Fall, der gleiche Host wie der Ansible-Control-Node sein.

In Zeile 4 und 5 wird die Datei geladen, welche die Variablen für die zu erstellende Laborumgebung enthält. Ohne diese Anweisung werden die Werte aus defaults/main.yml verwendet.

Abschließend wird die Ansible-Rolle inkludiert. Dies ist auch schon alles.

Zusammenfassung

Das Schreiben dieses Artikels hat deutlich länger gedauert als die Erstellung der eigentlichen Ansible-Rolle zur Erstellung einer Laborumgebung unter KVM.

Die einzelnen Abschnitte beschreiben das Vorgehen und die Bestandteile der Rolle im Detail. Ich hoffe, damit deren Funktionsweise deutlich gemacht zu haben.

Ich kann nun meine Labor-Umgebungen in Dateien wie rhel_lab.yml, debian_lab.yml, etc. definieren und die Rolle dazu verwenden, diese zu provisionieren. So steht mir in kurzer Zeit eine frische Testumgebung bereit. Und zwar jedes Mal aufs neue, wenn ich sie benötige.

Wenn euch dieser Artikel dabei hilft, eigene Labor-Umgebungen mithilfe von Ansible zu provisionieren freut mich dies umso mehr.

Quellen und weiterführende Links

  1. Build a lab in 36 seconds with Ansible. Ricardo Gerardi (Red Hat, Sudoer). Enable Sysadmin. 2021-10-22.
  2. 8 Linux virsh subcommands for managing VMs on the command line. Ricardo Gerardi (Red Hat, Sudoer). Enable Sysadmin. 2021-09.09.
  3. Build a lab in five minutes with three simple commands. Alex Callejas (Red Hat). Enable Sysadmin. 2021-08-20.
  4. Ansible Create KVM Guests
  5. community.libvirt.virt – Manages virtual machines supported by libvirt
  6. Ansible Dictionary Variables. URL: https://docs.ansible.com/ansible/latest/user_guide/playbooks_variables.html#dictionary-variables
  7. Creating valid variable names. URL: https://docs.ansible.com/ansible/latest/user_guide/playbooks_variables.html#creating-valid-variable-names