staging.inyokaproject.org

2025 Woche 09

2. März 2025

In den letzten Tagen gab es einige Irritationen bezüglich angepasster Datenschutzhinweise und neuen Nutzungsbedingungen für Firefox, welche zu teils absurden Unterstellungen vor allem in den sozialen Medien, aber auch teilweise in der Berichterstattung geführt haben. Tatäschlich hat sich für Nutzer von Firefox überhaupt nichts geändert und es folgte lediglich eine inhaltliche Anpassung auf Grundlage rechtlicher Rahmenbedingungen. Dieser Artikel klärt auf.

Am 26. Februar 2025 hat Mozilla seine Datenschutzhinweise aktualisiert und Nutzungsbedingungen für Firefox eingeführt. Daraus wurde in den sozialen Medien und teilweise auch in der Berichterstattung eine an Absurdität kaum zu übertreffende Geschichte gesponnen. Besonders beliebt war es dabei, eine Text-Anpassung der Datenschutzhinweise herauszupicken und dabei den zu dem Zeitpunkt sehr wohl bereits vorhandenen Kontext zu verschweigen.

Konkret ging es dabei um die Frage, ob Mozilla Daten seiner Nutzer verkauft. Eine entsprechende Passage, die das explizit verneint, wurde tatsächlich entfernt. Daraus folgt aber keineswegs, dass Mozilla plötzlich die Daten seiner Nutzer verkaufen würde. Die Begründung wurde von Mozilla von Anfang an geliefert, aber von vielen, die einen vermeintlichen Skandal verbreitet haben, unterschlagen.

In Wahrheit liegen ausschließlich rechtliche Gründe für diese Anpassung vor. So geht es um die Definition der Begrifflichkeit „Verkauf von Daten“, welche nicht überall auf der Welt gleich ist. Mozilla musste Abstand von dieser definitiven Formulierung nehmen, um sich nicht angreifbar zu machen. Nach dem Verständnis der meisten Menschen darüber, was ein Verkauf von Daten bedeutet, hat Mozilla aber noch nie die Daten seiner Nutzer verkauft und dies auch in der Zukunft nicht vor.

Mit einer mittlerweile veröffentlichten Klarstellung hat Mozilla ein konkretes Beispiel genannt. So definiert unter anderem Kalifornien in seinem California Consumer Privacy Act (CCPA) den Verkauf von Daten als „Verkauf, Vermietung, Freigabe, Offenlegung, Verbreitung, Zurverfügungstellung, Übertragung oder anderweitige mündliche, schriftliche, elektronische oder sonstige Übermittlung der persönlichen Daten eines Verbrauchers durch [ein] Unternehmen an ein anderes Unternehmen oder einen Dritten im Austausch für Geld oder andere wertvolle Gegenleistungen“. Und hier liegt der Knackpunkt. Nach dem CCPA stellt Mozillas Geschäftsmodell für Firefox, welches seit mittlerweile 20 Jahren existiert und allgemein bekannt ist, einen Verkauf von Daten dar.

Selbstverständlich muss Mozilla gewisse Daten erheben und mit seinen kommerziellen Partnern teilen, um dafür Geld zu erhalten, welches die Entwicklung von Firefox finanziert. Da geht es zum Beispiel um Themen wie gesponserte Inhalte auf der Firefox-Startseite oder Vorschläge in der Adressleiste. Diese Dinge werden aber alle in der Datenschutzerklärung von Firefox behandelt und sind keine Neuigkeit. Außerdem achtet Mozilla darauf, dass die Daten, die weitergegeben werden, „von potenziell identifizierenden Informationen befreit sind, nur in aggregierter Form weitergegeben werden oder unsere datenschutzfreundlichen Technologien (wie OHTTP) durchlaufen haben“.

Auch andere US-Staaten wie Virgina und Colorado hätten ähnliche Datenschutzgesetze wie den CCPA – was Mozilla ausdrücklich begrüßt. Aber die unterschiedlichen Interpretationen der „Do-not-sell-Anforderungen lassen viele Unternehmen im Unklaren über ihre genauen Verpflichtungen und darüber, ob sie als Datenverkäufer angesehen werden oder nicht“, so Mozilla.

Die andere große Irritation entstand durch die neuen Nutzungsbedingungen, welche Mozilla gewisse Rechte zur Nutzung von Daten einräumt. Diese hat Mozilla in Reaktion auf die vielen Missverständnisse mittlerweile überarbeitet. Auch hier handelt es sich in Wahrheit lediglich um juristisch sichere Texte, welche Mozilla die Grundlage dafür geben, im Sinne des Anwenders zu agieren. So hat Mozilla diesbezüglich klargestellt, dass sie eine Lizenz brauchen, „damit wir einige der grundlegenden Funktionen von Firefox ermöglichen können. Ohne sie könnten wir zum Beispiel die in Firefox eingegebenen Informationen nicht verwenden. Sie gibt uns NICHT das Eigentum an Ihren Daten oder das Recht, sie für etwas anderes zu verwenden als das, was in den Datenschutzhinweisen beschrieben ist.“

Zusammenfassend lässt sich also sagen, dass wieder einmal viel Aufregung um gar nichts betrieben wurde. Mozilla hat Anpassungen seiner Bestimmungen aus rechtlicher Vorsicht vorgenommen. Für Nutzer von Firefox hat sich nicht das Geringste verändert. Viel mehr legt dieses Thema einmal mehr offen, wie „geil“ viele Menschen einfach nur nach großen Skandalen sind und nicht davor zurückschrecken, selbst den Namen von Organisationen wie Mozilla in den Schmutz zu ziehen, die sich wie kein anderer Browserhersteller für den Datenschutz der Nutzer einsetzen, indem ohne jeden Beweis das komplette Gegenteil unterstellt wird.

Der Beitrag Richtigstellung bezüglich Irritationen über neue Nutzungsbedingungen von Firefox erschien zuerst auf soeren-hentzschel.at.

Für das Suchen von Dateien / Verzeichnissen verwende ich seit Jahren einen sogenannten Fuzzy Finder. Genauer gesagt fzf, mit dem ich auch im Grunde zufrieden bin. Kürzlich wurde ich aber auf das Tool television aufmerksam und wollte es daher testen.

Television in einem Terminal Emulator gestartet

Die Suchergebnisse von television waren in meinem Fall nicht deutlich besser als die von fzf. Aber auch nicht merklich schlechter.

Was ich bei television allerdings interessant finde, sind die sogenannten Channels. So gibt es diverse vorkonfigurierte Kanäle. Zum Beispiel gitrepos mit denen man nur in Git-Repositories sucht. Oder files mit dem man nur nach Dateien sucht. So bietet das Tool einige Möglichkeiten die Suche flexibel einzuschränken.

Weiterhin kann man auch noch konfigurieren, bei welchem Befehl television überhaupt reagieren soll und welcher Kanal dann genutzt wird. In der Standardkonfiguration ist der Editor helix beispielsweise nur für den Kanal git-repos konfiguriert.

1[shell_integration.channel_triggers]
2"git-repos" = ["nvim", "code", "hx", "git·clone"]

Gibt man also im Terminal Emulator hx (oder helix je nach verwendeter Distribution) ein und führt dann den Shortcut STRG+t aus, wird nur in den erkannten lokalen Git-Repositories gesucht.

Weiterhin kann man aber auch neue Kanäle anlegen. Zum Beispiel um nach Dotfiles im Verzeichnis $HOME/.config zu suchen und hierbei für die Anzeige bat und für die Suche fd zu verwenden.

1[[cable_channel]]
2name = "dotfiles"
3source_command = 'fd -t f . $HOME/.config'
4preview_command = 'bat -n --color=always {0}'

Man kann allerdings auch die Standardkanäle anpassen. Hierfür erstellt man einfach, wie auch bei neuen Kanälen, einen Eintrag in beispielsweise der Datei $HOME/.config/television/my-custom-channels.toml und verwendet bei dem betreffenden Eintrag bei name einfach die Bezeichnung des betreffenden Standardkanals.

Ist nun television besser als beispielsweise fzf oder skim? Ich würde sagen, es kommt wie üblich auf den jeweiligen Nutzer und den jeweiligen Anwendungsfall an. Ich persönlich finde die Idee mit den Kanälen sehr interessant, sodass ich aktuell television deutlich öfters nutze als fzf. Ob ich allerdings beispielsweise komplett auf television umsteige oder beide Tools nutze, kann ich aktuell noch nicht sagen.

Was ich allerdings sagen kann ist, dass die Entwickler bei der Bezeichnung ihrer Tools mal etwas kreativer sein sollten. Ja, television und channels sind von der Idee her gut gewählt. Aber wenn man eine Suchmaschine nutzt, hat der Nutzer einfach mehr, meiner Meinung nach unnötigen, Aufwand. Das Gleiche gilt beispielsweise auch für Hugo (Generator von statischen Webseiten) oder für das Kommunikationsprotokoll Matrix. Ab und zu bin ich inzwischen sogar der Meinung, es wäre gut, wenn Entwickler neue Tools beispielsweise ugaZKp4Hab benennen würden, sodass man danach leichter eine Suchabfrage bei Google, DuckDuckGo oder wo auch immer stellen kann.

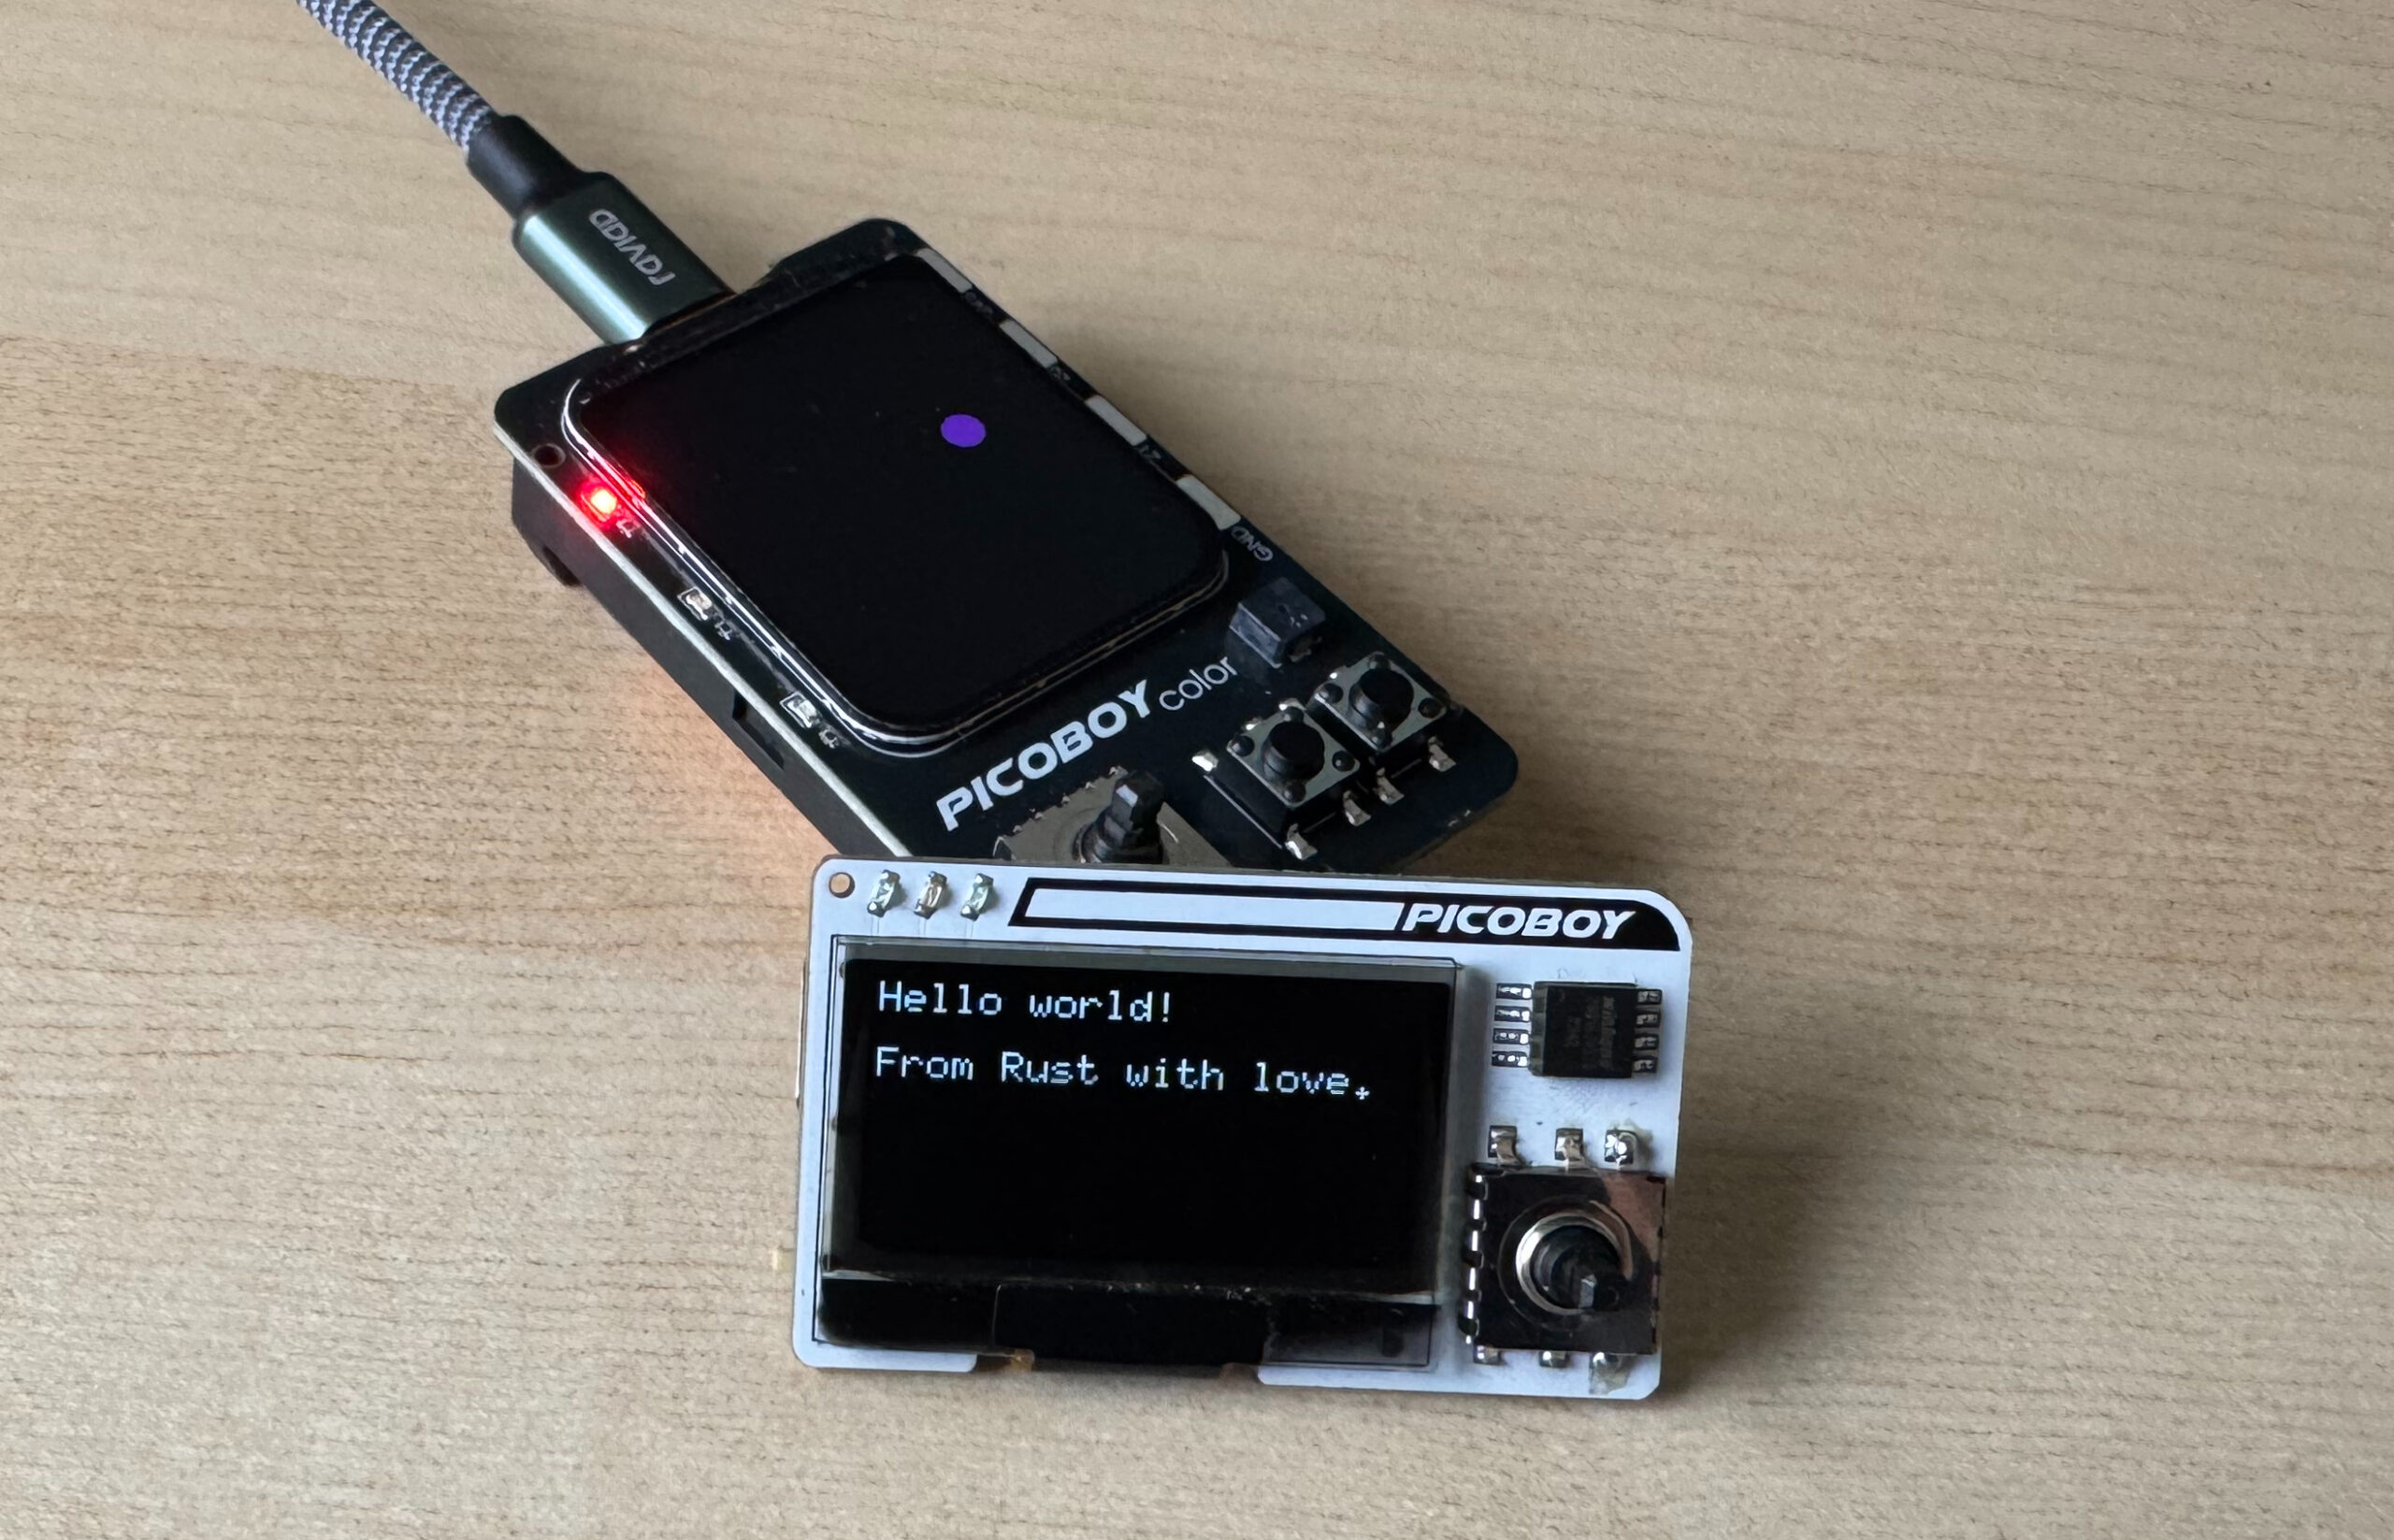
In den letzten Tagen erreichte mich der Picoboy Color, nachdem ich schon einige Zeit im Besitz eines Picoboy war. Neben den üblichen Spielereien war ich daran interessiert die beiden Geräte mittels Rust zum Laufen zu bekommen. Also warf ich einen Blick auf das vorhandene Tooling und am Ende entstanden zwei Crates, zur Anbindung der Picoboys an Rust.

Die entstandenen Crates

Auf Basis der rp-rs-Projekte entstanden, neben den Board Support Packages auch neue Templates zum Start neuer Projekte. Die einzelnen Repositorys sind hierbei picoboy-hal-boards, picoboy-project-template und picoboy-color-project-template. Sie sind jeweils under der Apache- und der MIT-Lizenz lizenziert.

Der Picoboy und der Picoboy Color, mittels Rust programmiert

Über das Rust-Werkzeug cargo-generate, welches mittels:

cargo install cargo-generate

installiert werden kann, können neue Projekte über die bereitgestellten Templates angelegt werden. Für den Picoboy wäre dies:

cargo generate --git https://github.com/seeseekey/picoboy-project-template.git

Analog dazu für den Picoboy Color:

cargo generate --git https://github.com/seeseekey/picoboy-color-project-template.git

Die Beispiele zeigen die Nutzung der Steuerung, das Zeichnen auf dem Display und einige weitere Kleinigkeiten. Hier ist an einigen Stellen durchaus noch Verbesserungsbedarf gegeben, so können z. B. die Abhängigkeiten angepasst werden, sobald die Basisbibliotheken von rp-rs auf die aktuellen Versionen aktualisiert wurden. Auch ein Upgrade der st7789-Bibliothek auf den Nachfolger mipidsi wäre dann denkbar.

Das Zeichnen auf dem Display erfolgt im Moment noch direkt, hier ließe sich die Performance durch die Nutzung von embedded-graphics-framebuf verbessern. Ebenfalls denkbar wäre eine weitere Modularisierung, so könnte z. B. die Controller- und Display-Initialisation in separate Rust-Module ausgelagert werden.

28. Februar 2025

Mozilla hat gestern eine Ankündigung für den Firefox gemacht: Sie führen dort Nutzungsbedingungen ein. Ein Open-Source-Browser, der bislang ganz gut ohne damit auskam, setzt jetzt auf das, was sonst eher in den AGB-Friedhöfen großer Plattformen vor sich hin verstaubt. Grundsätzlich lässt sich das noch mit einem wohlwollenden Achselzucken abtun: Natürlich braucht Mozilla sicherlich eine rechtliche Grundlage für all die interaktiven Dienste, die der moderne Browser so mit sich bringt. Soweit, so juristisch.

Aber das Timing? Es hätte suboptimaler nicht sein können. Fast zeitlich wurden nämlich jene Passagen von der Webseite entfernt, die bisher versprachen, die Nutzerdaten nicht zu verkaufen. Von der Community gab es daraufhin überwiegende kritische Reaktionen wie hier, hier, hier oder hier. Auch einer der zwischenzeitlich ausgeschiednenen Gründer von Mozilla sieht das Verhalten skeptisch.

Besonders kritisch wird dieser Absatz hervorgehoben:

When you upload or input information through Firefox, you hereby grant us a nonexclusive, royalty-free, worldwide license to use that information to help you navigate, experience, and interact with online content as you indicate with your use of Firefox.

Es stellt sich die Frage, warum ein Webbrowser überhaupt Nutzungsbedingungen braucht, wenn man als Nutzer doch schon den bestehenden Lizenzbedingungen zustimmen muss. In der Abfolge der Ereignisse der letzten Jahre lässt sich aber ein Trend erkennen, dass Mozilla sich von der Nutzerschaft in meinen Augen immer weiter entfernt.

Ein Blick in die Zahlen

Schauen wir uns hierzu einmal die Zahlen und Fakten an, um einen Überblick zu bekommen.

  • Der Marktanteil von Mozilla Firefox betrug nach Statcounter global im Jahr 2024 2,54%, während Chrome 67,08%, Safari 17,95% und Edge 5,2% ausmachen.
  • In Deutschland sieht das alles etwas anders aus: Historisch ist der Firefox hier sehr beliebt und kommt 2024 auf stolze 9,91% hinter Safari mit 20,4% und Chrome mit 51,83%.
  • Entwickelt und vertrieben wird der Firefox von der Mozilla Foundation sowie der Tochtergesellschaft Mozilla Corporation. Nach dem Finanzbericht 2023 der Foundation stammen gut 75% der Einnahmen aus sog. Royalities, die auch die Suchmaschinenpartnerschaften wie bei den berühmten Google-Deal umfassen. Für die Softwareentwicklung wurden 260 Mio. US-Dollar ausgegeben.

Firefox hat eine entscheidende Rolle für das Internetökosystem. Je mehr Googles eigene Browserplattform Chromium verbreitet ist, desto eher sind Internetstandards in Gefahr, da ohne Konkurrenz eine Spezifikation eines Standards überflüssig ist. Chromium wäre dann die Definition des Browserstandards. Google als potentiell eingestufter Monopolist wiederum kann mit der Finanzierung von Mozilla nachweisen, dass sie auch andere Browser unterstützen und gleichzeitig seinen eigenen Suchmaschinenstand manifestieren.

In genau diese Finanzierung kamen aber die letzten Jahre immer weitere Risse, nicht zuletzt durch die Kartellurteile gegen Google. Mozilla versucht schon seit Jahren, sich auf eigene Beine zu stellen, um nicht auf Google angewiesen zu sein. Umgesetzt wird dies durch Abonnements rund um den Browser, die ein stetiges Einkommen generieren sollen. Die Zahlen zeigen aber, dass die Einkünfte mit knapp 65 Mio. US-Dollar im Jahr 2023 gerade mal 10% der Gesamteinnahmen ausmachen und geradezu winzig gegenüber den ziemlich genau 4x höheren Entwicklungskosten aussehen.

Aber es ist doch alles Open Source?

Mozilla hat in den letzten Jahren darüber hinaus sein Engagement im Bereich künstlicher Intelligenz erhöht. Auch das mag die Sorge nähren, dass die zukünftig großzügig eingeräumten Berechtigungen dafür sorgen könnten, dass übertragene Daten für das eigene Training von Modellen oder den Verkauf von Trainingsdaten dienen könnten, um neue Finanzquellen zu erschließen. Ob die Sorgen berechtigt sind, wird sich in den nächsten Jahren zeigen.

An dieser Stelle mag man sich zwei Fragen stellen:

  1. Warum ist die Entwicklung eines Browsers so unfassbar teuer?
  2. Wie kann ein Open-Source-Browser so weit auf den kommerziellen Pfad rücken?

Ja, es überrascht, aber Browser und ihre Engines, also die Komponenten, die die Inhalte grafisch darstellbar machen, sind unfassbar komplexe Softwareprojekte geworden. Es ist heutzutage mitunter einfacher, ein einfaches Betriebssystem zu entwickeln als einen Webbrowser, der alle verschiedenen HTML- und CSS-Standards in allen Kompatibilitätsstufen beherrscht, eine Laufzeitumgebung für JavaScript besitzt und das auch performant umsetzt.

Lustigerweise war es gerade die Veröffentlichung von V8 im Google Chrome, die Anfang der 2010er-Jahre eine Wettbewerbssituation ausgelöst hat, JavaScript performant zu interpretieren, bis es auf einmal sogar im Backend eingesetzt werden konnte. Firefox wurde in der Zeit mit Vorhaben wie TraceMonkey deutlich performanter und konnte darüber hinaus viele Speicherlecks lösen.

Das ist auch der Grund, warum es so schwierig ist, einen Browser zu forken: Für die gesamte Codebase ist man auf einmal selber zuständig. Man muss sich also nicht nur darin einarbeiten, sondern gleichzeitig auf mehreren Fronten für die Sicherheit und Standardkonformität kämpfen, weil ein Browser so viele Technologien in sich vereint.

Ein Browser besteht somit aus einer einfach austauschbaren Oberfläche sowie einer Engine, die die Inhalte verarbeitet und zu einer grafisch darstellbaren Webseite verwandelt. Im Falle von Firefox war es bisher Gecko (neuerdings wohl auch Quantum genannt) und bei Google Chrome ist es Chromium. Anpassungen und Forks von Chromium wie Microsoft Edge oder Brave, die die Oberfläche anpassen, haben einen deutlich einfacheren Job als ein Projekt wie Firefox, das eine komplette Engine entwickeln muss. Aber genau diese Vielfalt an Engines schafft einen gesunden Wettbewerb.

Dieses Know-how wird auf einmal zum Asset und kann monetarisiert werden. Denn während die Open-Source-Engine lokal arbeitet, kann die Oberfläche immer mehr mit den eigenen Diensten verwoben werden – die wiederum eine Nutzungsbedingung erfordern. Diesen Weg ist Android sehr erfolgreich mit den Google-Diensten gegangen. Eine übliche Android-App greift einerseits auf Bibliotheken aus dem Android-Kern als auf Google-Mehrwertdienste zurück und kann somit nicht ohne die Google Play Store Services ausgeführt werden, die zum Vertrieb von den Smartphoneherstellern eine umfangreiche und strikte Zertifizierung abfordern. Schließt man diese Services ersatzlos aus, wird es mittlerweile überraschend ruhig bei Android.

Der Browser als Politikum

Der Browser als das Tor in das Internet ist mittlerweile auch in das politische Visier geraten. Zuletzt wurden in den EU-Rechtsakten rund um "eIDAS 2.0" (Verordnung (EU) 2024/1183) im Artikel 45a Browser in einer kritischen Komponente reguliert. Die EU fordert dort ein, dass Browser sich staatlichen Zertifizierungsstellen beugen müssen und diese nicht ausschließen dürfen. Zertifizierungsstellen (CAs) bestätigen die Identität von Webservern und können im schlimmsten Fall genutzt werden, um sich fälschlich als eine fremde Seite auszuweisen und sich so in die Verbindungen einzuklinken. Bisher wird die Liste zulässiger CAs in einer selbstverwalteten Branchenvereinigung namens CA/Browser-Forum gelöst, nun erzwingen sich Staaten einen Zugang.

Die Browserhersteller sind somit in ihrer Wahl der Sicherheitsfunktionen regulatorisch eingeschränkt. Erst nach öffentlichem Druck u.a. von Mozilla kam die EU leicht entgegen und erlaubt jetzt den temporären Ausschluss von Zertifizierungsstellen, wenn es begründete Sicherheitsbedenken gibt.

Auch in dieser Hinsicht steigen die Markteintrittsbarrieren neuer Webbrowser, wenn sie zusätzlich neben der Entwicklung noch juristische Fragen beantworten müssen.

Quo vadis?

Ich bin seit über 15 Jahren überwiegend treuer Firefox-Nutzer und schätze auch neuere Funktionalitäten wie den eingebauten PDF-Reader PDF.js. Der Einbindung der Online-Dienste zum scheinbaren Selbstzweck, insbesondere auch mit "KI-Funktionen", stehe ich aber kritisch gegenüber – und teile meine Meinung in der Frage mit vielen Nutzern.

Gleichzeitig muss man aber auch wissen, dass es nahezu unmöglich ist, ein hochkomplexes Softwareprojekt in der Entwicklung zu finanzieren, wenn es nicht gerade eine kommerzielle Verwertung genießt. Zwei bekannte Ausnahmen von dieser Regel sind:

  • der Linux-Kernel, der als Infrastrukturtechnologie durch die Komponentenhersteller, Softwareunternehmen und Cloud-Anbieter finanziert wird, sowie
  • das Firefox-Projekt, das im Wesentlichen vom Google-Deal lebt.

Hier haben also kommerzielle Unternehmen einen Vorteil vom Projekt und können das Geld umlegen und als "Abfallprodukt" ein Produkt für die Allgemeinheit schaffen.

Wenn Firefox allerdings finanziell neu organisiert werden muss, gibt es drei Optionen:

  • entweder muss das Projekt die Infrastrukturtechnologie auf irgendeine Weise kommerzialisieren oder
  • es findet sich ein Industriekonsortium, das einen solchen Vorteil aus der Existenz von Firefox zieht, dass es die Kosten schultert oder
  • Fonds und Förderprojekte wie der OTF in den USA oder STF in Deutschland finanzieren das Projekt strategisch aus der öffentlichen Hand.

Entscheidend ist, dass die Wettbewerbssituation und die Datenhoheit von Webbrowsern nicht nur taktisch, sondern strategisch für das Fortkommen identifiziert werden.

24. Februar 2025

Das MQTT-Passwort lässt sich auf der Konsole des Home Assistant Systems in der Datei /mnt/data/supervisor/homeassistant/.storage/core.config_entries finden. Der entsprechende Eintrag sieht bei mir wie folgt aus:

{
        "created_at": "1970-01-01T00:00:00+00:00",
        "data": {
          "birth_message": {
            "payload": "online",
            "qos": 0,
            "retain": false,
            "topic": "homeassistant/status"
          },
          "broker": "localhost",
          "discovery": true,
          "discovery_prefix": "homeassistant",
          "password": "hierstehtmeinmegalangesundkomplexespasswort",
          "port": 1883,
          "username": "homeassistant",
          "will_message": {
            "payload": "offline",
            "qos": 0,
            "retain": false,
            "topic": "homeassistant/status"
          }
},

Jetzt steht das Passwort in meinem Passwort-Manager KeePassXC und ich werde auf diesen Beitrag hoffentlich nicht so schnell zurückgreifen müssen.

Weitere Links zum Thema