staging.inyokaproject.org

22. September 2020

Die Snowden-Leaks und ihre Folgen ordnet Wikipedia inzwischen international im Artikel Globale Überwachungs- und Spionageaffäre ein. Kein anderes Ereignis hat die Öffentlichkeit derart aufgerüttelt und Datensicherheit, Datenschutz und digitale Privatsphäre so nachhaltig im öffentlichen Bewusstsein verankert. Seitdem haben wir viel erreicht.

Oft werde ich kritisiert, weil ich vor allem kritisiere (welch Ironie!). Das liegt vermutlich weniger an der fehlenden Wahrnehmung von Erfolgen, als vielmehr als der Natur des Menschen (oder doch nur meiner?). Negativpunkte, Fehlentwicklung und Defizite stechen mehr ins Auge als Bereiche in denen es einfach gut läuft. Darum möchte ich in diesem Artikel mal ein wenig resümieren was seit 2013 erreicht wurde.

Ein Blick in den Abgrund

Zum Zeitpunkt der Snowden-Leaks sah es bei der digitalen Privatsphäre sehr schlecht aus. Verschlüsselung von Kommunikation und Daten auf den Geräten und auf dem Transportweg war in nahezu allen Bereichen ein Nischenthema oder komplette Fehlanzeige. Hemmungslose Datensammlungen waren zwar nicht legal (die Unterschiede zwischen dem alten deutschen Datenschutzrecht und der DSGVO sind geringer als die meisten glauben) aber allgemein praktiziert. Die weltweiten Datenströme waren für die Geheimdienste somit offene Bücher in denen man nur mitlesen musste. Das gleiche galt für die großen IT-Konzerne und den bei ihnen gespeicherten Daten. Die meisten Menschen leisteten sich zudem ein laxes Verhältnis Privatsphäre im Internet. Soziale Netzwerke als Massenphänomen waren schließlich noch relativ jung.

Sichere Kommunikation allgegenwärtig

Durch die Snowden-Veröffentlichungen ist Verschlüsselung ein Mainstream-Thema geworden.

Bereits in den Folgejahren hat sich im Bereich der E-Mail Sicherheit sehr viel getan. Mein Mailanbieter verweigert automatisiert den Versand an einem Empfänger ohne aktive Transportverschlüsselung. Es ist ewig nicht mehr vorgekommen, dass ich eine entsprechende Wartnung erhielt. Transportverschlüsselung und weiterführende Technologien sind heute selbstverständlich.

Die E-Mail verliert im privaten Bereich an Boden, das schwächt aber nicht die Sicherheit der Inhalte, sondern stärkt sie eher. Der Marktführer WhatsApp verschlüsselt seit 2014 die Inhalte mit einem anerkannten und sicheren Verfahren. Dabei handelte es sich mutmaßlich um eine Reaktion auf die damals aus dem Boden schießenden Alternativen mit mehr Sicherheit. Obwohl WhatsApp also nachgerüstet hat, konnten sich mit Signal und Threema sichere und datenschutzfreundliche Alternativen in einem geringen Umfang etablieren.

Das Thema sichere Gruppen- und Videkommunikation wurde durch die Corona-Pandemie dann 2020 in den Fokus gerückt. Die Defizite waren offensichtlich und beim Senkrechtstarter Zoom hatte man in der Gründungsphase die Prioritäten anders gewichtet. Der öffentliche Fokus auf dieses Phänomen brachte hier aber zeitnah Besserung. Dieser Punkt ist kaum zu unterschätzen. Es ist nicht selbstverständlich, dass während einer Pandemie und einer veränderten digitalen Kommunikation automatisch in der Mainstream-Presse das Thema Sicherheit und Verschlüsselung prominent thematisiert wird. Bei der suche nach freien und unabhängigen Alternativen dürfte Jitsi Meet allgemein gestärkt aus der Krise gehen. Bis dahin fristete das Projekt doch eher ein Nischendasein.

Verschlüsselung ist Standard

Verschlüsselung von Daten ist älter als 2013, aber wer hat das ernsthaft praktiziert. Windows 7, Linux, macOS - sie allen kamen standardmäßig ohne Verschlüsselung. Das gleiche galt für iOS und Android. Seitdem gab es massive Fortschritte. Die Smartphones des Duopols iOS / Android sind heute quasi standardmäßig verschlüsselt. Man kann von biometrischen Entsperrmechanismen halten was man will (siehe: Biometrische Daten zur Authentifizierung sind unsicher!) aber der direkte Sicherheitsgewinn ist sicherlich enorm. Windows 10 und macOS bieten heute ebenfalls eine implementierte und einfach zu aktivierende Verschlüsselung und bei Linux bieten immer mehr Distributionen eine einfache Aktivierung in der Installationsroutine.

Cloud im Fokus

Seit 2013 hat sich vor allem im Bereich "Cloud" viel getan. Die Fortschritte sind hier nicht ganz so evident nachvollziehbar aber dennoch beachtlich. Mit Nextcloud steht eine relativ einfache Lösung für Privatanwender und kleine bis mittlere Firmen zur Verfügung um eine eigene Cloud zu betreiben. Die verbreiteten Heimanwender-NAS-Anbieter Synology und QNAP haben ebenfalls nachgelegt. Die Mehrheit dürfte dennoch immer noch nicht einen kommerziellen Dienstanbieter nutzen. Hier stehen mit Boxcryptor oder Cryptomator allerdings bekannte und einfach zu bedienende Verschlüsselungslösungen zur Verfügung.

DSGVO wirkt

Die DSGVO etablierte deutsches Datenschutzniveau für Europa und strahlt auch darüber hinaus in die Welt aus. Der Schock war groß (und gerade deutsche Firmen sollten da eigentlich ganz leise sein, da die DSGVO wenig Neues beinhaltete), am Anfang ruckelte es gewaltig und es gibt immer noch mannigfaltige Probleme. Dennoch ist der Mehrwert inzwischen klar zu erkennen.

Misstraut man einem Unternehmen oder möchte schlicht nur wissen, was es genau speichert, bietet die DSGVO mächtige Verbraucherrechte. Die Firmen zieren sich teilweise ein wenig und lassen einen ein paar Mal nachhaken aber letztendlich bekommt man sehr viele Informationen.

Die manchmal nervigen Cookie-Abfragen stellen zwar alte Datenschutz-Strategien auf den Kopf (siehe: Cookie Löschung als Datenschutz Maßnahme obsolet?) aber ein besserer Umgang mit Nutzerdaten zeichnet sich ab. Viele Webseiten bieten inzwischen wegen den gesetzlichen Anforderungen die Möglichkeit einer Datenerhebung weitestgehend zu widersprechen und erste Tests zeigen, dass dem dann auch wirklich so ist.

Open Source verbessert und akzeptiert

In der direkten Nachfolge der Leaks hatte die OSS-Community ein paar Rückschläge zu erleiden. Skandale wie Heartbleed legten öffentlichkeitswirksame Probleme und Schwachstellen offen. In der Praxis fehlendes Mehr-Augen-Prinzip, intransparente Projektstrukturen und der verbreitete Einsatz in der weltweiten Infrastruktur ohne entsprechende Beteiligung der einsetzenden IT-Konzerne. Die daraus folgenden Lehren haben aber viele Projekte verbessert. 

Im Bewusstsein einer breiteren Öffentlichkeit ist Open Source als Alternative zu proprietären Produkten akzeptiert und wird in der Regel als datenschutzfreundlicher und sicherer wahrgenommen. Nichts zuletzt Microsofts neue Open Source Strategie spricht da Bände. Open Source Software dürfte bewusst oder unbewusst bei den meisten Menschen vorhanden sein.

Das geringe Bewusstsein kommt vor allem durch den Einsatzort. Wer weiß schon, was der Linux-Kernel in Android macht, welches System auf seinem Router läuft oder mit welcher Technik WhatsApp Inhalte verschlüsselt. Ausgerechnet die klassischen OSS-Projekte wie Linux am Desktop oder Firefox konnten nicht oder nur unwesentlich profitieren. Allerdings liefert Microsoft mit Windows 10 nun quasi Linux mit. Wer hätte das vor 10 Jahren gedacht?

Privatsphäre im Marketing

Vor nahezu einem Jahrzehnt ließ sich Mark Zuckerberg zur Aussage Privatsphäre sei überholt hinreißen. Die IT-Geschichte ist voll von legendären Fehlannahmen und Irrtümern und die Aussage des Facebook-Chefs reiht sich da nahtlos ein.

Nahezu jede Firma im Digitalbereich schreibt sich heute öffentlichkeitswirksam Privatsphäre, Datenschutz und Sicherheit auf die Fahnen. Obwohl es bei manchen an Substanz dahinter mangelt, gibt es auch Positivbeispiele (siehe: Apple vs. Google - Datenschutz und Sicherheit) In manchen Bereichen wie der Webbrowser-Entwicklung hat sich dieser Trend durch Konkurrenz fast verselbstständigt.

Bewusstsein

Der wichtigste Punkt ist jedoch das weit verbreitete Bewusstsein. Die meisten Menschen sehen das Internet nicht mehr als ihr erweitertes Wohnzimmer, sondern wissen, dass sie in der Öffentlichkeit (inter-)agieren. Man kann es Selbstzensur nennen oder einfach die gesunde Übertragung von analogen Gewohnheiten in den digitalen Raum. So wie niemand entgleiste Partybilder auf dem Marktplatz ausstellen würde, kommen diese auch in den Social Media-Kanälen nicht mehr in diesem Maße vor (man erinnere sich an StudiVZ).


Bilder:

Einleitungs- und Beitragsbild von Megan_Rexazin via pixabay

"

21. September 2020


Friendica Hackathon 25.09.2020


Kurz nach dem neuen Friendica 2020.09 Red Hot Poker Release geht es auch schon weiter mit dem alljährlichen Hackathon.


Kommenden Freitag den 25.09.2020 findet der virtuelle Hackathon ab 17 Uhr für alle Projektbeteiligten statt. Der Hackathon dauert bis zum Sonntag den 27.09.2020 … bis das Licht ausgemacht wird.


Ab Freitag, 20 Uhr deutscher Zeit (UTC 18:00) findet eine Open Round Table für alle Benutzer und generell Interessierte statt. Wenn ihr Fragen zum Projekt, zur Oberfläche, zu Funktionen, zum Fediverse oder dem ganzen Rest habt, dann seid ihr herzlichst eingeladen euch einzuklinken, zu fragen und mitzumachen.Und natürlich seid ihr auch herzlich willkommen, wenn ihr öfter oder auch längerfristig bei Friendica Mitwirken wollt. #WeAreFamily

Eine Bitte noch: Benutzt bitte ein Headset und die Push-2-Talk Funktion, so dass den anderen nicht die Ohren abfliegen. Standardmäßig sind die oftmals streng limitiert und ohne Ohren halten Brillen wirklich sehr schlecht.

Die Zugangsdaten für die Open Round Table auf Big Blue Button lauten:

URL = https://public.senfcall.de/Friendica%20Hackathon%202020
Passwort = friendica


Die entsprechenden URLs für den Video-/Audio Call mit Big Blue Button auf dem Senfcall System und weitere Termine für die Projektbeteiligten werden auf einem Cryptopad https://cryptpad.fr/pad/#/2/pad/edit/TzVdf-GDbUYkdvUpAU2GUhjA/ veröffentlicht und aktuell gehalten.


Und natürlich werden offizielle Mitteilungen auch auf dem Friendica Hackathon Blog veröffentlicht https://friendi.ca/tag/hackathon/


Hier noch eine kleine UTC Weltzeit-Tabelle, falls ihr in einer anderen Zeitzone wohnen solltet. Quelle: https://www.timeanddate.com/worldclock/meeting.html

UTC-time Fr 18:00
Berlin Fr 20:00
New York Fr 14:00
Los Angeles Fr 11:00
Singapore Sa 02:00
Canberra Sa 04:00


Und wieder gibt es ein neues Friendica Release, nämlich 2020.09 Red Hot Poker “Fackellilie". Viele der Features dieses Releases liegen unter der Haube. Friendica wird von Release zu Release immer schneller. Das kommt daher, dass der Code- und Datenbankumbau und Optimierung weiter fortschreiten. Wenn das so weiter geht müssen die Friendica Admins ihre Server downsizen. Aber mal Spaß beiseite, es ist wirklich toll, was die Entwickler wieder einmal geleistet haben. Der Server wird bei absoluter Stabilität immer schneller und verbraucht dabei immer weniger Platz.

Aber nicht nur unter der Haube hat sich etwas getan, sondern auch der Benutzer kann wieder von neuen Featuren profitieren.


So gibt es jetzt ein neues Relay Server Konzept für das Abonnieren von Hashtags. Bisher nutzte Friendica Relay Server von Diaspora. Diese sind aber abgeschaltet worden. Friendica nutzt jetzt ActivityPup (AP) konforme Relay Server und der Aufbau von sprachraumorientierten Relay Servern, also z.B. für den deutschen oder den englischen Sprachraum sind im vollen Gange.

Diese Einstellungen werden vom Friendica Knoten Betreiber/Admin getätigt auf der Kommandozeile mit dem Befehl bin/console relay add RELAYSERVER eingestellt. Eine Übersicht von Relay Servern im Fediverse gibt es hier https://the-federation.info/activityrelay . Dazu ist es wichtig zu wissen, dass der Console Befehl eine komplette URL erwartet, wie z.B. https://relayserver.tld/actor . Das heisst man muss händisch, die Information von the-federation vorne um das https:// und hinten um den /actor erweitern.

Eine GUI Variante für das Adminpanel ist für das nächste Release geplant. Als Benutzer merkt man nur, dass wieder mehr Hashtag-orientierte Beiträge auf dem Knoten erscheinen.


Das Theme Frio hat jetzt weitere Styles bekommen, so dass man zwischen einem hellem, einem dunklen und einem schwarzen Style wählen kann. Innerhalb des Styles kann man auch noch die Akzentfarbe, also die Farbe, mit der Links und Überschriften angezeigt werden wählen.


Die öffentlichen Kalendereinträge sind jetzt auch als iCAL abonnierbar.


Wer noch mehr technische Details zu diesem Release nachlesen will, kann sich das CHANGELOG zum Gemüte führen https://github.com/friendica/friendica/pull/9146/files

Die offizielle Nachricht über die neue Friendica Ausgabe könnt ihr auf englisch hier nachlesen https://friendi.ca/2020/09/20/friendica-2020-09-released/


Ich will noch ein wenig zur Geschichte und ganz zum Schluss zum aktuellen Resourcenverbrauch von Friendica etwas erzählen.


Ein bisschen Geschichte

Als ich vor 4 Jahren mit meinem 2-20 User Server anfing, war einer der Gründe, warum ich mich für Friendica entschied, dass Friendica über automatisierte Löschfunktionen verfügt. So kann man relativ detailiert einstellen, wie und nach welcher Zeit welche Art von Beiträgen gelöscht werden sollen und welche nicht. Micro- oder Macroblogging ist für mich eine temporäre Sache. Wie oft liest man alte Beiträge auf diesen Netzwerken “nach"? Für mich wichtige Beiträge schreibe ich hier ins Blog, in mein Wiki, oder lokal in mein Gedankensammlungszettelkasten “Obsidian".


Anfangs war die Datenbank teilweise bis zu 8 GB groß, mittlerweile versucht sie die 2GB Grenze zu unterbieten. Im Laufe der Zeit sind viele Kontakte hinzugekommen und auch seit das Abonnieren von Hashtags hinzugekommen sind, ist die Datenbankgröße dennoch gesunken. Wobei man ehrlicherweise sagen muss, dass Friendica früher ALLES in der Datenbank gespeichert hatte. Mittlerweile wird das aufgeteilt in Datenbank und Dateisystem.


Als Friendica dann um ein Dateispeicher-Backend erweitert wurde, konnte man endlich sämtliche Bilder aus der Datenbank im Dateisystem speichern. Die Datenbank schrumpfte bei mir um die Hälfte auf 4GB und die anderen 4 GB wurden auf die Festplatte ausgelagert. Das hatte den Effekt, dass die Datenbank und dadurch auch Friendica um einiges schneller wurde und die Last (Load) auf dem System sehr viel geringer wurde. Ich behaupte jetzt einfach mal, dass auf einem 6 CPU 8GB RAM VPS Server die Load von 8-10 mittlerweile auf unter 1 gerutscht ist. aufrichtigerweise muss man sagen, dass das sicherlich nicht nur der Verdienst von Friendica selbst ist, sondern auch die Evolution von PHP 5.x auf PHP 7.x


Ein Blick in die Zukunft

Mittlerweile wird der Quellcode immer weiter optimiert und, ich nenne es mal abstrahiert. Das hat den Hintergrund, dass man in Zukunft eventuell auch andere Datenbanken we z.B. PostgressSQL benutzen kann. Dazu wurden sogenannte Datenbank Views eingeführt.


“Kurz” erklärt sind Datenbank Views in der Datenbank fest definierte Abfragen und Speichervorgänge, die sonst direkt im Quellcode definiert waren. Man kann sich das wie eine virtuelle Tabelle vorstellen. Diese zieht ihre Informationen aus den diversen Tabellen zusammen, die für die entsprechende Seite, oder Funktion im Browser gebraucht werden.


Dadurch, dass man jetzt nur noch an die Datenbank eine extrem einfache Abfrage dieser virtuellen Tabelle (View) machen muss, kann man zum einen innerhalb der Datenbank sämtliche Strukturen umbauen bzw optimieren und die View bleibt nach außen immer gleich. Das gilt auch für den schreibenden Zugriff auf die Datembank. Zum anderen muss man in anderen Datenbanksystemen wie MariaDB oder PostgreSQL die Datenbank bzw die Views nur noch anlegen. In Friendicas Konfiguration wird dann nur noch angegeben, welche Datenbank benutzt werden soll. Das ist noch Zukunft, aber die Arbeiten laufen in diese Richtung.


Ein bisschen Resourcen

Ich habe im Forum der Friendica Admins mal gebeten eine ungefähre Angabe zu machen, was sie für Hardware mit Ausstattung haben, wie viele Benutzer auf den Systemen sind und was sie für eine Auslasung haben, damit man ein wenig ein Gefühl dafür bekommt, wenn man einen eigenen Server aufsetzen möchte.

Die Datenbankgröße und Cache/Storage sind natürlich abhängig von der generellen Einstellung der Speicherdauer. Dazu kommt, dass Friendica noch eine Proxy Option besitzt, mit der externe Inhalte wie z.B. Vorschaubilder von Youtube oder anderen Quellen, die einfach nur dazu geladen werden, über den Server dazu geladen und an den Client ausgeliefert werden. Statt, dass jeder Client sich diese Daten selbst lädt. Diese Option erhöht natürlich die Privatssphäre belastet aber den Server mit Traffic und Speicherplatz.


Hier sind nun die Ergebnisse

Server 1

  • VPS Server mit einigen anderen Applikationen
  • 6 CPUs, 8 GB RAM
  • Datenbank 2.5 GB, Cache/Storage 7 GB, kein Proxy
  • 15 Accounts, Load 0.5 - 1.5

Server 2

  • VPS Server, dedizierter Friendica Server
  • 8 CPUs, 20 GB RAM
  • Datenbank 15.5 GB, Cache/Storage 16.3 GB , kein Proxy
  • 8 Accounts, Load 0.4 - 1

Server 3

  • Root Server
  • 6 CPUs, 16 GB RAM
  • Datenbank 60 GB
  • 80 Accounts, Load 0.5 - 3

Server 4

  • VPS Server
  • 6 CPUs, 32 GB RAM
  • Datenbank 100 GB
  • 1.400 Accounts, Load 1-4

Server 5

  • VM / VPS
  • 2 CPUs, 4 GB RAM
  • Datenbank 11 GB
  • 1 Account, Load 3

Server 6

  • RaspberryPi 2
  • 4 CPUs, 500 MB RAM
  • 12 Accounts, Load 1-5


Viel Spass mit dem neuen Release 2020.09 Red Hot Poker (Fackellilien) https://de.wikipedia.org/wiki/Fackellilien


20. September 2020

Im Mai hatte ich elementary OS anstelle Kubuntu auf den von mir betreuten Geräten installiert (siehe: elementary OS im Consumer-Einsatz - Ein Experiment). Die Zwischenbilanz fällt ziemlich gemischt aus. Die elementary Software funktioniert gut, die Ubuntu-Basis leider nicht.

Die Wahl des elementary Projekts Ubuntu als Basis zu nehmen hatte ich immer komisch gefunden. Man bindet sich dadurch an die strategischen Entscheidungen Canonicals. Erste Probleme zeigen sich schon durch die Entscheidung des eOS Teams für Flatpak. Ich hätte aber nicht erwartet, dass das Zusammenspiel so viele Probleme macht.

Es zeigte sich leider, dass der Zustand von Ubuntu außerhalb "mains" noch schlimmer ist, als befürchtet. Ubuntu 18.04 ist im "universe" eigentlich nur noch eine Sammlung von Sicherheitslücken und Bugs. In die läuft man dann mit elementary OS haufenweise rein. Aktuellere Software wie Chromium gibt es nur noch als Snaps und eben jene möchte das eOS-Team nicht unterstützen. Inwieweit das trotzdem harmoniert wollte ich nicht ausprobieren. Hinzu kommen ärgerliche Bugs. Ein bekanntes Problem sind beispielsweise Notebooks, die nicht mehr aus dem Standby aufwachen. Das Problem liegt wohl irgendwo im Zusammenspiel von systemd und light-locker. Das eOS Team verweist auf Ubuntu und dort interessiert das niemanden, weil Ubuntu im Hauptzweig GDM nutzt.

Die Desktopumgebung Pantheon Shell und zentrale Programme funktionieren jedoch beim Anwender sehr gut. Wenige Schaltflächen, durchdachte Menüführungen und Designkonzepte zeigen ihre positive Wirkung. Das gilt für eigentlich für die gesamte Basis wie die Shell, den Dateimanager, den Kalender, die Fotoverwaltung die Mailanwendung.

Aus diesem Grund habe ich anstelle einer vollständigen Abkehr von eOS bereits im Juni die Basis auf Fedora 32 (siehe: Fedora 32 mit Pantheon Shell) umgezogen. Das funktioniert seitdem im Alltagsbetrieb mit Autoupdates erstaunlich reibungslos.

Nach der Veröffentlichung von elementary OS 6 mit Ubuntu 20.04 als Basis werde ich nochmal prüfen, ob eine Rückkehr zu einem reinen eOS denkbar ist oder es bei Fedora in Pantheon Flavour bleibt.

Langfristig denke ich aber, dass ein Wechsel des eOS Team auf eine passendere Basis unausweichlich ist.

"

19. September 2020

Seid ihr zufällig Nutzer von KDE Plasma 5.19.5 sowie Frameworks 5.74.0 und habt gerade auf Qt 5.15.1 geupdated? Nun, das kann schiefgehen. Bei mir hat es das Multi-monitor-Setup erfolgreich zerlegt.

Ist gefixt, siehe Update!

Aktueller Workaround (siehe Update): KRunner aufrufen, plasmashell --replace ausführen.

Ich bin eigentlich KDE-Nutzer, weil man sich so schön die Oberfläche einrichten kann. Solche Dinge wie verschiedene Widgets und Hintergrundbilder, Schnellstartleiste oder Fensterleiste, die nur die Fenster anzeigt, die auch gerade auf dem Monitor liegen. Ist nun leider etwas glitchy momentan, erst einmal sind die Hintergrundbilder gezielt vertauscht, die Fensterleisten zeigen wahlweise die Fenster des jeweils anderen Monitors oder alle von einem bestimmten Monitor an und um das alles in Ordnung zu bringen, darf man x mal in den Einstellungen Primärbildschirm sowie Anordnung tauschen. Dann läuft es wieder – wohlgemerkt bis zum nächsten Neustart.

Aber ich bin damit zum Glück nicht alleine. Das beruhigt wenigstens. Ich habe erst einmal ein Downgrade gemacht, so läuft es wenigstens wieder.

Wir können gespannt bleiben, wenn ich es nicht vergesse, werde ich euch hier auf dem Laufenden halten.

Update 19.09. 22:20 Uhr: hier mal der Bugreport beim Qt-Projekt.

Update 19.09. 22:22 Uhr: Darüber hinaus gibt es einen Reddit-Thread, in dem auch das Event Calendar Applet als Verursacher verdächtigt wird und wo ein Workaround Abhilfe schaffen soll.

Update 20.09. 11:40 Uhr: endlich ein handhabbarer Workaround: im o.g. Reddit-Thread wird vor allem plasmashell --replace empfohlen. Das heißt, dass man trotzdem wie gewohnt upgraden kann und KDE mit der verdrehten Reihenfolge startet. Dann aber den KRunner aufrufen (oder den Anwendungs-Starter) und plasmashell --replace als Kommando eingeben. Damit startet man die Shell neu. Theoretisch kann man das auch aus dem Terminal heraus machen, dann "hängt" die Sitzung aber im Terminal mitsamt der Fehlerausgabe, etc. Es funktioniert nicht bei jedem, aber bei mir klappt dieser Workaround. Bei mir ist übrigens durchs Downgrade die Compositor-Einstellung verloren gegangen, evtl. noch an diese in den Einstellungen denken (Anzeige und Monitor → Compositor), damit die Effekte und Schatten funktionieren.

Update 25.09. 15:00 Uhr: es gibt einen ersten MR für einen Fix. Wir können gespannt bleiben.

Update 30.09. 20:00 Uhr: es gibt einen Upstream Fix im Qt Framework.

Update 01.10. 12:00 Uhr: hier noch der dazugehörige Bugreport. Den Fix wird es wohl mit Qt 5.15.2 geben.

Update 01.01. 16:30 Uhr: mithilfe dieses Patches ist schon mit Qt 5.15.1 ein Fix möglich. Unter Arch ist mit qt5-base 5.15.1-2 die Problematik gefixt. Ein genereller Fix wird mit Qt 5.15.2 veröffentlicht. Damit ist der Fall erledigt.

18. September 2020

Wie Mozilla offiziell bekannt gegeben hat, werden sowohl der Filesharing-Dienst Firefox Send als auch die Notiz-Funktion Notes by Firefox im Rahmen der internen Umstrukturierung von Mozilla nicht länger fortgeführt.

Firefox Send

Firefox Send war ein Filesharing-Dienst, den Mozilla im März 2019 offiziell gestartet hat. Die Nutzung von Firefox Send war kostenlos und erfolgte durch eine Ende-zu-Ende-Verschlüsselung sicher. Durch die Festlegung einer Maximal-Dauer sowie einer Maximal-Anzahl an Downloads löschten sich die Dateien nach kurzer Zeit wieder von selbst vom Mozilla-Server.

Bereits Anfang Juli hatte Mozilla Firefox Send offline genommen. Der Grund war, dass Firefox Send zunehmend dazu verwendet worden sei, „Nutzlasten für alle Arten von Cyberkriminalität zu speichern, von Lösegeld- bis hin zu Finanzkriminalität und von Banking-Trojanern bis hin zu Spyware, die gegen Menschenrechtsaktivisten eingesetzt wird“, wie ZDNet.de berichtete.

Ursprünglich sollte es sich dabei nur um eine temporäre Auszeit handeln, während Mozilla im Hintergrund an Verbesserungen arbeitet, um Firefox Send in verbesserter Form neu ins Rennen zu schicken. Dazwischen kam aber COVID-19 und die daraus resultierenden finanziellen Folgen für Mozilla sowie die angekündigte Umstrukturierung, welche die Kündigung von 250 Mitarbeitern einschließt.

Im Zuge der stattfindenden Umstrukturierung wurde nun beschlossen, Firefox Send aus Kostengründen nicht wieder online zu schalten. Die Website von Firefox Send leitet bereits auf die reguläre Mozilla-Website um.

Notes by Firefox

Notes by Firefox ist eine Browser-Erweiterung für den Desktop-Firefox sowie eine App für Android, welche es dem Nutzer erlaubt, Notizen anzulegen und diese zwischen verschiedenen Geräten zu synchronisieren.

Es dürfte die wenigsten Nutzer überraschen, dass jetzt auch für Notes by Firefox das offizielle Ende kommt, immerhin gab es nun auch schon seit 1 1/2 Jahren kein Update mehr. Mozilla wird Notes by Firefox mit dem 1. November dieses Jahres einstellen.

Nutzer, welche die Erweiterung für den Desktop-Firefox installiert haben, können diese auch über den 1. November hinaus nutzen. Es wird jedoch keinerlei Aktualisierungen mehr geben, was auch mögliche Sicherheits-Updates einschließt. Zur Neuinstallation wird Notes by Firefox ab dem 1. November nicht länger zur Verfügung stehen. Auch die Synchronsiation der Notizen wird mit dem 1. November stoppen. Bestehende Notizen können über die Erweiterung bereits exportiert werden. Mozilla wird in Kürze noch ein Update veröffentlichen, welches auf das bevorstehende Ende hinweist und womit alle Notizen mit einem Mal exportiert werden können.

Für die Android-App hat Mozilla bereits gestern ein Update veröffentlicht, welches einen entsprechenden Hinweis in der App einblendet. Notes by Firefox für Android wird ab dem 1. November gar nicht mehr funktionieren.

Der Beitrag Mozilla stellt Firefox Send und Notes by Firefox ein erschien zuerst auf soeren-hentzschel.at.

15. September 2020

Einer der bekanntesten Nachfolger von yacc, GNU Bison, hilft ab Version 3.7 bei Schwierigkeiten in der Parser-Grammatik mit konkreten Gegenbeispielen.

Es gibt in der Informatik extrem spannende Gebiete, auf die wir täglich zurückgreifen, aber mit denen die Wenigsten direkt zu tun haben. Trotzdem ist es sehr kurzweilig, einen kleinen Einblick in diese Welt zu erhalten. Eines dieser Gebiete ermöglicht es, Informationen strukturiert und menschenleserlich darzustellen: es geht um (formale) Grammatiken. Grammatiken sind die Grundlagen für Sprachen und definieren, wie z. B. eine Rechenaufgabe, eine Konfigurationsdatei oder ein Quellcode aussehen dürfen. Während in einer Grammatik also definiert wird, wie etwas korrekt aussieht, ist das Pendant dazu der Parser, der eine Eingabe einliest, entscheiden kann, ob diese ein gültiger "Satz" in der Grammatik ist und anschließend zur Weiterverarbeitung vorbereitet. Diese Kombination aus Sprache und Parser ist im Grunde eine Schnittstelle zwischen Mensch und Maschine. Sie ermöglichte eine der entscheidendsten Produktivitätssteigerungen, da hierauf praktisch alle Programmiersprachen basieren und selbst einfachste Anwendungen wie Rechenaufgaben mit Hilfe von Grammatiken implementiert werden.

Nun sind Grammatiken ein gut erforschtes Gebiet: die Linguistik hat viel Forschung in den 1960er-Jahren reingesteckt und die Informatik hat diese automatisiert. Seit vielen Jahrzehnten gibt es sog. Parsergeneratoren, in die man einen Bauplan, die Grammatik, eingibt und welche dann einen fertigen Parser auswerfen. yacc war einer der bekanntesten Parsergeneratoren und wurde auf den meisten Systemen bereits von GNU Bison abgelöst. GNU Bison ist vor einigen Wochen in Version 3.7 erschienen und bietet eine interessante Möglichkeit, um Grammatiken zu debuggen. Ja, Grammatiken können „Bugs“ enthalten und ihr könnt euch vorstellen, dass es nicht ganz leicht ist, eine Lösung zu finden, wenn C++-Code oder eine JSON-Eingabe auf einmal nicht eingelesen werden können, weil der Parser XY einen Fehler hat.

Um es einfach zu halten, werde ich das kurz anhand des „Hello worlds“ der Parser, dem Taschenrechner, demonstrieren.

Eine Bison-Grammatik sieht in etwa so aus:

%{
#include <stdio.h>
int main(void);
int yylex(void);
void yyerror(char const *);
%}

%token ZAHL
%token ZEILENENDE

%%

start:
  %empty
| start berechnung
;

berechnung:
  strichrechnung ZEILENENDE { printf("= %d\n", $1);}
| ZEILENENDE /* ignore */
;


strichrechnung:
  punktrechnung
| strichrechnung '+' punktrechnung { $$ = $1 + $3; }
| strichrechnung '-' punktrechnung { $$ = $1 - $3; }
;

punktrechnung:
  ZAHL
| strichrechnung '*' ZAHL { $$ = $1 * $3; }
;

%%

int main(void)
{
        yyparse();
}

void yyerror(char const *s)
{
        fprintf(stderr, "Error: %s\n", s);
}

Den Lexer, der die Eingabe vorverarbeitet und entscheidet, was nun eine "ZAHL" ist, lasse ich der Einfachheit mal raus.

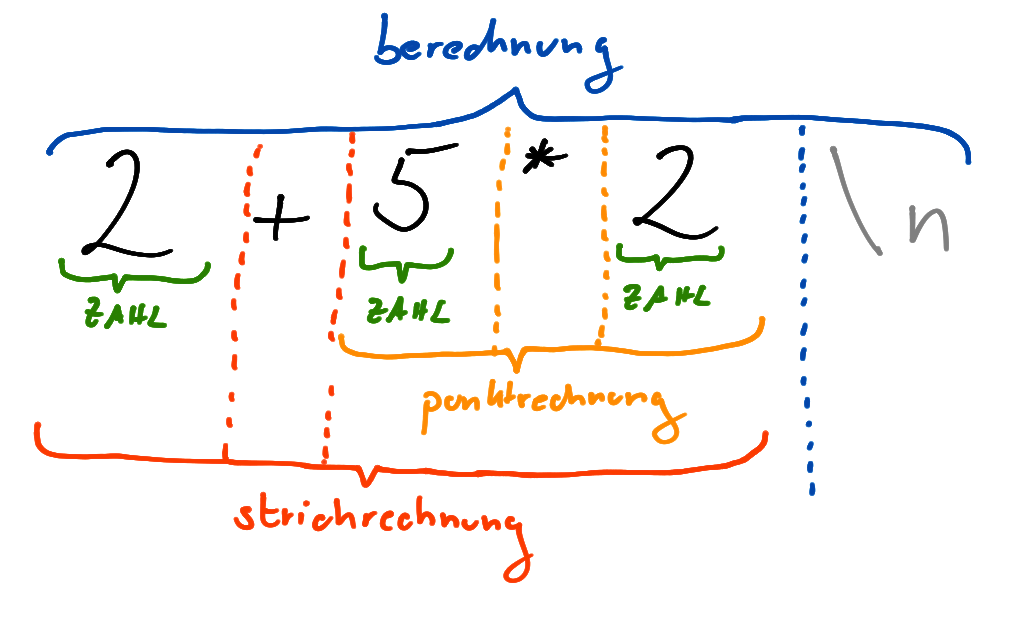
Interessant ist der Teil in der Mitte, da wird einerseits definiert, wie ein gültiger „Satz“ in unserer „Sprache der Rechenaufgaben (ohne Division)“ aussieht und daneben festgelegt, wie diese verarbeitet werden. So eine Bison-Grammatikdatei vermischt zwar ein wenig Syntax und Semantik, aber man will ja auch fertig werden. Die kleingeschriebenen Beizeichner heißen "Nichtterminale", sind ähnlich wie Variablen und können ausgetauscht werden. Die großgeschriebenen Bezeichner heißen "Terminale" und sind in unserem Beispiel Zahlen sowie das EOL/Enter. Eine Eingabe wäre also 2 + 5 * 2 <ENTER> bzw. 2 + 5 * 2 \n, da \n das Zeichen ist, was bei einem Enter entsteht. (Unter Linux zumindest) Das sieht visualisiert folgendermaßen aus:

Grammatik am Beispiel

Wir sehen also, dass Grammatiken nebenbei auch die Punkt- vor Strichregel implementieren. Und das ist im Grunde auch das Hauptarbeitsfeld, wenn man an Parsern baut. Und eine große Fehlerquelle. Findet ihr den Fehler in der obigen Grammatik?

Bison meckert jedenfalls über 6 Reduzier/Reduzier-Konflikte, kann also bei bestimmten Eingaben nicht entscheiden, wie die Eingabe interpretiert werden soll. Bisher musste man selber die Grammatik mit Hilfe des zugrundeliegenden Automaten debuggen, aber nun kann Bison selber konkrete Beispiele liefern, an welchen Stellen nicht entschieden werden kann.

Diese Funktion lässt sich mit der Option -Wcounterexamples aufrufen und liefert für obige Grammatik:

parse.y: warning: reduce/reduce conflict on tokens '+', '-', '*' [-Wcounterexamples]
  Example: strichrechnung '+' punktrechnung • '*' ZAHL
  First reduce derivation
    strichrechnung
    ↳ strichrechnung '+' punktrechnung
                         ↳ strichrechnung    '*' ZAHL
                           ↳ punktrechnung •
  Example: strichrechnung '+' punktrechnung • '*' ZAHL
  Second reduce derivation
    strichrechnung
    ↳ punktrechnung
      ↳ strichrechnung                       '*' ZAHL
        ↳ strichrechnung '+' punktrechnung •
parse.y: warning: reduce/reduce conflict on tokens '+', '-', '*' [-Wcounterexamples]
  Example: strichrechnung '-' punktrechnung • '*' ZAHL
  First reduce derivation
    strichrechnung
    ↳ strichrechnung '-' punktrechnung
                         ↳ strichrechnung    '*' ZAHL
                           ↳ punktrechnung •
  Example: strichrechnung '-' punktrechnung • '*' ZAHL
  Second reduce derivation
    strichrechnung
    ↳ punktrechnung
      ↳ strichrechnung                       '*' ZAHL
        ↳ strichrechnung '-' punktrechnung •

Mit geschultem Blick wird das Problem deutlich: die Operatorrangfolge, das "Punkt vor Strich", ist nicht korrekt implementiert. Bison kann also nicht entscheiden, ob "2 + 5 * 2 " nun 12 oder 20 ergeben soll, weil es entweder als (2 + 5) * 2 oder 2 + (5 * 2) interpretiert werden kann. Die Lösung sieht ohne weiteres Hintergrundwissen wie aus der Luft gegriffen aus, wäre aber, die Punktrechnung zu definieren als:

punktrechnung:
  ZAHL
| punktrechnung '*' ZAHL { $$ = $1 * $3; }
;

So kann die Grammatik eindeutig "interpretiert", also geparst werden und der Taschenrechner funktioniert.

Ihr könnt ja in den Kommentaren mal schreiben, ob euch das Thema interessiert und ob ich in weiteren Blogartikeln Aspekte und Grundlagen aus der Welt der Sprachen und Grammatiken aufbereiten soll. ;-)

Die MZLA Technologies Corporation hat mit der Verteilung des automatischen Updates von Thunderbird 68 auf Thunderbird 78 begonnen.

Vor gut zwei Monaten ist Thunderbird 78 erschienen. Thunderbird 78 bringt gegenüber Thunderbird 68 zahlreiche Neuerungen.

Automatische Updates von Thunderbird 68 auf Thunderbird 78 wurden bisher jedoch noch keine verteilt. Wer Thunderbird 78 nutzen wollte, musste also die neue Version von Hand über die alte Version installieren. In der Zwischenzeit hat die MZLA Technologies Corporation mehrere weitere Updates verteilt und nun damit begonnen, bestehende Installationen von Thunderbird 68 auf Thunderbird 78 zu aktualisieren.

Der Beitrag Update von Thunderbird 68 auf Thunderbird 78 wird verteilt erschien zuerst auf soeren-hentzschel.at.

12. September 2020

Vor kurzem habe ich mein kleines Heimnetzwerk erweitert und natürlich kam ich wieder mal bei der Frage an "Wie misst man jetzt eigentlich die Netzwerkgeschwindigkeit?". Klar kann man Daten über verschiedenste Protokolle übers Netzwerk schicken und hoffen, dass dabei halbwegs reale Zahlen herauskommen, aber in der Regel klappt das nicht so ganz.

Für so gut wie jede Plattform gibt es mittlerweile das Tool iperf3, was das eingangs erwähnte Problem elegant löst. Die Benutzung ist denkbar einfach, man startet hierzu iperf3 zuerst als Server auf dem Gerät was die Anfragen beantworten soll:

$ iperf3 -s

Anschließend ist ein Test in Senderichtung vom Client aus wie folgt durchführbar:

$ iperf3 -c 

Will man die Geschwindigkeit in Empfangsrichtung testen geht dies mittels des Parameters -R:

$ iperf3 -R -c 

Der Test dauert jeweils 10 Sekunden, danach bekommt man das Ergebnis zusammengefasst. Ich empfehle sowohl die Sende- als auch Empfangsrichtung zu testen, zumindest wenn es um eine kabellose Übertragung geht, da man hier stark unterschiedliche Werte bekommen kann.

Vor kurzem habe ich mein kleines Heimnetzwerk erweitert und natürlich kam ich wieder mal bei der Frage an "Wie misst man jetzt eigentlich die Netzwerkgeschwindigkeit?". Klar kann man Daten über verschiedenste Protokolle übers Netzwerk schicken und hoffen, dass dabei halbwegs reale Zahlen herauskommen, aber in der Regel klappt das nicht so ganz.

Für so gut wie jede Plattform gibt es mittlerweile das Tool iperf3, was das eingangs erwähnte Problem elegant löst. Die Benutzung ist denkbar einfach, man startet hierzu iperf3 zuerst als Server auf dem Gerät was die Anfragen beantworten soll:

$ iperf3 -s

Anschließend ist ein Test in Senderichtung vom Client aus wie folgt durchführbar:

$ iperf3 -c <serveradresse>

Will man die Geschwindigkeit in Empfangsrichtung testen geht dies mittels des Parameters -R:

$ iperf3 -R -c <serveradresse>

Der Test dauert jeweils 10 Sekunden, danach bekommt man das Ergebnis zusammengefasst. Ich empfehle sowohl die Sende- als auch Empfangsrichtung zu testen, zumindest wenn es um eine kabellose Übertragung geht, da man hier stark unterschiedliche Werte bekommen kann.

In Version Thunderbird 78.2 haben die Entwickler nun die lang erwartete integrierte OpenPGP Funktion freigeschaltet (siehe: OpenPGP in Thunderbird 78 - Der Weg ist noch weit). Die Funktionsweise ist nun weitestgehend gewährleistet, aber es fehlt noch viel Feinschliff.

Die OpenPGP Funktion ist nun standardmäßig aktiviert. Dies bedeutet man kann in direkt nach dem Erststart und der Konteneinrichtung in den Konteneinstellungen die Verschlüsselung aktivieren. Ein Gang in about:config entfällt nun.

Die Einstellungen nennen sich schlicht Ende-zu-Ende Verschlüsselung und bieten sowohl die Optionen für OpenPGP, als auch für S/MIME.

Wie man auf dem Screenshot sehen kann fehlt zumindest in meiner Installation über das Ubuntu Edge Snap noch einiges an Lokalisierungsarbeit. Über Add Key lässt je nach Bedarf ein bestehender Schlüssel importieren oder ein neuere generieren.

Bei einem neu generierten Schlüssel sind die Voreinstellungen halbwegs sinnvoll gewählt. Ob man ein Ablaufdatum in 3 Jahren haben möchte muss jeder für sich selbst entscheiden. Es spricht aus Gründen der Sicherheit einiges dafür, aber die schwierige Distribution der öffentlichen Schlüssel verhindert andererseits eine uneingeschränkte Empfehlung.

Verwalten lassen sich die Schlüssel wie gehabt im Schlüsselmanager, der noch sein altes Aussehen hat.

Die Suche nach öffentlichen Schlüssel auf dem einem Schlüsselserver funktioniert im Gegensatz zur vorherigen Version nun.

Beim Verfassen einer Nachricht zeigt ein kleiner Text und ein Symbol und rechts nun die aktivierte Verschlüsselung.

Insgesamt funktioniert OpenPGP in Thunderbird nun leidlich stabil, aber es fehlt noch viel Feinschliff. Wie auch beim Firefox stehen alte Designelemente wie der Schlüsselmanager mehr oder weniger unpassend neben neuen Elementen wie den Einstellungen. Beim Verfassen neuer Nachrichten fehlt zudem eine eindeutig und optisch starke Warnung bzw. Bestätigung ob die Nachricht nun verschlüsselt oder ungesichert raus geht.


Bilder:

Einleitungs- und Beitragsbild von mohamed Hassan via Pixabay

"

Open Source bot mal ein komplett freies alternatives Ökosystem. Dieses Versprechen kann die Gemeinschaft immer weniger bedienen. Kern des immer größer werdenden Problems sind: Mobile, Smart Home und intelligente Assistenzsysteme.

In vielen Artikeln bemängle ich beiläufig die Defizite im Open Source Ökosystem. Gemeint mit "Open Source" sind in diesem Kontext die Entwickler- und Anwendercommunity, sowie die wenigen Firmen rund um freie Software und die von ihnen (maßgeblich) geschaffenen Produkte. Es geht nicht um freie Kerne wie bei Android oder IoT, eingebettet in ein proprietäres undurchdringbarens Dickicht, denn dann wäre macOS auch Open Source.

Grundsätzlich darf an natürlich fragen warum Defizite in manchen Bereichen überhaupt ein Problem sein sollen. Open Source und proprietäre Produkte harmonieren schließlich leidlich miteinander. Meiner Erfahrung nach verfolgen viele eingefleischte Open Source Nutzer allerdings einen ganzheitlichen Ansatz und möchten proprietäre Produkte so weit wie möglich aus ihrem Umfeld verbannen. Wenn in immer mehr Lebensbereichen nur die Wahl zwischen Verzicht und proprietären Produkten besteht könnte man dazu übergehen gleich auch die letzten Open Source Refugien zu eliminieren.

Defizite und Perspektiven

Smartphones

Android war wie schleichendes Gift! Als Apple 2007 mit dem iPhone die Handy-Welt umkrempelte das Smartphone aus der Business-Ecke holte gab es durchaus verschiedene vielversprechende Ansätze. Die ganze Welt startete quasi bei Null. Alte Ansätze wie Symbian oder Black Berry OS entwerteten sich binnen weniger Monate. Der Markt war offen für neue Player und davon gab es einige. Man erinnere an MeeGo oder PalmOS. Diese scheiterten natürlich nicht allesamt an Android sondern hatten viele weitere Begrenzungen Probleme und Fehlentscheidungen.

Linux am Desktop zeigt jedoch wie genügsam die Community sein kann. Man benötigt nicht jede App, man braucht keine 50% Marktanteil. Die Basis war da, nur sammelten sich die interessierten Open Source Entwickler im Android-Ökosystem. Da war ja irgendwie Open Source und irgendwie Linux. Dort arbeiten sie nun um die Android Restriktionen herum und versuchen krampfhaft den zunehmend proprietären Kurs von Google zu kompensieren. Von einer transparenten und offenen Mitwirkung am Entwicklungsprozess mal ganz zu schweigen. Es erinnert an OpenOffice.org und Oracle. Nur ist die Android-Community zu zerfasert und unorganisiert um den Sprung zu wagen, den damals die Office-Entwickler machten. Der Versuch von Cyanogen scheiterte kläglich, nachdem man sich einem anderen IT-Großkonzern an den Hals geschmissen hatten.

Den Mobile-Zug hat man vollständig verpasst. Ubuntu Touch und Meego sind kaum mehr als Experimentalstudien und kommen trotz des leidenschaftlichen Einsatzes der wenigen Entwickler kaum vom Fleck. Purisms Librem ist vor allem ein Beispiel für ausgezeichnete PR-Arbeit und wie verzweifelt die Community inzwischen ist.

Tablets

Tablets waren mal große Smartphones und mit diesem Konzept wurden viele Millionen Geräte verkauft. Die Absatzzahlen gehen nun aber schon länger zurück und die Firmen reagieren mit einer zunehmenden Professionalisierung der Geräte. Ein Microsoft Surface oder das iPad Pro richten sich nicht an den Sofa-Surfer. Die zugedachten Tätigkeiten werden auch immer weiter ins Produktivitätsumfeld geschoben und mit alternativen Eingabemethoden wie dem Pencil versehen.

Das ist erst einmal für Open Source eine Chance. Auf einer Surface Hardware läuft prinzipiell auch Linux. Während manche Desktops wie die GNOME Shell das Spagat zwischen Tastatur und Maus, sowie einer Finger- und Gestenbedienung ganz passabel meistern, gilt dies für viel Software im Produktivbereich - man denke nur an LibreOffice - überhaupt nicht.

Ganz abgefahren ist der Zug hier aber noch nicht. Das ist schon mal ein Unterschied zu Smartphones.

Smarte Assistenten

Smart Assistenten sind das Megathema der Gegenwart. Amazon, Apple, Google - alle spielen sie mit. Sonderlich smart sind diese Lösungen eigentlich immer noch nicht. Selbst die Produkte der Marktführer sind - um im Begriffsschema zu bleiben - ziemlich "dumm". Die Tendenz ist aber eindeutig. Waren sie ursprünglich nur in Smartphones und Autos, finden sie sich nun in Lautsprechern und weiteren Produkten. Sie sind Teil der Zukunft.

Am Beispiel der smarten Assistenten zeigt sich ein Problem in der Open Source Entwicklung. Geldmangel und Organisationsmangel. Einen smarten Assistent entwickelt kein Entwickler nebenbei in seiner Freizeit, hier reicht auch keine kleine Entwicklergruppe. Solche Organisationsformen sind aber Nukleus fast alles Open Source Projekte - bis hin zum Linux Kernel. Diese Lücke füllte zumindest ansatzweise eines der wenigen echten Open Source Unternehmen - Mozilla - mit Common Voice und Deep Speech. Zwei Projekte in den Kinderschuhen aber mit Perspektive. Jedenfalls hatten sie diese bis Mozilla aus Geldnot vor kurzem den Stecker zog. Unklar sind die Auswirkungen auf die einzige wirkliche freie AI Mycroft.

Zukunftsträchtige Unterfangen hängen oft von einigen Firmen ab, wenn diese sich zurückziehwen war es das. Das ist auf dem Desktop mit Red Hat so, am Browser mit Mozilla und eben auch bei exotischeren Projekten wie Spracherkennung. Ironie: Auch hier hängt es letztlich an Google. Nun sagt man immer, dass kein Parasit den Wirt zerfrisst von dem er lebt - aber auch das bleibt abzuwarten.

Smart Home

Smarte Assistenten und ein smartes Zuhause sind zwei Seiten der gleichen Medaille bzw. greifen oft ineinander. Genau wie bei den Assistenten spielt nahezu jede infrage kommende Firma mit. Neben Startups sind das auch etablierte Marken wie - das zwischenzeitlich ausgegliederte - Philips Hue oder gar IKEA. Als Schaltzentralen etablieren sich zunehmend Sachen wie Apples HomeKit oder Googles Home-Lösung. Die proprietären Anbieter versuchen mit zweifelhaften Maßnahmen ihre Standards für allgemeingültig zu erklären.

Open Source hat hier openHAB zu bieten. Das viel mehr als nichts, aber wie so oft ist die Einarbeitungszeit immens. Die Berichte zeigen die Möglichkeiten, aber auch den Arbeitsaufwand. Die damit gesteuerten Endgeräte sind allerdings nahezu immer proprietär. Trotzdem ist hier noch ein wenig Potenzial für die zukünftige Entwicklung enthalten.

Vernetzte Geräte

Vernetzte Geräte sind irgendwie Teil des Smart Home, aber ich möchte sie hier dennoch separat ansprechen. Ein verbreitetes Beispiel sind kabellose Multiroom-Lautsprecher. Bekannte Marken sind hier SONOS, BOSE und Teufel. Was eint sie alle? Es sind letztlich proprietäre Systeme und man ist für den langfristigen Betrieb auf den guten Willen der Hersteller angewiesen. Wenn man auf diese Systeme verzichten möchte bleiben einem ggf. noch die integrierten Protokolle von Apple- allerdings ist auch dieses nicht offen.

Bei Open Source sind hier leider nur Leerstellen. Miracast ist weitestgehend Theorie geblieben. Multiroom bedeutet bei Open Source immer noch ein zentrales raspberry oder einen Server und dann Kabel ziehen.

Viele weitere Leerstellen

Die Liste lässt sich beliebig fortführen, weil immer mehr Bereiche unsere Lebens digitalisiert werden. Offene und transparente Steuersysteme für Autos und andere Mobilitätssysteme? Smart-TVs und Smartwatches? Die ganzen aufkommenden Dienste wie das Mobile Payment? Streaming? Alles nicht mal angedacht, von Dienstleistern ohne DRM und freien Protokollen nichts in Sicht

Fazit

Abseits des eigentlichen Desktops und Notebooks spielt Open Source höchstens die Rolle eines Zulieferers. Man darf halt den Firmen den Kernel oder ein paar Protokolle liefern, aber freie Systeme gibt es nicht. Ausgehend von einem fiktiven Startdatum 2007 - also kurz bevor Smartphones das Licht der Welt erblickten, aber Linux schon quasi massentauglich war - ist das ein erheblicher Rückschritt aus Anwendersicht.

Dafür gibt es viele Gründe und man sollte sich hüten Schuldige zu benennen. Entwickler arbeiten woran sie Spaß haben und die zunehmende Komplexität des digitalen Umfelds als Herausforderung für die Open Source Entwicklungsstrukturen haben schon vor Jahren Entwickler erkannt.

Nur sollte man meiner Meinung nach die vielschichtigen Defizite und wenigen Perspektiven im Blick behalten, wenn mal wieder irgendeine Initiative Open Source auf irgendwelchen Staats-Desktops fordert oder Schulen mit Linux versorgen möchte. Angesichts der Gesamtentwicklung erscheint mir das gelegentlich als Zombiedebatte.


Bilder:
Einleitungsbild und Beitragsbild von von Pixaline via pixabay

"

Heute möchte ich ein Kommandozeilen-Werkzeug vorstellen, dass ich seit einigen Monaten zur Zeiterfassung benutze. Bis Ubuntu 18.04 habe ich immer das Hamster-Applet verwendet, was wirklich toll war. Unter 20.04 funktioniert dieses Applet aber nicht mehr. Deshalb habe ich mich nach Alternativen umgeschaut und bin bei Watson gelandet – ein Werkzeug für die Kommandozeile. Die Zeiterfassung mit Watson ist anders als mit dem Hamster-Applet, doch schauen wir uns zuerst die Installation an.

Installation

Watson ist ein Python-Programm und man installiert es am besten mit dem Python Paket Manager pip:

$ sudo apt install python3-pip
$ sudo pip3 install td-watson

Damit die Bedienung einfacher wird, installieren wir noch die Bash-Autovervollständigung:

$ cd /etc/bash_completion.d/
$ wget https://raw.githubusercontent.com/TailorDev/Watson/master/watson.completion

Damit die Autovervollständigung auch funktioniert, muss man den Terminal neu starten.

Bedienung von Watson

Es gibt eine Reihe von Befehlen, die einem helfen, die Zeit zu erfassen, Zusammenfassungen anzuzeigen oder einzelne Projekte zu verwalten. Die wichtigsten stelle ich kurz vor:

Zeit eines Projekts erfassen

$ watson start Projektname +Schlagwort1 +Schlagwort2

Im Hintergrund wird damit ein „Frame“ oder Zeitabschnitt angelegt für das Projekt inkl. der beiden Schlagwörter. Mit Schlagwörtern kann man z.B. die Zeit für Unterprojekte / Teilaufgaben erfassen.

Mit

$ watson stop

beende ich die Zeiterfassung für das Projekt wieder.

Andere hilfreiche Befehle

Manchmal kommt es vor, dass ich vergesse „watson stop“ auszuführen. Mit

$ watson edit

kann ich den letzten Zeitabschnitt / „Frame“ bearbeiten:

watson edit

Um das letzte Projekt neu zu starten, reicht ein:

$ watson restart

Um mir eine Zusammenfassung meiner Projekte anzuschauen, kann ich folgende Befehle benutzen:

$ watson report // letzte 7 Tage
$ watson report -m // aktueller Monat
$ watson report -f "2020-08-01" -t "2020-08-31" // Report vom 01.08. bis 31.08.2020
$ watson aggregate // zeigt eine Zusammenfassung der letzten 7 Tage an (für jeden Tag einzeln)

Weitere nützliche Befehle erhält man mit

$ watson --help
$ watson Befehl --help

Fazit

Watson ist ein wirklich einfach zu bedienendes Kommandozeilen-Werkzeug. Die Zeiterfassung mit Watson gefällt mir wirklich gut, obwohl ich das Hamster-Applet auch sehr praktisch fand. Es gibt einzelne Community-Projekte rund um Watson, die die Arbeit damit noch einmal verbessern, z.B. ein GUI und andere nette Kleinigkeiten. Ein Feature, welches meiner Meinung nach noch fehlt, ist die Möglichkeit Notizen zu einem Zeitabschnitt hinzuzufügen. Es gibt dafür einen Pull Request, aber er ist noch nicht im Projekt.

Welches Tool benutzt du zur Zeiterfassung?

Der Beitrag Zeiterfassung mit Watson erschien zuerst auf zefanjas.

11. September 2020

Die MZLA Technologies Corporation hat mit Thunderbird 78.2.2 ein Update für seinen Open Source E-Mail-Client veröffentlicht.

Thunderbird 78.2.2 steht ab sofort zum Download bereit. Ein automatisches Update von Thunderbird 68 und älter steht weiterhin nicht zur Verfügung, dieses wird erst in den kommenden Wochen verteilt werden. Nutzer von Thunderbird 78.x erhalten die neue Version jedoch bereits als Update.

Neuerungen von Thunderbird 78.2.2

Mit dem Update hat das Team der MZLA Technologies Corporation die Möglichkeit implementiert, beim Verfassen von E-Mails die Reihenfolge der Empfänger per Drag and Drop zu verschieben.

Die Twitter-Unterstützung in der Chat-Komponente von Thunderbird ist auf Grund einer API-Änderung seitens Twitter schon länger defekt. Mit Thunderbird 78.2.2 wurde Twitter nun vollständig aus der Anwendung entfernt.

Ansonsten ist Thunderbird 78.2.2 wieder randvoll gefüllt mit Fehlerkorrekturen und Verbesserungen unter der Haube, welche sich im Detail in den Release Notes (engl.) nachlesen lassen.

Der Beitrag Thunderbird 78.2.2 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

10. September 2020

Ich muss zur Zeit relativ häufig Images von microSD-Karten anfertigen, welche hauptsächlich mit dem ext4-Dateisystem formatiert sind. Jetzt ist das insgesamt ein eher wenig angenehmer Prozess, weil das Anfertigen eines Images Zeit und Speicherplatz kostet.

Das Zeitproblem bekommt man inden Griff, indem man sich ordentliche microSD-Karten kauft (für Consumer sind SanDisk ganz nett, haben sich auch im Industriebereich für uns bewährt), sowie entsprechende microSD-Kartenleser (auch hier gibt es von SanDisk eine schöne, kleine, portable Lösung: SanDisk MobileMate USB 3.0 Reader (Datenraten >90MB/s sind damit problemlos möglich, für Sie getestet).

Das Speicherplatzproblem bekommt man halbwegs in den Griff, wenn man die Images komprimiert. Ich setze dazu gerne zstd ein, welches sich nach einigen Tests als das effizienteste Tool herausgestellt hat (sowohl was Zeitbedarf als auch Kompressionsrate anbelangt).

Leider beinhalten Images von microSD-Karten oft Daten an Stellen, wo gar keine mehr sein sollten. SSDs „trimmen“ diese Bereiche i.d.R. automatisch, microSD-Karten können das hingegen nicht.

Wer allerdings auf ein Dateisystem der ext-Familie setzt hat Glück - denn genau dafür gibt es zerofree. Kurzgesagt überschreibt zerofree effizient die Bereiche, die Nullen enthalten sollten aber es nicht tun. Dadurch fallen die anschließend angefertigten Images deutlich kleiner aus, als es sonst der Fall wäre. Die Benutzung ist denkbar einfach:

# zerofree -v /dev/sdXY

Danach kann man ein Image anfertigen, auf die genauen Parameter gehe ich hierbei explizit nicht ein:

# dd if=/dev/sdX bs=1M status=none | zstd -z -v --adapt -o microSD.img.zst

Das war's.

9. September 2020

Standardmäßig wird Firefox bereits mit drei Themes ausgeliefert. Ab Firefox 81 kommt noch ein viertes Farbschema dazu: Mit Firefox Alpenglow bringt Mozilla Farbe in den Browser.

Neben dem vorwiegend hellen Theme mit Akzent als Standard-Design und einem komplett hellen sowie einem komplett dunklen Theme wird Firefox standardmäßig bereits mit drei Design-Optionen ausgeliefert. Mit Firefox 81 kommt noch eine vierte Wahlmöglichkeit dazu.

Das neue Theme hört auf den Namen Firefox Alpenglow und ist besonders farbenfroh. Damit hebt es sich ganz bewusst von den drei anderen Themes ab. Dem Nutzer dürfte durch diesen Kontrast zu den anderen Firefox-Themes vor allem die vielfältigen Möglichkeiten der farblichen Anpassung vermittelt werden. Nutzer können über addons.mozilla.org aus tausenden weiteren Themes wählen.

Firefox Alpenglow

Firefox Alpenglow

Firefox Alpenglow kann über die Add-ons-Verwaltung, den Bildschirm zum Anpassen der Browseroberfläche oder für neue Nutzer direkt bei der Ersteinrichtung von Firefox ausgewählt werden.

Firefox Alpenglow

Firefox Alpenglow

Firefox 81 erscheint nach aktueller Planung am 22. September 2020.

Der Beitrag Firefox 81 wird mit zusätzlichem Farbschema ausgeliefert erschien zuerst auf soeren-hentzschel.at.

7. September 2020

Firefox ermöglicht bereits das Hinzufügen von Suchmaschinen entweder über den OpenSearch-Standard, falls von der jeweiligen Website implementiert, via WebExtension oder Unternehmensrichtlinie. Ab Firefox 82 können Nutzer ganz einfach selbst beliebige Suchmaschinen zu Firefox hinzufügen.

Für das Hinzufügen benutzerdefinierter Suchmaschinen in Firefox gibt es mehrere Optionen.

Das eine sind OpenSearch-Suchmaschinen. Voraussetzung hierfür ist, dass die jeweilige Website dies auch anbietet. Die Installation erfolgt ganz einfach über die Adressleiste.

Das andere sind Suchmaschinen-Erweiterungen. Diese sind nicht von der Implementierung auf einer Website abhängig, müssen jedoch auch erst von jemandem erstellt und dann vom Benutzer installiert werden.

Schließlich gibt es noch die Option der Unternehmensrichtlinien. Dieser Weg steht allerdings ausschließlich in Firefox ESR zur Verfügung.

Firefox 82 besitzt einen weiteren Weg, welcher es dem Nutzer ermöglicht, beliebige Suchmaschinen hinzuzufügen. Dazu gibt es in den Such-Einstellungen eine neue Schaltfläche zum Hinzufügen einer Suchmaschine.

Suchmaschine hinzufügen in Firefox 82

In dem sich dann öffnenden Dialog sind drei Felder auszufüllen: Der Name der Suchmaschine, den der Benutzer frei wählen kann, die Such-URL, wobei %s als Platzhalter für den Suchtext verwendet wird, sowie optional ein Alias, welches in die Adressleiste eingegeben werden kann, um den Suchmodus zu aktivieren.

Suchmaschine hinzufügen in Firefox 82

Wurde die Suchmaschine auf diese Weise angelegt, steht diese bei den Suchmaschinen-Icons in der Adressleiste zur Verfügung. Wurde ein Alias vergeben, reicht die Eingabe dieses Kürzels, gefolgt von der Leertaste, und Firefox aktiviert den Suchmodus, der die Suchmaschine in der Adressleiste besonders hervorhebt. Hierbei kommt der zuvor vergebene Name der Suchmaschine zum Einsatz.

Suchmaschine hinzufügen in Firefox 82

In der Nightly-Version von Firefox 82 muss die Neuerung derzeit noch über about:config aktiviert werden. Dazu muss browser.urlbar.update2.engineAliasRefresh als neuer Boolean-Schalter mit dem Wert true angelegt werden.

Firefox 82 erscheint nach aktueller Planung am 20. Oktober 2020.

Der Beitrag Firefox 82 ermöglicht Hinzufügen beliebiger Suchmaschinen erschien zuerst auf soeren-hentzschel.at.

Tracking ist im Internet allgegenwärtig (siehe: Internet - Schutz vor Tracking und Anonymität). Wirklich davor geschützt ist man eigentlich nur mit dem Tor Browser aber bisher konnte man mit einigen Maßnahmen seinen digitalen Fußabdruck verringern. Eine dieser Maßnahmen wird seit einiger Zeit mehr und mehr zu einem Problem.

Ein wichtiger Bestandteil einer Anti-Tracking-Konfiguration war bisher immer die Behandlung von Cookies. Diese eigentlich mal technisch sinnvolle Sache ist inzwischen weitgehend pervertiert und dient zur Überwachung der Nutzer. Zwar wird das so genannte Fingerprinting immer wichtiger (siehe: Fingerabdruck des Browsers), aber Cookies bleiben ein zentraler Bestandteil im Tracking-Baukasten.

Deshalb habe ich immer mit Lösungen gearbeitet die Cookies automatisch löschen. Lediglich wenige definierte Ausnahmen durften bleiben. Entweder am Session-Ende oder erkannte Tracking-Cookies per Zeitintervall (z. B. im Safari mit "Cookie": macOS und Datenschutz Teil II: Automatische Cookie-Löschung). Seit den letzten Urteilen werden die Banner mit Cookie-Abfragen jedoch immer penetranter und erfordern beim Session-Start zusätzliche Klicks.

Bei einigen Banner wie z. B. auf ZEIT ONLINE oder SPIEGEL ist das nicht weiter tragisch, da man nur die Option zwischen "Bezahlen" oder "Überwach mich" hat. Andere Seiten bieten hier difizile Einstellungsmöglichkeiten um dem Tracking jenseits des technisch notwendigen Minimums zu entkommen. Das macht aber natürlich nur Sinn, wenn man die Cookies nach dem Session-Ende nicht sofort löscht, weil man ansonsten täglich mehrfach die Konfigurationen vornehmen muss.

Die Frage angesichts des immer weiter um sich greifenden "Einwilligungs-Wahnsinns" ist nun halt, ob die obligatorische Cookie-Löschung am Session-Ende nicht sogar kontraproduktiv sei könnte und man mit einer differenzierten Konfiguration auf den Seiten mit entsprechender Möglichkeit nicht mehr erreicht.

Davon unbenommen sind natürlich andere Maßnahmen wie z.B. ein wirksamer Inhalte-/Werbungsblocker.

Wie seht ihr das?


Bilder:
Einleitungsbild und Beitragsbild von von 200 Degrees via pixabay

"

3. September 2020

1. September 2020

Mozilla hat mit Firefox 80.0.1 für Windows, Apple macOS und Linux ein Fehlerbehebungs-Update veröffentlicht.

Download Mozilla Firefox für Microsoft Windows, Apple macOS und Linux

Mozilla hat Firefox 80.0.1 veröffentlicht und behebt damit mehrere Probleme der Versionsreihe 80, darunter ein Performance-Problem in Zusammenhang mit neuen Zwischenzertifikaten.

Außerdem wurde ein Problem mit der WebExtension-API für Downloads behoben, welches dafür sorgte, dass Cookies in Download-Anfragen fehlten, weswegen bestimmte Downloads fehlschlagen konnten.

Behoben wurde auch ein potentieller Darstellungsfehler auf Seiten, welche WebGL nutzen, sowie eine mögliche Absturzursache in Zusammenhang mit GPU-Resets.

Schließlich wurde noch ein Problem mit dem Zoom via Tastatur für Nutzer mit einem japanischen Tastaturlayout behoben.

Der Beitrag Mozilla veröffentlicht Firefox 80.0.1 erschien zuerst auf soeren-hentzschel.at.

Wer unter Linux den Logical Volume Manager, kurz LVM nutzt, gewinnt an Flexibilität was die Nutzung von Festplatten und die entsprechende Aufteilung von Partionen und Ähnlichem angeht. So kann zum Beispiel eine Partion einfach auf eine zweite Festplatte erweitert werden. Dazu muss im ersten Schritt ein neues Physical Volume erstellt werden:

pvcreate /dev/sdb

Tritt dabei eine Fehlermeldung auf:

WARNING: Device for PV KT64tM-fAuf-zWoj-WuGQ-c5na-Z4x1-5NNwHq not found or rejected by a filter.
Can’t initialize physical volume „/dev/sdb“ of volume group „vgubuntu“ without -ff
/dev/sdb: physical volume not initialized.

muss die entsprechende Festplatte vorher mittels des wipefs-Kommandos bereinigt werden:

wipefs -a /dev/sdb

Anschließend kann das Physical Volume erstellt werden. Im nächsten Schritt muss die entsprechende Volume Group um das neue Physical Volume erweitert werden:

vgextend elementary-vg /dev/sdb

Ist die Volume Group nicht bekannt, so können die vorhandenen Volume Groups über das Kommando:

vgs

eingesehen werden. Nachdem dies geschehen ist, solle der Speicherplatz der entsprechenden Partion zugewiesen und das Dateisystem erweitert werden:

lvm lvextend -l +100%FREE /dev/elementary-vg/root
resize2fs -p /dev/mapper/elementary--vg-root

Damit wurde die zweite Festplatte erfolgreich eingebunden und das Dateisystem entsprechend erweitert.

30. August 2020

Vergangene Woche äußerte Sarah Novotny Kritik an den Arbeitswerkzeugen des Linux Kernels. Die Kommunikation über die Kernel Mailingliste und die seit Jahrzehnten etablierten Arbeitsmethoden seien aus der Zeit gefallen und eine unverhältnismäßige Einstiegshürde für Neueinsteiger. Damit legt Novotny den Finger in eine offene Wunde.

Projekte im Linux-Umfeld - vor allem solche mit einer Fokussierung auf den Desktop - drohen massiv zu überaltern. Am Beispiel des Kernels wird dies nun wenigstens in Teilen offen diskutiert. Teile der zentralen Subsystem-Maintainer gehören zur "ersten Garde" und arbeiten seit Jahrzehnten mit. Die Zahl an jüngeren Entwicklern nimmt seit Jahren ab. Nun gibt es für die großen Open Source Projekte keine exakten Zahlen, aber keines der Projekte im Linux Desktop Umfeld kann sich gerade mit vielen Neuzugängen brüsten. Verfolgt man die einschlägigen Planeten und Mailinglisten liest man immer wieder die gleichen Namen.

Ob hierfür nun die Kommunikationslösungen verantwortlich sind, ob der Umgangston unerträglich ist oder es vielleicht an etwas ganz anderem liegt kann natürlich niemand mit Sicherheit sagen. Mir persönlich kamen Mailinglisten schon 2007 antiquiert vor und auch Projekte wie KDE haben hier kürzlich Modernisierungsversuche unternommen. Die Krisensymptome nehmen insgesamt aber deutlich zu. Man erinnere an den Rücktritt von Michael Stapelberg wegen der veralteten Werkzeuge in Debian oder auch die Debian Projektleiterwahl 2019, bei der ein Kandidat mit einer Modernisierungsagenda antrat und scheiterte.

Die Beteiligung erfahrener Entwickler ist nun wirklich nichts schlechtes aber ihr Übergewicht kann zu einer gewissen Bräsigkeit führen und letztlich zu einem Anschlussverlust an größere Entwicklungen. Zuletzt hat sich hierdurch die FSF und das GNU-Projekt fast unmöglich gemacht. Liest man sich die Kommentare unter dem eingangs verlinkten Heise Artikel durch kann man diese Grundeinstellung sehr anschaulich nachvollziehen. Es dominieren Verachtung für aktuelle Entwicklungen und jüngere Menschen und deren Ansichten. Zwar sind die Mehrheit der Kommentatoren dort keine Entwickler aber meiner Erfahrung nach laufen Diskussion auf den Mailinglisten oft in einem ähnlichen Duktus ab.

Die Community sollte so etwas ernst nehmen. Linux war lange Zeit eine stete Aufwärtsgeschichte. Es stand für eine vollkommen andere Art der Softwareentwicklung und -nutzung, als dies die proprietären Hersteller vorgaben. Die Ideen und Idealer freier Software boten Anknüpfungspunkte für weiterführende Ideen zu freiem Wissen und einer Abkehr von einem allzu einschränkendem Urheberrecht. Diese Ideen sind heute aktueller denn je, aber ausgerechnet die Linux Community hat in Teilen den Anschluss an technische Trends verloren. Thematisiert man diese Probleme, kommen immer jene, die auf die Bedeutung des Linux Kernels für IoT, Server und Android verweisen. Das ist aber bestenfalls ein Rumpflinux, ohne Community, ohne Partizipation und letztlich eine Sackgasse. Linux wäre in diesem Sinne nur noch ein Produkt für die Hersteller proprietärer Geräte.


Bilder:
Einleitungs- und Beitragsbild von tuku via pixabay

"

Die MZLA Technologies Corporation hat mit Thunderbird 78.2.1 ein planmäßiges Update für seinen Open Source E-Mail-Client veröffentlicht. Mit der neuen Version wird die Verschlüsselung von E-Mails via OpenPGP unterstützt.

Thunderbird 78.2.1 steht ab sofort zum Download bereit. Ein automatisches Update von Thunderbird 68 und älter steht weiterhin nicht zur Verfügung, dieses wird erst in den kommenden Wochen verteilt werden. Nutzer von Thunderbird 78.x erhalten die neue Version jedoch bereits als Update.

Thunderbird unterstützt OpenPGP

Mit dem Update hat das Team der MZLA Technologies Corporation noch einmal letzten Feinschliff an der OpenPGP-Unterstützung betrieben und diese nun standardmäßig aktiviert. Die Verwendung einer Erweiterung wie Enigmail ist daher nicht länger notwendig, um seine E-Mails zwischen Empfängern Ende-zu-Ende zu verschlüsseln.

Für Nutzer von Enigmail werden alle Einstellungen automatisch migriert, wenn das Update erfolgt.

OpenPGP in Thunderbird 78

Der Beitrag Thunderbird 78.2.1 mit OpenPGP-Unterstützung veröffentlicht erschien zuerst auf soeren-hentzschel.at.