staging.inyokaproject.org

18. März 2019

Diesmal stand ich vor einem interessanten Problem: Die hinterlegten Verbindungen unter “Mit Server verbinden” wollte ich löschen. Allerdings gibt es in diesem Fenster keine Möglichkeit diese “History” zu leeren. Aber es ist ja nicht Linux wenn es nicht doch eine Lösung geben würde….

/home/username/.config/nautilus/servers

in dieser Datei im XML Format sind die benutzten Verbindungen hinterlegt. Und hier kann man diese auch entfernen.
In dieser Datei müssen die Werte zwischen (bzw. inklusiv) Bookmark entfernt werden.

17. März 2019

Nach Wochen der Bastelei habe ich es endlich geschafft ein Snap-Paket für die AusweisApp2 zu bauen, welches auch mit dem Confinement funktioniert. Die einzige Einschränkung, die aktuell noch existiert, ist das man nach der Installation einmalig die benötigten Interfaces des Snap-Pakets „connecten“ muss. Danach funktioniert die Anwendung ohne weitere Einschränkungen:

sudo snap install ausweisapp2-ce
sudo snap connect ausweisapp2-ce:raw-usb :raw-usb
sudo snap connect ausweisapp2-ce:hardware-observe :hardware-observe
sudo snap connect ausweisapp2-ce:network-manager :network-manager
sudo snap connect ausweisapp2-ce:network-observe :network-observe
sudo systemctl restart snap.ausweisapp2-ce.pcscd.service

Letzterer Befehl ist notwendig, damit der Card-Daemon noch vor dem ersten Start der Anwendung die passenden Rechte besitzt.

Ich habe im Snap-Store einen Request zum Auto-Connecten gestellt. Falls dieser genehmigt wird, kann man die Anwendung auch ohne explizites „connecten“ installieren.

Update

Ich habe gestern (05.04.19) die Freigabe des Stores für das automatische „connecten“ der benötigten Interfaces erhalten. Es reicht jetzt also aus das Snap zu installieren. Es sind keine weiteren Schritte notwendig.

Am Wochenende fanden die 21. Chemnitzer Linux-Tage an der TU Chemnitz statt. Für mich war es nun schon der dritte Besuch nach 2015 und 2018.

Zu Vorträgen aus dem Vortragsprogramm kann ich nicht sehr viel sagen. Wie es sich bei mir mittlerweile Standard ist, bin ich mehr in Gesprächen mit den zahlreichen Freunden „verwickelt“ gewesen und weniger in Vorträgen gewesen. Am Samstag habe ich es immerhin geschafft den einzigen Vortrag für mich an diesem Tag zu besuchen: „Python asyncio in der Praxis“.

Am Sonntag habe ich es ebenfalls nur zu einem Talk geschafft. Allerdings war ich da der Speaker und musste (viel) reden. Wie auch bei der letzten OpenRheinRuhr erzählte ich über „How To Commit: Nachvollziehbare Git-Historien“. In diesem Vortrag erzählte ich über die Art und Weise wie Commits auszusehen haben sollten, damit diese auch im Nachhinein nachvollziehbar sind. Der Talk war auch als Diskussion ausgerichtet, weshalb einige Informationen und Wortmeldungen entsprechend nicht in den „Folien“ enthalten sind. Eine Aufzeichnung des Talks gab es hingegen und wird hoffentlich zeitnah auf der Webseite vom CLT veröffentlicht.

Die Folien finden sich auf meinem Speakerdeck Account oder eingebettet (via JavaScript) auch hier:

Das Thema des Talks wird für mich im Umgang mit Git immer wichtiger, sodass es in der kommenden zweiten Auflage meines Git Buches ein eigenständiges Kapitel gewidmet bekommen wird.

Unabhängig von meinem Talk lohnt sich ein Besuch der Chemnitzer Linux-Tage auch weiterhin. Eine schöne nette Community die sich da trifft. Für mich auch die Open-Source-Konferenz, die ich am besten mag. Und das liegt nicht nur an der guten Organisation… :)

Auch in diesem Jahr haben die Chemnitzer Linux Tage wieder in das zentrale Hörsaal- und Seminar-Gebäude der Technischen Universität Chemnitz eingeladen. Das Motto lautete diesmal „Natürlich intelligent“ und so wundert es nicht, dass sich eine Vielzahl von Vorträgen den Themen Künstliche Intelligenz und Maschinelles Lernen widmeten. Darüber hinaus gab es interessante Vorträge zu den Themen IoT, Container, Sicherheit, Einsteiger, Datacenter, usw. Alles in allem wurde wie im letzten Jahr ein vielseitiges Programm geboten.

Anreise am Freitag

Wie im vergangenen Jahr bin ich auch dieses Mal wieder mit dem Auto angereist, denn 4,5 Std. Fahrt sind mir doch lieber, als 6-7 Std. Reisezeit mit der Bahn (laut Fahrplan). So kam ich Freitag Abend rechtzeitig an, um das Social Event im Turmbrauhaus zu besuchen. Es war ein schöner Abend mit freundlichen Menschen bei interessanten Gesprächen und natürlich 1..n Hopfenkaltschalen.

Ich habe mich gefreut, bekannte Gesichter von ubuntuusers.de wieder zu sehen und neue Gesichter hinter einigen Blogs kennen zu lernen, die ich regelmäßig lese.

Auftakt am Samstag

Punkt 7.00 Uhr Frühstück im Hotel, 8.00 Uhr Einlass bei den Chemnitzer Linux Tagen und ab 9.00 Uhr öffnete die Ausstellerfläche und das Vortragsprogramm startete. Ich selbst lernte an diesem Tag etwas über Präsentationen mit XeLaTeX (Beamer), NVMe, NVMe over Fabrics und erfuhr die ein und andere Neuigkeit im persönlichen Gespräch mit alten und neuen Bekannten. Mein persönliches Zitat des Tages stammt von D. Menzel und lautet: „NVMe over Fabric ist wie iSCSI auf Steroiden.“ :-D

Ausklang am Sonntag

Auch der Sonntag begann früh mit dem Frühstück um 7.00 Uhr. Um 9.00 Uhr war bereits alles für die Abreise gepackt und die Chemnitzer Linux Tage öffneten ihre Halle für den zweiten Veranstaltungstag. Dieser startete für mich mit einigen Standbesuchen, um Informationen über mögliche Schulungsangebote und Tipps für den Einsatz von Ansible einzusammeln, bevor es dann um 10.00 Uhr in den ersten Vortrag, den Samba Status Report, ging.

Laut dem zuvor genannten Vortrag tritt SMB2 an, um NFS zu töten. Naja, ich persönlich glaube, Totgesagte leben länger.

Der Storage Track endete mit einem Vortrag von Kai Wagner, welcher über die Neuigkeiten im neuen Ceph Release Nautilus berichtete. In hohem Tempo führte Kai durch eine Folienschlacht, um keine coole Neuerung zu vergessen. Bei den vielen lang erwarteten Neuerung kann ich gut verstehen, dass Kai keine davon unterschlagen wollte. Dennoch hat Kai hier einen tollen und unterhaltsamen Talk gehalten. Danke hierfür.

Der letzte Vortag für mich an diesem Tage war Open Source und Medizin, welcher einen interessanten Einblick in die Forschung mit Medizindaten bot.

Im Anschluss wurden die Vorträge noch in kleinen Gruppen diskutiert, bevor ich mich verabschiedete, um mich auf den Heimweg zu machen.

Es war mal wieder ein schönes Wochenende und tolle Chemnitzer Linux Tage 2019. Bis zum nächsten Jahr.

Wurde in einem Wiki, das auf die Software MediaWiki setzt, das Passwort von einem Benutzer vergessen? Wenn das Wiki korrekt konfiguriert wurde und der Nutzer eine E-Mail-Adresse hinterlegt hat, kein Problem, da es hierfür die Funktion "Passwort vergessen" gibt, die unter dem Login-Formular abgerufen werden kann.

Ist ein solches Zurücksetzen allerdings nicht möglich, da z.B. der Mailtransport nicht aktiviert ist, muss das Passwort anderweitig erneuert werden. Wer sich schon auf den Weg in die Datenbank (Tabelle "user", Spalte "user_password", i.d.R. BLOB) macht, kann aufatmen, denn bei Zugriff auf die PHP-CLI schafft eines der MediaWiki-Wartungsscripte Abhilfe.

changePassword.php im maintenance-Verzeichnis ist für Passwort-Änderungen auf Kommandozeilenebene zuständig. Benötigt wird Zugriff auf das interne Verzeichnis, am besten per SSH. Dann per

cd /pfad/zur/installation/maintenance

in das maintenance-Verzeichnis der MW-Installation schalten und dort

php changePassword.php --user=Benutzername --password=NeuesPasswort

ausführen.

Die Optionsparameter müssen durch den zurückzusetzenden MW-Benutzernamen sowie das neu zu vergebende Passwort ersetzt werden. Das neue Passwort sollte grundlegende Passwortstandards (mehr als 8 Zeichen, etc.) erfüllen, damit eine Änderung möglich ist.

Tipp: alternativ bietet sich auch das gleiche Kommando mit vorangestelltem sudo an:

sudo -u www-data php changePassword.php --user=Benutzername --password=NeuesPasswort

Hier wird das Kommando unter dem Benutzer www-data, dem unter Debian für Apache2 üblichen Benutzer, ausgeführt. Bei anderen Paketen, Konfigurationen oder Distributionen muss dieser Wert natürlich enstprechend des dort eingestellten Webserver-Benutzers geändert werden.

13. März 2019

KDE verfolgt bereits seit vielen Jahren mobile Pläne, herausgekommen ist dabei bisher nicht viel. Außer einem Framework namens Kirigami mit dem man klassische Desktopapplikationen mobil-tauglich machen möchte und damit das Benutzererlebnis auf dem Desktop ruiniert.

Wenn ich für irgendwas auf dem Linux Desktop Enthusiasmus entwickeln konnte, dann war dies immer KDE. Dank KDE bin ich erst richtig warm mit Linux geworden und habe dem Desktop über zwei große Versionssprünge die Treue gehalten. Zuletzt zunehmend frustriert (siehe auch die Serie ab: KDE Plasma 5 Teil I: Käfer und Schuldzuweisungen) aber ein Wechsel kam nie in Betracht. Seit einigen Jahren nutze ich nun auf dem Desktop macOS (siehe: Ein Apfel in der Antarktis - Teilwechsel auf macOS) und die virtuellen Maschinen laufen mit MATE.

KDE Plasma hat sich bei einigen Migrationsvorhaben allerdings immer wieder als sehr guter Desktop für Windows-Umsteiger erwiesen (siehe: openSUSE Leap im wartungsfreien Einsatz). Daher komme ich damit immer noch in Berührung. Nun habe ich mir mal den Entwicklungsstand von openSUSE Leap 15.1 angeguckt, da im Sommer einige Systeme darauf migriert werden sollen.

Vielleicht muss man erst mal Abstand zu einem Desktop gewinnen um den Entwicklern laut zuzurufen: Lasst das!

KDE Plasma ist nach wie vor ein toller Desktop und inzwischen auch hinreichend ressourcenschonend (siehe auch: Mythen V: KDE benötigt viele Ressourcen) und stabil. Das gilt sogar für notorische Problemkinder wie die Kontact-Suite, die hier im Produktiveinsatz keine nennenswerten Probleme macht. Von wirklichen Softwareperlen wie Dolphin mal ganz zu schweigen - der vielleicht beste Dateimanager unter allen Betriebssystemen und Desktopumgebungen, die ich je verwenden durfte.

Die Kirigami-basierten Anwendungen wie Discover und die neuen Systemeinstellungen sind jedoch furchtbar. Die Benutzerführung ist ganz offensichtlich an mobile Endgeräte angepasst, die Programme sind reaktionslangsam, es gibt Grafikfehler und bei Fenstervergrößerung/-verkleinerungen hängt alles.

Natürlich ist die Hardware nicht die Neueste. Ein Haswell i5 mit entsprechender Onboard-Grafikkarte liegt bei Linux aber im gesunden Mittelfeld, das hat die Ubuntu-Telemetriedatenerhebung ergeben.

Es ist schön, dass die Entwickler von Plasma Mobile am Ball bleiben. Die Zukunft liegt im mobilen Bereich und Linux darf sie nicht komplett verschlafen. Es gibt aber nach all den Jahren noch kein einziges mobiles Gerät auf dem Plasma Mobile läuft und keine Distribution einer lauffähigen Umgebung. Das wird sich vielleicht mit dem Librem 5 ändern, aber das kommt auch erst nächstes Jahr - frühestens!

Hört also auf die Desktopanwender in Geiselhaft für ein mobiles Unterfangen zu nehmen, das noch gar nicht existiert. Macht nicht das Desktoperlebnis für eure mobilen Träume kaputt. Sonst habt ihr am Ende nichts, keinen Desktop und kein mobiles System.


Bilder:

Einleitungs- und Beitragsbild von ElisaRiva via pixabay

"

12. März 2019

Mozillas kostenloser und die Privatsphäre respektierender Filesharing-Dienst Firefox Send hat die Betaphase verlassen und erweitert nun offiziell das Produkt-Portfolio von Mozilla. Eine Android-App folgt in Kürze.

Bereits 2017 hat Mozilla Firefox Send im Rahmen von Test Pilot gestartet. Mit dem heutigen Tag verlässt Firefox Send die Beta-Phase und startet mit neuem Logo und neuer Webseite durch.

Dateien privat und sicher teilen mit Firefox Send

Firefox Send

Firefox Send ist ein Dienst zum temporären Bereitstellen von Dateien. Die Nutzung von Firefox Send ist kostenlos und erfolgt durch eine Ende-zu-Ende-Verschlüsselung sicher. Durch die Festlegung einer Maximal-Dauer sowie einer Maximal-Anzahl an Downloads löschen sich die Dateien nach kurzer Zeit wieder von selbst vom Mozilla-Server.

Firefox Send

Dauerhaft können Dateien nicht bei Firefox Send gelagert werden, denn es ist ein wesentlicher Teil des Konzeptes von Firefox Send, dass sich Nutzer nicht sorgen müssen, dass ihre Dateien für immer in der Cloud herumliegen. Optional kann außerdem auch noch ein Passwort festgelegt werden, ohne welches die Dateien nicht heruntergeladen werden können.

Firefox Send

Firefox Send

Firefox Send funktioniert mit jedem Browser, also nicht nur mit Firefox. Ein Firefox Account ist weder für das Hochladen noch für das Herunterladen von Dateien notwendig. Firefox Send ist also für jeden geeignet.

Firefox Send

Ohne Anmeldung liegt das Limit bei 1 GB pro Datei. Wer sich mit seinem Firefox Account anmeldet, kann Dateien mit einer Größe von bis zu 2,5 GB hochladen.

Firefox Send

Die Verwendung des Firefox Accounts hat außerdem den Vorteil, dass hochgeladene Dateien von jedem Gerät aus verwaltet werden können und nicht nur von dem Gerät, von welchem sie hochgeladen worden sind.

Firefox Send

Außerdem ist ein höheres Limit als ein Download, nämlich bis zu 100 Downloads, sowie eine Maximal-Dauer von sieben Tagen nur mit Firefox Account möglich.

Zusätzlich soll schon bald, voraussichtlich sogar noch in dieser Woche, die erste Beta-Version einer Android-App von Firefox Send veröffentlicht werden.

Der Beitrag Mozillas Filesharing-Dienst Firefox Send startet offiziell erschien zuerst auf soeren-hentzschel.at.

9. März 2019

Auf meinen Desktop PC habe ich eine (ungewollte) Aktuallisierung von Thunderbird bekommen und musste so erfahren das die neue Version nicht mehr mit einem alten Windows Exchange 2003 Server funktioniert. Alle Tricks die ich gefunden habe brachen nichts so das ich in den Updateeinstellungen die Aktuallisierungen deaktiviert habe, anschliessend Thunderbird deinstalliert und wieder neu eingespielt. Die Einstellungen blieben zum Glück erhalten.
Wird wohl Zeit den Exchange langsam in Rente zu schicken…

Aktive Festplatten benötigen Energie, erzeugen Wärme, lassen den Lüfter laufen, verbrauchen dadurch noch mehr Energie und das meist völlig sinnlos, weil sie die meiste Zeit sowieso nicht benötigt werden. Daher sollte man Festplatten nach Möglichkeit bei Nichtgebrauch in den Standby schicken.

In heutigen NAS-Systemen arbeiten oft 2 und mehr große HDDs. Proprietäre Lösungen wie Synology oder QNAP haben daher längst Standby-Lösungen integriert. Ein normales Linux-Betriebssystem lässt die Festplatten allerdings 24/7 rotieren und erzeugt dadurch sinnlosen Energiebedarf. Nicht benötigte Festplatten sollten daher abgeschaltet werden

Voraussetzung ist dass das eigentliche System nicht auf einer der Festplatten liegt, da diese dann beständig wieder aufgeweckt werden würde und die Festplatte dadurch unnötigen Belastungen ausgesetzt wäre. Je nach Hardware kann man das eigentliche System z. B. auf eine kleine SSD installieren oder auch auf einen USB 3-Stick, der immer angeschlossen ist.

Grundsätzlich kann Linux mittels hdparm Festplatten bei Nicht-gebrauch in den Standby-Modus schicken. Hierzu ist lediglich eine Anpassung der Konfigurationsdatei /etc/hdparm.conf notwendig. Leider haben viele Distributoren die Situation verschlimmbessert indem sie die hdparm.conf ignorieren oder mit Skripten umgehen. Ubuntu und openSUSE sind hier unrühmliche Beispiele.

Eine einfache Möglichkeit das Problem zu beheben besteht in der Nutzung von TLP. Eigentlich handelt es sich dabei um eine Lösung zum Energiesparen auf Notebooks (ursprünglich sogar nur Thinkpads). Es lässt sich aber auch hervorragend auf Server- und Desktopsystemen nutzen.

Die Installation erfolgt bei vielen Distributionen direkt aus den Paketquellen. Bei openSUSE beispielsweise via:

# zypper in tlp

Anschließend muss die Konfiguration angepasst werden. Dies geschieht über die Datei /etc/default/tlp.

Folgender Abschnitt ist dabei von Interesse:

# Disk devices; separate multiple devices with spaces (default: sda).
# Devices can be specified by disk ID also (lookup with: tlp diskid).
DISK_DEVICES="sda"

# Disk advanced power management level: 1..254, 255 (max saving, min, off).
# Levels 1..127 may spin down the disk; 255 allowable on most drives.
# Separate values for multiple disks with spaces. Use the special value 'keep'
# to keep the hardware default for the particular disk.
DISK_APM_LEVEL_ON_AC="128"
DISK_APM_LEVEL_ON_BAT="128"

# Hard disk spin down timeout:
#   0:        spin down disabled
#   1..240:   timeouts from 5s to 20min (in units of 5s)
#   241..251: timeouts from 30min to 5.5 hours (in units of 30min)
# See 'man hdparm' for details.
# Separate values for multiple disks with spaces. Use the special value 'keep'
# to keep the hardware default for the particular disk.
DISK_SPINDOWN_TIMEOUT_ON_AC="120"
DISK_SPINDOWN_TIMEOUT_ON_BAT="120"

Unter DISK_DEVICES legt man fest welche Festplatten betroffen sein sollten. Im obigen Beispiel lediglich sda. Man könnte hier aber auch mehre Festplatten mit Leerzeichen getrennt angegeben.

Im zweiten Abschnitt legt man den APM-Level fest. Bei mehr als einer angegebenen Festplatte müssen die Werte nun ebenfalls für jede Platte angegeben und mit Leerzeichen getrennt werden. Viele Distributionen nehmen hier 254, was aber ein Abschalten verhindert. Hier muss man ein bisschen experimentieren, da das Verhalten je nach Festplatten-Modell unterschiedlich sein kann. Bei 128 (was oft auch für Notebooks verwendet wird) habe ich bei meinen WD Red Modellen gute Erfahrungen gemacht.

Der dritte Abschnitte steuert die Zeit, nach der die Festplatte ohne Zugriffe abgeschaltet werden. Die im Beispiel aufgeführten 120 bedeutet 10 Minuten. Der Wert ist ebenfalls für jede Platte anzugeben.

Abschließend aktiviert und startet man den Dienst:

# systemctl enable tlp

# systemctl start tlp

Mittels des folgenden Kommandos kann man überprüfen ob die Festplatte wie gewünscht in den Standby geht.

# hdparm -C /dev/sda

Folgende Ausgabe erscheint wenn die Festplatte korrekt in den Standby geht:

/dev/sda:
 drive state is:  standby

Kommt hingegen folgende Ausgabe ist die Festplatte aktiv:

/dev/sda:
 drive state is:  active/id

Bilder:

Einleitungs- und Beitragsbild von FreePhotosART via pixabay

"

Es muss nicht immer gleich der Red Hat Sattelite Server sein, um einen lokalen Spiegelserver für die Installation von RPM-Paketen bereitzustellen.

Auf GitHub habe ich im Repository „Poor man’s RHEL mirror“ eine kleine Sammlung von Bash-Skripten zusammengestellt, mit denen sich ein Spiegelserver für RHEL-Repositories aufbauen lässt. Mit diesem können RHEL-Repositories, für welche man eine gültige Subskription besitzt, auf einen Host im lokalen Netzwerk synchronisiert und deren Pakete anderen RHEL-Servern im LAN zur Verfügung gestellt werden.

Neben der reinen Spiegelung können mit den auf GitHub bereitgestellten Skripten weitere lokale Stage-Repositories eingerichtet werden, mit denen sich die Verfügbarkeit von Paketen für einzelne Stages steuern lässt. Zusätzlich bietet das Projekt Skripte, um eigene YUM-Repositories zu erstellen, um zum Beispiel eigene Pakete darüber bereitstellen zu können. Des Weiteren wurde die Möglichkeit berücksichtigt, die Red Hat Errata Informationen in die lokalen RHEL-Repositories zu integrieren, um die --advisory Option für YUM auch auf Systemen nutzen zu können, die über keine eigene Verbindung zum Internet verfügen.

Warum ist dieses Projekt nützlich?

  • Es schont die eigene Internetverbindung, da Pakete nur einmal aus dem Internet heruntergeladen und anschließend im LAN zur Verfügung gestellt werden.
  • Es unterstützt bei der Erstellung eines YUM-Repositories zur Bereitstellung von RPM-Paketen.
  • Es unterstützt das Staging-Konzept, in dem es die Möglichkeit bietet, stage-spezifische Repositories bereitzustellen.
  • Es implementiert die Red Hat Errata Informationen in die gespiegelten RHEL-Repos, so dass diese von angebundenen Servern genutzt werden können, die über keine eigene Internetverbindung verfügen.
  • Es entstehen keine Zusatzkosten, da alle notwendigen Werkzeuge in den Repos einer RHEL-Standard-Subskription enthalten sind.

Wer kann dieses Projekt nutzen?

Das Projekt selbst steht unter der MIT-Lizenz und kann unter deren Bedingungen frei genutzt, modifiziert und weiter verteilt werden.

Für den Betrieb des Spiegelservers ist der Besitz einer gültigen RHEL-Subskription Voraussetzung. Denn es können nur jene Repos gespiegelt werden, für die eine gültige Subskription vorhanden ist. Auch alle an den Spiegelserver angeschlossenen Systeme müssen über eine entsprechende und gültige Subskription verfügen.

Bei Fragen zu Subskriptionen helfen die folgenden Seiten weiter:

Um mit diesem Projekt einen Spiegelserver aufsetzen und betreiben zu können, sind gewisse Kenntnisse erforderlich. Zu diesen zählen die Installation eine RHEL-Systems inkl. Registrierung, das Hinzufügen von Subskriptionen und die Installation von Paketen. Informationen hierzu bietet die Product Documentation for Red Hat Enterprise Linux 7.

Wie ist das GitHub-Repository zu diesem Projekt aufgebaut?

Das GitHub-Repository beinhaltet ein README, welches einen Überblick über das Projekt und eine Kurzbeschreibung der einzelnen Skripte in englischer Sprache beinhaltet. Im Master-Branch befindet sich die letzte stabile Version des Projekts. Weiterentwicklungen und Fehlerkorrekturen werden im Dev-Branch gepflegt und nach einer Testphase in den Master-Branch übernommen.

Sorgen, Nöte und Anträge sowie gefundene Fehler dürfen gern über die Issue-Funktion oder in den Kommentaren zu diesem Beitrag gemeldet werden.

An dieser Stelle folgt eine Beschreibung in deutscher Sprache, wie ein Spiegelserver mit diesem Projekt aufgebaut werden kann. Dabei handelt es sich um keine Schritt-für-Schritt-Anleitung und es werden grundlegende Kenntnisse über den Betrieb eines RHEL-Servers und die Installation sowie Konfiguration von Paketen vorausgesetzt.

Einrichtung eines Spiegelservers für arme Sysadmins

Um das Projekt nutzen zu können, benötigt man eine RHEL-Installation mit gültiger Subskription, auf welcher mindestens die folgenden Pakete installiert sein müssen:

  • reposync und createrepo, um RHEL-Repos synchronisieren und eigene Repos erstellen zu können
  • git zum Klonen des hier beschriebenen Projekts
  • Die Gruppe Basic Web Server oder einen anderen Webserver eurer Wahl, um die gespiegelten Repos über HTTP im LAN bereitstellen zu können

Zu Beginn sind die Dateien aus dem oben genannten GitHub-Repository in einem Verzeichnis auf dem lokalen Host bereitzustellen. Anschließend ist das Projekt zu konfigurieren. Die dazu notwendigen Schritte werden in den folgenden Abschnitten erläutert.

CONFIG.SAMPLE

Hierbei handelt es sich um die Hauptkonfigurationsdatei. Diese ist in CONFIG umzubenennen bzw. zu kopieren und zu editieren. In dieser Datei werden die Variablen gesetzt, die von den verschiedenen Shell-Skripten verwendet werden. Darunter sind z.B. Angaben, welche Repos gespiegelt werden und wo die Dateien gespeichert werden sollen.

Die Datei ist mit Kommentaren versehen und sollte weitgehend selbsterklärend sein (was für alle weiteren Dateien gilt).

create_yum_repo.sh

Dieses Skript kann genutzt werden, um ein eigenes YUM-Repository zu erstellen, über welches RPM-Pakete bereitgestellt werden können. Der Name des zu erstellenden Repos kann dem Skript als Parameter übergeben werden.

do_reposync.sh

Dies ist das Herzstück des Projekts. Es kümmert sich um die Spiegelung der RHEL-Repos. Die notwendigen Parameter werden in der Datei CONFIG konfiguriert.

Das Skript lädt nur die aktuellen Pakete aus den Repos herunter, löscht aus den Upstream-Repos entfernte Pakete jedoch nicht automatisch auf dem lokalen Host. Dies ist meinen persönlichen Anforderungen geschuldet. Es ist nicht ausgeschlossen, dass ich diese Parameter in Zukunft ebenfalls konfigurierbar gestalte.

Einen Überblick über den Speicherbedarf ausgewählter RHEL-Repos findet ihr hier: How much disk space do I need for reposync?

Um die heruntergeladenen Pakete im LAN zur Verfügung zu stellen, muss das BASEDIR (siehe CONFIG) über einen Webserver zugreifbar gemacht werden.

refresh_repo.sh

Werden einem Repo neue RPM-Dateien hinzugefügt, muss die Metadaten-Datenbank aktualisiert werden, damit Klienten die neuen Pakete auch finden können. Um diese Aktualisierung kümmert sich eben dieses Skript.

rsync_repo.sh

Mit diesem Skript lassen sich Repos auf dem lokalen System synchronisieren. Dabei werden die Dateien jedoch nicht 1:1 kopiert, sondern Hardlinks erstellt. Dies spart bei der Verwendung mehrerer Repos für unterschiedliche Stages Speicherplatz.

Neben dem kompletten Sync eines Repos ist es auch möglich, dem Skript eine Datei zu übergeben, welche die Namen der Pakete enthält, welche in ein weiteres Repo „transportiert“ werden sollen.

Wrapper-Scripts

In meiner Umgebung arbeiten wir mit bis zu vier verschiedenen Stages (E, I, Q und P). Für jede dieser Stages wird ein eigenes Stage-Repo des Upstream rhel-7-server-rpms erzeugt. Um diese Stage-Repos zu aktualisieren, werden die folgenden Skripte verwendet:

  • update_rhel-e-stage.sh
  • update_rhel-i-stage.sh
  • update_rhel-q-stage.sh
  • update_rhel-p-stage.sh

Jede Stage wird mit den Paketen aus der vorhergehenden aktualisiert. So ruft z.B. update_rhel-e-stage.sh das Skript rsync_repo.sh, um die Pakete aus dem lokalen Spiegel des Upstreams rhel-7-server-rpms zu importieren. update_rhel-i-stage.sh verwendet dementsprechend die rhel-e-stage als Quelle usw.

Diese Konfiguration ist für meinen Anwendungsfall optimiert. Die Verwendung der Skripte ist optional. Der Spiegelserver funktioniert auch ohne diese Wrapper-Scripts.

update_mirror_packages_and_erratas.sh

Dieses Skript aktualisiert die Pakete in den Repos des lokalen Spiegelservers inkl. der Red Hat Errata Informationen. Letztere ermöglichen es, die Erratas (RHSA, RHBA und RHEA) auch Systemen verfügbar zu machen, welche über keine Verbindung zum Internet verfügen.

Das Skript ist in der Standardeinstellung auf meinen Anwendungsfall optimiert und aktualisiert am Ende alle vorhandenen RHEL-Stage-Repos. Wer diese Funktion nicht benötigt, kann sie durch Auskommentieren der Zeilen 45 und 46 im Skript deaktivieren.

Anschließend kann ein Cronjob erstellt werden, welcher das Skript ausführt, um den Spiegelserver regelmäßig gemäß der eigenen Anforderungen zu aktualisieren.

Die gespiegelten Repos verfügbar machen

Hat man die Repos seiner Wahl gespiegelt, ergibt sich je nach Konfiguration eine Verzeichnisstruktur ähnlich der folgenden.

$ tree -L 2
.
├──  rhel-7-test-mirror
│   ├── rhel-7-server-extras-rpms
│   ├── rhel-7-server-optional-rpms
│   ├── rhel-7-server-rpms
│   ├── rhel-7-server-supplementary-rpms
│   ├── rhel-e-stage
│   ├── rhel-e-stage.repo
│   ├── rhel-i-stage
│   ├── rhel-p-stage
│   ├── rhel-q-stage
│   └── rhel-server-rhscl-7-rpms

Das Verzeichnis rhel-7-test-mirror aus obigen Beispiel enthält die gespiegelten Repos als Unterverzeichnisse. Dieses Verzeichnis sollte über einen Webserver zugreifbar gemacht werden, um die Pakete den Clients im lokalen Netzwerk verfügbar zu machen.

Im obigen Listing ist eine Datei namens rhel-e-stage.repo zu sehen. Dabei handelt es sich um eine Repo-Datei, welche heruntergeladen und im Verzeichnis /etc/yum.repos.d/ platziert werden kann, um wie in diesem Beispiel das Repo rhel-e-stage zu aktivieren.

Aufbau einer Repo-Datei

Das folgende Listing zeigt die kommentierte Repo-Datei aus dem vorstehenden Abschnitt. Sie kann als Muster für weitere eigene Repo-Dateien dienen.

[rhel-e-stage] # Repo ID
baseurl = http://example.com/rhel-7-test-mirror/rhel-e-stage/
gpgcheck = 1
gpgkey = file:///etc/pki/rpm-gpg/RPM-GPG-KEY-redhat-release
name = Repo for rhel-7-server-rpms (Test)

Fragen, Sorgen, Nöte und Anträge

Das Projekt und die enthaltene Software werden so wie sie sind unter der angegebenen Lizenz zur Verfügung gestellt.

Fragen, Sorgen, Nöte und Anträge können sowohl hier in den Kommentaren zum Artikel, als auch auf Github hinterlassen werden.

Ich hoffe, dass dieses Projekt euch (weiterhin) nützlich ist und freue mich über Rückmeldungen, wie es euch gefällt.

Vor ca. einem Jahr habe ich beschrieben, wie man mit einem Raspberry Pi und einem Feinstaubsensor die Luftqualität messen kann. Das Setup setzen wir so seit einigen Jahren bei uns in der Schule bzw. auch privat ein. Einen Nachteil hat dieses Projekt allerdings: es ist nicht mobil, sondern abhängig von einem WLAN-Netz bzw. einer Netzwerkverbindung. Wenn der Raspberry Pi und das Smartphone / ein Rechner nicht im gleichen Netz sind, kann man nicht auf die Messdaten zugreifen. Deshalb haben wir vor einiger Zeit den Raspberry Pi um einen kleinen Bildschirm ergänzt, sodass man die Werte direkt am Gerät ablesen kann. Wie man diesen Bildschirm für unser mobiles Feinstaubmessgerät einrichtet und welche zusätzlichen Konfigurationen notwendig sind, möchte ich in diesem Artikel kurz vorstellen.

Bildschirm für den Raspberry Pi einrichten

Auf Amazon oder AliExpress gibt es verschiedene Displays für den Raspberry Pi. Diese reichen von ePaper-Screens bis hin zu LCDs mit Touchfunktion. Wir haben uns für einen 3,5″ LCD mit Touch entschieden, welcher eine Auflösung von 320×480 Pixel hat (Modell MPI3501). Man kann diesen Bildschirm einfach auf die GPIO Pins stecken. Dazu kostet er gerade mal 10-15€. Schön ist auch, dass er mit 3,5″ genauso groß wie ein Raspberry Pi ist.

Wenn man den Bildschirm aufsteckt und den Raspberry Pi startet, bleibt der Bildschirm weiß. Man muss zuerst noch die passenden Treiber für das Display installieren. Dazu meldet man sich per SSH an und führt folgende Befehle aus:

$ rm -rf LCD-show
$ git clone https://github.com/goodtft/LCD-show.git
$ chmod -R 755 LCD-show
$ cd LCD-show/

Je nach Bildschirmmodell muss man nun den passenden Befehl ausführen um die Treiber zu installieren. In unserem Fall (für das Modell MPI3501):

$ sudo ./LCD35-show

Dieser Befehl installiert die entsprechenden Treiber und startet den Raspberry Pi anschließend neu.

Pixel-Desktop installieren und Autostart einrichten

Damit wir die Website mit den Messwerten direkt beim Start auf dem Bildschirm angezeigt bekommen sind noch einige Schritte notwendig. Zuerst muss man die Pixel-Desktopumgebung installieren (falls man bisher Raspian Lite verwendet hat) mit

$ sudo apt install raspberrypi-ui-mods

Dann fehlt noch der Chromium-Browser, um die Website anzuzeigen:

$ sudo apt install chromium-browser

Standardmäßig ist der Autologin für das Benutzer „pi“ nicht eingerichtet. Dies ist aber notwendig, damit die Messwerte direkt nach dem Start angezeigt werden können, ansonsten begrüßt einen nur der Anmeldebildschirm. Den Autologin kann man über das raspi-config Programm einrichten:

sudo raspi-config

Im Menü wählt man dann 3 Boot Options → B1 Desktop / CLI → B4 Desktop Autologin.

Zu guter Letzt fehlt noch die Einrichtung des Autostarts, damit Chromium nach dem Booten automatisch mit der AQI-Seite gestartet wird. Dazu legt man den Ordner /home/pi/.config/lxsession/LXDE-pi/ an:

$  mkdir -p /home/pi/config/lxsession/LXDE-pi/

Anschließend erstellt man in diesem Ordner die Datei autostart

$ nano /home/pi/.config/lxsession/LXDE-pi/autostart

und fügt diesen Inhalt ein:

#@unclutter
@xset s off
@xset -dpms
@xset s noblank

# Chromium im Vollbild beim Start öffnen
@chromium-browser --incognito --kiosk http://localhost

Möchte man noch den Mauszeiger ausblenden, muss man noch das Paket unclutter installieren und am Anfang der autostart das Kommentarzeichen entfernen:

$ sudo apt install unclutter

mobiler Feinstaubsensor

Da ich im letzten Jahr ein paar kleine Änderungen am Code vorgenommen habe, empfiehlt es sich das Skript und die Dateien der AQI-Website neu herunterzuladen (wie das geht, steht im Originalartikel).

Fazit

Durch das Display hat man nun ein mobiles Feinstaubmessgerät. Wir setzen sie an unserer Schule ein um z.B. die Qualität der Luft in den Klassenzimmern zu überprüfen oder um Vergleichsmessungen durchzuführen. Mit diesem Setup ist man nicht mehr auf eine Netzwerkverbindung oder WLAN angewiesen, sondern kann die kleine Messstation überall einsetzen – mit einer Powerbank sogar noch unabhängig vom Stromnetz.

2 Kommentare

Der Beitrag Wie man ein mobiles Feinstaubmessgerät bauen kann erschien zuerst auf .:zefanjas:..

8. März 2019

Wenn ein Kommando auf der Linux-Konsole mit vorangestellten sudo ausgeführt wird, wie z.B.

sudo apt install mc

wird das Kommando in Normalfall mit den Rechten und im Kontext des Nutzers root ausgeführt. Manchmal soll eine solche Operation jedoch mit einem anderen Nutzer durchgeführt werden. Dazu dient die sudo-Option -u:

sudo -u www-data crontab -e

Nach der Option muss der Nutzer angegeben werden, in dessen Kontext gewechselt werden soll. In diesem Beispiel würde die Crontab-Datei des Nutzers www-data geöffnet.

6. März 2019

In privaten Fenstern sind Erweiterungen ab Firefox 67 standardmäßig deaktiviert. Nutzer können aber alle – oder auch einzelne Erweiterungen – in privaten Fenstern aktivieren und erhalten so mehr Kontrolle als bisher.

Ab Firefox 67 werden private Fenster noch ein Stück privater, denn ab dann sind Erweiterungen in privaten Fenstern standardmäßig nicht länger aktiviert und können so nicht länger Aktivitäten ausführen, welche in Widerspruch mit dem Konzept privater Fenster stehen. Firefox weist nach dem Update beim ersten Start eines privaten Fensters in Form eines Dialogs darauf hin.

Firefox 67: Erweiterungen in privaten Fenstern

Dies betrifft jedoch lediglich neu installierte Erweiterungen. Damit sich Nutzer nicht über plötzlich nicht mehr funktionierende Erweiterungen wundern, erhalten alle bereits installierten Erweiterungen automatisch die Berechtigung, auch in privaten Fenstern aktiv zu sein. Für bestehende Nutzer ändert sich also erst einmal nichts, bis die nächste Erweiterung installiert wird.

Im Add-on Manager markiert Firefox sämtliche Erweiterungen, welche die Berechtigung erhalten haben, auch in privaten Fenstern aktiv zu sein. Oberhalb der Erweiterungen steht eine Erklärung mit Link auf eine Hilfe-Seite von Mozilla.

Firefox 67: Erweiterungen in privaten Fenstern

In der Detail-Ansicht des Add-on Managers kann für jedes Add-on individuell eingestellt werden, ob dieses in privaten Fenstern aktiv sein soll oder nicht.

Firefox 67: Erweiterungen in privaten Fenstern

Bisher waren Add-ons immer sowohl in regulären als auch in privaten Fenstern aktiv. Mit dieser neuen Option kann der Nutzer selbst entscheiden, bestimmte Erweiterungen auch in privaten Fenstern zu nutzen, andere jedoch nicht. Damit ist diese Neuerung ein Mehrgewinn für die Nutzer, ungeachtet dessen, wie man zur Standard-Einstellung steht, weil so jeder das bekommt, was er respektive sie will.

Der Beitrag Firefox 67: Nutzer entscheidet, welche Erweiterungen in privaten Fenstern aktiv sind erschien zuerst auf soeren-hentzschel.at.

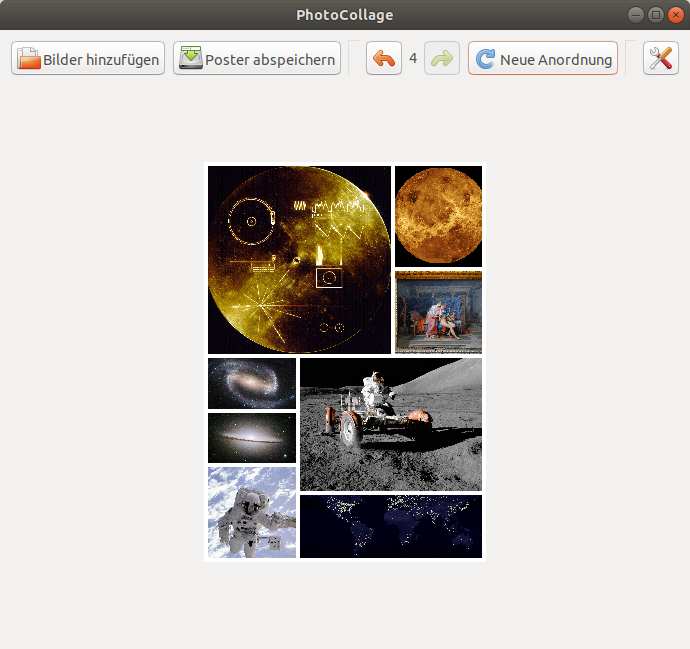
Um eine Fotocollage zu erstellen existieren viele Wege. So kann die Collage mit dem Bildbearbeitungsprogramm der Wahl, wie z.B. GIMP, erstellt werden. Mit zunehmender Anzahl von Fotos kann sich dieser Prozess allerdings in die Länge ziehen.

Eine mittels PhotoCollage erstellte Collage

Eine Alternative zu diesem manuellen Prozess kann die Anwendung PhotoCollage, welche über das Paket photocollage installiert werden kann, darstellen:

sudo apt install photocollage

Die Anwendung verfügt über ein simples Interface, in welchem die Bildgröße und die Farbe der Ränder eingestellt werden. Anschließend können die Bilder hinzugefügt werden und unterschiedliche Anordnungen ausprobiert werden. Anschließend kann die Collage exportiert werden. Im Gegensatz zu vielen Webdiensten, welche ähnliches leisten, ist PhotoCollage nicht auf bestimmte Größen beschränkt. Damit sind auch Collagen im Format DIN-A2 und größer möglich. Der Quelltext des Projektes ist auf GitHub zu finden. Lizenziert ist PhotoCollage unter der GPL in der Version 2 und damit freie Software.

5. März 2019

Firefox Lockbox ist ein Passwort-Manager von Mozilla für Apple iOS, der in Kürze außerdem für Android sowie für den Desktop-Firefox erscheinen wird. Dieser Artikel gibt eine Vorschau, was von Lockbox für den Desktop-Firefox zu erwarten ist.

Im Juli 2018 hat Mozilla die erste Version von Firefox Lockbox für Apple iOS veröffentlicht, einen Passwort-Manager mit 256-Bit-Verschlüsselung und Synchronisation, der seit dem auch schon einige Updates erhalten hat.

Download Firefox Lockbox für Apple iOS

Doch nicht nur auf Apple iOS ist Firefox Lockbox ein Thema. In Kürze wird Mozillas Passwort-Manager ebenso für Android erscheinen und die bevorzugte Passwort-Lösung für den kommenden Fenix-Browser sein, im Sommer wird Lockbox außerdem als Erweiterung für den Desktop-Firefox erscheinen. Mockups geben einen Ausblick, was von der Firefox-Erweiterung zu erwarten ist.

Wie immer bei Mockups sei auch hier angemerkt, dass diese nicht zwangsläufig das finale Produkt repräsentieren müssen – weder, was das Design betrifft, noch funktional.

Die Mockups zeigen eine Toolbar-Schaltfläche, über welche ein Login ausgewählt werden kann. Benutzername und Passwort lassen sich darüber betrachten und kopieren.

Firefox Lockbox für Desktop

Firefox Lockbox für Desktop

Die Passwort-Verwaltung selbst wirkt sehr aufgeräumt und bietet im Wesentlichen die gleichen Funktionen wie die Toolbar-Schaltfläche. Hierüber können bestehende Logins außerdem bearbeitet und neu angelegt werden – etwas, was in der bestehenden Passwort-Verwaltung von Firefox nicht möglich ist.

Firefox Lockbox für Desktop

Erkennt Firefox Lockbox, dass ein Login kompromittiert sein könnte, wird darauf in Form eines roten Banners hingewiesen. Dabei handelt es sich um eine Integration von Firefox Monitor, einem Dienst, den Mozilla im September 2018 gestartet hat und Nutzer überprüfen lässt, ob diese in der Vergangenheit Opfer eines Datendiebstahls waren. Dafür arbeitet Mozilla mit HaveIBeenPwned.com zusammen.

Die Mockups zeigen außerdem einen eigenständigen Monitor-Tab, wo es zu bekannten Datendiebstählen ausführliche Informationen über Zeitpunkt und Art des Diebstahls gibt. Außerdem wird der Nutzer animiert, sein Passwort zu ändern.

Firefox Lockbox für Desktop

Auch mit dem dunklen Theme von Firefox soll Firefox Lockbox harmonieren, wie das folgende Mockup zeigt.

Firefox Lockbox für Desktop

Ob der Monitor-Service ebenso Teil des kostenlosen Angebots sein wird, lässt sich anhand der Mockups nicht ableiten. Denn während die Grundfunktionalität kostenlos ist, plant Mozilla, ab dem dritten Quartal mit Premium-Features für Firefox Lockbox und Firefox Monitor zu experimentieren. Mit Premium-Angeboten möchte Mozilla unabhängiger von Suchmaschinen-Verträgen werden. Bislang erhält Mozilla einen Großteil seines Geldes von Google. Im Oktober 2018 hat Mozilla in den USA mit einem VPN sein erstes Premium-Angebot testweise gestartet.

Der Beitrag Vorschau auf Mozillas neuen Passwort-Manager für Firefox erschien zuerst auf soeren-hentzschel.at.

Schulnetzwerke werden mit wachsenden Anforderungen komplexer. Ein Schulserver, schulweites WLAN, Einsatz von Tablets und Laptops im Unterricht, eine Schulcloud, einheitliche Logins für alle Dienste – die Anforderungen an einen Netzwerkbetreuer oder Dienstleister in der Schule sind vielfältig. Wenn alles funktioniert, ist meist auch alles gut. Aber was ist, wenn der Server, die Firewall oder ein Switch ausfällt? Die Konsequenzen können sehr unterschiedlich sein. Wie schnell kann der Normalbetrieb wiederhergestellt werden? Wie wichtig ist Hochverfügbarkeit in einem Schulnetzwerk?

Hochverfügbarkeit

Laut Wikipedia definiert sich Hochverfügbarkeit folgendermaßen

Hochverfügbarkeit (englisch high availability, HA) bezeichnet die Fähigkeit eines Systems, trotz Ausfalls einer seiner Komponenten mit einer hohen Wahrscheinlichkeit (oft 99,99 % oder besser) den Betrieb zu gewährleisten.

Es geht also darum, dass ein System („das Schulnetzwerk“) einsatzfähig bleibt, auch wenn eine oder mehrere Komponenten einmal ausfallen sollten. Dabei kann es durchaus zu Unterbrechungen kommen. Je nachdem wie lang so eine Unterbrechung ist, teilt man die Hochverfügbarkeit in verschiedene Klassen ein. Ein Schulnetzwerk muss vor allem an Schultagen einsatzfähig sein (ca. 180-200 Tage pro Jahr). Auch wenn eine 99,999% Verfügbarkeit in den wenigsten Schulen absolut notwendig ist, ist der reibungslose Betrieb für den Unterrichtsalltag sehr wichtig.

Single Point of Failures

Um Hochverfügbarkeit herzustellen, müssen sogenannte „Single Point of Failures“ reduziert werden. Es handelt sich dabei um Komponenten bei deren Ausfall das ganze Schulnetzwerk still stehen würde. Was können solche „Single Point of Failures“ sein?

  • Firewall → fällt sie aus, gibt es kein Zugang mehr zum Internet, je nach Konfiguration funktioniert auch das interne Netz nicht mehr
  • Switche (v.a. Hauptswitch) → siehe Firewall, Komplettausfall
  • Server → fällt er aus, sind viele Anwendungen nicht mehr zu erreichen, d.h. keine Anmeldung mehr im internen Logins, Webanwendungen, Schulcloud, …
  • Internetanschlüsse → fällt der einzige Zugang aus, ist man offline.
  • …

Kurze Geschichte am Rande:

Letzte Woche ist unsere Firewall ausgefallen (aufgrund des Atom C2000 Bugs). Das Netzwerk lag still, wir waren offline. Ein erster Versuch die Firewall zu virtualisieren scheiterte, sodass wir auf einen kleinen Minicomputer mit 2 Netzwerkkarten ausgewichen sind. Es waren ein paar zusätzliche Konfigurationen an unserem Hauptswitch nötig um alle WANs und VLANs auf zwei Netzwerkkarten aufzuteilen. Nach einigen Stunden lief das Netzwerk dann wieder (wir konnten das Backup der Konfiguration mit wenig Änderungen problemlos wiederherstellen).

Wie kann man die Ausfallsicherheit erhöhen?

Es gibt mehrere Möglichkeiten, wie man die Ausfallsicherheit erhöhen und das System „Schulnetzwerk“ besser gegen Ausfälle schützen kann. Allgemein geht es darum, dass man möglichst wenige (am besten keine) „Single Point of Failures“ hat und kritische Komponenten bei einem Ausfall fehlertolerant sind. Wie bereits oben erwähnt, hängen die Anforderungen an ein hochverfügbares Schulnetzwerk sehr von den Gegebenheiten und Wünschen des Schulträgers ab. Zum einen ist es eine Frage des Geldbeutels, zum anderen muss auch nicht jedes Netzwerk innerhalb weniger Minuten wieder verfügbar sein.

Hier einige Ideen, wie man die Ausfallsicherheit erhöhen kann:

  • qualitative Hardware → gute Hardware kostet zwar mehr, aber sie läuft oft stabiler
  • Backups, Backups → Konfigurationen, Daten, Virtuelle Maschinen, Container – an Backups führt kein Weg dran vorbei (Backups unbedingt auch testen!)
  • Monitoring → ein gutes Monitoring kann in manchen Fälle Fehler früh erkennen bzw. gibt einen Überblick, wo es im Netzwerk gerade Probleme gibt. So kann man schneller reagieren und ist nicht auf die Hinweise der Benutzer im Netzwerk angewiesen („Das Internet geht nicht mehr“, „Der Drucker ist kaputt“, …)
  • Fehlertoleranz erhöhen → auch „Failover“ genannt, d.h. zwei Netzteile im Server, mehrere Internetanschlüsse („Multi-WAN), zwei Firewalls, RAID, zwei Server, …
  • Ersatzteile vorhalten → Festplatten, Ersatzswitch, …
  • UPS/USW → Hardware bei Stromschwankungen schützen und Weiterbetrieb auch bei einem Stromausfall gewährleisten (für begrenzte Zeit)
  • „personelle Redundanz“ → besser zwei oder mehrere Administratoren bzw. Dienstleister (bei Abwesenheit durch Krankheit, Urlaub, …)
  • vorbeugende Wartungen
  • …

Fazit

Ein Schulnetzwerk ist sicher kein hochkritisches System, aber mit der fortschreitenden Digitalisierung der Schulen wird es immer wichtiger, dass die IT-Infrastruktur möglichst ohne Ausfälle erreichbar bleibt. An manchen Schulen wiegt ein Ausfall des Internets so schwer, dass kaum weiter gearbeitet werden kann (Onlinesysteme zur Verwaltung, Schulclouds, Online-Lernsysteme, Student Information Systems). Um die Ausfallsicherheit zu erhöhen, muss man nicht immer viel Geld in die Hand nehmen. Viel wichtiger ist, dass man auf einen Ausfall vorbereitet ist (v.a. bei den Single Point of Failures).

3 Kommentare

Der Beitrag Wie wichtig ist Hochverfügbarkeit in einem Schulnetzwerk? erschien zuerst auf .:zefanjas:..

Time Machine ist die universelle Backuplösung für macOS und Vorbild für Linux-Lösungen wie Back In Time oder Deja-Dup. Mit Time Machine lassen sich Systemeinstellungen, installierte Programme und Benutzerdaten auf externe Speichermedien sichern. Hierfür eignet sich von der externen Festplatte bis zum Netzwerkspeicher jedes mögliche Speichermedium.

Lange Zeit waren AFP-Freigaben dafür notwendig (siehe z. B. Time Machine Backups auf einen Linux Server sichern), was bei Linux die Netatalk-Implementierung erforderlich machte. Inzwischen wendet sich Apple von solchen Insellösungen ab und vollzieht einen Schwenk zu SMB. MacOS 10.14 "Mojave" stellt hier einen Zwischenschritt dar (siehe auch: Time Machine auf einem Linux Server - Stand macOS 10.14 "Mojave"), bei dem beide Implementierungen für Time Machine funktionieren. Wer also ein funktionsfähiges AFP-Backupziel hat braucht nicht zu wechseln, wer Probleme hat oder eine neue Sicherung einrichtet sollte gleich zukunftsfest auf SMB setzen.

Problematisch ist gegenwärtig immer noch, dass Apple einige spezifische Erweiterungen für SMB voraussetzt, damit dieses als Sicherungsziel für Time Machine geeignet ist. Proprietäre NAS-Anbieter wie beispielsweise Synology haben diese sehr schnell implementiert, die Open Source Community brauchte leider mal wieder erheblich länger. Die im März vergangenen Jahres veröffentlichte Version Samba 4.8 enthält nun aber alle benötigten Funktionen. Das Veröffentlichungsdatum zeigt jedoch schon, dass keine ernstzunehmende LTS-Distribution diese Version gegenwärtig ausliefert. Der Linux-Standard ist momentan Samba 4.7 oder älter. Das gilt leider auch für openSUSE Leap 15.0.

Wenn man also auf Leap 15.0 eine Time Machine-taugliche SMB-Freigabe einrichten will, muss man zuerst die Samba-Version aktualisieren. Dank des hervorragenden OBS ist dies zum Glück kein Problem. Dazu muss lediglich folgendes Repository hinzugefügt werden:

http://download.opensuse.org/repositories/network:/samba:/STABLE/openSUSE_Leap_15.0/

Anschließend aktualisiert man die installierte Samba-Version auf die dort gegenwärtig ausgelieferte Variante. Sofern nicht bereits installiert benötigt man zusätzlich noch Avahi:

# zypper in avahi

Nun richtet man eine Freigabe für Time Machine ein. Dazu sind, wie bereits erwähnt, einige Besonderheiten zu berücksichtigen. Folgendes sollte in der /etc/samba/smb.conf stehen: 

[TimeMachine]
	comment = Time Maschine Backuport
	path = /media/Daten/tmb
	browseable = yes
	writeable = yes
	vfs objects = catia fruit streams_xattr
	fruit:aapl = yes
	fruit:time machine = yes

Hierdurch wird das Speicherziel /media/Daten/tmb genutzt. Diesen Pfad muss man ggf. anpassen.

Als Benutzer empfiehlt es sicher immer für Time Machine einen eigenen Benutzer anzulegen. Bei openSUSE kann man das im entsprechenden YaST-Modul erledigen. Anschließend muss der Benutzer noch als Samba-User angelegt werden:

# smbpasswd -a <user>

Der Benutzer ist zudem noch als Eigentümer des Sicherungsordners einzutragen

# chown <user> /media/Daten/tmb

Abschließend aktiviert und startet man die Dienste für Samba und Avahi:

# systemctl enable smb.service

# systemctl start smb.service

# systemctl enable avahi-daemon.service

# systemctl start avahi-daemon.service

Die SMB-Freigabe lässt sich nun in macOS als Sicherungsziel einrichten.


Bilder:

Einleitungs- und Beitragsbild von FreePhotosART via pixabay

"

2. März 2019

Nur selbst betriebene Dienste bieten wirkliche Sicherheit für die eigenen Daten. In kaum einer Frage sind sich die meisten Experten derart einig. Das Softwareanagebot um eine solche Lösung zu betreiben ist vielfältig und die finanziellen Kosten überschaubar (siehe auch: Cloud in Eigenregie Teil I: Vorbemerkungen). Allerdings kommt man bei vollständiger Umsetzung letztlich nicht um den Betrieb eines Servers, der direkt aus dem Internet aufrufbar ist, herum.

Die meisten normalen Anwender sind mit der Pflege ihrer Endgeräte bereits vollkommen überfordert. Menschen, die in Supportforen mit vollständig veralteten Betriebssystem-Versionen jenseits jedweder Supportperiode auftauchen sind keine Seltenheit sondern repräsentieren eine große Gruppe von Anwendern. Lediglich die extrem langen Supporzeiträume von Windows-Versionen bewahren uns hier vor schlimmeren. Im mobilen Bereich ist die Verwendung nicht mehr unterstützter Betriebssysteme sogar die Regel - leider nicht nur bei Android. Die Ursache ist eine Mischung aus Hilflosigkeit, Unkenntnis, falscher Risikoabschätzung und der furchtbar falsch verstandenen Redewendung "never change a running system".

Die positive Nachricht ist, dass das Problem dennoch überschaubar ist. Massive Angriffswellen auf Android-Smartphones im Stil früherer Angriffe auf Windows-Rechner sind bisher zum Glück ausgeblieben, aber immmer wieder aufkommende Wellen von Schadsoftware, zuletzt in Form von Crypto-Schädlingen, zeigen das immense Problempotenzial. Zum Glück befinden sich viele der schlecht gewarteten Systeme hinter einem Router, dessen Firewall das schlimmste verhindert. 

Ganz anders bei einem Home Server, den man per DynDNS und Portweiterleitung aus dem Internet erreichbar macht. Schlecht konfigurierte Software oder ein Betriebssystem jenseits jeglicher Supportzeiträume entfaltet hier ein ganz anderes Gefährdungspotenzial. Mal abgesehen davon, dass ein Server voller Sicherheitslücken mit direkter Erreichbarkeit aus dem Netz alles möglich ist, nur kein wirksames Mittel für mehr Datenschutz.

Den meisten Anwendern kann man daher den Betrieb eines eigenen Servers kaum empfehlen. Sie bleiben auf die bestehenden Angebote von Dienstleistern angewiesen und können keinen wirksamen Datenschutz betreiben. Umso wichtiger ist hier natürlich die Existenz vertrauenswürdiger Anbieter, die ihren Kunden ein hohes Datenschutz-Niveau bieten.

Ansonsten entsteht eine Zwei-Klassen-Gesellschaft beim Datenschutz. Auf der einen Seite jene, die durch Ausbildung oder viel Zeit, sowie dem nötigen Interesse sich Kenntnisse angeeignet haben um eine eigene Infrastruktur zu betreiben und auf der anderen Seite solche Personen, denen das unerreichbar bleibt und für die kein wirksamer Datenschutz möglich ist.


Bilder:
Einleitungs- und Beitragsbild von Tumisu via pixaybay

"

Jolla bzw. das Betriebssystem Sailfish OS war mal die große Hoffnung auf ein funktionsfähiges, freies Mobilbetriebssystem ohne Google-Anbindung (siehe auch der damalige Test: Sailfish OS auf dem Nexus 4 ausprobiert). Trotz mannigfaltiger Schwierigkeiten gibt es Jolla und Sailfish OS immer noch, aber das kommerzielle Überleben hat seinen Preis.

Jolla wurde von ehemaligen Nokia-Mitarbeitern entwickelt, die den eingeschlagenen Entwicklungsweg des N9 und MeeGo weitergehen wollten. Sie hatten damit nicht unrecht. Die Kooperation zwischen Microsoft und Nokia, sowie die anschließende Übernahme der Handysparte von Nokia durch den Redmonder Konzern endete im Fiasko. Heute baut Microsoft keine Smartphones mehr und hat jüngst sein Mobilbetriebssystem beerdigt (siehe auch: Kommentar: Microsoft wird Windows aufgeben), Nokia ist als Lizenzmarke von HMG Global nun wieder auf dem Smartphone-Markt zurück - mit Android. Jolla gibt es immer noch und jüngst veröffentlichte man Sailfish OS 3.

Doch auch Jollas Weg war nicht einfach. Anfänglich versuchte man sich auf die integrierte Entwicklung von Betriebssystem und Hardware, verhob sich dann aber mit der Entwicklung eines Tablets. Man fokussierte sich daraufhin auf die Weiterentwicklung des Systems und Lizensierung an Partner. Zudem arbeitet man mit Sony zusammen, weshalb es für einige Sony Xperia Geräte Sailfish X als offizielle Variante gibt.

Obwohl Sailfish OS als Open Source Hoffnung galt und sich in dieser Szene auch überproportionaler Beliebtheit erfreut ist das Betriebssystem nicht komplett quelloffen. Die Basis aus Linux Kernel und Mer ist zwar Open Source, die Oberfläche und einige Apps allerdings proprietär. Der Vorteil liegt also eher in der Unabhängigkeit von Google, Apple & Co und weniger in einer vollkommen transparenten Software.

Diese Unabhängigkeit hat leider ihren Preis. Um der Insolvenz zu entgehen versuchte man das Betriebssystem stärker in Schwellenländern zu etablieren, wo Android und iOS möglicherweise noch nicht so gefestigt sind. Vor allem die Verbindungen nach Russland sind in den letzten Jahren gewachsen. Die russische Firma Open Mobile Platform Ltd. gehört nicht nur zu den wichtigsten Mittelgebern Jollas, sondern lizensiert das Betriebssystem auch für die den russischen Markt.

Inzwischen ist der russische Staat über den Staatskonzern Rostelecom, der 75% der Anteile von Open Mobile Platform Ltd. hält, direkt an Jolla beteiligt. Rein theoretisch soll ein angepasstes Sailfish OS, das als Aurora OS firmiert, zukünftig als Betriebssystem für alle Mobiltelefone von Staatsbeamten genutzt werden. Inwiefern hier gesetzgeberische Theorie und gelebte Verwaltungspraxis auseinander gehen kann man natürlich von Deutschland aus nicht beurteilen.

Es stellt sich aber schon die Frage, ob ein System, auf dessen Entwicklung mittelbar ein Staat Einfluss hat dessen politisches System nur sehr wenige als lupenreine Demokratie bezeichnen, wirklich noch die Open Source Hoffnung am Smartphone-Markt sein kann.


Bilder:
Einleitungs- und Beitragsbild von Pexels via pixabay

"

1. März 2019

Text-, Sprach- und Videonachrichten werden heutzutage nicht mehr über standardisierte Formate, sondern über Dienste in Firmenhand ausgetauscht. Damit einher geht ein riesiger Datenpool, denn selbst bei verschlüsselten Inhalten bleiben die wertvollen Metadaten ungeschützt. Abhilfe könne hier nur freie Dienste schaffen, aber das Angebot ist unübersichtlich und nicht konkurrenzfähig.

Wie prekär die Situation ist, zeigte sich kürzlich wieder anlässlich der geplanten Integration der drei Facebookdienste WhatsApp, Instagram und Facebook Messenger (siehe auch: Kommentar: Facebook - Einfach weiter wie bisher). Facebook legt damit potenziell eine Datenbank an, die für sehr viele Weltregionen beinhaltet wer, wann mit wem kommuniziert hat.

Facebook und seinen Tochterunternehmen spielt dabei in die Hände, dass sich die anderen großen IT-Firmen vollkommen verzettelt haben. Weder haben Google, Microsoft und Apple es hingekriegt einen Dienst als Gegengewicht aufzubauen, noch konnten die Telekommunikationsunternehmen ihre halbgaren Lösungen etablieren. Bei ersteren fehlt es definitiv am Willen zur Zusammenarbeit, bei letzteren an Marktmacht und fähigen Entwicklern.

Es bleiben somit nur freie Lösungen, die von der Community oder kleinen Firmen entwickelt und gepflegt werden.

Früher trennt man die Bereiche in Text-, Sprach und Videokommunikation. Heute können die meisten Apps mehrere oder gar alle dieser Funktionen gleichzeitig. Die ehemaligen Lösungen zur Videkommunikation haben Textlösungen implementiert und ehemalige Instant Messenger lassen nun auch Videokommunikation zu. Dateiaustausch bietet fast jede Lösung an.

Die folgende Auflistung behandelt nur komplett freie Angebote und keine halbfreien Pseudolösungen wie beispielsweise Telegram mit seinem proprietären Server.

Freie Kommunikationslösungen

Dezentrale Ansätze

Die beiden dezentralen Angebote basieren auf den Fortentwicklungen relativ alter Standards und dem Versuch diese den Gegebenheiten der Gegenwart anzupassen. Herausforderungen sind hier neben der Vielzahl der Endgeräte und ihrer mobilen Nutzung auch die staatliche Überwachung und das Bedürfnis nach starker Verschlüsselung.

IRC

IRC (Instant Relay Chat) ist vermutlich die älteste Lösung und kommt noch aus den Anfängen des öffentlichen Internets. War es anfänglich als Möglichkeit zum textbasierten Gruppenchat weit verbreitet, nutzt heute vor allem die Open Source Szene noch stark das System. Die Stärke des Systems ist sein dezentraler Ansatz und die Vielzahl an Clients, die das System auf allen denkbaren Betriebssystemen ermöglicht.

Das System hat aber auch zahlreiche Schwächen. IRC ist kein homogener Messenger sondern gespalten in unterschiedliche Netzwerk mit regionalen Schwerpunkten. Der Anwender muss sich mit einem solchen Netz (bspw. freenode) verbinden und kann sich dann nur innerhalb des verbundenen Netzes Nachrichten austauschen. Die Nachrichtenübertragung erfolgt standardmäßig unverschlüsselt, was in letzter Zeit lediglich mit den Transportverschlüsselung kompensiert wurde. Clientseitige Verschlüsselung hat sich weder für Gruppen- noch Privatnachrichten durchgesetzt. Dadurch ist IRC so sicher wie eine herkömmliche E-Mail.

XMPP

Das Extensible Messaging and Presence Protocol (kurz XMPP), früher auch als Jabber bekannt, ist etwas jünger als IRC und seit 2004 durch die IETF als Standard anerkannt. Jeder an das Internet angebundene XMPP-Server kann mit anderen Servern kommunizieren, wodurch XMPP ähnlich dezentral aufgebaut ist wie die E-Mail. Dadurch kann jeder Inhaber eines XMPP-Accounts alle anderen Anwender kontaktieren.

Der dezentrale Ansatz ist jedoch auch das größte Hindernis bei der Entwicklung. Verbindungen zwischen zwei Clients werden immer über mindestens einen Server aufgebaut. Sind die Anwender bei unterschiedlichen Servern angemeldet, müssen besagte Server miteinander kommunizieren. Das erfolgte ursprünglich mal alles unverschlüsselt, inzwischen haben die meisten Anbieter eine Transportverschlüsselung eingerichtet. Eine Verschlüsselung der Inhalte zwischen den Endgeräten (Ende-zu-Ende) ist zwar theoretisch mittels OTR bzw. OMEMO möglich, aber viele Clients haben das immer noch nicht implementiert. Audio- und Videokommunikatin ist bis dato noch fast immer unverschlüsselt.

Einige Zeit lang sah es so aus, als ob XMPP als Messenger eine vergleichbare Bedeutung wie die E-Mail erreichen könnte. Die Unterstützung durch Google und viele andere große Anbieter sollte es möglich machen. In den letzten Jahren beendeten jedoch viele Firmen ihr Engagement und XMPP ist tendenziell auf dem Rückzug. In Open Source Kreisen hofft man regelmäßig, dass XMPP sich doch noch durchsetzen kann (so wie bei Linux), aber das ist unwahrscheinlich. Die Bedeutung des Standards liegt heute vor allem darin, dass er die Basis für die vielen proprietären Lösungen von WhatsApp bis iMessage bildet.

Matrix/Riot

Matrix ist einer der neuesten Akteure auf dem Markt der dezentralen Angebote. Matrix möchte simplifiziert ausgedrückt die Schwächen von XMPP überwinden und ein zeitgemäßes Protokoll für die Text-, Sprach und Videokommunikation über das Internet anbieten.

Mit Synapse und dem mit Abstand wichtigste Client Riot - der sowohl für Desktop, wie Mobilbetriebssysteme zur Verfügung steht - gibt es quasi Referenzimplementierungen. Hierdurch vermeidet man zumindest vorerst die starke Zersplitterung von XMPP mit all ihren Nachteilen. Grundsätzlich erlaubt man allerdings eine Föderalisierung.

Der Fokus liegt dem Zeitgeist folgend stark auf Gruppenkommunikation wie sie das proprietäre Slack massentauglich gemacht hat.

Silence

Bei Silence (ehemals SMSSecure) handelt es sich im Prinzip um einen Aufsatz für SMS/MMS, der eine Verschlüsselung dieser Kommunikation gewährleistet. Das macht zentrale Server überflüssig, setzt aber eine Mobilfunknummer, sowie einen Tarif voraus. Zudem existiert Silence nur für Android und ist daher eine Insellösung.

Zentralisierte Messenger

Einige Entwickler haben sich den Erfolg von WhatsApp zum Vorbild genommen und konzeptionell ähnliche Angebote entwickelt, die jedoch sicherer sein sollen oder dem Anwender mehr Freiheiten lassen.

Signal

Signal ist sicherlich das Flaggschiff der sicheren Messenger. Seit 2015 firmieren die Kommunikationslösungen von Open Whisper Systems einheitlich unter der Marke Signal und lösen damit die Vorgänger TextSecure für Android ab. Finanziert wird das ganze durch Spenden und sonstige Einnahmen. Strukturell ähnelt Signal modernen Angeboten wie WhatsApp. Die Kommunikation erfolgt über Apps für Mobilbetriebssysteme und wird über zentrale Server abgewickelt. Zwar kann theoretisch jeder einen eigenen Signal-Server betreiben, allerdings würde man sich dann vom restlichen Signal-Netzwerk loslösen. Eine Dezentralisierung lehnen die Entwickler ab, da man genau jene Entwicklungshemmnisse fürchten in die XMPP und IRC geraten sind.

Die Verschlüsselungslösung von Signal, das vormals so genannte Axolotl-Protokoll, gilt als absolut sicher und findet auch in den konkurrierenden Lösungen WhatsApp und Wire Verwendung. Signal versucht zudem seit längerem die anfallenden Metadaten und Informationen zum Kontaktabgleich zu minimieren. Der Zugriff auf das Adressbuch ist sowieso optional. Verschlüsselung ist hier nur nicht ein Placebo für die besorgte Anwenderseele.

Wire

Wire funktioniert oberflächlich ähnlich wie Signal und bearbeitet damit die gleiche Nische. Es gibt Apps die über einen zentralen Server miteinander verschlüsselt kommunizieren. Das Verfahren wurde erfolgreich einem Audit unterzogen und ist somit vertrauenswürdig. Die Entwicklung betreibt maßgeblich die Schweizer Firma Wire Swiss GmbH aber Apps und Server sind Open Source.

Peer-to-Peer Lösungen

Es gibt auch Lösungen, die ohne einen oder mehrere zentrale Server auskommen und die Verbindung direkt zwischen den Clients aufbauen.

Ring/Jami

Kaum eine Lösung hat sich so oft umbenannt, wie das was aktuell als Jami firmiert. Man kennt es möglicherweise auch unter den früheren Namen GNU Ring und SFLPhone. Insbesondere letzterer zeigt den ursprünglichen Fokus des Projekts auf eine SIP-basierende Lösung für Sprachkommunikation.

Jami ist quelloffen und benötigt keinen zentralen Server. Es steht Apps für alle verbreiteten Desktopsysteme, sowie für Android und iOS zur Verfügung.

Briar

Die ausschließlich für Android verfügbare Lösung Briar ist ein Sonderling. Der Datenverkehr wird über das Tor-Netz geleitet oder direkt über WLAN und Bluetooth. Kontakte lassen sich ausschließlich über das gegenseitige scannen des QR-Codes, d. h. also beim persönlichen Kontakt, hinzufügen. Alle Inhalte sind Ende-zu-Ende verschlüsselt und ausschließlich auf den Endgeräten gespeichert. Das Programm wurde einem Audit unterzogen den es mit Bravour bestanden hat.

Briar fällt in sofern aus der hiesigen Aufzählung, da die Entwickler nicht den Massenmarkt im Sinn haben, sondern einen extrem sicheren Dienst für besonders gefährdete Zielgruppen erstellen wollen. Komfortfunktionen werden daher grundsätzlich der Sicherheit untergeordnet. Ein Punkt wo Lösungen wie Signal durchaus machmal Kompromisse eingehen.

Tox

Tox ist ebenfalls eine Peer-to-Peer Lösung. Ursprünglich gab es zumindest in der Außendarstellung einen starken Fokus auf Videokommunikation, inzwischen bietet man auch hier das Komplettpaket aus Text, Sprach- und Videokommunikation. Ähnlich wie bei IRC und XMPP gibt es keine richtig offiziellen Clients, sondern das Angebot variiert je nach Plattform und beruht lediglich auf einem gemeinsamen Kern. Das betrifft leider auch Funktionsumfang und Stabilität.

Problematisch ist, dass die Hinzufügung von Kontakten lediglich über eine sehr lange ID erfolgen kann, die auf einem anderen Weg als Tox ausgetauscht werden muss. Zur Verschlüsselung greift man auf die NaCI Bibliothek zurück, was von allen anderen vergleichbaren Lösungen abweicht.

Zusammengefasst

Der Artikel umfasst nur einen Bruchteil der existierenden, quelloffenen Kommunikationslösungen und zeigt dennoch bereits das Problem auf. Viele verschiedene Lösungen wollen das gleiche Angebot machen: Sichere, quelloffene und transparente Software für Text-, Sprach und Videokommunikation zwischen Mobilgeräten und/oder Desktopsystemen. Dabei gibt es einen Wettstreit unterschiedlicher Ansätze von dezentralen Systemen, über zentrale Server bis hin zu Peer-to-Peer Verbindungen. Während man die Parallelität dieser Ansätze noch nachvollziehen kann, ergeben viele Doppelentwicklungen innerhalb dieser Bereiche kaum noch Sinn.

Im Kommunikationsbereich setzt sich nämlich nicht die beste Lösung durch, sondern die am weitesten verbreitete. Hier gilt insbesondere jenes Argument nicht, das im Linux-Bereich oft herangezogen wird: Vielfalt fördert Entwicklung. Denn der Netzwerkeffekt beförderte die Durchsetzung von WhatsApp und Facebook, die zu keinem Zeitpunkt die technisch beste oder beliebteste Lösung darstellten. Keine der oben genannten Lösungen hat die Chance eine nennenswerte Reichweite zu erreichen, wenn die für Sicherheit und Datenschutz sensibilisierte Zielgruppe sich auf dutzende Lösungen (und oben sind schließlich nur die freien Möglichkeiten aufgelistet) verteilt.

Deshalb bleibt WhatsApp & Co erfolgreich.


Bilder:
Einleitungs- und Beitragsbild von geralt via pixabay

"

Rust ist in einer neuen Version erschienen. Version 1.33 bringt einige Änderungen insbesondere in Bezug auf sog. const fn-Funktionen mit. In diesem Blogartikel möchte ich ein wenig hierauf eingehen.

Verbesserungen bei const fn

const fn erhielt die Möglichkeit, let-Bindings (auch mutable) zu beinhalten sowie Wertzuweisungen auszuführen. Um ein wenig die Bedeutung von const fn zu erläutern, hier ein kleiner Exkurs:

const fn wurde mit Rust 2018 (v1.31) eingeführt kann immer dann eingesetzt werden, wenn Funktionen bereits zur Kompilierungszeit (compile time) ausgewertet werden sollen. Aber was bedeutet das? Schauen wir uns ein kleines Beispiel aus C an, um ein Gefühl dafür zu bekommen:

Kleiner C-Exkurs

#include <stdio.h>

int main()
{
	/* Define variable by precise value */
	int a = 1;
	int b = 9;

	/* Define variable by expression */
	int c = a + b;

	/* print to stdout */
	printf("%d", c);

	/* return with successful return code */
	return 0;
}

Diesen Quelltext werden wir nun ohne jegliche Optimierungen (-O0) kompilieren, aber den Zwischenschritt vor der Assemblierung genauer anschauen (konkret: dort stoppen; -S):

gcc -S -O0 demo.c

In der demo.s befindet sich jetzt der Assembler-Source. Relevant sind hier die folgenden Zeilen:

movl	$1, -12(%rbp)
movl	$9, -8(%rbp)
movl	-12(%rbp), %edx
movl	-8(%rbp), %eax
addl	%edx, %eax
movl	%eax, -4(%rbp)
movl	-4(%rbp), %eax
movl	%eax, %esi
leaq	.LC0(%rip), %rdi
movl	$0, %eax
call	printf@PLT

Hieran lässt sich eindrucksvoll zeigen, dass bei Programmausführung wirklich erst die Zahlen 1 und 9 in die entsprechenden Register geladen und dann addiert werden. Jetzt kann die Frage auftauchen, warum der Compiler nicht selber erkennen kann, dass er doch sowieso nur mit der Variable c arbeiten muss, die ja in diesen Beispiel offensichtlich 10 ergibt und so Rechenschritte bei der Ausführung sparen könnte. Ja, genau das macht die Optimierung, die wir gerade noch abgeschaltetet haben. Mit

gcc -S -O3 demo.c

sieht die entsprechende Stelle ganz anders aus:

movl	$10, %esi
leaq	.LC0(%rip), %rdi
xorl	%eax, %eax
call	printf@PLT

Hier wird der Code sauber erkannt und kann bereits so optimiert werden, dass die Zwischenschritte der Addition entfallen. Voraussetzung ist natürlich, dass die Werte zur compile time feststehen. Interaktive Nutzereingaben machen solch eine Optimierung natürlich unmöglich.

Was hier als Optimierungsschritt erscheint, lässt sich auch mit System betrachten: Funktionen, die bereits während der Kompilierung zu einem Ausgabewert zerfallen können, verbrauchen während der Ausführungszeit weniger Ressourcen, es entfallen Aufrufe und Rücksprünge. Genau das ist einer der Einsatzszenarien für const fn. Unter C++ ist ein ähnliches Konstrukt als constexpr seit C++11 bekannt.

const fn-Funktionen kommen neben der Performanceoptimierung auch dann zum Einsatz, wenn ihre Ausgabe schon während der Kompilierung bekannt sein muss, z.B. bei der Berechnung der Länge von Arrays. Wer öfter mit dem Compiler zu tun hatte, wird merken, dass aufgrund der statischen Typisierung i.d.R. die Größe von Ausgaben während der Kompilierung bereits bekannt und konstant sein muss (d.h. der Ausgabetyp muss das Sized-Trait implementieren). Wenn das nicht möglich ist, muss als Workaround wenigstens der Pointer auf den (langsameren) Heap eine fixe Länge haben (s. Box).

Dass diese const fn-Funktionen 4 Monate nach ihrer Einführung stetig erweitert werden, sehe ich als sehr sinnvoll an.

Pinning

Ein von mir heiß erwartetes Feature ist endlich stable geworden: Pinning. Hierzu muss man im Hinterkopf haben, dass Rust im Gegensatz zu C(++) den Einsatz von manuellen Pointern konzeptionell massiv zurückdrängt. Das Management von Pointern soll Rust übergeben werden, wodurch Boilerplate-Code vermieden werden soll. C++-Entwickler werden dies mitunter von unique_ptr kennen. Der Nachteil bei Rust: einige Aufgaben wie komplexerere Datenstrukturen sind oftmals mit C schneller umgesetzt oder könnten in Rust nur mit direktem Zugriff auf die Pointer über die unsafe-Blöcke umgesetzt werden.

Als einfaches Beispiel dienen selbstreferenzierende structs, die durch die Eigenreferenz im Speicher verschoben (move) und invalidiert werden. Hier bestand lange Zeit der Wunsch, solche Speicherbereiche zu fixieren, also anpinnen zu können, was durch das Pin module nun auch im Stable-Code ermöglicht wird. Dies wird die Arbeit vieler Autoren der Bibliotheken erleichtern, da hier solche Szenarien öfter vorkommen. Mir ist so ein Szenario in letzter Zeit beim Threading bzw. der Arbeit mit tokio-rs untergekommen und hier wird die Reise auch hingehen, denn dieses Feature ist ein Meilenstein bei der Entwicklung von async und await für Rust, die unter areweasyncyet.rs verfolgt werden kann.

Underscore imports

Rust-Einsteiger werden merken, dass unter Rust ein etwas anderes Verständnis von Objektorientierung vorherrscht. So werden die Daten (struct) von deren Methoden (impl) optisch wie auch semantisch getrennt und nicht in einer Einheit wie z.B. class unter Python mit Eigenschaften/Properties und Methoden vereint.

Gemeinsame Methoden werden in traits (Fähigkeiten) deklariert und können für ein bestimmtes struct implementiert werden. Ergo wird die dahinterliegende Datenstruktur bei der Interaktion für einen Entwickler irrelevant und unsichtbar, er beschränkt sich nur auf die Übergabestellen. Aus diesem Grund werden die Java-Entwickler diese Technik auch unter dem Namen interfaces kennen. Zusammenfassend lässt sich der in Rust vorliegende Ansatz als Composition over inheritance bzw. Komposition an Stelle von Vererbung beschreiben.

Der Entwicklungsalltag ist somit von traits geprägt. Soll mit einem bestimmten struct gearbeitet und auf eine für dieses implementierte trait-Funktion aus einem anderen Modul zurückgegriffen werden, muss das trait über ein use-Kommando in-scope gerufen werden. Das klingt sehr ungewöhnlich, ist aber beim Programmieren logisch. In nebenstehender Grafik habe ich ein wenig das Szenario versucht, grafisch zu umreißen.

Fakt ist: bisher kann dieses Verfahren zu "naming clashes" führen, wenn z.B. die Funktionalität des Read-traits aus der Standard-Lib genutzt, aber gleichzeitig ein eigenes Read-trait im Code definiert werden soll. Ab sofort gibt es hierfür Abhilfe: mit z.B.

use std::io::Read as _;

lässt sich die mit dem Trait verbundene und durch das genutzte struct implementierte Read-Funktionalität nutzen; trotzdem kann nun zusätzlich ein eigenes Read-Trait im Module definiert werden, da durch den underscore import das Trait im Module nicht namentlich bekannt gemacht wird.

Weitere Änderungen

  • Duration kann nun im Stable in kleineren Einheiten als Sekunde ausgeben, benötigt dafür z.B. unsigned 128-bit integer
  • Cargo erkennt und rekompiliert nun, sofern sich während der Kompilierung Dateien ändern
  • viele Libraries wurden weiter stabilisiert

Das Changelog sowie der Blogartikel zum neuen Release sind vom Rust-Team bereits zur Verfügung gestellt worden.