staging.inyokaproject.org

2022 Woche 10

13. März 2022

In vielen Diensten sind Metadaten eigentlich die wirklich wichtigen Daten und es geht weniger um Inhalte. Bei einem Gerät wie einem Notebook mag das so nicht komplett zutreffen, aber auch hier sind interessante Metadaten verfügbar. Bei Linux liegen die weitestgehend offen.

Das neue Home-Konzept aus dem Umfeld von systemd habe ich bereits vorgestellt. Vorwiegend von Interesse war und ist für mich die Verschlüsselungsoption für die Home-Verzeichnisse, da hier eine Lücke geschlossen wird, die bei Linux einfach faktisch existiert. Daneben adressiert das Konzept auch andere Einsatzszenarien wie portable Home-Verzeichnisse oder Home-Verzeichnisse auf einer Netzwerkfreigabe. Ein weiterer spannender Aspekt ist die völlig neue Verwaltung von Metadaten, die zu einem Benutzer gehören.

Bei einem normalen Linux-System kann ich auch ohne Kenntnis der Logindetails einiges über die vorhandenen Nutzer auslesen. Erst einmal kann man natürlich alle vorhandenen Benutzer ermitteln. Hinzu kommen dann weiterführende Informationen wie Benutzername ggf. weitere eingegebene Metadaten wie vollständiger Name oder E-Mail Adresse, das letzte Logindatum, Gruppenmitgliedschaften, Standard-Shell, Richtlinien zur Passwortänderung und wann das Passwort zuletzt geändert wurde. Sicherlich habe ich hier noch einiges vergessen.

Bei normalen Client-Systemen mit nur einem Benutzer und einer Vollverschlüsselung umgeht man dieses Problem, weil die vollständige Verschlüsselung eben auch die Metadaten einschließt. Das ist quasi der Vorschlaghammer, um alle Sicherheitsdefizite bei Linux zu lösen. Bei Multi-User-Systemen geht das nicht, da liegen diese Metadaten zwangsläufig eher schlecht gesichert im System. Vor allem der Zeitpunkt des letzten Login ist auf vielen Ebenen ein sehr interessanter und problematischer Punkt.

Der Ansatz von systemd-homed diese Informationen im Benutzerverzeichnis selbst zu speichern, ist sehr interessant. Diese Informationen liegen alle in einer Datei .identity, die im Home-Verzeichnis des Anwenders liegt und erst nach dessen Anmeldung lesbar ist. Das System „kennt“ dadurch nur die Systembenutzer, die menschlichen Benutzer machen sich erst durch ihren Login und nur für die Dauer des Logins „bekannt“ mit dem System. Einzige Voraussetzung ist natürlich ein verfügbarer und laufender Dienst systemd-homed, aber das wird mittelfristig bei immer mehr Distributionen der Fall sein.

Das ist sicherlich kein Problem, das jeden Linux-Anwender umtreibt, aber ich finde es durchaus interessant, sich mal über Benutzer-Metadaten Gedanken zu machen. Die ganze Benutzerverwaltung unter Linux ist schließlich an Anciennität kaum zu überbieten. Informationen verteilen sich über viele Stellen, die Tools unterscheiden sich je nach Distribution erheblich und die fehlende Trennung von Systembenutzern und menschlichen Anwendern ist auch nur durch die Binnenlogik des Systems verständlich.

Der Artikel Linux Benutzerverwaltung – Problem ungesicherte Metadaten erschien zuerst auf [Mer]Curius

Lange galt der Grundsatz nur eine möglichst vollständige Verschlüsselung, schützt Daten auch wirklich sicher. Lösungen wie eCryptFS wurden daher zugunsten LUKS-basierter Ansätze aufgegeben. Diese Tendenz gipfelte zuletzt im Versuch, GRUB noch weiter aufzubohren, um eine Verschlüsselung der Boot-Partition zu ermöglichen. Doch macht diese Entwicklung Sinn oder ist sie nicht eher eine Sackgasse?

Dazu muss man sich vergegenwärtigen, warum die vollständige Verschlüsselung des kompletten Systems eigentlich als Ideal aufgestellt wurde. Vier wesentliche Faktoren spielten hier eine Rolle:

  1. Sicherstellen, dass keine sensiblen Daten in unverschlüsselten Bereichen gespeichert werden.
  2. Verhindern, dass Angreifer die unverschlüsselte Boot-Partition manipulieren.
  3. Verhindern, dass Angreifer über Einsicht in die Systempartition etwas über das System erfahren.
  4. Schwer zu lösende Probleme beim Logout und mit der Swap-Partition umgehen.

Im Grunde genommen sollte der Ansatz also vor allem die Unzulänglichkeiten von Linux umgehen. Das offensiv vorgetragene Sicherheitsargument sollte das nur übertünchen. Meiner Ansicht nach ist diese Entwicklung letztlich eine Sackgasse bzw. ein sterbender Entwicklungszweig, den man mittelfristig aufgeben wird. Dazu muss man sich nur ein paar Fragen stellen und nicht von den üblichen Linux-Antworten: „Das war schon immer so“ und „Das sind Unix-Prinzipien“ abspeisen lassen. Denn warum speichert das System eigentlich überhaupt Nutzerdaten außerhalb der Home-Partition ohne Kontrolle des Anwenders, warum gibt es keinen verifizierten Startvorgang, warum enthält die Systempartition durch die Verschränkung von Basissystem und Anwenderkonfiguration eigentlich sensible Informationen über das System?

Sicherheit kann man auch anders erreichen, ohne jedes Problem mit Verschlüsselung gleichsam einem Vorschlaghammer zu erschlagen. Sondern dieses Mittel nur dort einsetzt, wo man sie wirklich benötigt. Android ist da ein interessantes Vorbild – auch weil vieles an der Android-Basis so oder so ähnlich auch für Linux verfügbar ist. Wie das idealerweise bei Android funktioniert, kann man bei Interesse sehr gut erklärt in der GrapheneOS-FAQ nachlesen.

Im Grunde genommen basieren die Systeme auf einer Verschränkung von Verifizierung und Verschlüsselung. Firmware und Systempartition sind einfach nur Kopien der offiziellen Veröffentlichung und ihre Integrität wird lediglich beim Start verifiziert. Weil die Inhalte dieser Images öffentlich bekannt sind, braucht es keine Verschlüsselung. Die Anwendungen und Konfigurationen des Systems – also die Sachen, die ein System unterscheidbar machen – liegen in der Datenpartition. Diese muss natürlich verschlüsselt ein. Die wirklich sensiblen Daten liegen dann in den jeweiligen Nutzerprofilen, die logischerweise ebenso verschlüsselt und gegeneinander abgeschirmt sind.

Ich gehe aktuell davon aus, dass die aktuelle Situation bei Android ein Vorbild dafür ist, wo die Reise für Linux allgemein hingeht. Hierfür muss sich einiges ändern, aber viele grundlegende Umbauten sind schon länger in Arbeit und erreichen vermutlich demnächst relevante Nutzergruppen. Dazu zählt der usrmerge, den viele Distributionen zwischenzeitlich abgeschlossen haben. Unveränderbare Systeme wie SIlverblue, Kinoite, MicroOS etc. sind ebenfalls auf dem Vormarsch und bereiten den Weg für Systemimages, die nicht verschlüsselt werden müssen, weil sie nichts Geheimes enthalten. Beide Vorgänge führen zudem zu mehr Disziplinierung bei den Maintainern, die in der Vergangenheit Konfigurationen gerne außerhalb von /etc ablegten. Containerbasierte Ansätze im Serverbereich, aber auch Sachen wie Flatpak/Snaps am Desktop führen zur Frage, was die klassische Paketverwaltung leisten kann und soll und wie man zukünftig Anwendungen installiert. Zuletzt seien noch die Entwicklungen bei systemd genannt, um Verschlüsselung für Anwenderprofile anders umzusetzen.

Natürlich wird es wieder jene geben, die finden, dass dies alles überflüssig ist und für die das bisherige System ausreichend funktioniert. Diese Veränderung ist aber eine Chance, weil sie hässliche Workarounds beseitigt, mit denen man aktuell Sicherheitsprobleme zu adressieren versucht. Dazu gehören Funktionen in GRUB, die nicht in einen Bootloader gehören und dieses „Monster“ immer unwartbarer machen, aber notwendig aufgrund fehlender Verifizierung und des folglich fehlenden Manipulationsschutzes sind. Dazu gehören hässliche Lösungen, um vollständig verschlüsselte Server so zu starten, dass eine Remote-Passworteingabe möglich ist. Dazu gehören aber auch schlimme Tricks, um vollständig verschlüsselte Systeme Multiuser-tauglich zu machen, indem man 7 LUKS-Passwörter erstellt und anschließend (bestenfalls) die Profile mit eCryptFS gegeneinander schützt, das ebenfalls mehr eine Sammlung unlösbarer Bugs und Limitationen, denn eine ausgegorene Lösung darstellt.

Denkt man diese Entwicklung größer, dann gehören auch solche Sachen wie PolKit (ehm. PolicyKit) und fein austarierte Sudo-Konzepte dazu, welche in immer mehr Distributionen umfassend für die Privilegierung von Aufgaben einsetzt wird und das alte Root-System ablöst, bei dem man alles mit Adminrechten laufen lassen konnte oder gar nichts. Sicherheitsframeworks wie SELinux oder AppArmor sind bereits in den letzten Jahren in nahezu alle Distributionen eingezogen und führen Beschränkungen jenseits klassischer Dateirechte ein. Mit der Abkehr von X.Org zugunsten von Wayland bei wichtigen Distributionen 2022 wird auch dieses Sicherheitsrisiko endgültig in Richtung Abstellgleis geschoben.

Das sind spannende Entwicklungen, am Ende wird Linux deutlich anders aussehen, als es noch vor knapp 5-10 Jahren aussah, bevor diese Entwicklung in Gang kam.

Der Artikel Verschlüsselung neu denken – Das Ergebnis wird ein anderes Linux sein erschien zuerst auf [Mer]Curius
11. März 2022

Kurz notiert: Arch Linux, die Linux-Distribution, die besonders durch ihr KISS-Prinzip bekannt geworden ist, feiert heute ihren 20. Geburtstag. Sie erblickte die Welt am 11. März 2002 mit dem Release der Version 0.1. Klassische (Major-)Releases gibt es bei Arch Linux nicht, da das Rolling-Release-Modell genutzt wird. Die "Versionen" fungieren dabei eher als Einstiegspunkt. Als Paketverwaltung kommt das eigene System pacman zum Einsatz. Bei Arch Linux stehen die Prinzipen der Einfachheit, Modernität, Benutzerorientierung, Vielseitigkeit und des Pragmatismus im Mittelpunkt. (siehe Wiki)

Wer mehr zur Geschichte von Arch Linux lernen will, kann einen Blick in das Arch Wiki sowie die heutigen Artikel auf Heise und LinuxNews werfen.

Ich selber habe Arch vor knapp 10 Jahren das erste Mal ausprobiert, damals noch mit initscripts und knapp vor der systemd-Umstellung – und bin bis heute der Distribution treu geblieben. Es wirkt, als würde die Zeit zu rasen beginnen, wenn man bedenkt, dass bei vielen, einschließlich mir, der Arch-Einstieg zeitlich näher am ersten Release zurückliegt, als am heutigen Tage.

In diesem Sinne: Happy Birthday, Arch Linux!

Linux-Distributionen sind etwas fast einzigartiges. Bei keinem anderen Betriebssystem schieben sich zwischen Endanwender und Entwickler so zahlreiche und gleichzeitig mächtige Zwischenhändler. Kritik an diesem System wird von Verteidigern oft begegnet mit dem Einwand, die Distributionen würden einen wichtigen Prüfauftrag erfüllen. Wirklich?

Natürlich kann es bei Linux nicht wie bei macOS oder Windows lediglich einen Anbieter geben, der gleichermaßen Entwickler wie Verteiler ist, wobei auch andere freie Software wie z. B. die diversen BSD andere Systeme etabliert haben. Die Situation mit zahlreichen Distributoren, die alles vom Kernel bis zum Browser kontrollieren und im Extremfall in ein eigenes Betriebssystem „branden“ ist einzigartig. Es ist zudem nicht nur einzigartig, sondern auch umstritten und bereits seit vielen Jahren Ziel der Kritik, nicht zuletzt von den eigenen Softwareentwicklern, die den Distributoren vorwerfen, ein zu enger Flaschenhals im System zu sein.

Der vielfältigen Kritik begegnen die Distributoren und ihre Unterstützer mit dem umfassenden „Auftrag“ der Distribution. Dem Selbstverständnis nach bilden sie das Scharnier, das Entwickler und Endanwender verbindet und die unterschiedlichen Bedarfe vermittelt. In der Theorie prüfen die Distributoren schließlich den von den Entwicklern (Upstream) stammenden Code, verpacken ihn und stimmen die einzelnen Bestandteile des modularen Linux-Ökosystems aufeinander ab, verändern den von Upstream stammenden Code meist noch durch verschiedene Patches, ergänzen zudem noch eigene Tools und liefern es an den Endnutzer aus. Hinzu kommen ggf. weitere Prüfaufträge wie bei Debian z. B. die Konformität zu den DFSG.

In der Praxis können die Distributoren diesem Auftrag eigentlich nicht wirklich gerecht werden und sie tun es faktisch auch nicht. Dazu reicht Logik und Beobachtung.

Beginnen wir bei der Logik. Wir sind nicht mehr im Jahr 1995. Anfang der 1990er enthielt selbst der Linux-Kernel „nur“ einige Tausend Teilen Code. Heute sind es Millionen und von einer Version zur nächsten ändern sich gut und gerne mal Hunderttausende Zeilen. Der Kernel ist ein extremes Beispiel, aber große und wichtige Softwareprojekte wie systemd, Firefox oder die großen Desktopumgebungen sind da nicht viel besser. Die Schlagzahl ist bei nahezu allen Softwareprojekten rasant gestiegen. Die Zeiten, wo es mehrere Jahre infolge höchstens Minorversionen gab, sind schon lange vorüber. Heute kommen wichtige Veröffentlichungen gerne im Monatstakt. Ebenso gestiegen ist die Erwartungshaltung der Anwender. Nicht nur bei Rolling Release-Distributionen soll bestenfalls am Release-Tag die neue Version verfügbar sein, auch bei stabilen Varianten gibt es Backports und alle 1-2 Jahre neue Funktionsreleases. Gleichzeitig ist die Zahl derjenigen, die sich als Entwickler an den Distributionen beteiligen, tendenziell eher rückläufig. Eine nicht anlassbezogene und systematische Prüfung des kompletten Paketbestandes ist faktisch unmöglich.

Es scheitert aber nicht nur am „Mengenproblem“, sondern auch am Willen, den Prüfauftrag konsequent zu erfüllen. Das kann man seit vielen Jahren beobachten. Dazu gehört nämlich auch die Bereitschaft, qualitativ schlechte Software nicht an den Anwender auszuliefern, selbst wenn dadurch Lücken im Portfolio entstehen. Vorgänge, wie man sie z. B. im openSUSE Bugzilla am Beispiel des KDE Partition Manager / kpmcore nachlesen kann, wo wegen massiver Mängel Versionen zurückgehalten und Upstream Änderungen eingefordert werden, sind meiner Beobachtung nach extrem selten. Das kann man beispielsweise auch daran sehen, wie viele Distributionen immer noch bedenkenlos encfs ausliefern, obwohl das seit bald einem Jahrzehnt als gebrochen gilt oder ihre Anwender dem gefährliche Fingerprint-Authentfizierungssystem fprint aussetzen.

Innerhalb der Distributionen können weiterhin auch Inkonsistenzen vorherrschen. So entfernt Debian bei Firefox zahlreiche Telemetriefunktionen von Mozilla, verändert aber z. B. Chromium nicht. Es gibt somit keine konsistente Anti-Tracking-Policy, sondern es hängt an der Meinung des Maintainers und seiner Bereitschaft, etwas zu tun.

Dieser Zustand ist auch ein Grund weshalb ich neuen Softwareverteilungsformen offen gegenüberstehe und davor warne das alles überragende Distributorenmodell des Linux Server/Desktop-Ökosystems, das sich letztlich nur aus den Pfadabhängigkeit in der Entwicklung von Infrastruktur erklären lässt, auch auf moderne Bereiche wie mobile Systeme zu übertragen. Leider passiert momentan genau das. Weshalb wir für eine Handvoll Hardware zig Distributionen haben, die alle den gleichen nicht-alltagstauglichen Zustand paketieren, sich gegenseitig kannibalisieren und Geld kosten, das anderswo besser investiert wäre. Oder weshalb neue Konzepte wie Flatpak verunstaltet werden, bis alle sie alle Kennzeichen der bisherigen Distributorenlogik auch erfüllen und ihre Vorteile einbüßen, siehe Fedoras eigene Flatpak-Quelle. Da kommt halt ein weiterer Teil von Infrastrukturlogik zum Tragen: Das System versucht sich krampfhaft selbst zu erhalten und bremst die Entwicklung bis zur Blockade, weil bei neu aufkommender Infrastruktur Verlierer entstehen

Kurzum, die Distributionen erliegen an der Aufgabe, sind größtenteils auch nicht bereit, ihre selbst zugeschriebene Rolle konsequent zu erfüllen und dort, wo sie es tun, erledigen sie es inkonsequent. Die Position als verbindendes Scharnier zwischen Entwickler und Anwender und ihre Bedeutung sollte man also nicht zu hoch hängen. Viele Upstream-Projekte sind heute so professionell, dass sie durchaus ihre Software direkt auf den Anwender loslassen könnten, ohne dass es zu einem allgemeinen Qualitätsverfall kommen würde. Nichtsdestotrotz werden uns Distributionen in der aktuellen Form wohl erhalten bleiben, weil zu viele von dem System profitieren, die ansonsten keine Rolle spielen würden.

Der Artikel Distributionen als Scharnier – Eine Rolle, die auch gefüllt werden will erschien zuerst auf [Mer]Curius
Firefox Relay ist ein kostenloser Dienst von Mozilla, der die persönliche E-Mail-Adresse vor Spam und unerwünschter Offenlegung schützt. Nun hat Mozilla mehrere Verbesserungen aktiviert.

Was ist Firefox Relay?

E-Mail-Adressen sind gleichzusetzen mit einer persönlichen Adresse. Sie sind einmalig und viele Nutzer besitzen nur eine einzige E-Mail-Adresse, die sie teilweise auf dutzenden, wenn nicht gar auf hunderten Websites verwenden. Findet auf einer Website, auf der man mit seiner E-Mail-Adresse registriert ist, ein Datendiebstahl statt, wird damit in vielen Fällen auch die persönliche E-Mail-Adresse offengelegt. Und haben Spammer erstmal eine E-Mail-Adresse in ihrem System, darf man sich auf viele unerwünschte E-Mails ohne realistische Hoffnung einstellen, dass der Spam abnehmen wird.

Mit Firefox Relay können Alias-Adressen angelegt werden, die der Nutzer für Newsletter-Anmeldungen und Website-Registrierungen angeben kann. Firefox Relay leitet diese E-Mails dann an die persönliche E-Mail-Adresse weiter.

Firefox Relay ist kostenlos. Es gibt aber auch eine kostenpflichtige Premium-Version, welche unendlich viele Alias-Adressen anstelle von nur fünf sowie eine eigene E-Mail-Domain erlaubt. Der zeitlich begrenzte Einführungspreis von Firefox Relay Premium beträgt 0,99 EUR pro Monat.

Auch in der kostenlosen Version: Deutlich höheres Größen-Limit

Bisher hatte Firefox Relay ein Limit von maximal 150 KB inklusive Dateianhänge pro E-Mail. E-Mails, die größer waren, konnten nicht weitergeleitet werden. Dieses Limit hat Mozilla auf 10 MB erhöht.

Werbeblocker in Premium-Version

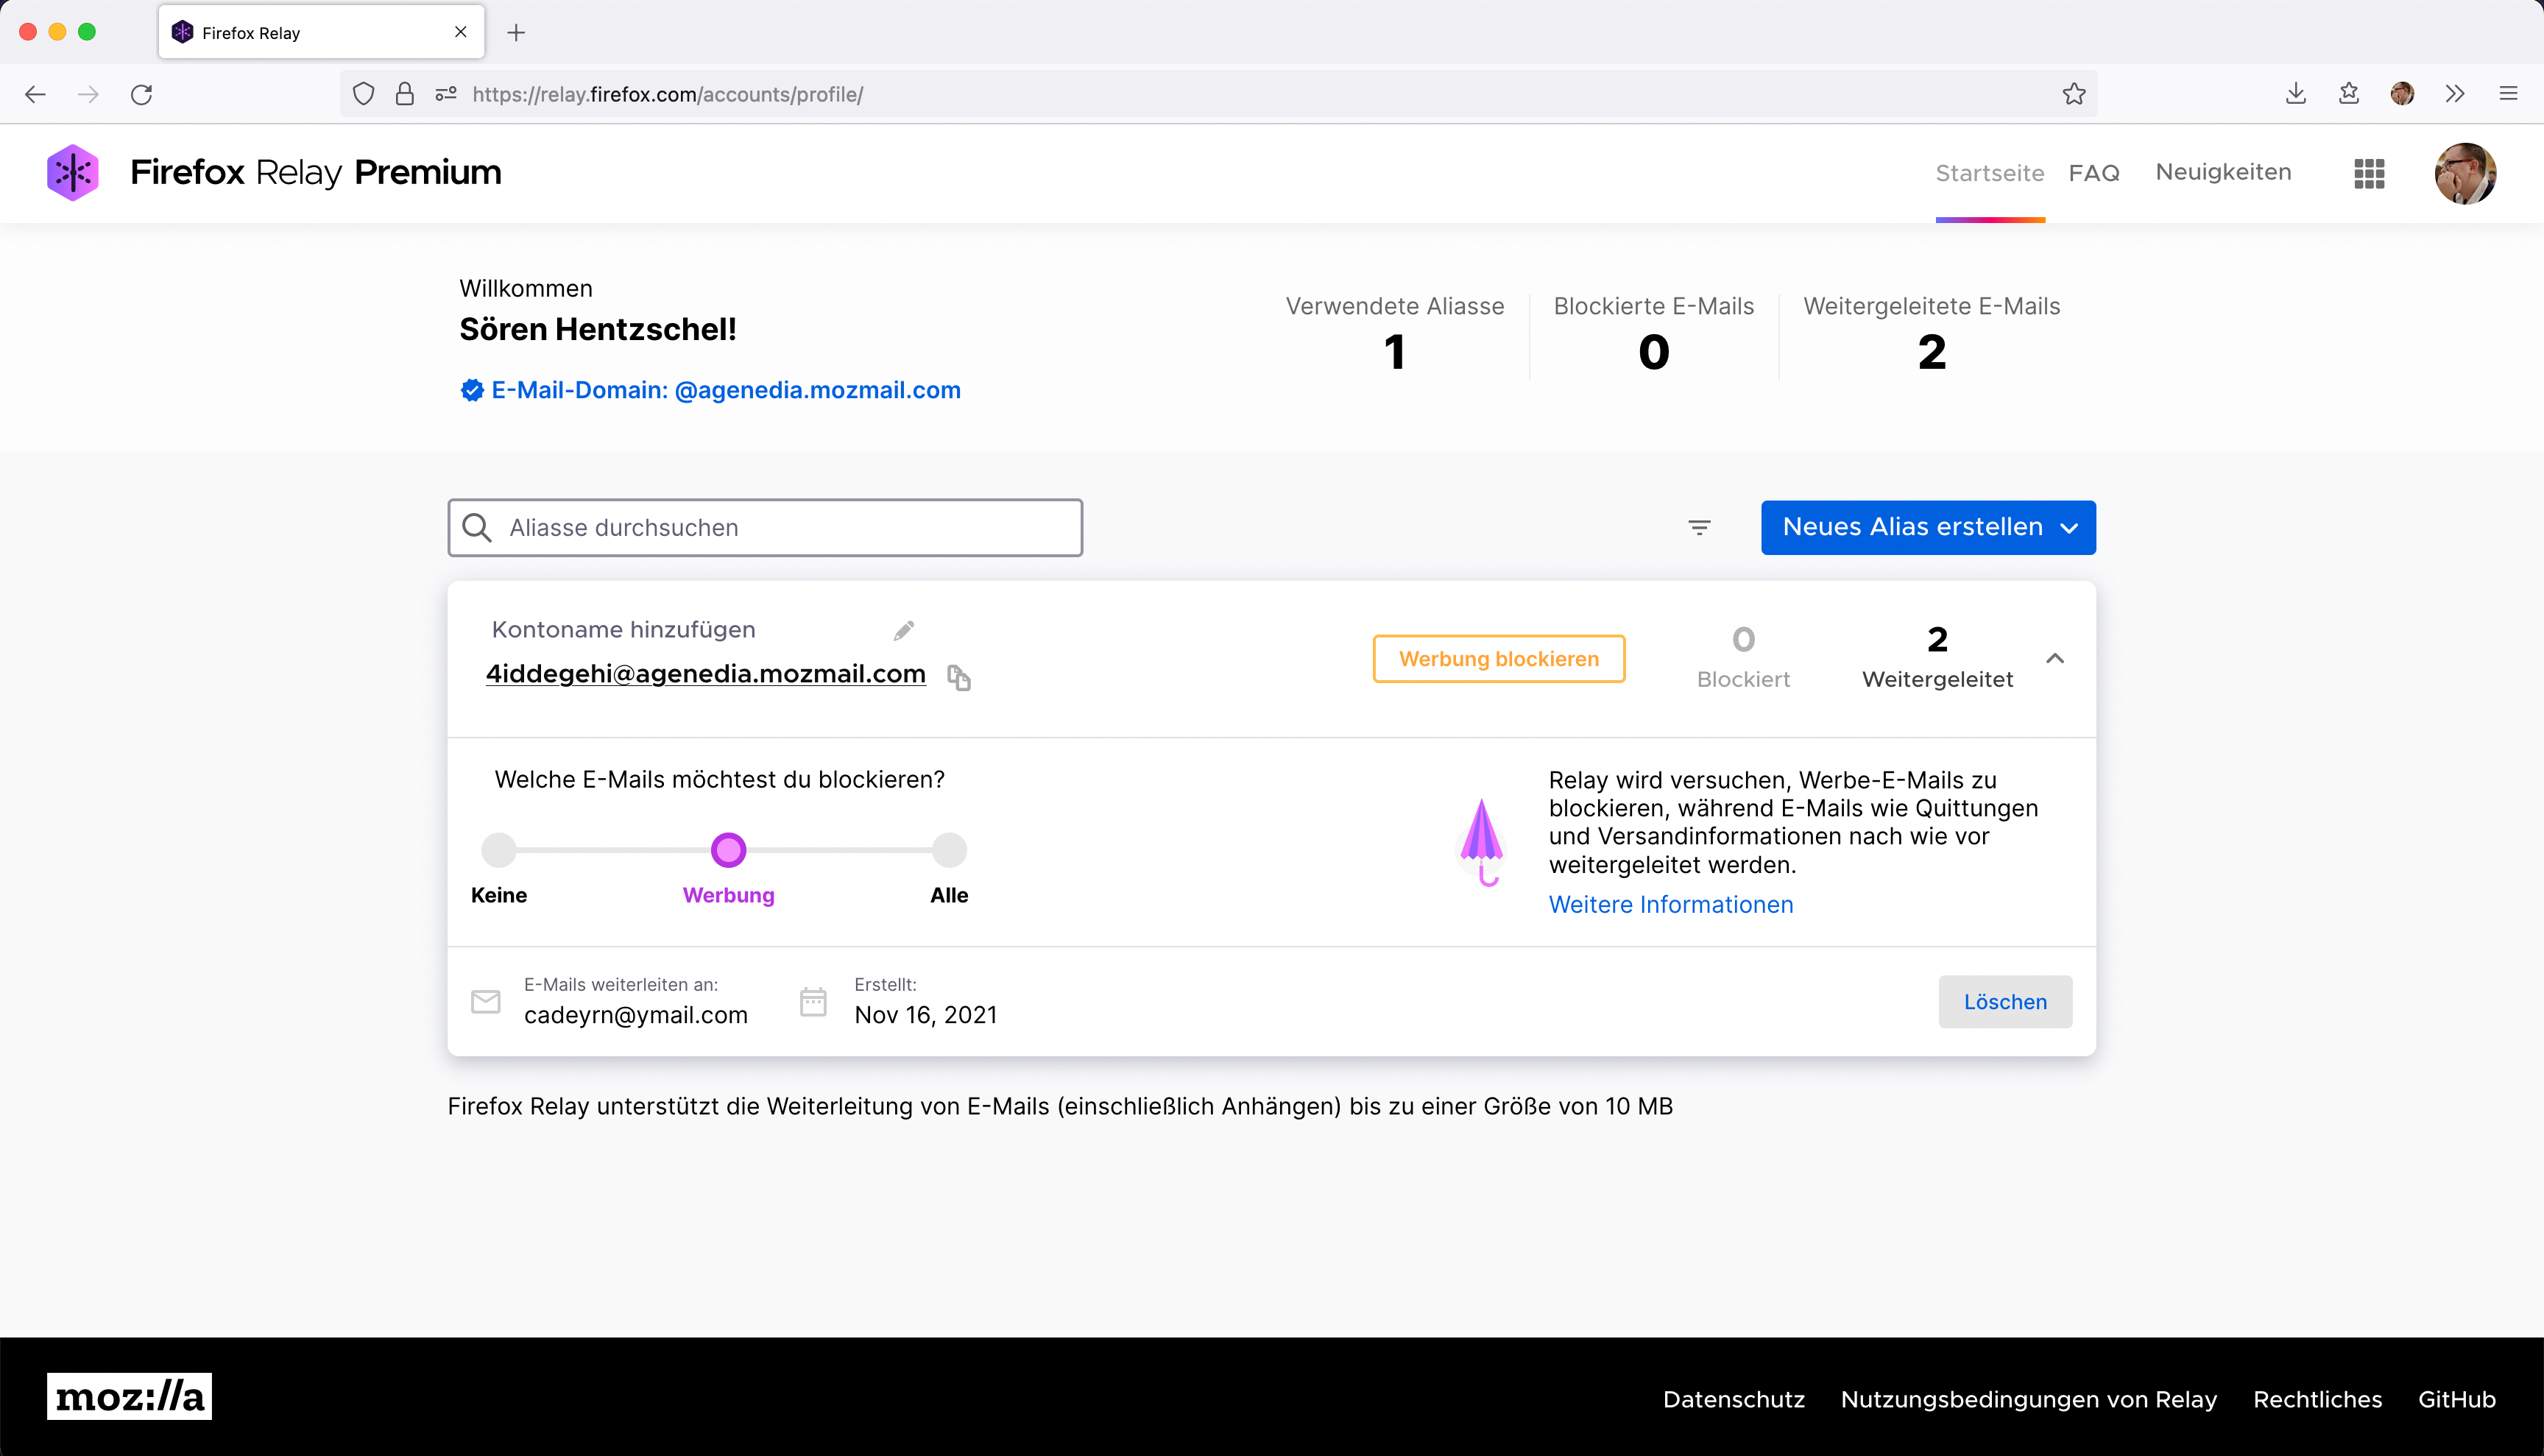
Firefox Relay Premium hat eine neue Option erhalten, über welche individuell pro Alias konfiguriert werden kann, ob alle E-Mails zugestellt, alle E-Mails blockiert oder lediglich E-Mails zu Werbezwecken blockiert werden sollen, während alle anderen E-Mails weiterhin zugestellt werden.

Firefox Relay Premium Werbeblocker

Firefox Relay für Google Chrome

Während Firefox Relay als Dienst natürlich grundsätzlich unabhängig von einem Browser ist, gibt es eine Browser-Erweiterung für Firefox, welche bei der Verwendung der Alias-Adressen unterstützt, indem zum Beispiel direkt über das E-Mail-Feld eines Webformulars eine neue Alias-Adresse angelegt werden kann. Ab sofort gibt es von Mozilla auch eine entsprechende Erweiterung für Google Chrome.

Der Beitrag Firefox Relay: Höheres Limit, Werbeblocker, Chrome-Erweiterung erschien zuerst auf soeren-hentzschel.at.

10. März 2022

Die MZLA Technologies Corporation hat mit Thunderbird 91.7 ein planmäßige Update für seinen Open Source E-Mail-Client veröffentlicht.

Neuerungen von Thunderbird 91.7

Mit dem Update auf Thunderbird 91.7 hat die MZLA Technologies Corporation ein planmäßiges Update für seinen Open Source E-Mail-Client veröffentlicht und behebt damit aktuelle Sicherheitslücken. Darüber hinaus bringt das Update diverse Fehlerbehebungen der Versionsreihe 91, welche sich in den Release Notes (engl.) nachlesen lassen.

Der Beitrag Thunderbird 91.7 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

Do, 10. März 2022, Stephan Schultze

DietPi ist eine leichtgewichtige, Debian basierte Linux-Distribution für Einplatinencomputer und Serversysteme, welche auch die optionale Desktopumgebungen anbietet. Sie wird als minimales System bereitgestellt, erlaubt jedoch die Installation kompletter und nutzungsfertiger Softwarepakete mittels Konsolen-basierten Shell Dialogen und Skripten.


Der Quellcode ist auf GitHub bereitgestellt: https://github.com/MichaIng/DietPi
Die DietPi Webseite finden Sie unter: https://dietpi.com/

Die Highlights dieser Version sind:

  • Neue Images für virtuelle Maschinen unter VMware ESXi/vSphere, Proxmox, UTM sowie Hardkernel's Odroid C4/HC4 Einplatinencomputer wurden veröffentlicht.
  • Die Kubernetes-Plattform MicroK8s von Canonical wurde als Software-Option hinzugefügt.
  • Die audiophile Weboberfläche von Allo.com für Raspberry Pi und Sparky SBC hat ein umfangreiches Upgrade erhalten. Dabei wurden viele Probleme und Sicherheitsaspekte behoben und die zugrunde liegenden Laravel-Abhängigkeiten auf die neuesten Versionen aktualisiert.
  • Die Benutzer werden nun darauf hingewiesen, wenn ein Neustart erforderlich ist, um ein aktuelles Kernel-Upgrade abzuschliessen, wodurch sichergestellt wird, dass Software-Installationen und andere System-Wartungsaufgaben bei Bedarf Kernelmodule laden können.

Die kompletten Versionshinweise finden Sie unter: https://dietpi.com/docs/releases/v8_2/

9. März 2022

Mi, 9. März 2022, Fabian Schaar

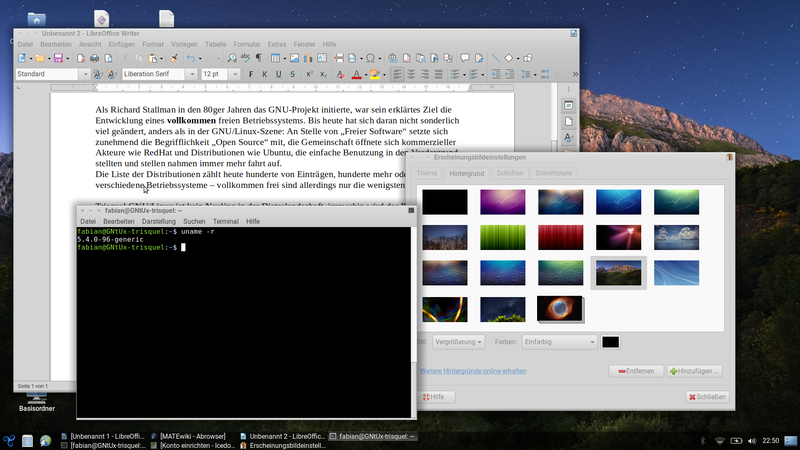
Im Dschungel der vielen, vielen GNU/Linux-Distributionen finden sich nur sehr wenige, die den Idealen freier Software vollkommen konsequent entsprechen. Die Free Software Foundation informiert auf ihrer Website über die Abwandlungen des Betriebssystems, die dem Gedanken freier Software am nächsten kommen. Eine dieser Distributionen ist Trisquel GNU/Linux.

Als Richard Stallman in den 80er Jahren das GNU-Projekt initiierte, war sein erklärtes Ziel die Entwicklung eines vollkommen freien Betriebssystems. Bis heute hat sich daran nicht sonderlich viel geändert, anders als in der GNU/Linux-Szene: An Stelle von „Freier Software“ setzte sich zunehmend die Begrifflichkeit „Open Source“ durch; die Gemeinschaft öffnete sich kommerzieller Akteure wie RedHat und Distributionen wie Ubuntu, die einfache Benutzung in den Vordergrund stellten und stellen nahmen immer mehr Fahrt auf. Die Liste der Distributionen zählt heute hunderte von Einträgen, hunderte mehr oder minderverschiedene Betriebssysteme – vollkommen frei sind allerdings nur die wenigsten.

Trisquel GNU/Linux ist kein Neuling in der Distro-Landschaft, immerhin wird das Projekt schon seit 2007 entwickelt – während die erste Version noch auf Debian 4 aufsetzte, wechselte das Projekt relativ schnell zur Ubuntubasis. In dieser Hinsicht scheint Trisquel die Einfachheit und Nutzerfreundlichkeit von Ubuntu mit der konsequenten Umsetzung der Ideale freier Software kombinieren zu wollen. Die randvollen Repositories mit einer Aktualität auf dem Stand von Ubuntu 20.04 LTS veranlassten mich dazu, dem Projekt eine Chance zu geben – nicht nur auf einer virtuellen Maschine, sondern auf echter Hardware.

Kurzerhand habe ich also meine wichtigsten Dateien zusammengepackt, einen Livestick mit Trisquel GNU/Linux erstellt und installiert. Die Installation war hierbei wirklich einfach, immerhin setzt Trisquel standardmäßig auf den Ubiquity-Installer von Ubuntu. Nach der Installation begrüsst Trisquel neue Nutzer*innen mit einem doch sehr ansprechenden Desktop, standardmäßig ist das Mate. Mit seinem dicken Panel schafft die Distro eine praktische Oberfläche, natürlich nichts Extravagantes; aber doch praktisch. Wer die voreingestellten Pastellfarben des leicht angepassten Greybird-Themas („Trisquel“) nicht mag, kann neue installieren oder die CSS-Dateien der Themen anpassen. Trisquel bedient sich bekannter und beliebter Konzepte, schafft ein angenehmes Nutzungserlebnis und tauscht seine Ideale nicht gegen Bequemlichkeit.

Die Entwicklung des Betriebssystems kann als Dekommerzialisierung Ubuntus zugunsten der Freiheit der Nutzer*innen gesehen werden: Das Projekt stützt sich auf die Community und deren Spenden und ist organisiert als Non-Profit-Organisation.

Eine Besonderheit ist, wie oben schon erwähnt, die Auswahl der Software. Anstatt des Browsers Firefox kommt dessen augenscheinliche Abwandlung „Abrowser“ daher, aktuell in Version 97. Mozillas Thunderbird wird ersetzt durch IceDove, diese Bezeichnung könnte alt eingesessenen Debian-Nutzer*innen bekannt vorkommen. Was die Nutzung auswirkt, ergeben sich durch die Abwandlungen kaum merkliche Unterschiede.

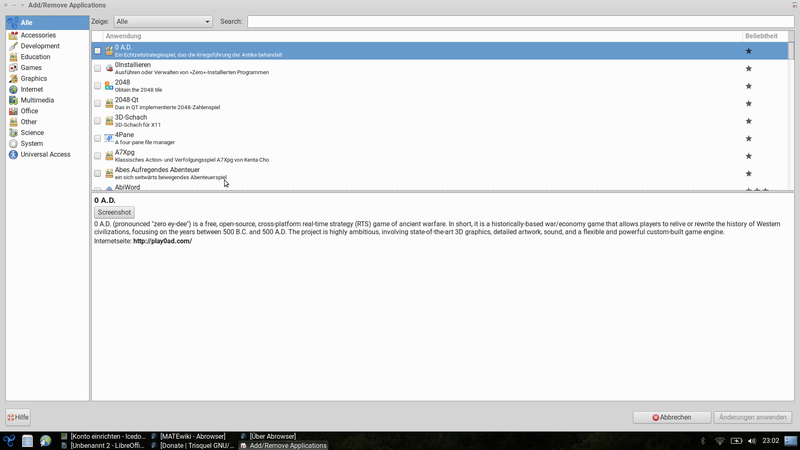
Bemerkenswert finde ich den Appstore, den Trisquel mitbringt: Hier haben die Distributor*innen eine angenehme, grafische Oberfläche zu schaffen. Über die Anwendung lassen sich leicht klassische .deb-Pakete aus den Repos installieren. Flatpak und Ubuntus Snap sind nicht vorinstalliert.

Die Softwareverwaltung ist gewohnt einfach, sie entspricht dem Standard bei debianbasierten Systemen. Wegen der geringen Verbreitung der Distro sind die Mirrors etwas weit entfernt und standardmäßig etwas behäbig, zumindest im deutschsprachigen Raum, wirklich schlimm ist das nicht.

Trisquels Alleinstellungsmerkmal ist und bleibt der besondere Fokus auf der Freiheit der Software. In der Folge werden keinerlei unfreie Anwendungen, Treiber usw. unterstützt. Um das WLAN auf dem Laptop zum Laufen zu kriegen, musste ich daher über die iwlwifi-firmware als .deb über Gdebi installieren. Hier ist Trisquel allerdings auch nicht sonderlich anders als die offizielle Ausgabe von Debian, die auch keine unfreien Pakete beinhaltet.

Meinen ersten Eindrücken zufolge ist Trisquel eine der vollkommen freien Distros, die verhältnismässig leicht genutzt werden können. Die Mission, die das Projekt im Sinne freier Software verfolgt, ist in der unübersichtlichen GNU/Linux-Szene doch bemerkenswert.

Sicher fragen sich jetzt die ein oder anderen, warum eine solche Distro überhaupt genutzt werden sollte, wenn man am Ende doch auf unfreie Firmware für das WLAN angewiesen ist. Diese Frage ist natürlich gerechtfertigt. Und doch sehe ich digitale Rechte mit Trisquel besser verteidigt als mit anderen GNU/Linux-Varianten, besser als bei denen, die gerne mal auf das„GNU“ im Namen verzichten. Trisquel hat sich als Projekt der freien Desktop-Software verschrieben, hat also ein konkretes Ziel. Bei anderen ist das nur eine Nebensache.

Meiner Ansicht nach kann es nicht schaden, wenn unfreie Software aus dem System so gut wie es geht fern gehalten wird. Weitere Beispiele, wo das Konzept gut aufgeht, sind Abrowser und IceDove. Allen, die auf unfreie Software verzichten wollen und können, kann ich Trisquel ans Herz legen. Zumindest in einer virtuellen Maschine ist das Ganze einen Versuch wert.

Trisquel erhält die Vision des GNU-Betriebssystems aufrecht. Eine Vision, die nicht vergessen werden sollte. Die Vision, dass sich die Anwender*innen von Software selbst befreien können.

Quelle: https://trisquel.info/de

8. März 2022

Di, 8. März 2022, Lioh Möller

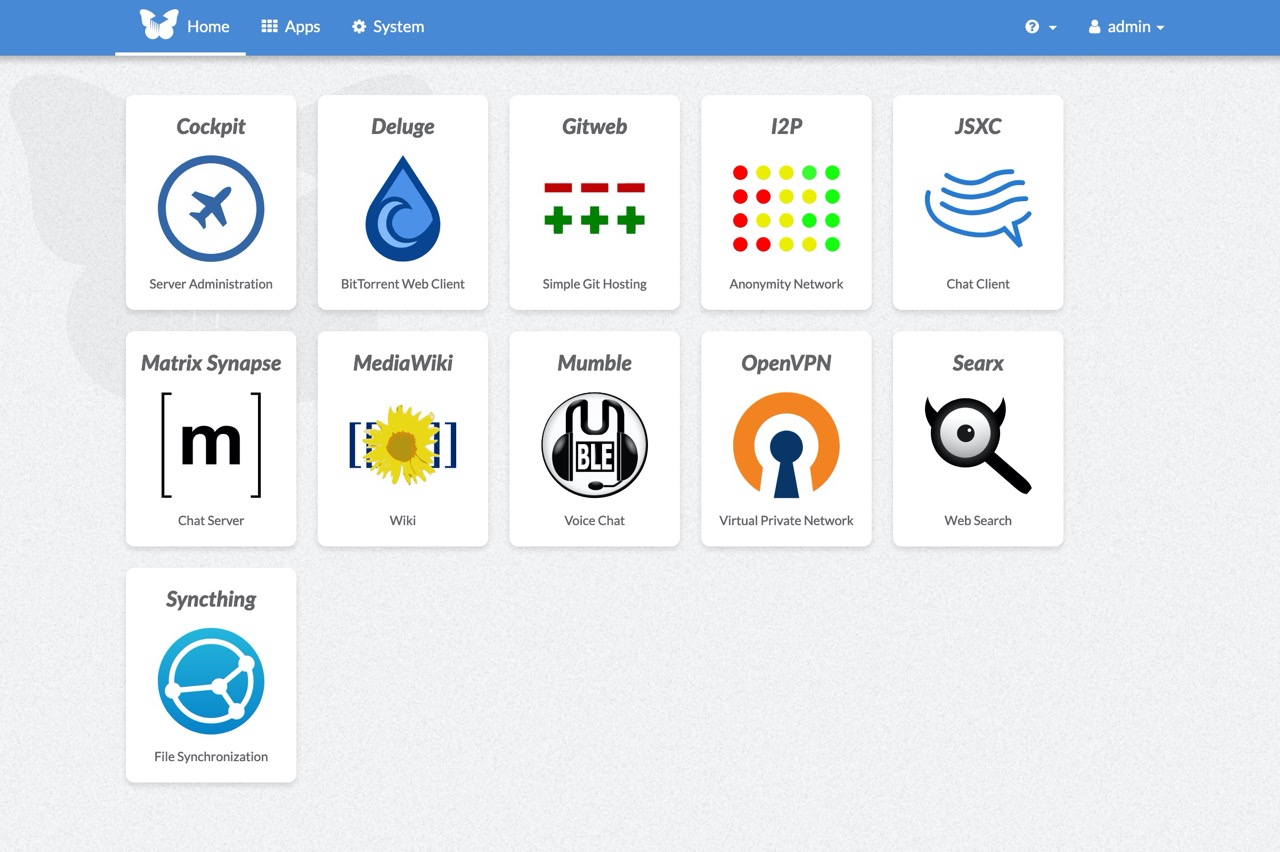
Das FreedomBox Projekt hat neue Images für die Nutzung auf Raspberry Pi Geräten bereitgestellt. Bisher war eine Installation von FreedomBox auf dem Raspberry Pi 4 nur über Umwege mithilfe des allgemeinen arm64 Images möglich.

Die neuen Abbilder eignen sich für Raspberry Pi 3B, Raspberry Pi 3B+ und Raspberry Pi 4B und sind für die arm64 Architektur optimiert worden. Sie beinhalten die Raspberry Pi Boot- und Wi-Fi-Firmware. Während der Einrichtung wird automatisch ein WLAN-Netzwerk konfiguriert, was den Zugriff auf die FreedomBox zur Einrichtung deutlich vereinfacht.

Ankündigung: https://discuss.freedombox.org/t/new-64-bit-images-for-raspberry-pi-3b-3b-and-4b/1971
Download: https://freedombox.org/download/

Da ich tmux (Alternative zu screen) sehr häufig benutze, nutze ich auch bei remote ssh logins einen Befehl, der mich nach dem erfolgreichen Login gleich in eine detachte tmux session bringt.

ssh -l -p -t "tmux a"

Da ich tmux (Alternative zu screen) sehr häufig benutze, nutze ich auch bei remote ssh logins einen Befehl, der mich nach dem erfolgreichen Login gleich in eine detachte tmux session bringt.

ssh -l -p -t "tmux a"

Da ich tmux (Alternative zu screen) sehr häufig benutze, nutze ich auch bei remote ssh logins einen Befehl, der mich nach dem erfolgreichen Login gleich in eine detachte tmux session bringt.

ssh -l <USERNAME> <HOST> -p <PORT> -t "tmux a"

Weitere Artikel zu tmux

  1. tmux – neues Fenster oder Pane im aktuellen Verzeichnis öffnen
  2. tmux ein Windowmanager für die Konsole
  3. Live-Anzeige der Webserver-Client Verbindungen
  4. Eine tmux.conf Konfiguration

The post Beim ssh login tmux aufrufen first appeared on Dem hoergen Blog.

7. März 2022

Herzlich Willkommen zu Teil 4 meines Wochenend-Projekts „Nextcloud im Container“. Diesem gingen die folgenden Teile voraus:

  1. Der Plan
  2. Die Ansible-Rolle
  3. NGINX als Reverse-Proxy

Nach Teil 3 habe ich die Zwei-Faktor-Authentisierung über TOTP für meine Nutzerkonten aktiviert, die Bookmark-, Calendar- und Contact-App installiert bzw. aktiviert, ein paar Kalendertermine erstellt und ein paar Dateien hochgeladen. Nichts Wichtiges. Lediglich ein paar Daten, die ich nach einem Backup zerstören kann, um anschließend den Restore-Prozess zu testen. Zuvor möchte ich aber noch ein paar Dinge festhalten, die mir bisher aufgefallen sind.

Background jobs: Cron does not run

In den Grundeinstellungen der Nextcloud werden Hintergrund-Aufgaben konfiguriert. Diese sind laut des dortigen Hinweises wichtig, um die optimale Geschwindigkeit zu erreichen:

Um die optimale Geschwindigkeit zu erreichen ist es wichtig, dass die Hintergrund-Aktivitäten richtig konfiguriert sind. Für größere Installationen ist ‚Cron‘ die empfohlene Einstellung. Weitere Informationen findest Du in der Dokumentation.

Grundeinstellungen in den Nextcloud-Einstellungen

Die Überschrift ist der Titel des GitHub-Issues #1695. Dieser beschäftigt sich damit, dass Cron in der Container-Instanz nicht läuft. Halt genau so, wie Cron dies bei mir auch nicht tut.

Der Benutzer beryl03, welcher den Issue eröffnet hat, beschreibt, dass Cron in der Container-Instanz nicht verfügbar ist und er in der Dokumentation keinen Hinweis darauf gefunden hat. Um das Problem zu mitigieren hat beryl03 einen Cronjob auf seinem Container-Host konfiguriert, welcher sich mit der Container-Instanz verbindet und darin die Datei cron.php ausführt. Welch elender Workaround. Aber immerhin gibt es einen. Denn die Hintergrund-Aufgaben mit AJAX auszuführen, scheitert leider ebenfalls. Schade, so habe ich mir das tatsächlich nicht vorgestellt.

Im Verlauf von Issue #1695 wird darauf hingewiesen, dass zur Verwendung von Cron ein weiterer Container benötigt wird (siehe [3]). Dies wird in den Beispielen zu den Compose-Dateien beschrieben (siehe [4]). Da ich Podman und Ansible statt Docker-Compose verwende, habe ich mir diese Beispiele natürlich nicht angesehen. Das ist dem Projekt nicht anzulasten, da ich mich ja bewusst für einen anderen Weg entschieden habe. Doch denke ich, dass man das Thema Hintergrund-Aufgaben innerhalb der Projekt-Dokumentation als auch in der Nextcloud-Dokumentation etwas ausführlicher behandeln könnte und sollte. Doch wie gehe ich nun mit dem Problem um, dass meine Hintergrund-Aufgaben nicht ausgeführt werden?

Docker-Compose mit Podman nutzen

Tatsächlich habe ich einen Artikel gefunden, welcher beschreibt, wie man Docker-Compose ab Podman 3.0 nutzen kann. Allerdings bietet dieser nur eine Lösung für den Fall, dass man Podman als User root bzw. mit Root-Rechten ausführt. Da Podman bei mir rootless läuft, kommt die Lösung für mich nicht in Frage.

Nach etwas weiterer Recherche habe ich einen RFE gefunden, welcher diese Funktionalität auch für rootless-Podman fordert. Die gute Nachricht lautet, dass diese Funktion mit Podman 3.2 veröffentlicht wurde. Pech für mich, dass unter Debian stable lediglich Podman 3.0.1 in den Quellen verfügbar ist.

Ein Workaround ist besser als gar keine Lösung

Tatsächlich erscheint mir aktuell der Workaround von beryl03 (siehe [1]) der beste Weg zu sein, um die Hintergrund-Aufgaben ausführen zu lassen. Dazu führe ich auf meinem Container-Host folgenden Befehl aus:

$ podman exec -u 33 -t nextcloud php -f /var/www/html/cron.php

Damit wird das Skript cron.php innerhalb der Container-Instanz mit der Nextcloud ausgeführt. Mit -u 33 wird die UID von www-data innerhalb der Container-Instanz angegeben. Für eine genaue Erklärung des Befehls und seiner Optionen siehe podman-exec(1).

Hintergrund-Aufgaben wurden erfolgreich ausgeführt.
Die Hintergrund-Aufgaben wurden nun erfolgreich ausgeführt

Da ich nicht gern lange Befehle in die Crontab schreibe, erstelle ich ein kurzes Skript namens nextcloud_cron.sh, welches obigen Befehl aufnimmt und welches ich alle 5 Minuten von Cron ausführen lasse. Damit werde ich sich noch sehr lange arbeiten, denn nicht umsonst sagen manche: „Nichts hält so lange, wie ein gutes Improvisorium.“

Fazit von Teil 4

Ich hoffe, die Artikelserie hat euch bis hierhin ein wenig unterhalten. Wer nach einer einfachen Lösung gesucht hat, bei der man ein bis zwei Container-Images aus dem Regal nimmt, ein paar Variablen mit Werten füllt, sie auf einen Container-Host provisioniert, ausführt und fertig ist, wird sicher gemerkt haben, dass er diese Lösung in dieser Artikelreihe nicht findet.

Auch ich habe mir zu Beginn nicht vorgestellt, dass es so hakelig werden würde. Schließlich soll mit Containern doch alles einfacher werden, nicht wahr? Warum mache ich also weiter und lasse das ganze Wochenend-Projekt nicht einfach fallen? Neugier, Sturheit, eine nutzbare Nextcloud-Instanz und auch ein bisschen Spaß bilden die Antwort auf vorstehende Frage. Und deshalb mache ich auch weiter. In Teil 5 wird es um Backup und Restore gehen.

Wie betreibt ihr eure Nextcloud? Mit Container oder ohne? Unter Docker, K3s, K8s, Podman, OpenShift oder einer noch ganz anderen Lösung? Lasst es mich gern in den Kommentaren wissen. Habt ihr über eure Erfahrungen in eurem eigenen Blog geschrieben, lasst mir gern einen Link hier. Macht es gut, bis nächste Woche.

Quellen und weiterführende Links

  1. Background jobs: Cron does not run #1695
  2. AJAX Background Jobs Fail After a Period of Inactivity #1442
  3. https://github.com/nextcloud/docker/issues/1695#issuecomment-1042602441
  4. https://github.com/nextcloud/docker/blob/master/.examples/docker-compose/insecure/mariadb/apache/docker-compose.yml
  5. Using Podman and Docker Compose. Podman 3.0 now supports Docker Compose to orchestrate containers. Enable Sysadmin. 2021-01-07.
  6. [RFE]Make docker-compose work with rootless podman #9169