staging.inyokaproject.org

2022 Woche 35

1. September 2022

Die MZLA Technologies Corporation hat mit Thunderbird 102.2.1 ein Update außer der Reihe veröffentlicht. Dabei handelt es sich um ein wichtiges Sicherheits-Update. Nutzern wird empfohlen, ihren E-Mail-Client schnellstmöglich zu aktualisieren.

Neuerungen von Thunderbird 102.2.1

Mit dem Update auf Thunderbird 102.2.1 hat die MZLA Technologies Corporation ein Update für seinen Open Source E-Mail-Client veröffentlicht. Das Team empfiehlt bestehenden Nutzern ausdrücklich, das Update so schnell wie möglich zu installieren, da dieses wichtige Sicherheitskorrekturen beinhaltet.

Darüber hinaus bringt Thunderbird 102.2.1 auch wieder einige Fehlerbehebungen und Verbesserungen unter der Haube, welche sich in den Release Notes (engl.) nachlesen lassen.

Der Beitrag MZLA veröffentlicht wichtiges Sicherheits-Update Thunderbird 102.2.1 erschien zuerst auf soeren-hentzschel.at.

31. August 2022

Heute eine Nachricht in eigener Sache. Während immer mehr Nachrichtenportale sukzessive ihre RSS-Angebote einstellen, erlebt momentan ein Medium, das fundamental darauf aufbaut, einen kometenhaften Aufstieg in der Breite: der Podcast. Technisch handelt es sich dabei um eine Erweiterung des RSS-2.0-Standards und ermöglicht, dass der ein und selbe Inhalt an verschiedene Podcatcher, also Podcast-Clients, ausgespielt wird. Zunehmend übernehmen Streaming-Plattformen wie Spotify das Konzept und führen eigene Verzeichnisse hierfür ein.

Der Podcast ist in der Medienlandschaft längst angekommen und entwickelt sich zu einem beliebten Gesprächsformat. Es gibt bereits Stimmen, die ihn schon als Nachfolger des Blogs sehen. Besonders trenden Themen zu Politik, Wirtschaft, aber auch Technologie. Eine nicht zu unterschätzende Nische ist dabei die IT-Sicherheit – und diese Nische möchte ich in meinem neusten Projekt füllen.

Mein neuer Podcast „Risikozone“ geht ab morgen, dem 01. September 2022 an den Start und beschäftigt sich u. a. mit den Themen IT-Sicherheit, Open-Source-Software und Künstliche Intelligenz bzw. Maschinelles Lernen. Im Podcast kann ich endlich die Themen behandeln, die zu lang für einen Blogartikel, aber zu kurz für ein Video/-kurs sind, oder gar nicht in die beiden Kategorien passen. Es geht auch um Grundlagenthemen der Kryptographie, Computerkommunikation und des Datenschutzes sowie um aktuelle Nachrichten aus diesen Bereichen. Die Zielgruppe liegt in der Breite: es geht darum, IT zu vermitteln. Aus diesem Grund werden die technisch tiefgreifenden Themen weiterhin im Blog behandelt, während im Podcast weitere Themen Einzug finden können.

Pro Monat sollen mindestens zwei ca. 20 bis 45 Minuten lange Episoden enstehen, die dann über unterschiedlichste Wege abrufbar sind. In den Folgen werden entweder Gäste dabei sein oder ich werde alleine Schwerpunktthemen vorstellen.

Um den Podcast zu abonnieren, gibt es verschiedene Möglichkeiten: da heutzutage die Plattformökonomie auch bei Podcasts angekommen ist, möchte ich hier Spotify und Apple Podcasts erwähnen, bei weiteren Plattformen folgt die Listung in Kürze. Der Feed des Podcasts ist unter https://risikozone.de/feed/mp3/ erreichbar. Weitere Informationen und Aktualisierungen sind auch auf der entsprechenden Seite verfügbar.

Morgen Vormittag werden die beiden ersten Episoden veröffentlicht, in denen es um das Thema E-Mail-Sicherheit geht. Eine Trailerepisode 0 ist bereits jetzt schon verfügbar. Wie es dann weitergeht, könnt ihr mit eurem Feedback auch mitentscheiden. Gefällt es euch, habt ihr Themenvorschläge oder Anmerkungen? Das alles könnt ihr an info@risikozone.de schicken.

Darüber hinaus könnt ihr gerne, wenn euch der Podcast gefällt, euren Freunden und eurer Familie davon erzählen oder ihn auf Spotify und/oder Apple Podcasts bewerten und uns dort folgen.

Zur üblichen Arbeit eines Systemadministrators gehört der Umgang mit persistentem Speicher (a.k.a. Festplatte), der heutzutage in Form von HDDs, SSDs oder auch NVMes daherkommt. Üblicherweise werden in Produktivsystemen die Platten in einem RAID angeordnet, um bei einem Festplattenausfall die Verfügbarkeit des Systems zu erhöhen. Soll in diesem Zusammenhang allerdings eine Festplatte vor einem drohenden Ausfall manuell aus dem RAID entfernt werden, ist es ratsam, sie vorher sicher zu löschen. In diesem Artikel möchte ich allerdings kurz umschreiben, warum der Hinweis, Backups vor jeglicher Formatierung zu erstellen, so wichtig ist - besonders bei NVMe-Speichern.

Um die gleich folgende Syntax zu verstehen, sei noch gesagt, dass unter Linux ein bestimmtes Schema existiert, wie Festplatten oder eben NVMes angesprochen werden. Bei SCSI- bzw. SATA-Platten kennt man z. B. /dev/sda für die erste erkannte SATA-Festplatte (= sd für den Treiber und a für die Platte) und /dev/sda3 für die dritte Partition (= 3) auf der ersten erkannten SATA-Festplatte. Wichtig ist, dass "erste erkannte Festplatte" genau so relativ verstanden werden muss, wie es klingt. Wird, aus welchem Grund auch immer, eine andere Festplatte zu erst erkannt und ist die Buchstabenzuweisung nicht persistiert, ändert sich über mitunter auch die Zuweisung. Nicht ohne Grunde werden Linux-Nutzer angehalten, mit UUIDs eindeutig identifizierbare Bezeichner für ihre /etc/fstab zu nutzen.

Bei NVMe ist das scheinbar ähnlich, auch wenn es hier einen Zusatz gibt. Eine Partition auf einem NVMe-Gerät, das alleine in einem Rechner steckt (d. h. nur eine NVMe ist eingebaut) könnte /dev/nvme0n1p3 heißen. Hier bedeutet die Syntax, dass es sich um die dritte Partition (p3) auf dem ersten Namespace (n1) hinter dem Controller mit der Nummer 0, handelt, das über den NVMe-Treiber angesprochen wird. NVMes verfügen mit Namespaces über eine weitere Abstraktionsschicht, sodass der NVMe-Controller seinen Storage in Namespaces unterteilen kann, die jeweils über eine eigene Partitionstabelle verfügen.

Im administrativen Umgang arbeitet man oft mit mehreren Block-Devices, einerseits der "Platte selber", klassischerweise einer /dev/sda, und den Partitionen, also /dev/sda3. Bei NVMe ist die "Platte selber" in den allermeisten Fällen ein Namespace, also /dev/nvme0n1 und NICHT /dev/nvme0.

Es gibt allerdings ein Szenario, wo man mal den Controller direkt ansprechen muss: beim Kommando nvme format. Hier gibt es eine Syntax, wo als Argument das NVMe-Device, also der Controller, angesprochen und der Namespace per Option übergeben wird. Ich durfte nun erleben, wie das sehr, sehr schiefgehen kann.

Wer nämlich glaubt, dass man von /dev/nvme1n1 auf den Controller /dev/nvme1 schließen kann, irrt sich gewaltig. Diese beiden Bezeichner haben streng genommen nichts miteinander zu tun. Und so kann es dazu führen, dass wenn

  • man zwei NVMe-Devices hat
  • /dev/nvme1n1 behalten und
  • /dev/nvme0n1 mittels nvme format /dev/nvme0 -n 1 löschen möchte,

man sich potenziell den Boden unter den Füßen wegzieht und die eigentlich zu behaltende NVMe löscht - was nach der Formatierung mit der netten Fehlermeldung bash: <executable>: cannot execute binary file: Exec format error quitiiert wird, wenn man das nächste Kommando in der Bash aufrufen will.

Der Zusammenhang wird zwischen /dev/nvmeX und /dev/nvmeYn1 nämlich - NVMe Multpathing sei dank - dynamisch gewählt. Und ich bin nicht der einzige, dem das aufgefallen ist. Normalerweise hängen die Bezeichner zusammen, aber wenn man beim Tausch der NVMes zwischendurch Reboots durchführen muss, kann sich die Reihenfolge schon mal verdrehen - aber eben nur halb.

Und so muss man manuell nachprüfen, welches Device wirklich hinter dem Block-Device eines Namespaces steckt:

me@server:~$ ls -l /sys/block/nvme1n1/device
lrwxrwxrwx 1 root root 0 Aug 31 19:43 /sys/block/nvme1n1/device -> ../../nvme0

In diesem Fall steckt hinter /dev/nvme1n1 das Device /dev/nvme0. Muss man beachten.

Dies hat übrigens nicht nur auf das Formatieren Auswirkungen: auch die SMART-Überwachung zeigt für /dev/nvme0n1 und /dev/nvme0 völlig unterschiedliche Resultate an. An dieser Stelle ist mir übrigens erst aufgefallen, dass der Zusammenhang zwischen den Devices mitunter nicht-systematisch gewählt werden könnte.

Was lernen wir daraus? Neue Treiber, wie in unserem Fall nvme, bringen neue Herausforderungen mit. Es ist gut, sich jedes Mal, wenn man seine Produktivsysteme mit neuen Fähigkeiten ausstattet, mit der Dokumentation und dem Standard hinter dem Treiber zu beschäftigen. Darüber hinaus - und das ist noch viel wichtiger - sollte man jederzeit auf seine Backups als zusätzliches Sicherheitsnetz achten, weil es immer etwas geben wird, was man übersieht. In meinem Fall hatte ich Glück, weil der betroffene Server aus der Testumgebung stammte und das Formatieren der falschen Platte nur vernachlässigbare Auswirkungen hätte - ich bin aber froh, auf diesem Umstand aufmerksam geworden zu sein und wollte euch an dieser Stelle einfach "vorwarnen".

Mi, 31. August 2022, Lioh Möller

Ähnlich wie es bei KDE Plasma bereits seit einiger Zeit der Fall ist, möchte nun auch das GNOME Projekt Telemetriedaten erheben, um die Software langfristig zu verbessern.

Dazu hat der Entwickler Vojtech Stanek im Rahmen eines Interships bei Red Hat eine Anwendung namens gnome-info-collect veröffentlicht. Pakete stehen bereits für unterschiedliche Distributionen wie Fedora, Ubuntu, Arch Linux und openSUSE zur Verfügung.

Aktuell sammelt und übermittelt das Programm unter anderem:

  • Hardware-Informationen, einschliesslich Hersteller und Modell.
  • Verschiedene Systemeinstellungen, wie die Workspace-Konfiguration und welche Freigabefunktionen aktiviert wurden.
  • Anwendungsinformationen, z. B. welche Anwendungen installiert sind und welche bevorzugt werden.
  • Welche GNOME-Shell-Erweiterungen installiert und aktiviert wurden.

Eine vollständige Liste aller gesammelten Informationen findet man im README des Projektes.

Die übermittelten Daten werden anonymisiert und enthalten keine persönlichen Informationen. Vor dem Absenden werden alle Telemetriedaten aufgelistet und der Anwender muss der Übertragung aktiv zustimmen.

Quelle: https://blogs.gnome.org/aday/2022/08/25/help-improve-gnome/

29. August 2022

Mo, 29. August 2022, Lioh Möller

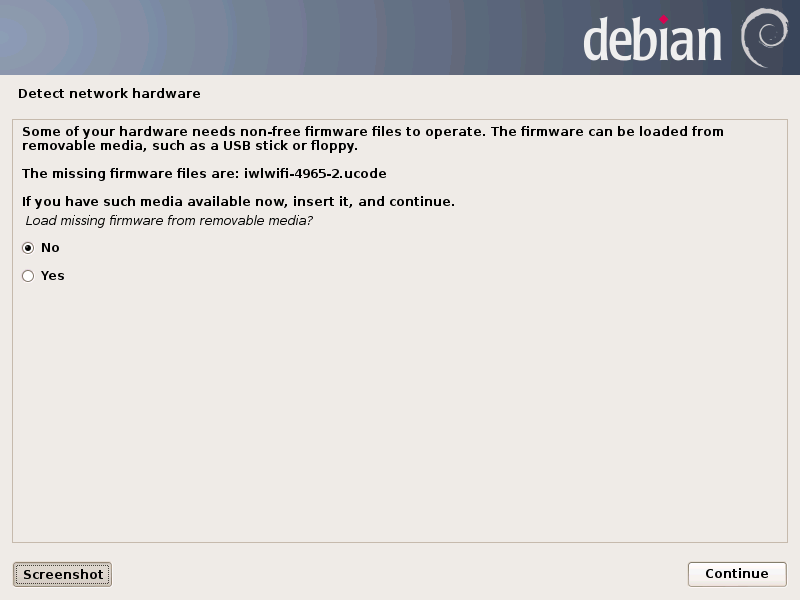
Das Debian Projekt liefert die hauseigene Distribution standardmässig ohne unfreie Firmwarekomponenten aus. Dies galt als klares Bekenntnis für Freie Software, auch wenn alternative Installationsmedien zur Verfügung standen, welche allerdings nicht aktiv beworben wurden.

Der Debian-Entwickler Steve McIntyre hatte bereits im April dieses Jahres dazu aufgerufen, das Thema neu zu diskutieren, da insbesondere Einsteiger sonst kaum in der Lage seien, die Distribution erfolgreich auf Hardware zu installieren, auf der beispielsweise der integrierte Netzwerkadapter ohne Binary Blobs nicht nutzbar ist.

Dies mündete nun in eine General-Resolution, dessen Diskussionsphase am 3. September 2022 endet. Sie besteht aus drei Varianten, wobei die erste eine Modifikation und einen vollständigen Ersatz der bisherigen Installationsmedien vorsieht. Die zweite Variante befürwortet die Erstellung von Installationsmedien mit unfreier Firmware unter Beibehaltung der bisherigen Medien. Für Einsteiger sollen die neu erstellten Abbilder prominenter ersichtlich sein, wobei die Images ohne Binary Blobs weiterhin angeboten werden sollen. In beiden Varianten soll bei einer Nutzung eines unfreien Installationsmediums automatisch das entsprechende Repository, welches die Firmware-Pakete enthält, auf dem Zielsystem aktiviert werden.

Variante 3 zielt darauf ab, Installationsmedien mit unfreien Komponenten anbieten zu können, den Anwender allerdings vor dem Download darüber zu informieren, was eine Nutzung dieser bedeuten würde. Medien ohne unfreie Firmware sollen in diesem Falle weiterhin gleichwertig beziehbar sein.

Aktuell erhält Variante 1 die meiste Unterstützung, was einen klaren Schritt in Richtung Unfreiheit bedeuten würde.

Damit würde mit Debian GNU/Linux eine weitere populäre Distribution den Weg in die Unfreiheit gehen, um Anwendern die Nutzung zu erleichtern. Somit würde eine wertvolle Chance zur Sensibilisierung und Information verloren gehen.

Mo, 29. August 2022, Lioh Möller

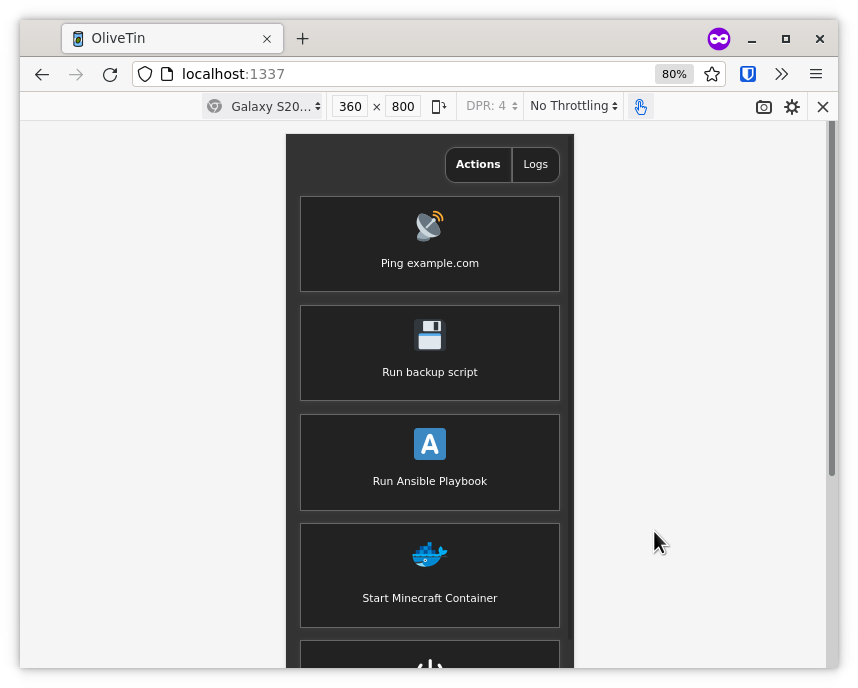
Zur Verwaltung von Linux und macOS Systemen über den Webbrowser eignet sich die Anwendung OliveTin, mit der auf sichere Weise vordefinierte Shell-Befehle ausgeführt werden können.

Dazu kann zunächst das bereitgestellte Paket im rpm oder deb Format heruntergeladen und installiert werden. Alternativ steht in Binary-Archiv oder der Quellcode zur Verfügung. Eine Nutzung in Docker oder Kubernetes ist ebenfalls möglich.

Die eigentliche Konfiguration erfolgt im YAML Format in der Datei /etc/OliveTin/config.yaml

Ein einfaches Beispiel sieht dabei wie folgt aus:

actions:
  - title: "Hello world!"
    shell: echo 'Hello World!'

Daraufhin kann der Dienst aktiviert und gestartet werden:

systemctl enable --now OliveTin

Ein Zugriff auf die Oberfläche ist standardmässig via http über Port 1337 möglich. Daher empfiehlt sich der Einsatz eines Proxy Servers wie NGINX Proxy Manager oder Traefik.

Die Web-GUI ist responsive und bietet einen Dark-Mode an.

Quelle: https://www.olivetin.app/
Dokumentation: https://docs.olivetin.app/index.html

Links meint in diesem Artikel insbesondere Lesezeichen (engl. Bookmarks), wie sie häufig im Webbrowser gespeichert werden. Und Shaarli (engl.) ist eine simple und schnelle Anwendung, um diese zu speichern, verwalten und teilen zu können.

In der Vergangenheit habe ich wiederholt Lösungen gesucht, um meine Lesezeichen im Webbrowser auf verschiedenen Geräten synchron zu halten. Bisher habe ich mich stets an einem oder mehreren der folgenden Punkte gestört:

  • Die Lösungen funktionierten nur mit einem Browser (z.B. Firefox oder Chrome)
  • Die Lösungen waren cloud-basiert. Ich möchte meine Links aber nach Möglichkeit nicht in einem Cloud-Dienst speichern.
  • Es mussten Browser-Plugins installiert werden, die mit der nächsten Browserversion nicht mehr funktionierten oder nach ein paar Monaten eingestellt wurden.
  • Man musste dazu Dienste hosten, von denen man 90 % der Funktionalität nicht genutzt hat.
  • Es funktionierte nie auf allen meinen Geräten.

Dabei ist es mir gar nicht wichtig, dass die Links synchronisiert werden. Ich möchte nur von all meinen Geräten auf die gleiche Sammlung zugreifen können. Eine umfangreiche und wachsende Linksammlung hier im Blog zu pflegen skaliert jedoch auch nicht. Und hier kommt Shaarli ins Spiel.

Nach eigener Darstellung kann Shaarli (engl.) genutzt werden, um:

  • interessante Links zu speichern, kommentieren und zu teilen.
  • von verschiedenen Computern und mobilen Geräten auf diese Links zuzugreifen.
  • als Microblog zu dienen.
  • als ToDo-Liste oder lese-ich-später-Liste zu fungieren.
  • eine Wissensdatenbank mit Notizen und Code-Schnipseln zu erstellen.
  • etc.

Ich selbst nutze Shaarli aktuell vorwiegend zum Speichen von Links, welche ich mit Titel, Beschreibung und Tags versehen und organisieren kann. Zusätzlich können Links als privat markiert werden, wodurch sie erst nach einem Login abrufbar sind.

Mir gefällt die einfache und schnelle Erfassung neuer Links. Die folgenden drei Screenshots veranschaulichen dies.

Shaarli add link dialog
HInzufügen eines Links zu Shaarli
Shaarli save dialog.
Hinzufügen von Titel, Beschreibung und Tags
Shaarli WebUI
So sieht der Link anschließend im WebUI aus

Die Projektdokumentation ist brauchbar und die Anwendung lässt sich ohne großen Aufwand auch selbst betreiben. Bei mir läuft sie unter Debian in einem rootless-Podman-Container (engl.).

Fazit

Schnelle und einfache Einrichtung der Anwendung sowie Erfassung von Links machen dieses Projekt zu einem nützlichen Werkzeug in meinem Alltag. And of course, it’s Open Source.

Da bleibt mir nur noch zu sagen: „Danke Dirk für den Tipp.“

Referenzen