staging.inyokaproject.org

2023 Woche 41

14. Oktober 2023

Produnis 15. Oktober 2023 00:00

Anscombe-Quartett

Ich verwende in der Lehre gerne das Anscombe-Quartett, welches der englische Statistiker Francis Anscombe im Jahr 19731 vorgestellt hat.

Es besteht aus 4 kleinen Datensätzen mit jeweils 11 Beobachtungen von 2 Variablen (x, y). Der Datensatz ist u.a. bei Wikipedia erhältlich, aber auch direkt in R implementiert.

# aktiviere den Datensatz
data("anscombe")

# Daten anzeigen
anscombe
   x1 x2 x3 x4    y1   y2    y3    y4
1  10 10 10  8  8.04 9.14  7.46  6.58
2   8  8  8  8  6.95 8.14  6.77  5.76
3  13 13 13  8  7.58 8.74 12.74  7.71
4   9  9  9  8  8.81 8.77  7.11  8.84
5  11 11 11  8  8.33 9.26  7.81  8.47
6  14 14 14  8  9.96 8.10  8.84  7.04
7   6  6  6  8  7.24 6.13  6.08  5.25
8   4  4  4 19  4.26 3.10  5.39 12.50
9  12 12 12  8 10.84 9.13  8.15  5.56
10  7  7  7  8  4.82 7.26  6.42  7.91
11  5  5  5  8  5.68 4.74  5.73  6.89

Das Anscombe-Quartett ist hervoragend geeignet, um Studierenden die Wichtigkeit von graphischen Auswertungen neben statistischen Kennzeichen zu verdeutlichen.

Vorbereitung

Ich teile die Studierenden in 4 Gruppen auf, und jede Gruppe erhält einen Anscombe-Datensatz.

Gruppe1 <- data.frame(x=anscombe$x1, y=anscombe$y1)
Gruppe2 <- data.frame(x=anscombe$x2, y=anscombe$y2)
Gruppe3 <- data.frame(x=anscombe$x3, y=anscombe$y3)
Gruppe4 <- data.frame(x=anscombe$x4, y=anscombe$y4)
Gruppe1
    x     y
1  10  8.04
2   8  6.95
3  13  7.58
4   9  8.81
5  11  8.33
6  14  9.96
7   6  7.24
8   4  4.26
9  12 10.84
10  7  4.82
11  5  5.68
Gruppe2
    x    y
1  10 9.14
2   8 8.14
3  13 8.74
4   9 8.77
5  11 9.26
6  14 8.10
7   6 6.13
8   4 3.10
9  12 9.13
10  7 7.26
11  5 4.74
Gruppe3
    x     y
1  10  7.46
2   8  6.77
3  13 12.74
4   9  7.11
5  11  7.81
6  14  8.84
7   6  6.08
8   4  5.39
9  12  8.15
10  7  6.42
11  5  5.73
Gruppe4
    x     y
1   8  6.58
2   8  5.76
3   8  7.71
4   8  8.84
5   8  8.47
6   8  7.04
7   8  5.25
8  19 12.50
9   8  5.56
10  8  7.91
11  8  6.89

Jetzt sollen die Gruppen für ihren Datensazt jeweils auf 2 Stellen gerundet

  • den Mittelwert
  • die Standardabweichung
  • den Korrelationskoeffizienten nach Pearson
  • die Formel der linearen Regressionsgeraden

berechnen, sowie eine Punktwolke mit Regressionsgeraden zeichnen.

statistische Kennzeichen

Wenn die Gruppen wieder zusammenkommen und ihre Ergebnisse präsentieren, gibt es bei den statistischen Kennwerten den ersten Aha-Moment.

Gruppe 1

round(mean(Gruppe1$x),2)
[1] 9
round(sd(Gruppe1$x),2)
[1] 3.32
round(mean(Gruppe1$y),2)
[1] 7.5
round(sd(Gruppe1$y),2)
[1] 2.03
round(cor(Gruppe1$x,Gruppe1$y),2)
[1] 0.82
fit <- lm(Gruppe1$y~Gruppe1$x)
round(fit$coefficients,2)
(Intercept)   Gruppe1$x 
        3.0         0.5 

Gruppe 2

round(mean(Gruppe2$x),2)
[1] 9
round(sd(Gruppe2$x),2)
[1] 3.32
round(mean(Gruppe2$y),2)
[1] 7.5
round(sd(Gruppe2$y),2)
[1] 2.03
round(cor(Gruppe2$x,Gruppe2$y),2)
[1] 0.82
fit <- lm(Gruppe2$y~Gruppe2$x)
round(fit$coefficients,2)
(Intercept)   Gruppe2$x 
        3.0         0.5 

Gruppe 3

round(mean(Gruppe3$x),2)
[1] 9
round(sd(Gruppe3$x),2)
[1] 3.32
round(mean(Gruppe3$y),2)
[1] 7.5
round(sd(Gruppe3$y),2)
[1] 2.03
round(cor(Gruppe3$x,Gruppe3$y),2)
[1] 0.82
fit <- lm(Gruppe3$y~Gruppe3$x)
round(fit$coefficients,2)
(Intercept)   Gruppe3$x 
        3.0         0.5 

Gruppe 4

round(mean(Gruppe4$x),2)
[1] 9
round(sd(Gruppe4$x),2)
[1] 3.32
round(mean(Gruppe4$y),2)
[1] 7.5
round(sd(Gruppe4$y),2)
[1] 2.03
round(cor(Gruppe4$x,Gruppe4$y),2)
[1] 0.82
fit <- lm(Gruppe4$y~Gruppe4$x)
round(fit$coefficients,2)
(Intercept)   Gruppe4$x 
        3.0         0.5 

Alle Gruppen haben die selben (zugegeben gerundeten) Kennwertergebnisse ausgerechnet, obwohl die Datensätze unterschiedlich sind. Das sorgt häufig für Erstaunen und führt zu ersten Diskussionen.

graphische Darstellung

Spannend wird es dann nochmal, wenn die Punktwolken verglichen werden.

plot(Gruppe1$x,Gruppe1$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe1$y~Gruppe1$x))


plot(Gruppe2$x,Gruppe2$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe2$y~Gruppe2$x))


plot(Gruppe3$x,Gruppe3$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe3$y~Gruppe3$x))


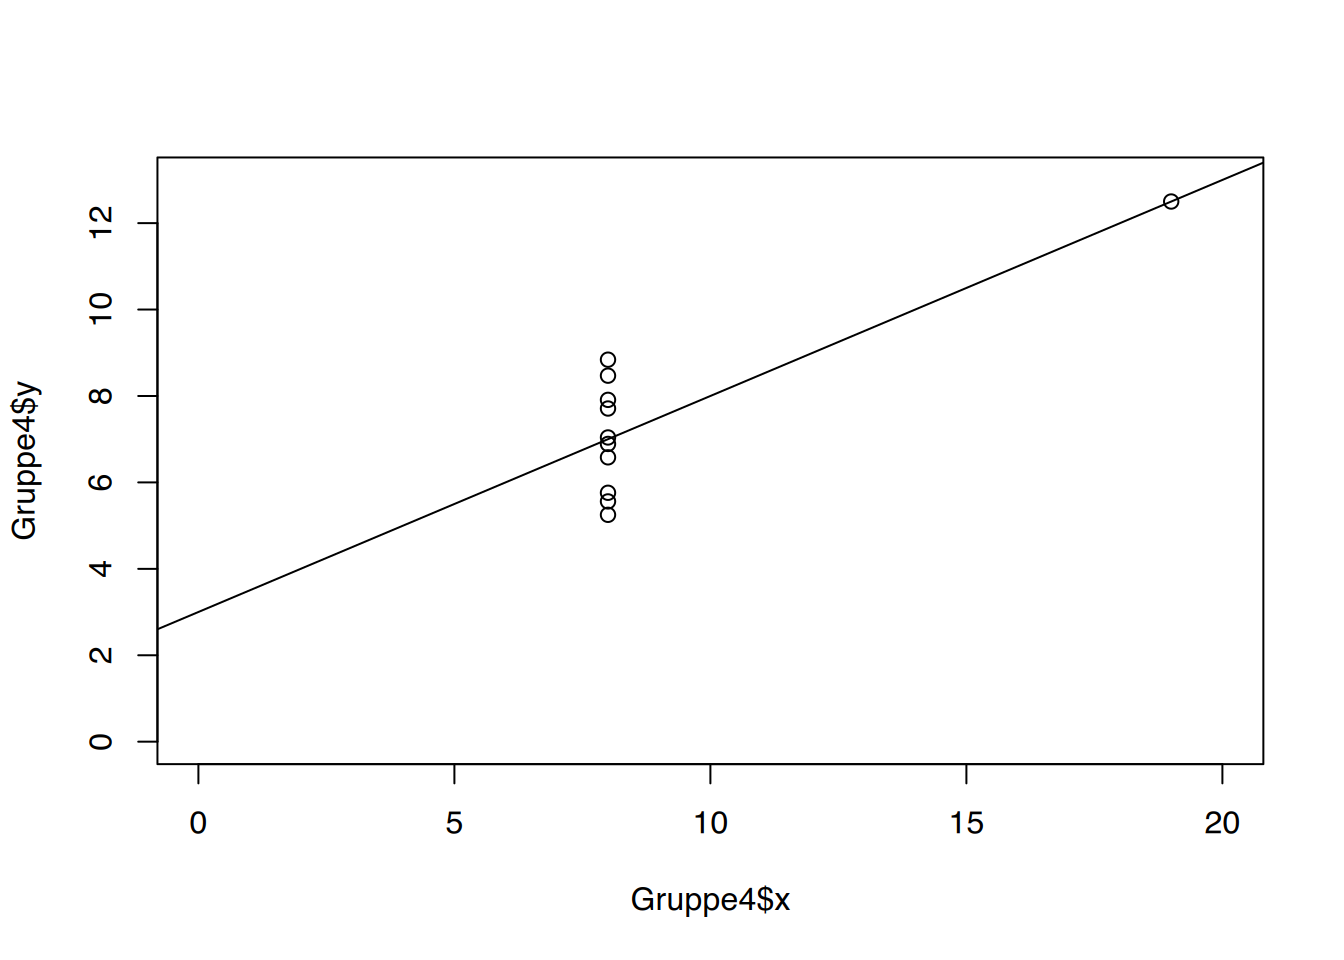
plot(Gruppe4$x,Gruppe4$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe4$y~Gruppe4$x))
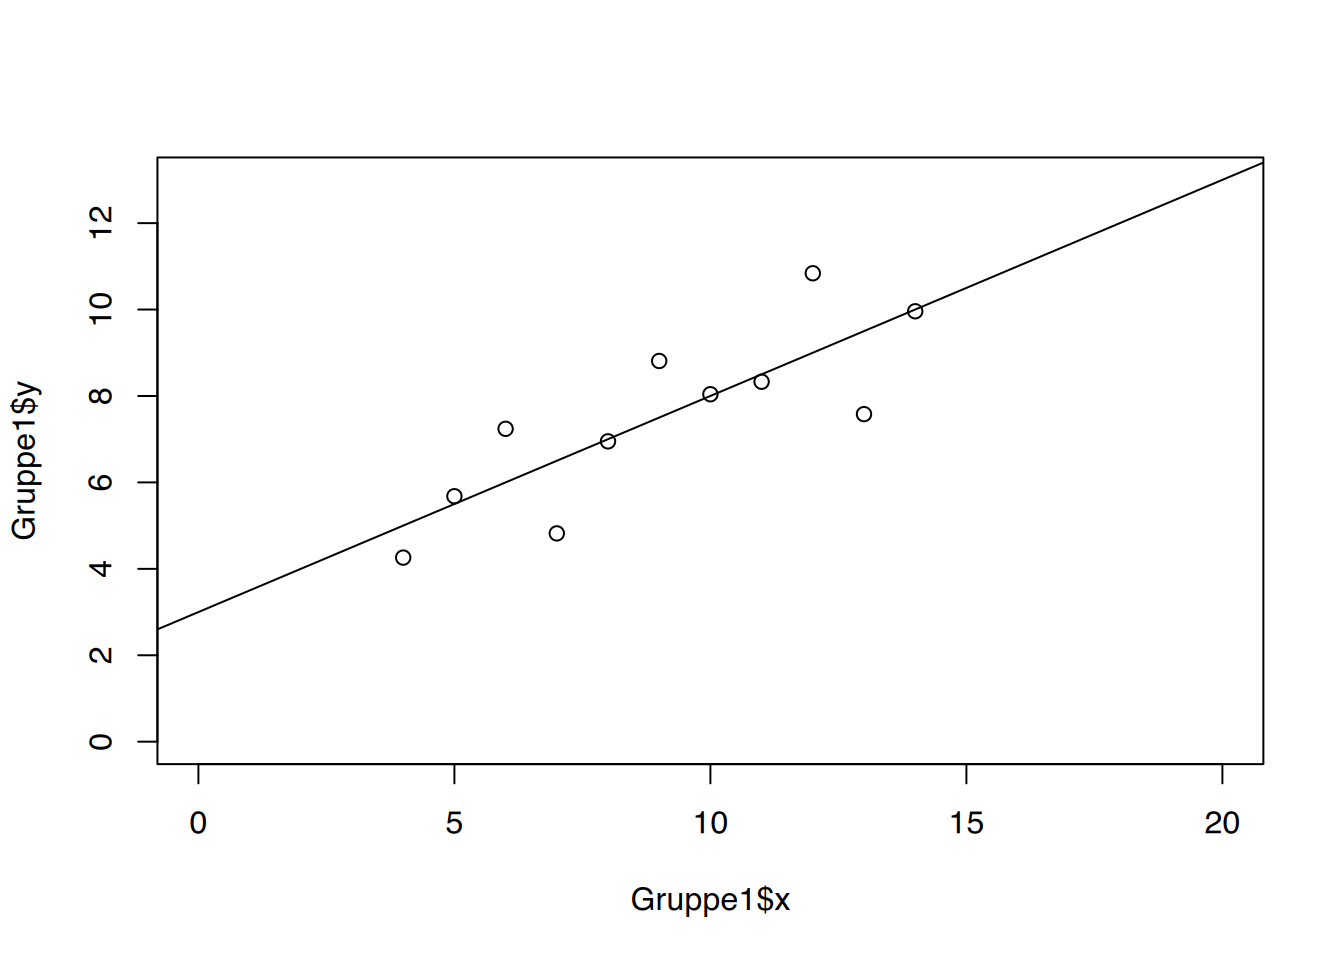
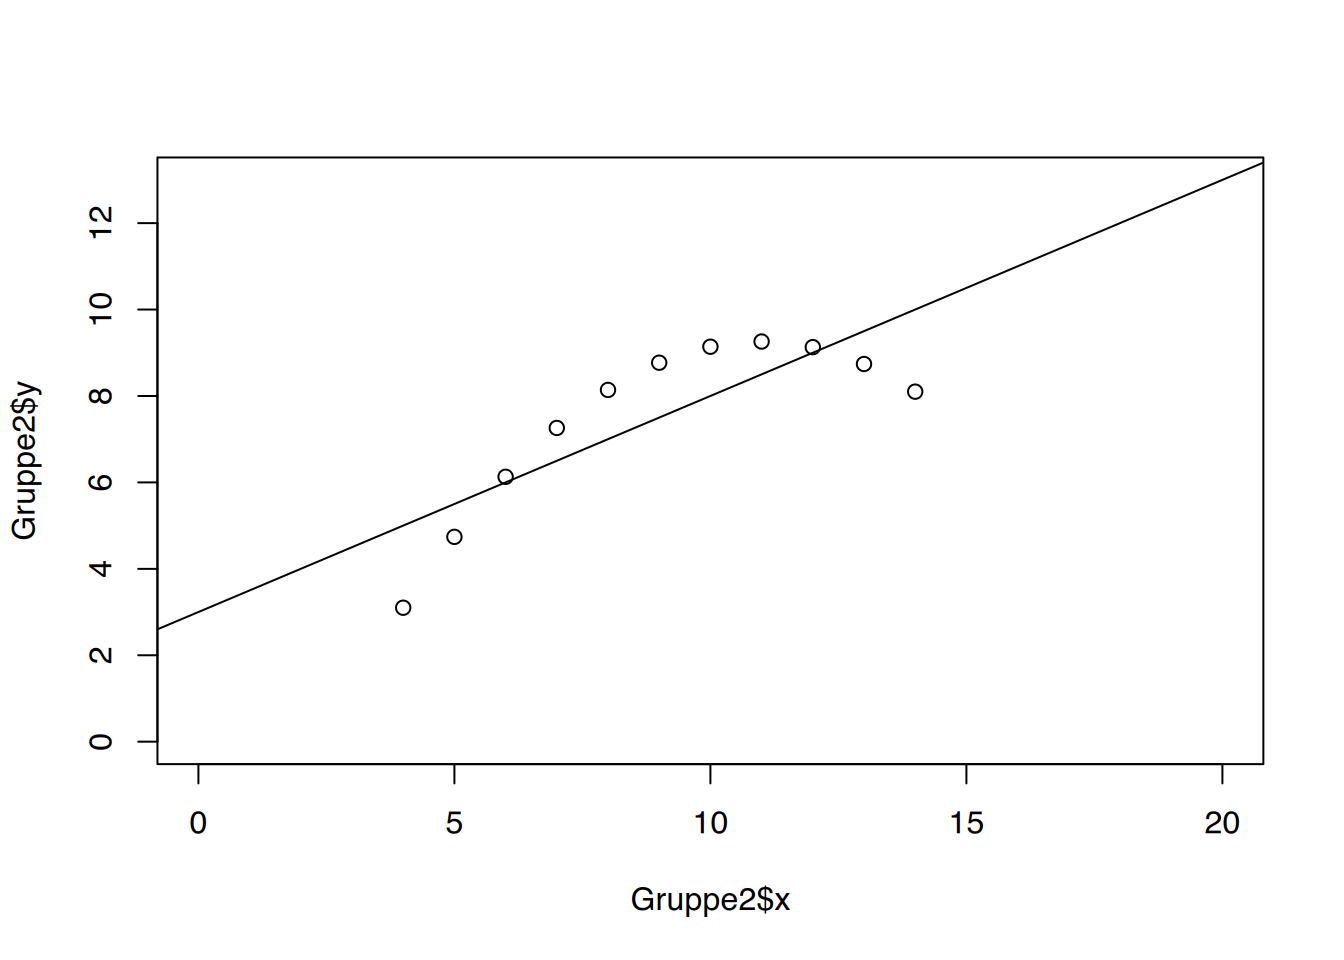
(a) Gruppe 1
(b) Gruppe 2
(c) Gruppe 3
(d) Gruppe 4
Abbildung 1: Anscombe Quartett

Alle Diagramme sehen unterschiedlich aus, und ihre Darstellung regt weitere Diskussionen an:

  • Diagramm 1 sieht aus wie ein klassisches Streudiagramm. Die lineare Regressionsgerade sieht passend aus, die Variablen scheinen zu korrelieren. Hier ist alles in Ordnung.
  • Diagramm 2 lässt erkennen, dass der Zusammenhang zwischen x und y nicht linear ist. Somit lassen sich keine Korrelationen oder lineare Regressionen auf die Daten anwenden.
  • Diagramm 3 zeigt einen deutlichen Ausreisser, der die Ergebnisse von Korrelation und Regression verzerrt.
  • Diagramm 4 zeigt ebenfalls einen deutlichen Ausreisser, während alle anderen y-Werte im selben x übereinander liegen. Ohne den Ausreisser wäre keine Korrelation oder Regression rechenbar.

Diskussion

Mit dieser kleinen Übung gelingt es häufig, Studierenden die Wichtigkeit der graphischen Datenanalyse nahezulegen, die vor der eigentlichen statistischen Auswertung erfolgen sollte. Statistische Kennzahlen reichen nicht aus, um die Daten ausreichend zu beschreiben.

heutzutage

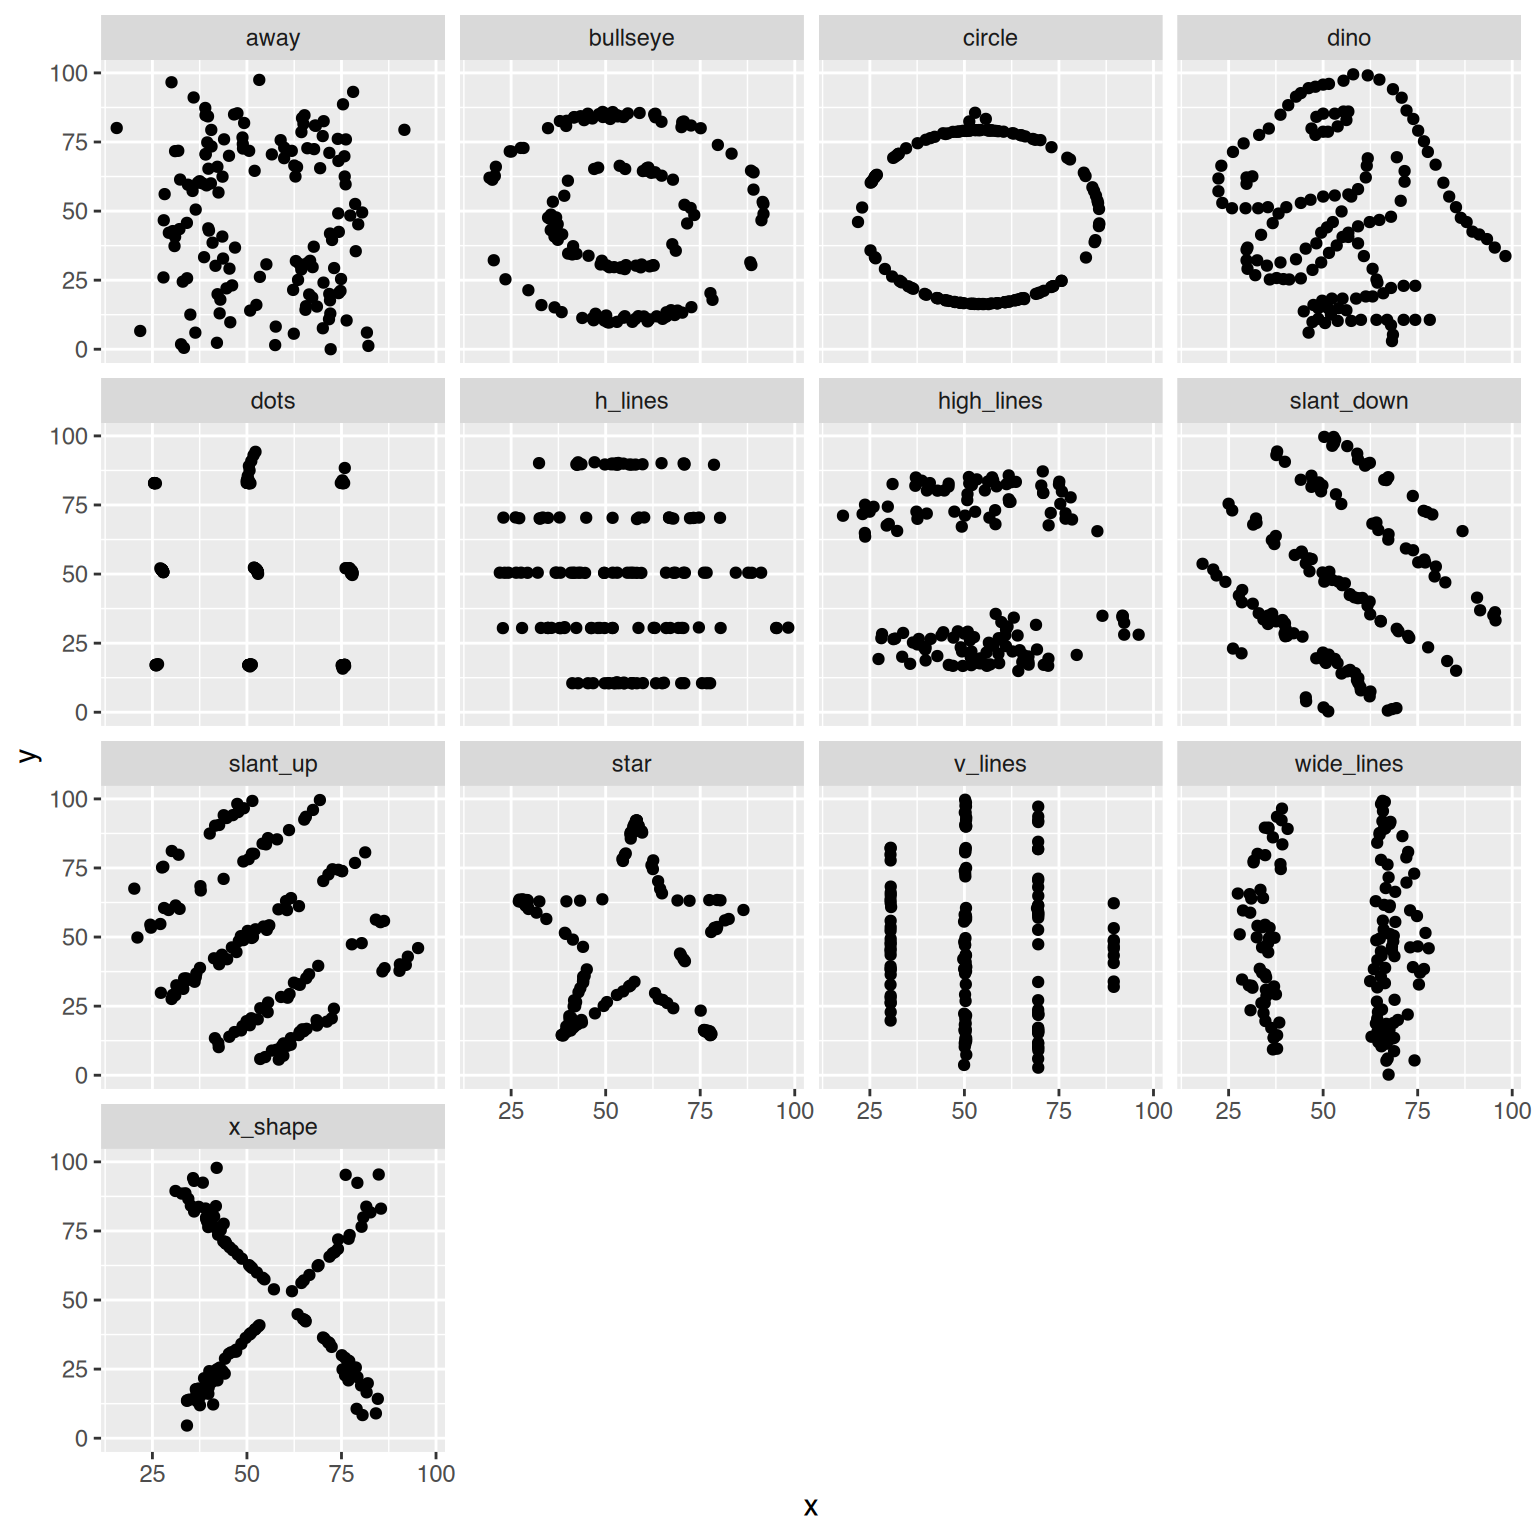
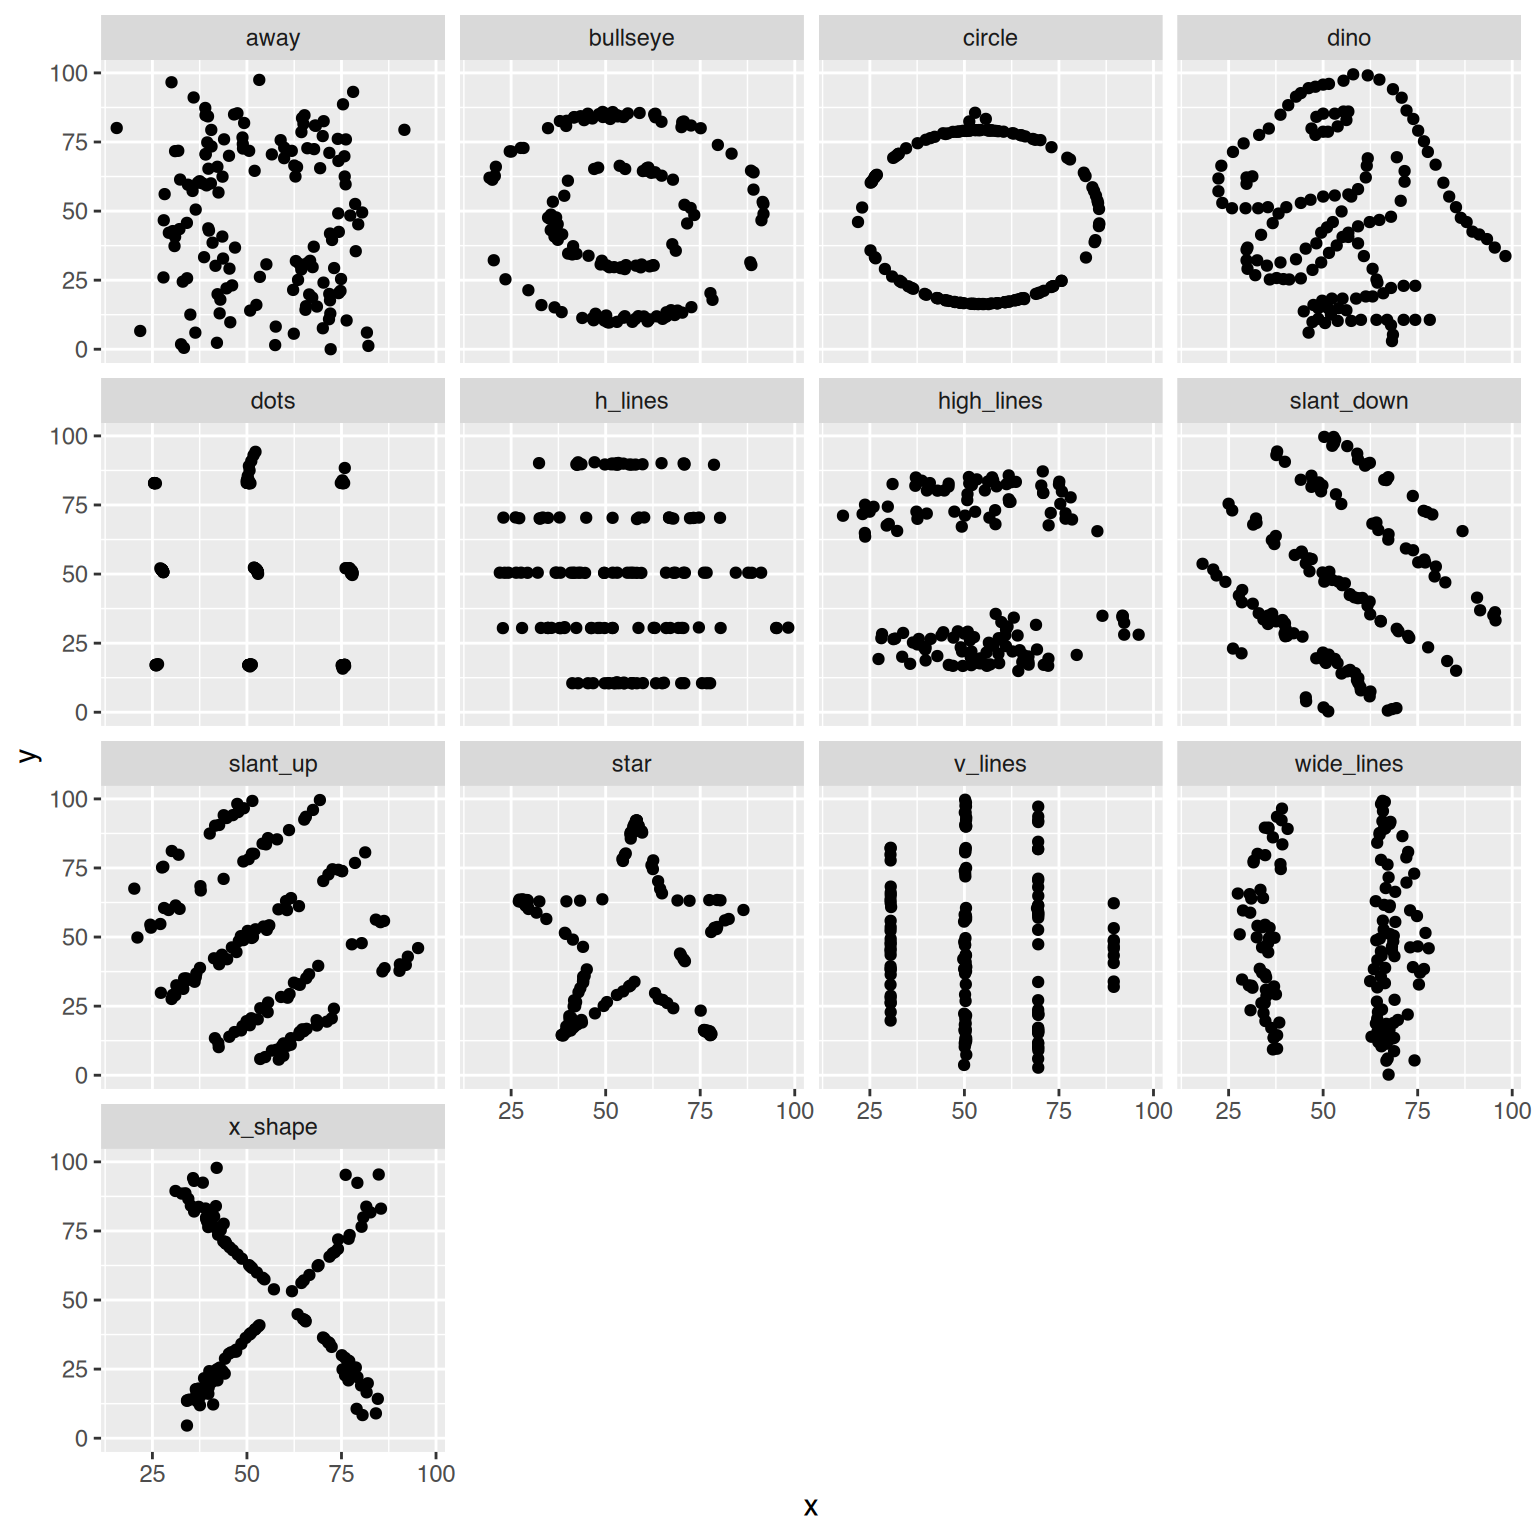
Heutzutage ist es mit Hilfe von evolutionären Algorithmen möglich, weit komplexere Datensätze zu erzeugen, die in ihren Kennwerten übereinstimmen, deren Streudiagramme aber beliebige Formen annehmen können.

Mein Favorit ist der Datasaurus2.

library(ggplot2)
load(url("https://www.produnis.de/nagut/datasaurus.RData"))

datasaurus |> 
  ggplot(aes(x=x, y=y)) +
  geom_point() +
  facet_wrap(~dataset)
Abbildung 2

Weblinks


Fußnoten

  1. F. J. Anscombe: Graphs in Statistical Analysis. In: American Statistician. 27. Jahrgang, Nr. 1, 1973, S. 17–21↩︎

  2. Matejka, J., & Fitzmaurice, G. (2017). Same Stats, Different Graphs: Generating Datasets with Varied Appearance and Identical Statistics through Simulated Annealing. Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems, 1290–1294. https://doi.org/10.1145/3025453.3025912↩︎

Ich verwende in der Lehre gerne das Anscombe-Quartett, welches der englische Statistiker Francis Anscombe im Jahr 19731 vorgestellt hat.

Es besteht aus 4 kleinen Datensätzen mit jeweils 11 Beobachtungen von 2 Variablen (x, y). Der Datensatz ist u.a. bei Wikipedia erhältlich, aber auch direkt in R implementiert.

# aktiviere den Datensatz
data("anscombe")

# Daten anzeigen
anscombe
   x1 x2 x3 x4    y1   y2    y3    y4
1  10 10 10  8  8.04 9.14  7.46  6.58
2   8  8  8  8  6.95 8.14  6.77  5.76
3  13 13 13  8  7.58 8.74 12.74  7.71
4   9  9  9  8  8.81 8.77  7.11  8.84
5  11 11 11  8  8.33 9.26  7.81  8.47
6  14 14 14  8  9.96 8.10  8.84  7.04
7   6  6  6  8  7.24 6.13  6.08  5.25
8   4  4  4 19  4.26 3.10  5.39 12.50
9  12 12 12  8 10.84 9.13  8.15  5.56
10  7  7  7  8  4.82 7.26  6.42  7.91
11  5  5  5  8  5.68 4.74  5.73  6.89

Das Anscombe-Quartett ist hervoragend geeignet, um Studierenden die Wichtigkeit von graphischen Auswertungen neben statistischen Kennzeichen zu verdeutlichen.

Vorbereitung

Ich teile die Studierenden in 4 Gruppen auf, und jede Gruppe erhält einen Anscombe-Datensatz.

Gruppe1 <- data.frame(x=anscombe$x1, y=anscombe$y1)
Gruppe2 <- data.frame(x=anscombe$x2, y=anscombe$y2)
Gruppe3 <- data.frame(x=anscombe$x3, y=anscombe$y3)
Gruppe4 <- data.frame(x=anscombe$x4, y=anscombe$y4)
Gruppe1
    x     y
1  10  8.04
2   8  6.95
3  13  7.58
4   9  8.81
5  11  8.33
6  14  9.96
7   6  7.24
8   4  4.26
9  12 10.84
10  7  4.82
11  5  5.68
Gruppe2
    x    y
1  10 9.14
2   8 8.14
3  13 8.74
4   9 8.77
5  11 9.26
6  14 8.10
7   6 6.13
8   4 3.10
9  12 9.13
10  7 7.26
11  5 4.74
Gruppe3
    x     y
1  10  7.46
2   8  6.77
3  13 12.74
4   9  7.11
5  11  7.81
6  14  8.84
7   6  6.08
8   4  5.39
9  12  8.15
10  7  6.42
11  5  5.73
Gruppe4
    x     y
1   8  6.58
2   8  5.76
3   8  7.71
4   8  8.84
5   8  8.47
6   8  7.04
7   8  5.25
8  19 12.50
9   8  5.56
10  8  7.91
11  8  6.89

Jetzt sollen die Gruppen für ihren Datensazt jeweils auf 2 Stellen gerundet

  • den Mittelwert
  • die Standardabweichung
  • den Korrelationskoeffizienten nach Pearson
  • die Formel der linearen Regressionsgeraden

berechnen, sowie eine Punktwolke mit Regressionsgeraden zeichnen.

statistische Kennzeichen

Wenn die Gruppen wieder zusammenkommen und ihre Ergebnisse präsentieren, gibt es bei den statistischen Kennwerten den ersten Aha-Moment.

Gruppe 1

round(mean(Gruppe1$x),2)
[1] 9
round(sd(Gruppe1$x),2)
[1] 3.32
round(mean(Gruppe1$y),2)
[1] 7.5
round(sd(Gruppe1$y),2)
[1] 2.03
round(cor(Gruppe1$x,Gruppe1$y),2)
[1] 0.82
fit <- lm(Gruppe1$y~Gruppe1$x)
round(fit$coefficients,2)
(Intercept)   Gruppe1$x 
        3.0         0.5 

Gruppe 2

round(mean(Gruppe2$x),2)
[1] 9
round(sd(Gruppe2$x),2)
[1] 3.32
round(mean(Gruppe2$y),2)
[1] 7.5
round(sd(Gruppe2$y),2)
[1] 2.03
round(cor(Gruppe2$x,Gruppe2$y),2)
[1] 0.82
fit <- lm(Gruppe2$y~Gruppe2$x)
round(fit$coefficients,2)
(Intercept)   Gruppe2$x 
        3.0         0.5 

Gruppe 3

round(mean(Gruppe3$x),2)
[1] 9
round(sd(Gruppe3$x),2)
[1] 3.32
round(mean(Gruppe3$y),2)
[1] 7.5
round(sd(Gruppe3$y),2)
[1] 2.03
round(cor(Gruppe3$x,Gruppe3$y),2)
[1] 0.82
fit <- lm(Gruppe3$y~Gruppe3$x)
round(fit$coefficients,2)
(Intercept)   Gruppe3$x 
        3.0         0.5 

Gruppe 4

round(mean(Gruppe4$x),2)
[1] 9
round(sd(Gruppe4$x),2)
[1] 3.32
round(mean(Gruppe4$y),2)
[1] 7.5
round(sd(Gruppe4$y),2)
[1] 2.03
round(cor(Gruppe4$x,Gruppe4$y),2)
[1] 0.82
fit <- lm(Gruppe4$y~Gruppe4$x)
round(fit$coefficients,2)
(Intercept)   Gruppe4$x 
        3.0         0.5 

Alle Gruppen haben die selben (zugegeben gerundeten) Kennwertergebnisse ausgerechnet, obwohl die Datensätze unterschiedlich sind. Das sorgt häufig für Erstaunen und führt zu ersten Diskussionen.

graphische Darstellung

Spannend wird es dann nochmal, wenn die Punktwolken verglichen werden.

Gruppe 1

plot(Gruppe1$x,Gruppe1$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe1$y~Gruppe1$x))

Gruppe 2

plot(Gruppe2$x,Gruppe2$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe2$y~Gruppe2$x))

Gruppe 3

plot(Gruppe3$x,Gruppe3$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe3$y~Gruppe3$x))

Gruppe 4

plot(Gruppe4$x,Gruppe4$y,
     xlim = c(0,20),
     ylim = c(0,13))
abline(lm(Gruppe4$y~Gruppe4$x))

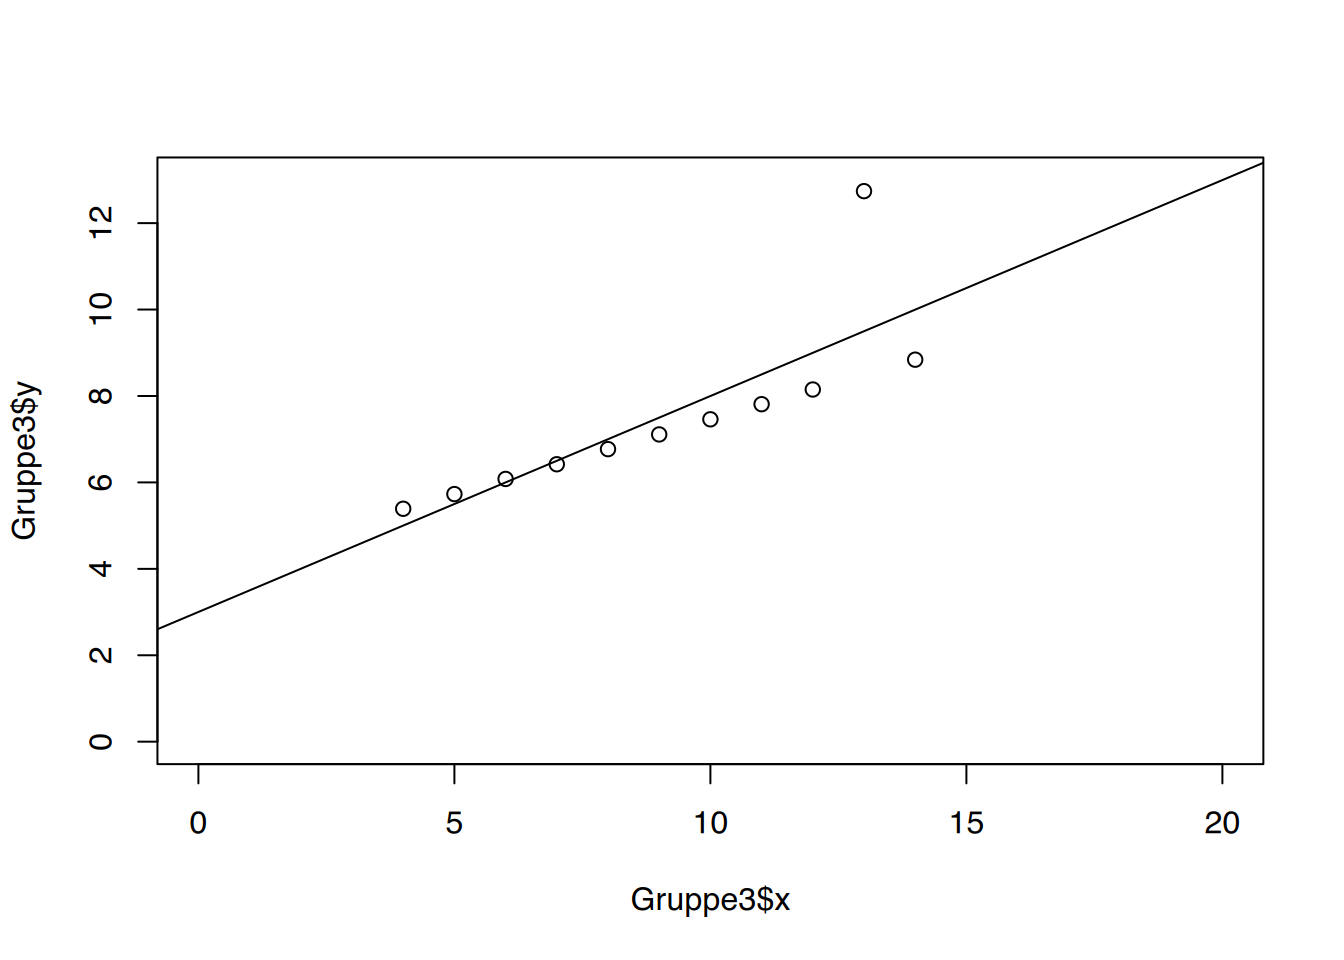
Alle Diagramme sehen unterschiedlich aus, und ihre Darstellung regt weitere Diskussionen an:

  • Diagramm 1 sieht aus wie ein klassisches Streudiagramm. Die lineare Regressionsgerade sieht passend aus, die Variablen scheinen zu korrelieren. Hier ist alles in Ordnung.
  • Diagramm 2 lässt erkennen, dass der Zusammenhang zwischen x und y nicht linear ist. Somit lassen sich keine Korrelationen oder lineare Regressionen auf die Daten anwenden.
  • Diagramm 3 zeigt einen deutlichen Ausreisser, der die Ergebnisse von Korrelation und Regression verzerrt.
  • Diagramm 4 zeigt ebenfalls einen deutlichen Ausreisser, während alle anderen y-Werte im selben x übereinander liegen. Ohne den Ausreisser wäre keine Korrelation oder Regression rechenbar.

Diskussion

Mit dieser kleinen Übung gelingt es häufig, Studierenden die Wichtigkeit der graphischen Datenanalyse nahezulegen, die vor der eigentlichen statistischen Auswertung erfolgen sollte. Statistische Kennzahlen reichen nicht aus, um die Daten ausreichend zu beschreiben.

heutzutage

Heutzutage ist es mit Hilfe von evolutionären Algorithmen möglich, weit komplexere Datensätze zu erzeugen, die in ihren Kennwerten übereinstimmen, deren Streudiagramme aber beliebige Formen annehmen können.

Mein Favorit ist der Datasaurus2.

library(ggplot2)
load(url("https://www.produnis.de/nagut/datasaurus.RData"))

datasaurus |> 
  ggplot(aes(x=x, y=y)) +
  geom_point() +
  facet_wrap(~dataset)
Weblinks


kommentiere per [matrix]:

Fußnoten

  1. F. J. Anscombe: Graphs in Statistical Analysis. In: American Statistician. 27. Jahrgang, Nr. 1, 1973, S. 17–21↩︎

  2. Matejka, J., & Fitzmaurice, G. (2017). Same Stats, Different Graphs: Generating Datasets with Varied Appearance and Identical Statistics through Simulated Annealing. Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems, 1290–1294. https://doi.org/10.1145/3025453.3025912↩︎

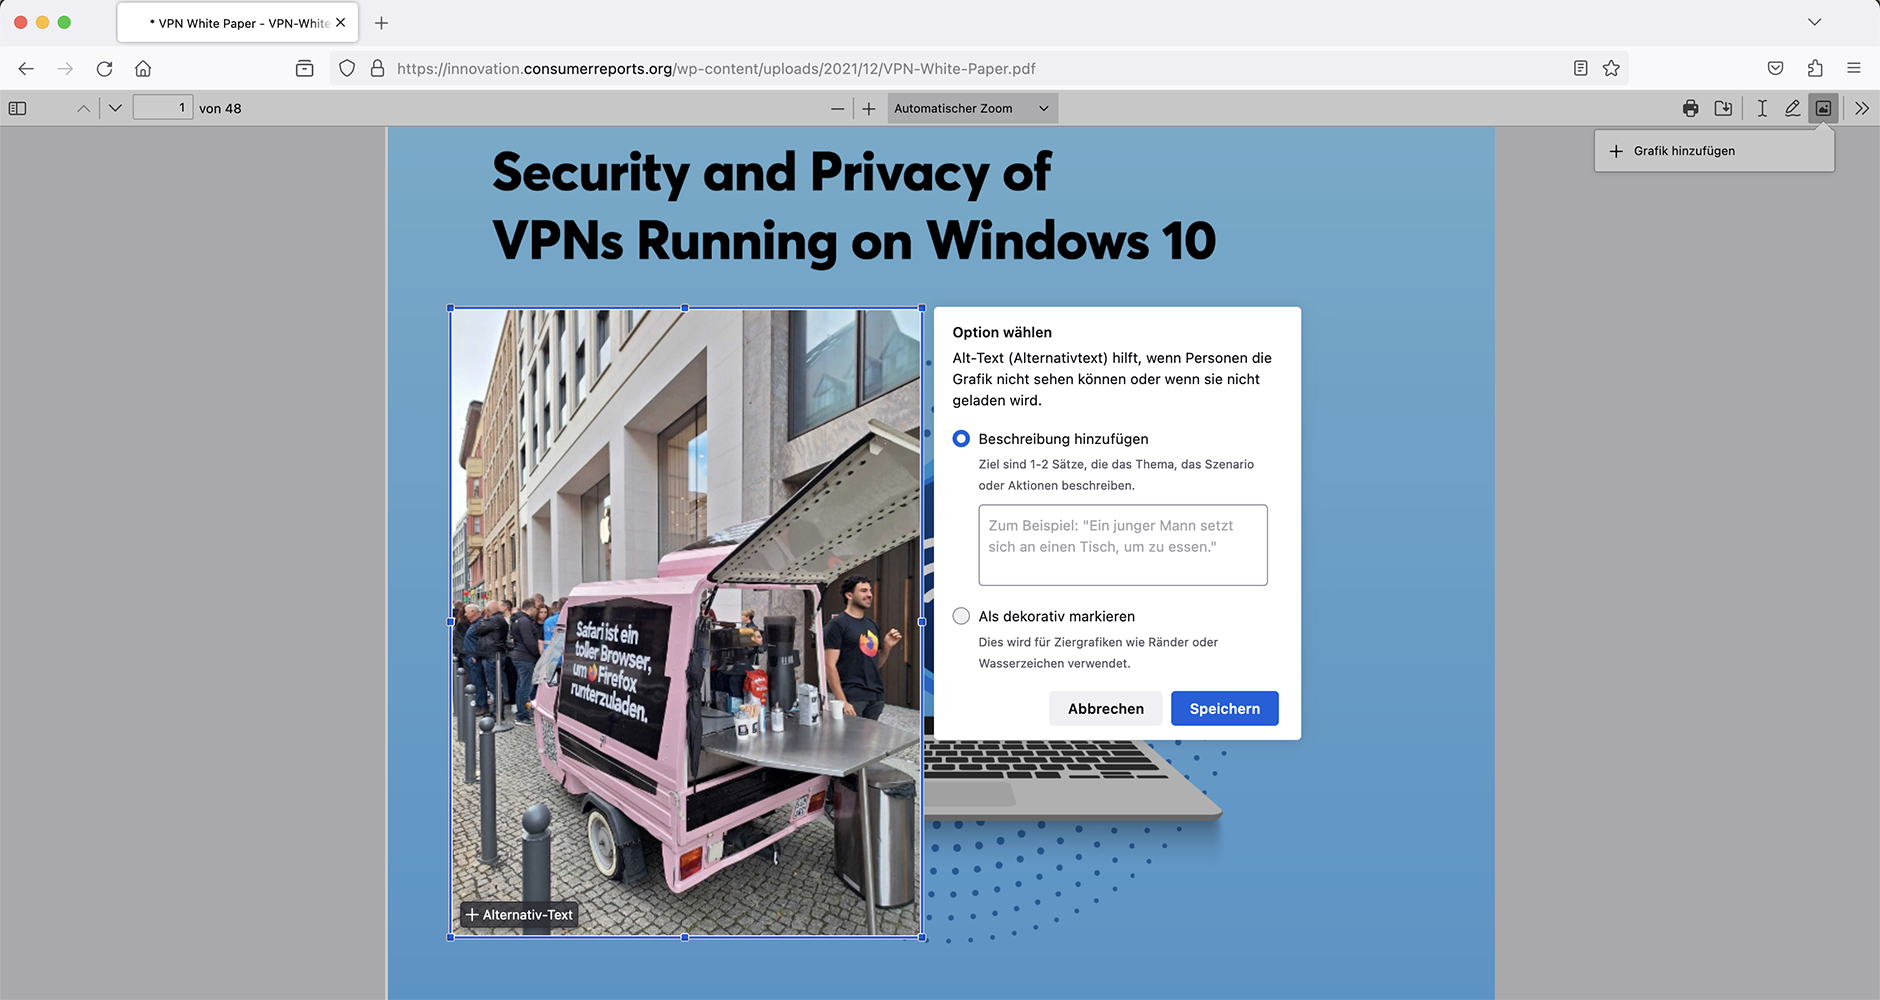
Der PDF-Betrachter von Firefox kann längst nicht mehr nur zum reinen Betrachten von PDF-Dateien, sondern auch zum Ausfüllen von PDF-Formularen oder zum Ergänzen von Text und Zeichnungen genutzt werden. Firefox 119 bringt zusätzlich die Möglichkeit, Bilder einzufügen.

Manchmal kann es notwendig sein, eine bestehende PDF-Datei zu bearbeiten und zusätzliche Textanmerkungen zu platzieren. Auch das Zeichnen auf PDF-Dateien ist seit Firefox 106 möglich. Was bisher noch fehlte und Firefox 119 ergänzen wird, ist die Möglichkeit, zusätzliche Bilder in PDF-Dateien zu integrieren. Mögliche Anwendungsfälle hierfür wären beispielsweise Stempel oder Unterschriften auf digitalen Dokumenten.

Natürlich soll auch die Barrierefreiheit dabei nicht zu kurz kommen. Daher können Bilder entweder als dekorativ markiert oder ein Alternativtext hinterlegt werden, der Nutzern assistiver Technologien bereitgestellt wird.

Firefox 119: Bilder in PDF-Dateien

Der Beitrag Firefox 119 erlaubt das Einfügen von Bildern in PDF-Dateien erschien zuerst auf soeren-hentzschel.at.

13. Oktober 2023

Die Veröffentlichung wurde verschoben, bis das Upstream-Problem aufgrund von Komplikationen im Zusammenhang mit dem Linux-Kernel 6.5 gelöst ist.


Arch-Linux und darauf basierende Distributionen erfreuen sich, nicht nur bei Profis, sondern auch bei fortgeschrittenen GNU/Linux-Anwender:innen, einer grossen Beliebtheit. Das mag am Rolling-Release-Modell liegen, aber auch daran, dass die ehemals schwierige Installation der Vergangenheit angehört. Schaut man bei Distrowatch nach, finden sich 25 Distributionen, die auf Arch aufsetzen. Zu den prominentesten gehören Manjaro und EndeavourOS, die aktuell die Plätze 3 und 5 des Rankings bei Distrowatch belegen. (Hinweis: diese Liste ist eine selbsterfüllende Prophezeiung). Diese beiden machen es den Benutzern besonders einfach bei der Installation. Nach der Cassini-Serie von EndeavourOS hätte eigentlich die Galileo-Version erscheinen sollen. Doch diese verspätet sich.

Das letzte Update der Distribution ist Cassini Nova R3, das im September veröffentlicht wurde. Einen positiven Kurztest von Cassini könnt ihr hier lesen. Unglücklicherweise änderte das Erscheinen von Linux-Kernel 6.5 die Pläne der Entwickler, bevor die endgültige Version von EndeavourOS Galileo fertig war. Es stellte sich heraus, dass diese Kernel-Version einen Fehler aufweist, der manchmal Probleme verursacht, wenn sie auf bestimmter Hardware oder Virtualisierungssoftware eingesetzt wird.

Daher verzögert sich die Veröffentlichung von Galileo, bis das Problem Upstream behoben ist. Das kleine Team von EndeavourOS kann diese Aufgabe nicht selbst bewältigen. Man hätte stattdessen den Linux-Kernel 6.1 LTS verwenden können, wäre jedoch das Risiko eingegangen, dass Teile moderner Hardware davon nicht unterstützt werden.

Eine der grössten Änderungen, die mit der Galileo-Serie Einzug erhalten, ist der Austausch der Standard-Desktopumgebung von Xfce zu KDE Plasma. Als Begründung für diesen Wechsel schreibt das Team:

Von Anfang an haben wir unsere ISOs mit einer leicht angepassten Xfce-Live-Umgebung und einer Offline-Installationsoption ausgeliefert. Jetzt, nach mehr als vier Jahren, wird es für uns immer schwieriger, die angepasste Xfce-Live-Umgebung mit den Fortschritten des Calamares-Installers in Einklang zu bringen. Aus diesem Grund verabschieden wir uns von Xfce und wechseln ab Galileo zu Plasma. KDE Plasma bietet eine nativere Entwicklungserfahrung für das Team und ist daher einfacher zu pflegen.

Als weitere Desktop-Umgebungen kann während der Installation zwischen Budgie, Cinnamon, GNOME, i3, LXDE, LXQt, MATE und Xfce ausgewählt werden. Ausserdem wird Galileo die erste Version ohne die Optionen Sway, Qtile, Openbox und bspwm im Installationsprogramm sein. Natürlich ist es immer noch möglich, sie auf einem bereits laufenden System zu installieren.

Sobald Galileo erschienen ist, werden wir euch informieren und das neue Release ausprobieren.

Quelle: https://endeavouros.com/news/our-galileo-release-is-delayed-but-here-are-the-main-changes-you-can-expect/


GNU/Linux.ch ist ein Community-Projekt. Bei uns kannst du nicht nur mitlesen, sondern auch selbst aktiv werden. Wir freuen uns, wenn du mit uns über die Artikel in unseren Chat-Gruppen oder im Fediverse diskutierst. Auch du selbst kannst Autor werden. Reiche uns deinen Artikelvorschlag über das Formular auf unserer Webseite ein.

12. Oktober 2023

Cookie-Dialoge sind in der Theorie eine gute Sache, sollen sie dem Anwender doch mehr Kontrolle und Datenschutz geben. In der Praxis sind die meisten Anwender wohl doch eher genervt davon. Ab Firefox 120 soll Mozillas Browser damit beginnen, Cookie-Dialoge standardmäßig zu blockieren.

Wieso gibt es Cookie-Dialoge?

Zunächst einmal: Cookies sind nichts Schlechtes. Im Gegenteil sind diese häufig sogar technisch notwendig. In Cookies werden Informationen gespeichert, die es einem beispielsweise ermöglichen, auf Websites eingeloggt zu bleiben.

Häufig werden Cookies mit Tracking in Verbindung gebracht, indem über Websites und Sitzungen hinweg Informationen gespeichert und zusammengeführt werden, was es Websites dann erlaubt, zum Beispiel personalisierte Werbung auszuspielen. An diesem Punkt bekommen Cookies eine Datenschutz-Relevanz. Firefox-Nutzer sind hier durch den vollständigen Cookie-Schutz geschützt, der seit Firefox 103 für alle Nutzer standardmäßig aktiv ist. Gleichwohl ist zu bedenken, dass seitenübergreifendes Tracking heutzutage auch über andere Mechanismen stattfinden kann.

Cookie-Dialoge sind keine Idee der Website-Betreiber, sondern eine Konsequenz der Gesetzgebung innerhalb der Europäischen Union. Diese sieht es vor, dass Nutzern die Kontrolle darüber gegeben wird, was mit ihren Daten geschieht. Auch wenn es namentlich eigentlich nur um Cookies geht, hängt da oft viel mehr als nur Cookies dran. So kann das Laden ganzer Scripts von fremden Servern von der Entscheidung abhängen, ob man über einen solchen Dialog seine Zustimmung erteilt oder nicht.

Ziel dieser Cookie-Dialoge ist eine Verbesserung des Datenschutzes der Nutzer, was ohne Frage ein nobles Ziel ist. In der praktischen Umsetzung zeigt sich jedoch, dass viele Nutzer nur noch davon genervt sind, auf jeder Website erst einmal einen Dialog bestätigen zu müssen, zumal eine begründete Entscheidung oft auch gar nicht möglich ist, sei es wegen fehlender oder im Gegenteil so vieler Informationen, dass man erschlagen wird und einfach nur noch bestätigt. Gerne wird auch mit Tricks gearbeitet, welche die Zustimmung visuell attraktiver machen als die Ablehnung.

Ab Firefox 120 werden Cookie-Dialoge blockiert

Es ist bereits über ein Jahr her, dass ich darüber berichtet hatte, dass Firefox in Zukunft Cookie-Dialoge blockieren wird. Während Mozilla in der Zwischenzeit weiter an dem Feature gearbeitet hat, war nicht klar, wann die neue Funktion denn nun erstmals in einer finalen Version von Firefox ausgerollt werden wird.

Jetzt ist klar: Mozilla wird in Firefox 120 damit beginnen, Cookie-Dialoge standardmäßig zu blockieren. Allerdings: Die Ausrollung in Firefox 120 wird nur für Nutzer in Deutschland erfolgen. Nutzer in anderen Ländern werden also noch etwas länger warten müssen – oder die Funktion manuell über about:config aktivieren, indem der Schalter cookiebanners.service.mode auf 1 gesetzt wird.

Zu beachten ist, dass die Funktion Cookie-Dialoge reduzieren und nicht vollständig eliminieren wird. Es kann immer auch Websites geben, auf denen Cookie-Dialoge erscheinen, die von Firefox nicht erkannt werden. Außerdem blockiert Firefox standardmäßig ausschließlich Cookie-Dialoge, welche eine Option zum Ablehnen anbieten. Für die Zukunft ist geplant, noch eine Funktion zu integrieren, über welche man Mozilla auf Websites hinweisen kann, auf denen Cookie-Dialoge nicht erkannt werden. Bis dahin lassen sich Seiten mit nicht erkannten Cookie-Dialogen aber auch über GitHub melden.

Der Beitrag Ab Firefox 120 werden Cookie-Dialoge blockiert erschien zuerst auf soeren-hentzschel.at.

11. Oktober 2023

Die MZLA Technologies Corporation hat mit Thunderbird 115.3.2 ein Update für seinen Open Source E-Mail-Client veröffentlicht.

Neuerungen von Thunderbird 115.3.2

Mit dem Update auf Thunderbird 115.3.2 hat die MZLA Technologies Corporation ein Update für seinen Open Source E-Mail-Client veröffentlicht und behebt damit mehrere Probleme, welche sich in den Release Notes (engl.) nachlesen lassen.

Der Beitrag Thunderbird 115.3.2 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

10. Oktober 2023

Mozilla hat Firefox 118.0.2 veröffentlicht und verbessert damit die Übersetzungsfunktion, behebt Webkompatibilitätsprobleme und bringt weitere Verbesserungen.

Download Mozilla Firefox 118.0.2

Mit dem Update auf Firefox 118.0.2 verbessert Mozilla die mit Firefox 118 eingeführte Übersetzungsfunktion, welche Websites komplett im Browser übersetzen kann, ohne die zu übersetzenden Texte an einen Online-Dienst wie Google Translate senden zu müssen. Ab sofort können auch Inhalte übersetzt werden, welche sich im sogenannten Shadow DOM einer Website befinden.

Firefox 118.0.2 behebt auch einige Webkompatibilitätsprobleme. So wurde ein Problem behoben, durch welches manche H.264 WebRTC-Videos nicht abgespielt werden konnten, ebenso wie ein Audio-Decoding-Problem unter Windows mit manchen Formaten korrigiert wurde. Ein weiteres behobenes Problem verursachte, dass die Website betsoft.com nicht geladen werden konnte. Ebenfalls behoben wurde das Problem, dass CORS XHR mit Authentifizierung nicht mehr funktionierte. Außerdem gab es Probleme beim Drucken mancher SVG-Grafiken.

Durch die Anti-Fingerprinting-Konfiguration von Firefox konnte es in privaten Fenstern dazu kommen, dass teilweise nicht die richtigen Schriften angezeigt worden sind. Dies hat vor allem Nutzer japanischer, chinesischer oder koreanischer Sprachen betroffen.

Für Nutzer von Windows 11 ab Build 22621 poppte bei Installation eine Berechtigungsanfrage von Windows für das Anpinnen an die Taskleiste auf. Mit Firefox 118.0.2 wird diese Aktion ab diesem Windows-Build nicht mehr als Teil des Installers ausgeführt, sondern nur noch als Teil der Willkommenstour, wo Nutzer explizit danach gefragt werden und wo diese Berechtigungsanfrage daher weniger Verwirrung beim Anwender auslöst.

Dazu kommt noch die Behebung dreier möglicher Absturzursachen sowie eine Performance-Verbesserung in Zusammenhang mit CSS und dem Shadow DOM.

Der Beitrag Mozilla veröffentlicht Firefox 118.0.2 erschien zuerst auf soeren-hentzschel.at.

9. Oktober 2023

Firefox Relay ist ein Dienst von Mozilla, der die persönliche E-Mail-Adresse vor Spam und unerwünschter Offenlegung schützt. Die dazugehörige Browser-Erweiterung hat Mozilla nun in Version 2.7.4 veröffentlicht.

Was ist Firefox Relay?

E-Mail-Adressen sind gleichzusetzen mit einer persönlichen Adresse. Sie sind einmalig und viele Nutzer besitzen nur eine einzige E-Mail-Adresse, die sie teilweise auf dutzenden, wenn nicht gar auf hunderten Websites verwenden. Findet auf einer Website, auf der man mit seiner E-Mail-Adresse registriert ist, ein Datendiebstahl statt, wird damit in vielen Fällen auch die persönliche E-Mail-Adresse offengelegt. Und haben Spammer erstmal eine E-Mail-Adresse in ihrem System, darf man sich auf viele unerwünschte E-Mails ohne realistische Hoffnung einstellen, dass der Spam abnehmen wird.

Mit Firefox Relay können sogenannte Masken als Alias-Adressen angelegt werden, die der Nutzer für Newsletter-Anmeldungen und Website-Registrierungen angeben kann. Firefox Relay leitet diese E-Mails dann an die persönliche E-Mail-Adresse weiter. Außerdem kann Firefox Relay bekannte Tracking-Scripts aus E-Mails entfernen.

Firefox Relay ist kostenlos. Es gibt aber auch eine kostenpflichtige Premium-Version, welche unendlich viele Masken anstelle von nur fünf sowie eine eigene E-Mail-Domain erlaubt. Außerdem können in Firefox Relay Premium auf weitergeleitete E-Mails geantwortet und Werbe-Mails automatisch blockiert werden. In den USA sowie Kanada können mittlerweile auch Telefonnummern maskiert werden.

Browser-Erweiterung für Firefox Relay

Die dazugehörige Browser-Erweiterung ist nicht zwingend erforderlich, erleichtert aber das Anlegen neuer Masken, da direkt in E-Mail-Feldern auf Websites ein entsprechendes Symbol erscheint, über welches eine neue Maske angelegt werden kann. Über die Schaltfläche im Erweiterungsmenü erscheinen diverse Statistiken wie die Anzahl verwendeter E-Mail-Masken, blockierter E-Mails, weitergeleiteter E-Mails sowie entfernten E-Mail-Trackern. Darüber hinaus kann die Erweiterung genutzt werden, um ein Problem mit Firefox Relay auf bestimmten Websites zu melden.

Neuerungen der Browser-Erweiterung Firefox Relay 2.7.4

Mit Firefox Relay 2.7.4 gab es weitere Verbesserungen der Webkompatibilität in Zusammenhang mit dem Masken-Symbol in E-Mail-Feldern. Außerdem wurde eine Zufriedenheitsumfrage eingeführt, welche unter bestimmten Voraussetzungen angezeigt werden kann.

Download der Browser-Erweiterung Firefox Relay für Firefox
Download der Browser-Erweiterung Firefox Relay für Google Chrome

Der Beitrag Mozilla veröffentlicht Browser-Erweiterung Firefox Relay 2.7.4 erschien zuerst auf soeren-hentzschel.at.

In den letzten Jahren habe ich mich immer wieder mit Erkenntnissen aus der Lernforschung auseinandergesetzt, um mein persönliches Lernen aber auch das Lernen an unserer Schule stetig zu verbessern. Ein Begriff, der mir dabei immer wieder begegnete, ist „Spaced Repetition“. Was das mit „Lernen ohne zu vergessen“ und mit Anki zu tun, möchte ich in diesem Artikel kurz beschreiben.

Was ist „Spaced Repetion“?

Spaced Repetition kann man am besten mit „zeitlich verteilte Wiederholung“ oder „verteilte Wiederholung“ übersetzen. Im Grunde geht es darum, dass ich Lerninhalte idealerweise dann wiederhole, kurz bevor ich sie vergessen habe. Wenn man Lernen als einen Kampf gegen das Vergessen bezeichnet, ist genau das wichtig: Wiederholen bevor mein Gedächtnis das Gelernte vergessen hat.

Immer dann, wenn ich Gelerntes wiederhole und mich daran erinnern kann, verlängert sich die „Speicherdauer“ in meinem Gedächtnis.

Wir alle kennen diesen Effekt. Wenn ich in meiner Schulzeit für einen Vokabeltest gelernt habe (meist am Tag davor 🙂 ), habe ich die meisten Vokabeln nach 3 Tagen wieder vergessen. Dass ist auch der Grund, warum ich mich nur noch an ganz wenige Französischvokabeln erinnern kann, obwohl ich 5 Jahre Sprachunterricht hatte. Hätte ich jedoch jeden Tag eine kleine Menge an Vokabeln gelernt und wiederholt, hätte ich mich wesentlich länger an sie erinnern können. Hier mal eine Grafik, die das Prinzip veranschaulicht:

Zusammenfassung: Wenn ich etwas Gelerntes im richtigen Moment wiederhole, kann ich die „Speicherdauer“ im Langzeitgedächtnis deutlich verlängern.

Doch woher weiß ich, wann der richtige Zeitpunkt ist, um etwas zu wiederholen? Ich möchte ja nur die Dinge wiederholen, die ich gerade am Vergessen bin und nicht die, die ich noch weiß. Das ist eine sehr wichtige Frage. Wenn ich zu viele Dinge wiederhole (v.a. Lerninhalte, die ich noch weiß), steigt mein zeitlicher Aufwand für die Wiederholungen. Wenn ich zu wenige Lerninhalte wiederhole, steigt die Chance, dass ich Dinge vergesse und ich sie letztendlich neu lernen muss.

Anki

Genau an diesem Punkt kommt Anki ins Spiel. Anki ist eine Open Source Karteikartensoftware, die mir die Arbeit der Berechnung der richtigen Intervalle abnimmt, sodass ich nur noch das wiederhole, was ich kurz vor dem Vergessen bin. Das genau ist es, was diese Lernmethode so effizient macht, denn nun kann ich Dinge in weniger Zeit lernen bzw. mehr in der gleichen Zeit, die ich bisher zum Lernen aufgewendet habe.

Anki ist eine sehr mächtige und flexible Anwendung, die sich durch viele Erweiterungen anpassen lässt. Das sorgt auch dafür, dass die Lernkurve für diese App etwas steiler ist. Deshalb empfehle ich, dass man sich am besten ein paar einführende Videos anschaut.

Karteikarten kann man sich entweder selbst erstellen oder nutzt eines der fertigen Lernpakete.

Lernen ohne zu vergessen – eine Utopie?

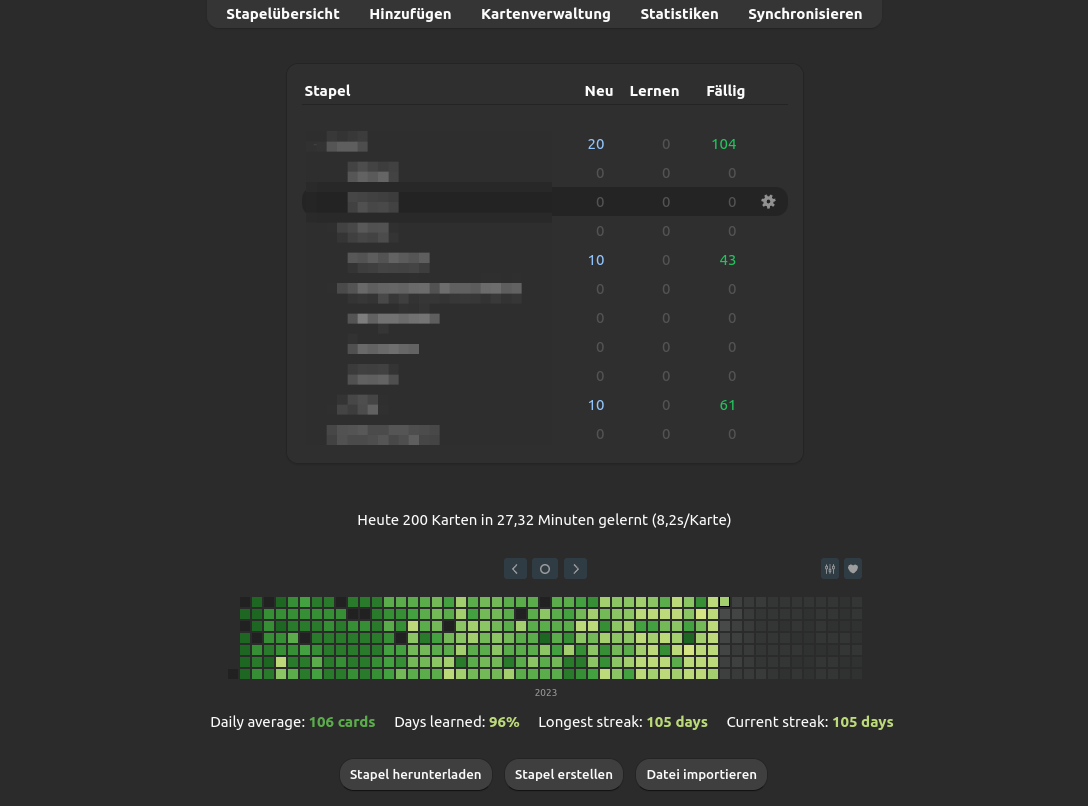
Persönlich nutze ich Anki seit ca. 1 Jahr. Hauptsächlich lerne ich damit Vokabeln (ja, auch wieder Französisch…), Bibelverse / -texte, Markierungen / Zitate aus Büchern, die ich gelesen habe und alles, was mich sonst noch so interessiert. Ich bin total begeistert von den Ergebnissen. Ich hätte nicht gedacht, dass es so leicht ist, sich Dinge langfristig im Gedächtnis zu behalten.

Wo ist der Haken? Damit das mit den Wiederholen zum richtigen Zeitpunkt auch klappt, muss ich meine Wiederholungen jeden Tag machen. Je nachdem wie viele Karten man lernt, können das 5 Minuten am Tag sein oder auch 2 Stunden. Der Schlüssel zum Erfolg ist die tägliche Wiederholung. Es dauert vielleicht ein paar Wochen bis man diese neue Gewohnheit in seinen Alltag integriert hat, aber man wird belohnt mit der Erfahrung, dass dieses Prinzip der verteilten Wiederholung wirklich funktioniert und unser Gedächtnis sich viele (sehr viele) Dinge merken kann.

Der Beitrag Lernen ohne zu vergessen mit Anki erschien zuerst auf zefanjas.