staging.inyokaproject.org

2024 Woche 13

31. März 2024

Mozilla hat über seinen Risikokapitalfonds Mozilla Ventures in Holistic AI investiert.

Mozilla Ventures ist ein Ende 2022 gestarteter und mit anfänglich 35 Millionen USD ausgestatteter Risikokapitalfonds, über welchen Mozilla in Startups investiert, welche das Internet und die Tech-Industrie in eine bessere Richtung bringen. Nach der Investition in das deutsche KI-Startup Flower Labs hat Mozilla Ventures nun seine zweite Investition dieses Jahres bekannt gegeben.

Mit Holistic AI hat Mozilla Ventures in den nach Angaben von Mozilla weltweit führenden Anbieter von verantwortungsvoller KI investiert, welcher Fortune-500-Konzerne, kleine und mittlere Unternehmen, Regierungen und Aufsichtsbehörden unterstützt. Demnach bietet Holistic AI End-to-End-Lösungen für KI-Governance an, einschließlich KI-Vertrauen, Risiko, Sicherheit und Compliance, die es Unternehmen ermöglichen, Künstliche Intelligenz in großem Umfang einzuführen.

Alle Investitionen und Akquisitionen von Mozilla

Der Beitrag Mozilla Ventures investiert in Holistic AI erschien zuerst auf soeren-hentzschel.at.

Mein Heimserver ist seit Jahren über eine dynamische-DNS-Adresse von spDYN per SSH erreichbar. Da ich einer der letzten glücklichen kleinen Lichter bin, die noch eine echte IP4-Adresse erhalten (und keine genattete), kann ich mich so immer von überall auf meine Kiste einloggen.

Bislang habe ich meine aktuellen IP-Adressen mittels Script geupdatet. Im Zuge notwendiger Aktualisierungen bin ich über ddclient gestolpert und nutze es seit dem ausschließlich - mein Script ist in Rente gegangen.

ddclient

ddclient ist ein Perl-Client, der dynamische DNS-Einträge für Konten vieler dynamischer DNS-Dienste aktualisieren kann. Auf der Github-Seite steht eine Liste der kompatiblen Dienste bereit, viele weitere Dienste funktionieren aber ebenfalls, da sie die selben Protokolle verwenden.

Ich nutze ddclient mit folgenden freien DynDNS-Anbietern:

Da ich einen echten Dual-Stack habe, sollen IPv4 und IPv6 gleichzeitig aktualisiert werden.

Installation

ddclient kann installiert werden mittels:

# Ubuntu
sudo apt-get install ddclient

# Arch, btw
pacman -S ddclient

Konfiguration

systemd

Ich bereite mir ein Systemd-Skellet vor, so dass ich alle .conf-Dateien im Verzeichnis /etc/ddclient/ steuern kann.

sudo nano /etc/systemd/system/ddclient@.service

[Unit]
Documentation=man:ddclient(8)
Description=Update dynamic domain name service entries
After=network-online.target
Wants=network-online.target

[Service]
Type=forking
Environment=daemon_interval=10m
EnvironmentFile=-/etc/default/ddclient
ExecStart=/sbin/ddclient -syslog -file /etc/ddclient/%I.conf -cache /var/cache/ddclient/%I.cache
Restart=on-failure

[Install]
WantedBy=multi-user.target

Jetzt müssen die Services neu geladen werden,…

sudo systemctl daemon-reload

…und schon kann es losgehen. Alle FOO.conf-Dateien im Verzeichnis /etc/ddclient lassen sich nun steuern mittels systemctl start ddclient@FOO (ohne .conf).

Dafür müssen wir aber diese Config-Dateien erstellen, und wir sollten wissen, wie wir unsere “echten” globalen IPv4 und IPv6-Adressen abrufen können.

IP-Adressen abrufen

ddclient kann die Adressen entweder über die Interfaceschnittstelle oder über das Web beziehen. Das führt bei mir allerdings zu Probleme:

  • über die Interface-Schnittstelle (z.B. eth0) finde ich nur meine lokal LAN-IP (weil ich hinter meiner FritzBox sitze)
  • über die web-Methode finde ich nur eine IPv6-Adresse, nicht aber meine IPv4.

Daher muss ich sicherstellen, dass für IPv4 wirklich die gültige IPv4 gefunden wird, und für IPv6 ebenso. Ich kann diese externen IP-Adressen mittels curl abrufen:

# externe IPv4
curl -s4 http://ifconfig.me/ip

# externe IPv6
curl -s6 http://ifconfig.me/ip

Dies mache ich mir in ddclient zu nutze, denn neben “Interface” und “Web” kann über den Parameter cmd= ein custom Script angegeben werden, welches die IP-Adressen ermittelt. Ich erzeuge mir diese Scripte jeweils für IPv4 und IPv6 direkt im Verzeichnis /etc/ddclient.

sudo nano /etc/ddclient/myipv4address.sh

curl -s4 http://ifconfig.me/ip

sudo nano /etc/ddclient/myipv6address.sh

curl -s6 http://ifconfig.me/ip

Die Scriptdateien müssen noch ausführbar gemacht werden: sudo chmod +x /etc/ddclient/myipv6address.sh /etc/ddclient/myipv4address.sh

ddclient für meinen Anbieter konfigurieren

Für jeden DynDNS-Dienst lege ich mir eine eigene Config-Datei an. So sieht z.B. meine Client-Config für DuckDNS aus:

sudo nano /etc/ddclient/duckdns.conf

daemon=300                       # check every 300 seconds
syslog=yes                       # log update msgs to syslog
pid=/var/run/ddclientduckdns.pid # record PID in file.
ssl=yes                          # use ssl-support.
debug=yes                        # write to journal log
verbose=yes                      # write to journal log
usev4=cmdv4, cmdv4=/etc/ddclient/myipv4address.sh # IPv4
usev6=cmdv6, cmdv6=/etc/ddclient/myipv6address.sh # IPv6

#### DUCKDNS.org ########
#------------------------
protocol=duckdns,    # Komma muss bleiben
password=9a5dc6a5-FUCK-AFD-bbaf-foobar # ersetze dein Token
YOURNAME.duckdns.org # deinen Namen ersetzen

Für Dynv6.com sieht diese so aus:

sudo nano /etc/ddclient/dynv6.conf

daemon=300                     # check every 300 seconds
syslog=yes                     # log update msgs to syslog
pid=/var/run/ddclientdynv6.pid # record PID in file.
ssl=yes                        # use ssl-support.
debug=yes                      # write to journal log
verbose=yes                    # write to journal log
usev4=cmdv4, cmdv4=/etc/ddclient/myipv4address.sh # für IPv4
usev6=cmdv6, cmdv6=/etc/ddclient/myipv6address.sh # für IPv6

#### DYNv6.com ##########
#------------------------
protocol=dyndns2
server=dynv6.com
password='sKx3hF_stPT_fuck_AfD_1rPmskxiTga' 
login=none
YOURNAME.dynv6.net

ddclient starten

Zunächst können die Einstellungen getestet werden, ohne Daten zum Server zu senden:

ddclient -daemon=0 -debug -verbose -noquiet -file /etc/ddclient/dynv6.conf

Sieht alles gut aus, können wir die Dienste wie folgt aktivieren:

# aktivieren und starten
sudo systemctl enable --now ddclient@duckdns
sudo systemctl enable --now ddclient@dynv6

# Logs ansehen
journalctl -u ddclient@duckdns -f
journalctl -u ddclient@dynv6 -f

Tolle Sache, funktioniert prima!

Weblinks


30. März 2024

Als diese Meldung heute morgen über die Kanäle ging, musste ich mehrmals nachschauen, ob wir nicht den 1. April haben. Durch eine mutmaßlich bösartige Übernahme der Entwicklung wurde xz-utils gezielt kompromittiert. Betroffen sind die aktuellen Versionen 5.6.0 und 5.6.1 und wichtige Distributionen wie Debian, Fedora oder openSUSE.

Das Paket XZ-utils (früher als LZMA-Utils bekannt) ist eines dieser zentralen Hintergrundtools der freien Softwarewelt. Wer seine Paketverwaltung nicht genau im Blick hat, bemerkt diese kleinen zentralen Bausteine, auf denen die Distributionen fußen gar nicht mehr. Es handelt sich um einen Datenkompressionsalgorithmus (vergleichbar zu gzip). Diese Werkzeuge sind wichtig, aber chronisch wenig beachtet und damit ein ideales Einfallstor.

Die gute Nachricht vorweg: Da das Problem sehr schnell bekannt wurde, sind nur sehr aktuelle Distributionen betroffen, d.h. primär Rolling-Release-Distributionen und aktuelle Entwicklungszweige wie Fedora 40. In Ubuntu 24.04 konnte das Paket nicht erfolgreich platziert werden. Die gängigen Enterprise-Distributionen sind aufgrund der deutlich längeren Entwicklungszeit nicht betroffen. Hier erweisen sich stabile Distributionen mit langen Supportzeiträumen mal wieder als überlegen, weil neue Versionsstände dort erst nach mehreren Jahren Einzug halten. Das schützt nicht hundertprozentig vor solchen Fehlern, lässt aber mehr Zeit für die Entdeckung dieser Probleme. So wie das aktuell der Fall ist. Der Code ist gegenwärtig nicht öffentlich einsehbar, da das Quellcode-Repo auf GitHub nach Bekanntwerden des Problems durch Microsoft gesperrt wurde.

Die Schadsoftware öffnet eine Backdoor und lässt potenziell einen unbefugten Fernzugriff via SSH zu. Die Lücke ist kein Versehen, sondern wurde bewusst eingebaut und verschleiert. Der verantwortliche Entwickler hat offensiv versucht, die schadhafte Version in zentrale Distributionen zu bringen. Das zeigt der entsprechende Launchpad-Eintrag für Ubuntu. Um die Lücke auszunutzen ist eine Kette an Voraussetzen notwendig, wie z.B. eine x86-64 Architektur, die Verwendung von glibc und das Paketformat DEB oder RPM. Die Funktionsweise hat Viktor Garske in seinem Blog sehr anschaulich erklärt. Alles nicht besonders exotisch. Der aktuellen Informationsstand kann bei GitHub nachgelesen werden. Einige Fragen sind noch offen und müssen geklärt werden. Es ist gut möglich, dass noch andere Angriffsvektoren bekannt werden. Klar ist aber schon, dass das Bedrohungspotenzial immens ist.

Das Ziel der Angreifer war es vermutlich, unbemerkt einen zentralen Baustein der Linux-Distributionen anzugreifen. Die Fokussierung auf RPM- und DEB-basierte Distributionen legt den Schluss nahe, dass verbreitete Server-Distributionen das Ziel waren. Das ist keineswegs abwegig, denn wäre die Lücke nicht durch Performanceprobleme bei aktuellen Entwicklungsversionen aufgefallen, dann wäre sie mittelfristig in die Enterprise-Systeme eingeflossen. In wenigen Jahren wären diese Systeme dann angreifbar gewesen.

Der Angriff trifft die Open-Source-Entwicklung an einigen ihrer wunden Punkte. Viele Projekte werden von kleinen Teams oder sogar nur durch einzelne Entwickler gepflegt. Das liegt an der chronischen Unterfinanzierung der zentralen Projekte, an der mangelnden Attraktivität, sich in diesen Hintergrundprojekten zu engagieren und manchmal auch an den rauhbeinigen Maintainern, die nicht gerade zur Mitarbeit einladen. Hier scheint sich ein neuer Akteur über Jahre eine Reputation aufgebaut zu haben, den bis dahin zuständigen Maintainer mittels Druck an die Seite geschoben und erst dann den komplexen Schadcode eingebaut zu haben. Eine Überprüfung durch mehrere Augen scheint nicht stattgefunden zu haben. Der frühere Hauptentwickler ist derzeit nicht erreichbar, was aber wohl schon öfter vorgekommen ist. Ein weiteres Problem ist der Unterschied zwischen dem Code auf GitHub und den Release-Tarballs. Das passiert häufiger als man denkt. Der offen sichtbare Code hat dann keine Schwachstelle, der Code im Tarball aber schon. Reproduzierbarkeit ist deshalb seit vielen Jahren ein wichtiges Thema in der Linux-Gemeinschaft.

Das Problem darf nicht verharmlost werden und muss weiter aufgearbeitet werden. Die große Katastrophe blieb aus, weil der Schadcode nicht in die Enterprise-Versionen gelangte und schnell erkannt wurde. Der Vorfall legt aber einmal mehr den Finger in die offenen Wunden der Open-Source-Entwicklung. Prinzipiell lassen sich mit einem solchen Vorgehen viele Projekte mit recht hoher Erfolgswahrscheinlichkeit infiltrieren. Kleine Teams, wenig Kontrolle, unterschiedliche Code-Stände im Repostitorium und Release – alles bekannte Probleme. Durch seine große Bedeutung für die Infrastruktur ist Linux ein Hochwertziel, das solchen Aufwand für die Angreifer vermutlich rechtfertigt.

Die weitverbreiteten Datenkompressionswerkzeuge XZ Utils (früher LZMA Utils) enthalten in Version 5.6 eine Backdoor. Ziel der Backdoor ist nach aktuellem Kenntnisstand eine Kompromittierung von SSH-Servern. Dies wurde gestern auf der oss-security-Mailingliste von Andres Freund nebst einer umfangreichen Analyse des Sachverhalts bekannt gegeben. Durch den Einsatz der Werkzeuge in Linux-Distributionen haben wir hier einen Fall einer Supply-Chain-Attacke. Red Hat hat dem Vorfall die CVE-Nummer CVE-2024-3094 vergeben.

Vorab eine Liste mit weiteren Links:

Wirkungsweise

Dabei wird die Backdoor nur unter bestimmten Bedingungen ausgeführt, wie das FAQ beschreibt. Im Wesentlichen muss argv[0] auf /usr/sbin/sshd gesetzt sein und eine Reihe an Umgebungsvariablen entweder gesetzt oder nicht gesetzt sein. Normalerweise hängt OpenSSH nicht von liblzma ab. Einige Distributoren patchen OpenSSH allerdings so, dass systemd-Notifcations funktioniert, welches wiederum auf liblzma setzt und die Backdoor möglich macht. Technisch werden einige Checks durchgeführt und anschließend mittels IFUNC Bibliotheksaufrufe umgeleitet. Dies betrifft nach aktuellem Stand auch Aufrufe während der Kryptoroutinen bei der SSH-Authentifizierung.

Betroffenheit

Der Wirkungsweise der Payload ist noch nicht abschließend geklärt. Besonders auch aus diesem Grund wird ein unverzügliches Update angeraten. Im Folgenden einige unverbindliche Faktoren, die eine Verwundbarkeit wahrscheinlich machen. Auf diese Weise kann man priorisieren, welche Systeme zuerst aktualisiert werden sollten.

Versionierte Distros wie z. B. Debian oder RHEL sind nach aktuellem Kenntnisstand mit ihren stabilen Versionen nicht direkt betroffen, da die Versionen 5.6 noch keinen Einzug in das System gefunden haben. Die Testing-Versionen dieser Distros wie z. B. Debian Sid wurden allerdings aktualisiert und sind betroffen.

Rolling-Release-Distros sind naturgemäß auch betroffen, wenn sie schon Version 5.6 in ihre Pakete aufgenommen haben. Dies betrifft zum Beispiel Arch Linux oder Gentoo. Da allerdings einige Distributionen wie Arch Linux OpenSSH nicht gegen liblzma linken, wird die Bibliothek nicht direkt in die Ausführung der Komponenten eingebunden.

Nach aktuellem Stand wird eine Verwundbarkeit besonders kritisch, wenn auf dem betroffenen Host ein öffentlich erreichbarer SSH-Server läuft, da die oben beschriebenen Faktoren ein Laden der Payload auslösen können.

Wie kam es?

Aufgefallen ist die Backdoor nur durch Zufall durch das Debugging von Performanceproblemen, die durch die Backdoor verursacht wurden. Die Backdoor wurde obfuskiert im Rahmen von Buildskripten untergebracht, sodass aufgrund der Komplexität die Lücken noch nicht direkt aufgefallen sind.

Das Repository hinter xz kann als kompromittiert gesehen werden und ist auch auf GitHub schon gesperrt worden. Auffällig ist, dass die Backdoor in den Tarballs der Releases enthalten war, nicht jedoch im Repository-Dump selber. Auch personell gab es einige Auffälligkeiten, da es vor kurzem einen Maintainerwechsel beim Projekt gab und die Lücken vom neuen Maintainer, der seit 2 Jahren am Projekt mitarbeitet, zumindest begünstigt wurden. Die Art und Weise lässt auch auf ein koordiniertes, von langer Hand geplantes Vorgehen schließen.

Einfluss und Folgen

Das große Ganze ist ein Paradebeispiel von xkcd 2347 "Dependency". Wir sehen hier Live ein Beispiel einer Supply-Chain-Attacke. Ein kleines, scheinbar unbedeutendendes Projekt wird übernommen, nur um strategisch Commits zu platzieren, die automatisch "flussabwärts" ihren Weg in größere Distributionen finden, die allesamt auf das Projekt setzen. Alles passiert trotz Open Source. Besonders pikant: der Maintainer hat aktiv versucht, die Backdoor-begünstigenden Umgebungsfaktoren, konkret das Umbiegen von Bibliotheksaufrufen mittels ifunc, in Fuzzing-Projekten wie oss-fuzz, die aktiv nach sowas suchen, zu deaktivieren.

Software wird immer bedeutender und benötigt Vertrauen. Dabei ist jetzt schon klar, dass niemand selber solch komplexe Systeme von alleine bauen kann. Aber auch die Kontrolle der Quellen ist eine große Herausforderung. Neue Gesetzgebung wie der geplante Cyber Resilience Act in der EU versuchen in der Industrie Anreize zu schaffen, die Softwarequalität zu erhöhen.

Diese Attacke konnte einigermaßen abgewendet werden, sollte die umfassende Analyse der Payload keine belastenden Neuigkeiten hervorbringen. Eines ist aber auch klar: Die Angreifer studieren das Verhalten der Verteidiger und werden in Zukunft ihre Vorgehensweise dahingehend optimieren, nicht so einfach mehr gefunden zu werden. Es ist also möglich, Backdoors in so ein Ökosystem hineinzuschummeln. Umso besser müssen aber die Identifikations- und Abwehrmöglichkeiten werden, damit solche Angriffe wirksam verhindert werden können.

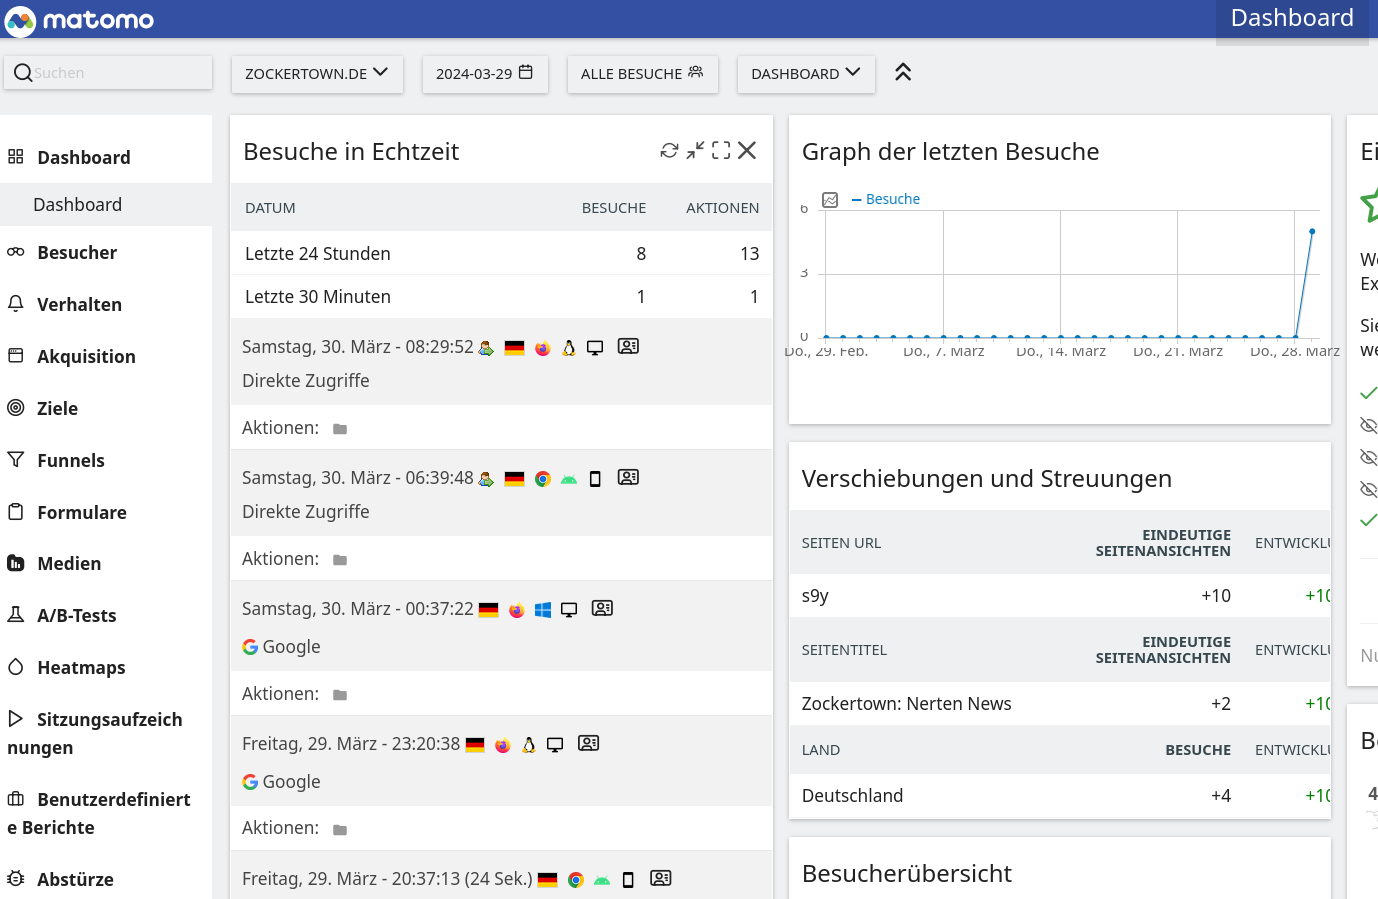
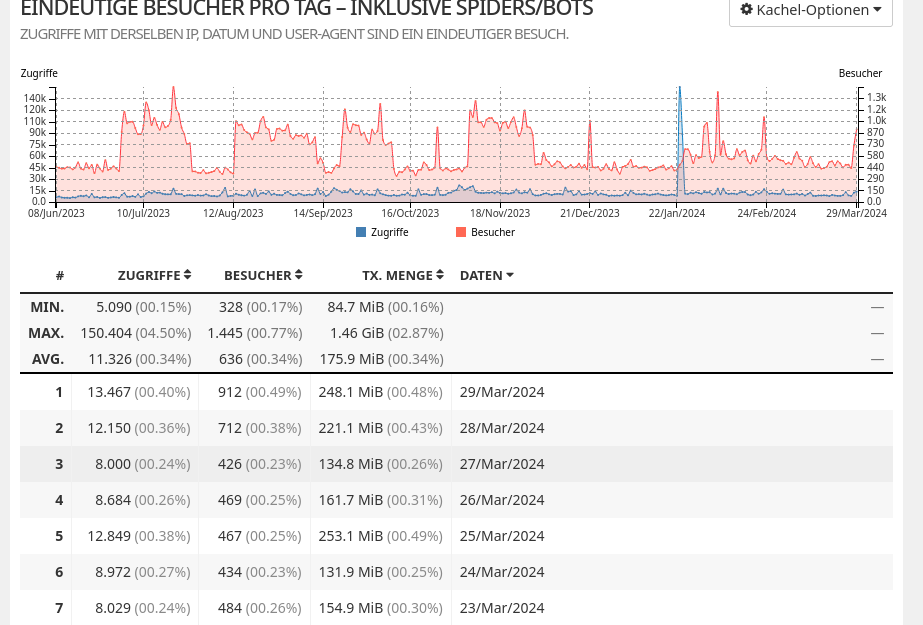
Ein wichtiger Unterschied zwischen Matomo und GoAccess ist, dass Matomo ein JavaScript-Tracking-Code erfordert, der in den Header der überwachten Website eingefügt werden muss. Dies wird dazu führen, dass Matomo-Daten durch Ad-Blocker oder ähnliche Tools blockiert werden, was die Genauigkeit der Analysen je nach Art der Webseite extrem beeinträchtigen kann. Ein Beispiel ist meine Site zockertown.de. Hier haben viele Besucher einen Informatik-, Linux Sachverstand und man kann annnehmen, dass hier nahezu Jeder einen Adblocker nutzt, oder javascript  blockt.

Im Gegensatz dazu analysiert GoAccess nur die Webserver-Logdateien direkt, ohne dass zusätzlicher Code in die Website eingefügt werden muss. Dies bedeutet, dass GoAccess nicht von Ad-Blockern oder ähnlichen Tools behindert wird und möglicherweise eine zuverlässigere Datenerfassung ermöglicht.

Ein konkretes Beispiel dazu.

Dieser Unterschied ist enorm. wenn man zwischen Matomo und GoAccess wählt. Wenn die Genauigkeit der Daten wichtig ist und man bereit ist, den zusätzlichen Aufwand für die Implementierung des JavaScript-Tracking-Codes in Kauf zu nehmen, könnte Matomo die bessere Wahl sein. Wenn man jedoch eine einfachere, unkomplizierte Lösung bevorzugt, die nicht von Ad-Blockern beeinflusst wird, könnte GoAccess für Ihre Anforderungen geeigneter sein.

Ein wichtiger Aspekt bei der Auswahl eines Analysetools sind Datenschutzbedenken.

Matomo, als selbstgehostete Lösung, ermöglicht  den Nutzer, die volle Kontrolle über die Daten zu behalten. Da Matomo auf eigenen Servern läuft, hat man die Möglichkeit, die Datenschutzrichtlinien und Sicherheitsmaßnahmen nach seienem eigenen Standards anzupassen.

Auf der anderen Seite analysiert GoAccess die Webserver-Logdateien direkt, ohne dass Daten an Dritte gesendet werden. Da keine Daten an externe Server übertragen werden, kann dies als datenschutzfreundlichere Option angesehen werden. Zusätzlich werden bei mir die Log sowieso anonymisiert, damit komme ich gar nicht in die Verlegenheit über DSGVO Konformität nachzudenken.

Wer Matomo verwendet, sollte den Besucher deutlich darauf hinweisen, dass hier ein Tracking erfolgt und auch ohne Cookies funktioniert. Wenn der Nutzer das Script aber blockiert, wird gar nichts aufgezeichnet, noch nicht einaml der Besuch sebst, es ist, wie in den Screenshots deutlich zu sehen, als wäre der Besucher gar nicht da gewesen. Das kann ja auch keine Lösung sein.

Aus meiner Sicht geht es gar nicht schlimmer. Matomo kann zwar auch das Webserver Logfile auswerten, aber das habe ich jetzt nicht mehr ausprobiert.

Die Datenschutzrichtlinien und -funktionen beider Tools sollte man sorgfältig zu prüfen, um sicherzustellen, das sie den geltenden Datenschutzbestimmungen entsprechen.

Matomo mag seine Berechtigung bei kommerziellen Websites haben, die Möglichkeiten sind beeindruckend, gegen die tracking Aspekte gibt es auch noch die Bilder Tracking Methode u.a.,

aber für mich kommt es gar nicht in Frage.

Ausserdem fiel mir auf, dass der Zugriff mit javascipt tracking erheblich länger dauerte.

Im hohen einstelligen Sekundenbereich

Also GoAccess!

29. März 2024

Mit Common Voice stellt Mozilla den weltweit größten öffentlichen Datensatz menschlicher Stimmen bereit – kostenlos und für jeden nutzbar. Mozilla hat Version 17.0 seines Datensatzes veröffentlicht.

Der Markt für Spracherkennung wird von den ganz großen Namen kommerzieller Anbieter dominiert: Amazon, Apple, Google, Microsoft. Darum hat Mozilla im Jahr 2017 das Projekt Common Voice gestartet. Mit Common Voice bietet Mozilla eine kostenlose Alternative an, zu der jeder beitragen kann und die jedem zur Verfügung steht. Damit möchte Mozilla Innovation und Wettbewerb in der Sprachtechnologie auf Basis von Maschinenlernen fördern.

Mit dem vor kurzem veröffentlichten Common Voice Corpus 17.0 wächst der deutschsprachige Datensatz von 1.403 auf 1.424 Stunden an. Wer bereits den Common Voice Corpus 16.1 besitzt, kann wie immer auch nur ein sogenanntes Delta Segment mit den Unterschieden zur Vorversion herunterladen. Für Deutsch würde das den Download von 33,4 GB auf 625 MB reduzieren.

Insgesamt deckt Mozilla Common Voice mit der neuen Version jetzt 124 Sprachen mit insgesamt 31.176 aufgenommenen Stunden ab, was Mozilla Common Voice zum vielfältigsten mehrsprachigen Sprachkorpus der Welt macht.

Zum Download der Mozilla Common Voice Datensätze

Der Beitrag Mozilla veröffentlicht Common Voice Corpus 17.0 erschien zuerst auf soeren-hentzschel.at.

27. März 2024

Erst im Februar hatte Mozilla in Zusammenarbeit mit Onerep Mozilla Monitor Plus in den USA gestartet. Diese Zusammenarbeit kommt nun zu einem unerwarteten Ende.

Das ist Mozilla Monitor (Plus)

Mozillas kostenfreier Dienst Mozilla Monitor zeigt nach Eingabe einer E-Mail-Adresse an, ob diese Teil eines bekannten Datendiebstahls in der Vergangenheit war. Neben dem Zeitpunkt des Diebstahls und dem Zeitpunkt des Bekanntwerdens wird auch angegeben, welche Daten gestohlen worden sind, zum Beispiel E-Mail-Adressen, Benutzernamen oder Passwörter. Darüber hinaus nennt Mozilla Monitor allgemeine Tipps, welche man in Betracht ziehen sollte, wenn man von einem Datendiebstahl betroffen ist.

Anfang Februar dieses Jahres ist Mozilla Monitor Plus gestartet, bisher nur in den USA. Damit können persönliche Informationen von über 190 Personen-Suchmaschinen entfernt werden – einer laut Mozilla 240 Milliarden Dollar schweren Industrie, welche mit der Bildung von Profilen und dem Verkauf dieser Daten Profit generiert. Hierfür arbeitet Mozilla mit dem Dienstleister Onerep zusammen.

Ende der Zusammenarbeit mit Onerep

Nach einem Bericht von Brian Krebs, Journalist und Betreiber des Sicherheits-Blogs Krebs on Security, hat der Gründer und CEO von Onerep, Dimitiri Shelest, seit 2010 selbst zahlreiche solcher Personen-Suchmaschinen ins Leben gerufen. In diese ist er größtenteils nicht mehr involviert, ist mit Nuwber allerdings nach wie vor an einer beteiligt.

Auch wenn für Nutzer von Mozilla Monitor Plus durch die Verbindung keine direkte Problematik entstand, hat Mozilla das Thema damit kommentiert, dass die finanziellen Interessen und Aktivitäten des CEOs von Onerep nicht den Werten von Mozilla entsprechen. Mozilla Monitor Plus wird es weiterhin geben, aber Mozilla soll an einem „Übergangsplan“ arbeiten, welcher „den Kunden eine nahtlose Erfahrung bietet und ihre Interessen weiterhin an die erste Stelle setzt“. Weitere Details wurden keine genannt. Denkbar wäre, dass Mozilla die gleiche Dienstleistung in Zukunft über einen anderen Anbieter abwickeln wird.

Der Beitrag Mozilla Monitor Plus: Mozilla beendet Zusammenarbeit mit Onerep erschien zuerst auf soeren-hentzschel.at.

25. März 2024

Wer Projekte per git auf dem aktuellen Stand halten will, aber sonst nicht viel mit git macht, braucht immer mal wieder dieselben Befehle, um die notwendigen Aktualisierungen durchzuführen. Da sind dann immer wieder diese Leute, die dann ein paar Befehle rüber werfen, aber nicht wirklich zwei klärende Worte zum Zusammenhang hinzufügen. Das Problem ist zwar damit vielleicht aus der Welt, aber es ist nichts damit gewonnen. Konfuzius rotierte im Grabe!

Gib einem Mensch einen Fisch und du ernährst ihn für einen Tag. Lehre einen Menschen zu fischen und du ernährst ihn für sein Leben.

Konfuzius

Wenn die Mehrzahl der EmpfehlerInnen nach dieser Maxime handeln würden, wäre das Frustrationspotential auf Myriaden von Webseiten und Foren nicht so hoch. Das musste ich mal los werden.

Ich gehe am praktischen Beispiel des Fediverse Servers Friendica vor. Den geübten Umgang mit z.B. Linux und der Konsole bzw der Shell Bash setze ich voraus. Ebenso ein installiertes git .

Git und das Repo

Das Software Repository, oft auch nur Repository oder Repo genannt, von Friendica liegt z.B. auf https://github.com/friendica/friendica . Das ist der Speicherort, auf dem die Software liegt und von Entwicklern gepflegt, programmiert und aktualisiert wird. Git ist eine Software, die gleichzeitig verschiedene Versionen von Dateien verwalten kann und für die Softwareentwicklung entwickelt wurde. Kurz gesagt ermöglicht sie es sehr einfach recht komplexe Version- Upgrades oder Downgrades absolut korrekt durchzuführen, so dass als Ergebnis immer eine saubere und lauffähige Version der Software bzw des Quellcodes herauskommt.
Mehr zum Thema git

Schritt 1: Die Software installieren – Das Repo clonen

Ich nehme mal an, du willst Friendica auf deinem Server installieren und hast das Webverzeichnis für deine Domain www.MeineDomain.de eingerichtet, das sich z.B. unter /var/web/MeineDomain/htdocs befindet. Und genau hier willst du Friendica installieren, daher wechselst du in dieses Verzeichnis. Das Verzeichnis muss komplett leer sein, sonst weigert sich git die Dateien hier abzulegen.

Der Befehl der dafür vorgeschlagen wird, ist oft

git clone https://github.com/friendica/friendica

ABER! Dieser würde dir in deinem /var/web/MeineDomain/htdocs/ Verzeichnis ein Unterverzeichnis friendica /var/web/MeineDomain/htdocs/friendica/anlegen und dort alle Dateien und Verzeichnisse ablegen. Und dein Server wäre dann nur unter www.MeineDomain.de/friendica/ erreichbar. Aber du möchtest, dass der Friendica Server unter www.MeineDomain.de erreichbar ist.

Daher musst du dem vorgeschlagenen Befehl noch ein Leerzeichen (Trenner) und einen Punkt (repräsentiert immer das aktuelle Verzeichnis) mitgeben, mit dem du angibst, dass die Dateien im aktuellen Verzeichnis abgelegt werden. Und dann sieht das so aus:

git clone https://github.com/friendica/friendica .

Damit liegt nun die Software, genauer gesagt die stable (früher master) Version, auf deinem Server und du kannst mit der Konfiguration und Einrichtung beginnen. Die Dokumentation dazu findest du unter https://wiki.friendi.ca/ .

Da die Addons für Friendica ein einem extra Repo https://github.com/friendica/friendica-addons liegen, müssen diese natürlich mit den gleichen Schritten eingerichtet und später dann auch aktualisiert werden.

Schritt 2: Aktualisierungen

In so einem Software Repo wird in den meisten Fällen nicht nur eine Software Version gepflegt, sondern meist mehrere. Eigentlich sind immer stable und develop bzw origin/stable und origin/develop verfügbar. Wie oben schon erwähnt hieß stable früher standardmäßig master, aber in modernen Repos gibt es nur noch den Namen stable oder öfter main. Hintergründe Bei Friendica heisst die aktuelle stabile Version stable.

Info: Für Friendica ist ein wenig mehr erforderlich. Die kompletten Befehle führe ich weiter unten auf. Aus Gründen der Verständlichkeit vereinfache ich die Vorgehensweise hier.

Ganz allgemein: Um deine Software zu aktualisieren wechselst du zukünftig in dein Verzeichnis /var/web/MeineDomain/htdocs/ und gibst den Befehl ein

git pull

und dein Friendica wird auf den neusten Stand gebracht. (Addons nicht vergessen)

Schritt 3: Versionen und branches

Nun gibt es wie oben schon geschrieben meist mindestens 2 Versionen. Die stable und die development Version. Die Versionen in git werden branches genannt. Welche branches du hast, kannst du ganz einfach herausfinden mit den Befehlen

Welche Branches liegen (remote) auf dem Software Repo
git branch -r

ergibt z.B. so eine Ausgabe

 origin/2022.09-rc
 origin/2022.12-rc
 origin/2023.03-rc
 origin/2023.05-rc
 origin/2023.09-rc
 origin/2024.03-rc
 origin/HEAD -> origin/develop
 origin/develop
 origin/stable

Welche Branches liegen (lokal) deinem Server
git branch -a

Um zu einem anderen branch bzw Version zu wechseln, gibst du einfach z.B. ein

git checkout develop um auf die Entwicklerversion zu wechseln
git checkout stable um auf die stabile Hauptversion zu wechseln.

Allerdings sollte so ein Wechsel immer gut durchdacht sein, denn oftmals kann das weitere Abhängigkeiten haben, wie zum Beispiel bei Friendica irgendwelche Updates von Datenstrukturen in der Datenbank. Älter Versionen kennen neuere Datenbankstrukturen nicht und das wird dann vermutlich zu Fehlern führen. Prüfe stehts!

Schritt 4: Updates und Versionen – development, stable & RC

Es gibt also die development Version, die immer die neusten Funktionen und Features hat, die aktiv entwickelt werden und daher mit einer hohen Wahrscheinlichkeit Fehler enthalten, die noch korrigiert (gefixt) werden müssen. Und die stabile stable Version, die zum produktiven Einsatz freigegeben wurde.

Dann gibt es oft noch RC (Release Candiates) Versionen. Zum Beispiel eine 2024.04-RC . Das ist eine aktuelle development Version, zu der keine neuen Features dazu kommen (Feature Freeze) und die zur nächsten stabilen Version werden soll. Diese Version ist mit einer öffentlichen Beta Version vergleichbar, die zur Verfügung gestellt wird, damit sie von vielen getestet und eventuelle Fehler behoben werden können. Wenn dann alle Fehler behoben sind, dann wird diese 2024.04-RC Version in die stable Version überführt.

Das heißt, wenn die Aktualisierung des eigenen Friendica Servers immer auf das branch stable eingestellt ist, dann wird beim nächsten git pull der Server automatisch auf die neuste Version aktualisiert. Wurde zuvor auf z.B. auf das RC 2024.04-RC branch gewechselt, muss natürlich dann aktiv auf das stable branch wieder zurück gewechselt werden. git checkout stable & git pull

Friendica per Git aktualisieren

Bei Friendica gibt es wie beschrieben noch das addon Verzeichnis und zusätzlich noch den Composer, der Abhängigkeiten von bestimmten Softwarebibliotheken verwaltet und sicherstellt, dass die richtigen Versionen auf deinem Server liegen. Daher müssen bei einer Aktualisierung mindestens folgende Befehle eingegeben werden.

Ausgehend dass du dich in deinem deinem Verzeichnis /var/web/MeineDomain/htdocs befindest:

git pull https://github.com/friendica/friendica.git
bin/composer.phar install --no-dev 
cd addon 
git pull https://github.com/friendica/friendica-addons.git 

weitere nützliche Git Befehle

git fetch – Die Liste der Branches vom Repo holen
git checkout – Den Branch wechseln
git stash – Local commits „verwerfen“
git checkout -b – Lokal einen neuen Branch erstellen
git branch -D – Lokalen Branch löschen
git push origin --delete – Den remote Branch löschen
git branch -r – Remote Branches anzeigen lassen
git branch -a – Lokale Branches anzeigen lassen
git remote prune origin – Löscht alle lokalen Branches, die auch nicht mehr auf dem remote Repo sind
git gc --auto – Garbage Collection. führt Aufräumarbeiten durch (komprimiert Revisionen, entfernt lose/unzugängliche Objekte). Mit der Option –auto wird zunächst festgestellt, ob Maßnahmen erforderlich sind, und wenn dies nicht der Fall ist, wird das Programm beendet, ohne etwas zu tun.

Falls es zu Fehlermeldungen und größeren Problemen kommt, dann sind folgende Befehle hilfreich. ABER bitte vorher das Handbuch dazu lesen !!! Nicht einfach per Copy n Paste von hier benutzen! Sonst selber schuld!
git reset --hard
git clean -df -x

Views: 20

Git Leitfaden

Wer Projekte per git auf dem aktuellen Stand halten will, aber sonst nicht viel mit git macht, braucht immer mal wieder dieselben Befehle, um die notwendigen Aktualisierungen durchzuführen. Da sind dann immer wieder diese Leute, die dann ein paar Befehle rüberwerfen, aber nicht wirklich zwei klärende Worte zum Zusammenhang hinzufügen. Das Problem ist zwar damit vielleicht aus der Welt, aber es ist nichts damit gewonnen.

Gib einem Mensch einen Fisch und du ernährst ihn für einen Tag. Lehre einen Menschen zu fischen und du ernährst ihn für sein Leben.

Konfuzius

Wenn die Mehrzahl der Empfehlenden nach dieser Maxime handeln würden, wäre das Frustrationspotenzial auf Myriaden von Webseiten und Foren nicht so hoch. Das musste ich mal loswerden.

Ich gehe am praktischen Beispiel des Fediverse-Servers Friendica vor. Den geübten Umgang mit Linux und der Konsole beziehungsweise der Shell Bash setze ich voraus. Ebenso ein installiertes git.

Git und das Repo

Das Software-Repository, oft auch nur Repository oder Repo genannt, von Friendica liegt zum Beispiel auf GitHub. Das ist der Speicherort, auf dem die Software liegt und von Entwicklern gepflegt, programmiert und aktualisiert wird.

Git ist eine Software, die gleichzeitig verschiedene Versionen von Dateien verwalten kann und für die Softwareentwicklung entwickelt wurde. Kurz gesagt ermöglicht sie es, sehr einfach recht komplexe Versions-Upgrades oder Downgrades absolut korrekt durchzuführen, so dass als Ergebnis immer eine saubere und lauffähige Version der Software beziehungsweise des Quellcodes herauskommt.

Schritt 1 Die Software installieren - Das Repo klonen

Ich nehme mal an, du willst Friendica auf deinem Server installieren und hast das Webverzeichnis für deine Domain eingerichtet, das sich zum Beispiel unter /var/web/MeineDomain/htdocs befindet. Und genau hier willst du Friendica installieren, daher wechselst du in dieses Verzeichnis. Das Verzeichnis muss komplett leer sein, sonst weigert sich git, die Dateien hier abzulegen.

Der Befehl, der dafür vorgeschlagen wird, ist oft

git clone https://github.com/friendica/friendica

Aber. Dieser würde dir in deinem /var/web/MeineDomain/htdocs/-Verzeichnis ein Unterverzeichnis friendica anlegen und dort alle Dateien und Verzeichnisse ablegen. Und dein Server wäre dann nur unter www.MeineDomain.de/friendica/ erreichbar. Aber du möchtest, dass der Friendica-Server unter www.MeineDomain.de erreichbar ist.

Daher musst du dem vorgeschlagenen Befehl noch ein Leerzeichen und einen Punkt mitgeben, mit dem du angibst, dass die Dateien im aktuellen Verzeichnis abgelegt werden. Und dann sieht das so aus.

git clone https://github.com/friendica/friendica .

Damit liegt nun die Software, genauer gesagt die stable-Version, auf deinem Server und du kannst mit der Konfiguration und Einrichtung beginnen. Die Dokumentation dazu findest du im Friendica-Wiki.

Da die Addons für Friendica in einem extra Repo liegen, müssen diese natürlich mit den gleichen Schritten eingerichtet und später dann auch aktualisiert werden.

Schritt 2 Aktualisierungen

In so einem Software-Repo wird in den meisten Fällen nicht nur eine Software-Version gepflegt, sondern meist mehrere. Eigentlich sind immer stable und develop beziehungsweise origin/stable und origin/develop verfügbar. Wie oben schon erwähnt hiess stable früher standardmässig master, aber in modernen Repos gibt es nur noch den Namen stable oder öfter main. Bei Friendica heisst die aktuelle stabile Version stable.

Ganz allgemein. Um deine Software zu aktualisieren, wechselst du zukünftig in dein Verzeichnis /var/web/MeineDomain/htdocs/ und gibst den Befehl ein

git pull

und dein Friendica wird auf den neuesten Stand gebracht. Addons nicht vergessen.

Schritt 3 Versionen und Branches

Nun gibt es wie oben schon geschrieben meist mindestens zwei Versionen. Die stable und die development Version. Die Versionen in git werden Branches genannt. Welche Branches du hast, kannst du ganz einfach herausfinden mit den Befehlen.

Welche Branches liegen remote auf dem Software-Repo.

git branch -r

ergibt zum Beispiel so eine Ausgabe.

origin/2022.09-rc
origin/2022.12-rc
origin/2023.03-rc
origin/2023.05-rc
origin/2023.09-rc
origin/2024.03-rc
origin/HEAD -> origin/develop
origin/develop
origin/stable

Welche Branches liegen lokal auf deinem Server.

git branch -a

Um zu einem anderen Branch beziehungsweise Version zu wechseln, gibst du einfach zum Beispiel ein.

git checkout develop um auf die Entwicklerversion zu wechseln

git checkout stable um auf die stabile Hauptversion zu wechseln

Allerdings sollte so ein Wechsel immer gut durchdacht sein, denn oftmals kann das weitere Abhängigkeiten haben, wie zum Beispiel bei Friendica irgendwelche Updates von Datenstrukturen in der Datenbank. Ältere Versionen kennen neuere Datenbankstrukturen nicht und das wird dann vermutlich zu Fehlern führen. Prüfe stets.

Schritt 4 Updates und Versionen - development, stable und RC

Es gibt also die development Version, die immer die neuesten Funktionen und Features hat, die aktiv entwickelt werden und daher mit einer hohen Wahrscheinlichkeit Fehler enthalten, die noch korrigiert werden müssen. Und die stabile stable Version, die zum produktiven Einsatz freigegeben wurde.

Dann gibt es oft noch RC-Versionen, also Release Candidates. Zum Beispiel eine 2024.04-RC. Das ist eine aktuelle development Version, zu der keine neuen Features dazukommen (Feature Freeze) und die zur nächsten stabilen Version werden soll. Diese Version ist mit einer öffentlichen Beta-Version vergleichbar, die zur Verfügung gestellt wird, damit sie von vielen getestet und eventuelle Fehler behoben werden können. Wenn dann alle Fehler behoben sind, dann wird diese 2024.04-RC-Version in die stable Version überführt.

Das heisst, wenn die Aktualisierung des eigenen Friendica-Servers immer auf das Branch stable eingestellt ist, dann wird beim nächsten git pull der Server automatisch auf die neueste Version aktualisiert. Wurde zuvor auf zum Beispiel das RC 2024.04-RC-Branch gewechselt, muss natürlich dann aktiv auf das stable-Branch wieder zurückgewechselt werden. git checkout stable und git pull.

Friendica per Git aktualisieren

Bei Friendica gibt es wie beschrieben noch das Addon-Verzeichnis und zusätzlich noch den Composer, der Abhängigkeiten von bestimmten Softwarebibliotheken verwaltet und sicherstellt, dass die richtigen Versionen auf deinem Server liegen. Daher müssen bei einer Aktualisierung mindestens folgende Befehle eingegeben werden.

Ausgehend davon, dass du dich in deinem Verzeichnis /var/web/MeineDomain/htdocs befindest.

git pull https://github.com/friendica/friendica.git
bin/composer.phar install --no-dev
cd addon
git pull https://github.com/friendica/friendica-addons.git

Weitere nützliche Git-Befehle

  • git fetch holt die Liste der Branches vom Repo
  • git checkout wechselt den Branch
  • git stash verwirft lokale Commits
  • git checkout -b erstellt lokal einen neuen Branch
  • git branch -D löscht den lokalen Branch
  • git push origin --delete löscht den remote Branch
  • git branch -r zeigt remote Branches an
  • git branch -a zeigt lokale Branches an
  • git remote prune origin löscht alle lokalen Branches, die auch nicht mehr auf dem Remote-Repo sind
  • git gc --auto führt Aufräumarbeiten durch, komprimiert Revisionen, entfernt lose und unzugängliche Objekte

Falls es zu Fehlermeldungen und grösseren Problemen kommt, dann sind folgende Befehle hilfreich. Aber bitte vorher das Handbuch dazu lesen. Nicht einfach per Copy und Paste von hier benutzen. Sonst selber schuld.

  • git reset --hard
  • git clean -df -x

Quellen

Git und Friendica sind als Open-Source-Software verfügbar.

Dies ist mein Erfahrungsbericht der Chemnitzer Linux-Tage 2024. Es war mal wieder eine sehr schöne Veranstaltung.

Die Anreise

Im vergangenen Jahr hatte mich die Deutsche Bahn in Chemnitz sitzengelassen und ich musste mit einem kurzfristig angemieteten Leihwagen heimfahren.

Da die Deutsche Bahn und die Gewerkschaft Deutscher Lokomotivführer sich noch immer nicht auf einen neuen Tarifvertrag einigen können und ich mich nicht erneut über eine schlechte Verbindung ärgern wollte, bin ich dieses Jahr mit dem eigenen Pkw gefahren.

Am Freitag um 13:30 Uhr ging die Reise los. Mit viel Verkehr, Baustellen und Stau waren ich etwa 4,5 Stunden später im Hotel, wo ich direkt über Stoeps gestolpert bin.

Wir spazierten vom Residenz Hotel Chemnitz zum Veranstaltungsgebäude, um uns anzumelden und unsere Badges zu empfangen. Damit ersparten wir uns das Warten in der Schlange am Samstagmorgen.

Am Hörsaalgebäude traf ich schon erste vertraute Gesichter, wie z.B. Andreas, welcher fleißig beim Aufbau geholfen hat. Hier haben wir uns auch mit Michael von der Aspicon GmbH getroffen, mit dem ich für Sonntag einen Vortrag geplant hatte. Wir sind gemeinsam in die Stadt gegangen, um uns bei Speis und Trank kennenzulernen und den Abend zu verplaudern.

Der Samstag

Um 07:00 Uhr begann ich den Tag mit dem Frühstück. So war der erste Hunger bereits gestillt, als der Frühstücksraum sich zu füllen begann. Bekannte Gesichter und nerdige T-Shirts verrieten, dass es sich bei sehr vielen der Gäste um Besucher der Chemnitzer Linux-Tage handelte.

Die 20 Minuten zum Veranstaltungsort wurden auch diesmal wieder zu Fuß zurückgelegt. Und der erste Konferenztag konnte beginnen.

Um 10:00 Uhr war ich an der Reihe und durfte in einem rappelvollen Raum V6 meinen „::1“-Vortrag halten. An dieser Stelle euch allen nochmal vielen Dank für eure Teilnahme. Ich hoffe, ihr hattet so viel Spaß wie ich und konntet ein paar neue Eindrücke gewinnen.

Es hat mich gefreut, auch nach dem Vortrag noch einige Fragen beantworten zu können und über IPv6 zu fachsimpeln. Ganz nebenbei konnte ich auch noch die Frage eines Red Hat-Kunden beantworten. Darüber freute sich dieser sehr, bleibt ihm der Support eine zufriedenstellende Antwort doch seit langer Zeit schuldig. Es ist halt stets eine gute Erfahrung, einen TAM zu treffen.

Die Chemnitzer Linux-Tage gibt es übrigens schon seit 25 Jahren. Da eine Veranstaltung aufgrund der Pandemie ausfallen musste, findet die 25. Veranstaltung allerdings erst im nächsten Jahr am 22. und 23. März statt.

20-jähriges Jubiläum feiert in diesem Jahr Ubuntu, weshalb der Community-Stand dieses Jahr besonders schön geschmückt war und toddy mehrfach mit Luftschlangen gefesselt wurde.

Ich genieße die Zeit unter gleichgesinnten Nerds oder wie Stoeps es ausdrückte: „Endlich wieder unter normalen Menschen“. Mich hat es dieses Jahr sehr gefreut, auch viele jüngere Gesichter zu sehen. So sehr ich mich freue, auch die gleichen alten Nasen immer wiederzutreffen ist es doch schön, dass die Gemeinschaft nicht einfach alt wird, sondern auch junge Menschen mit Interesse, Motivation und Freude an Open Source nachwachsen.

Da die Hörsäle hier bei den Vorträgen meist aus allen Nähten platzen, hatte ich mich im Vorfeld als Sessionleitung für die drei Vorträge

  1. Never ever break userspace – was das in der Praxis bedeutet von Wolfram Sang
  2. DIY Verified Boot in 2024 von Marco Felsch und
  3. VirtualBox Meets KVM von Julian Stecklina

gemeldet. So war mir ein guter Platz im Raum sicher. Ich danke den drei Referenten für ihre interessanten Vorträge.

Am Abend waren alle Aussteller, Helfer und Referenten zum gemütlichen Beisammensein in die Mensa eingeladen, welche schräg gegenüber dem Veranstaltungsgebäude liegt. Hier gab es ein reichhaltiges Angebot an warmem und kaltem Essen sowie eine Auswahl verschiedenster Getränke. Vielleicht ist es in der Zukunft möglich, die Getränke zu kühlen. Dann wird das Bier nicht so schnell warm und schmeckt länger gut.

Ich schätze es sehr, mich auf Konferenzen mit alten und neuen Bekannten auszutauschen, zu fachsimpeln und ganz allgemein angeregte Gespräche zu führen. Das musikalische Rahmenprogramm traf auch in diesem Jahr nicht meinen Geschmack. Ich würde mir etwas Hintergrundberieselung wünschen, um sich gut unterhalten zu können. Doch sind Geschmäcker verschieden und ich erkenne durchaus an, was das Organisations-Team der Chemnitzer Linux-Tage hier Jahr für Jahr auf die Beine stellt. Euch allen vielen Dank für euren unermüdlichen Einsatz.

Der Sonntag

Nach einem frühen Frühstück und Check-out ging es heute mit dem Auto zum Veranstaltungsgelände. Noch vor dem zweiten Kaffee wurden hier die Folien für den nächsten Vortrag nochmal geprüft. Um 10:00 Uhr war es wieder soweit. Diesmal durfte ich zusammen mit Michael den Vortrag „Mit Ansible Collections & Workflows gegen das Playbook-Chaos“ halten.

@Michael: „Es hat mir gut gefallen, mit dir einen Vortrag zu halten. Das können wir gerne wiederholen.“

Beim Mittagessen habe ich dann auch noch Christian getroffen. Für ihn waren es die ersten Chemnitzer Linux-Tage und auch ihm haben sie sehr gut gefallen.

Und wie immer war die Zeit auch viel zu schnell wieder vorbei. So habe ich Henning zwar kurz gesehen, doch für mehr als ein kurzes „Hi und Tschüss, bis zum nächsten Mal“ reichte es diesmal leider nicht.

Die Heimreise

Auch die schönsten Chemnitzer Linux-Tage gehen vorbei. Doch im Auto sitzend freute ich mich auch schon darauf, meine Familie wiederzusehen. Die Straße war frei und nach nur 3 Stunden 20 Minuten war ich wieder daheim. Zum Vergleich, mit der Bahn wäre ich je nach Verbindung erst nach 5,5-6,5 Stunden daheim gewesen, wenn alles nach Plan fährt.

So konnte ich mehr Zeit vor Ort verbringen und war rechtzeitig daheim, um noch etwas Zeit mit meinem Sohn zu verbringen, bevor dieser ins Bett ging.

Fazit

Es war schön. Ich hoffe, ihr seid alle wieder gut heimgekommen und behaltet auch diese Chemnitzer Linux-Tage in guter Erinnerung.

Weitere Berichte über die CLT 2024