staging.inyokaproject.org

2025 Woche 01

5. Januar 2025

Nutzer veralteter Firefox-Versionen müssen damit rechnen, ab März 2025 keine Add-ons und geschützten Inhalte auf Streaming-Plattformen mehr nutzen zu können.

Am 14. März 2025 verliert ein Stammzertifikat seine Gültigkeit, welches zur Verifizierung signierter Inhalte genutzt wird. Aus diesem Grund ist es wichtig, dass der Browser bis dahin in einer Version genutzt wird, welche das neue Stammzertifikat beinhaltet. Wer nach diesem Datum nicht Firefox 128 oder höher respektive Firefox ESR 115.13 oder höher nutzt, muss mit erheblichen Einschränkungen rechnen. Betroffen sind Firefox für Windows, macOS, Linux sowie Android. Lediglich Firefox für iOS ist hiervon nicht betroffen, da Mozilla auf iOS von der Apple-Plattform abhängig ist.

Ab dem 14. März 2025 werden für Nutzer älterer Firefox-Versionen keine Erweiterungen mehr ausgeführt. Dies betrifft nicht nur neu installierte Erweiterungen. Bereits installierte Erweiterungen werden automatisch deaktiviert. Ebenfalls kann es auf Streaming-Plattformen in Folge ausbleibender Updates für das DRM-Modul nach diesem Datum jederzeit dazu kommen, dass keine Wiedergabe mehr möglich ist. Auch andere auf Remote-Updates angewiesene Funktionen können nach diesem Datum eingeschränkt sein.

Der Beitrag Erhebliche Einschränkungen für Nutzer veralteter Firefox-Versionen ab März 2025 erschien zuerst auf soeren-hentzschel.at.

4. Januar 2025

Gestern wurde Version 25.01 des modalen Editors Helix veröffentlicht. Da die vorherige Version im Juli 2024 veröffentlicht wurde und weil die Entwickler ziemlich fleißig waren, gibt es mit Version 25.01 viele Änderungen, Neuerungen und Verbesserungen.

Die Entwickler haben in einem Artikel die Highlights zusammengefasst. Das wesentlich umfangreichere Changelog lässt sich bei Github abrufen.

Da die Entwickler von Helix relativ selten neue offizielle Versionen veröffentlichen, verwende ich aktuell selbst die Git-Version. Somit konnte ich die diversen Neuerungen usw. bereit schon seit einiger Zeit nutzen. Bei den Funktionen, die ich nutze, konnte ich keine Probleme feststellen.

Wer sich für einen modalen Editor interessiert, aber mit vim / Neovim nicht warm wird, sollte sich Helix zumindest einmal ansehen. Denn Helix funktioniert bewusst in vielen Dingen anders. Ich verweise hierzu einfach mal auf einen Artikel den ich 2023 geschrieben habe.

Helix hat aber auch, verglichen mit beispielsweise Neovim, weiterhin Nachteile. Je nachdem welche Anforderungen der Nutzer hat. So gibt es weiterhin kein Plugin-System. Was mich persönlich aber nicht stört.

3. Januar 2025

Firefox besitzt eine Übersetzungsfunktion für Websites, welche im Gegensatz zu Cloud-Übersetzern wie Google Translate lokal arbeitet, die eingegebenen Texte also nicht an einen fremden Server sendet. Mit der Unterstützung von Chinesisch, Japanisch und Koreanisch wurde jetzt der nächste wichtige Meilenstein erreicht.

Firefox wird seit Version 118 standardmäßig mit einer lokalen Funktion zur maschinellen Übersetzung von Websites für den Browser ausgeliefert. Das bedeutet, dass die Übersetzung vollständig im Browser geschieht und keine zu übersetzenden Inhalte an einen Datenriesen wie Google oder Microsoft übermittelt werden müssen.

Mit der Unterstützung der sogenannten CJK-Sprachen wurde nun ein weiterer Meilenstein erreicht. Die Nightly-Version von Firefox kann jetzt Inhalte aus dem Chinesischen, Japanischen sowie Koreanischen übersetzen.

Der Beitrag Übersetzungsfunktion von Firefox Nightly lernt Chinesisch, Japanisch und Koreanisch erschien zuerst auf soeren-hentzschel.at.

31. Dezember 2024

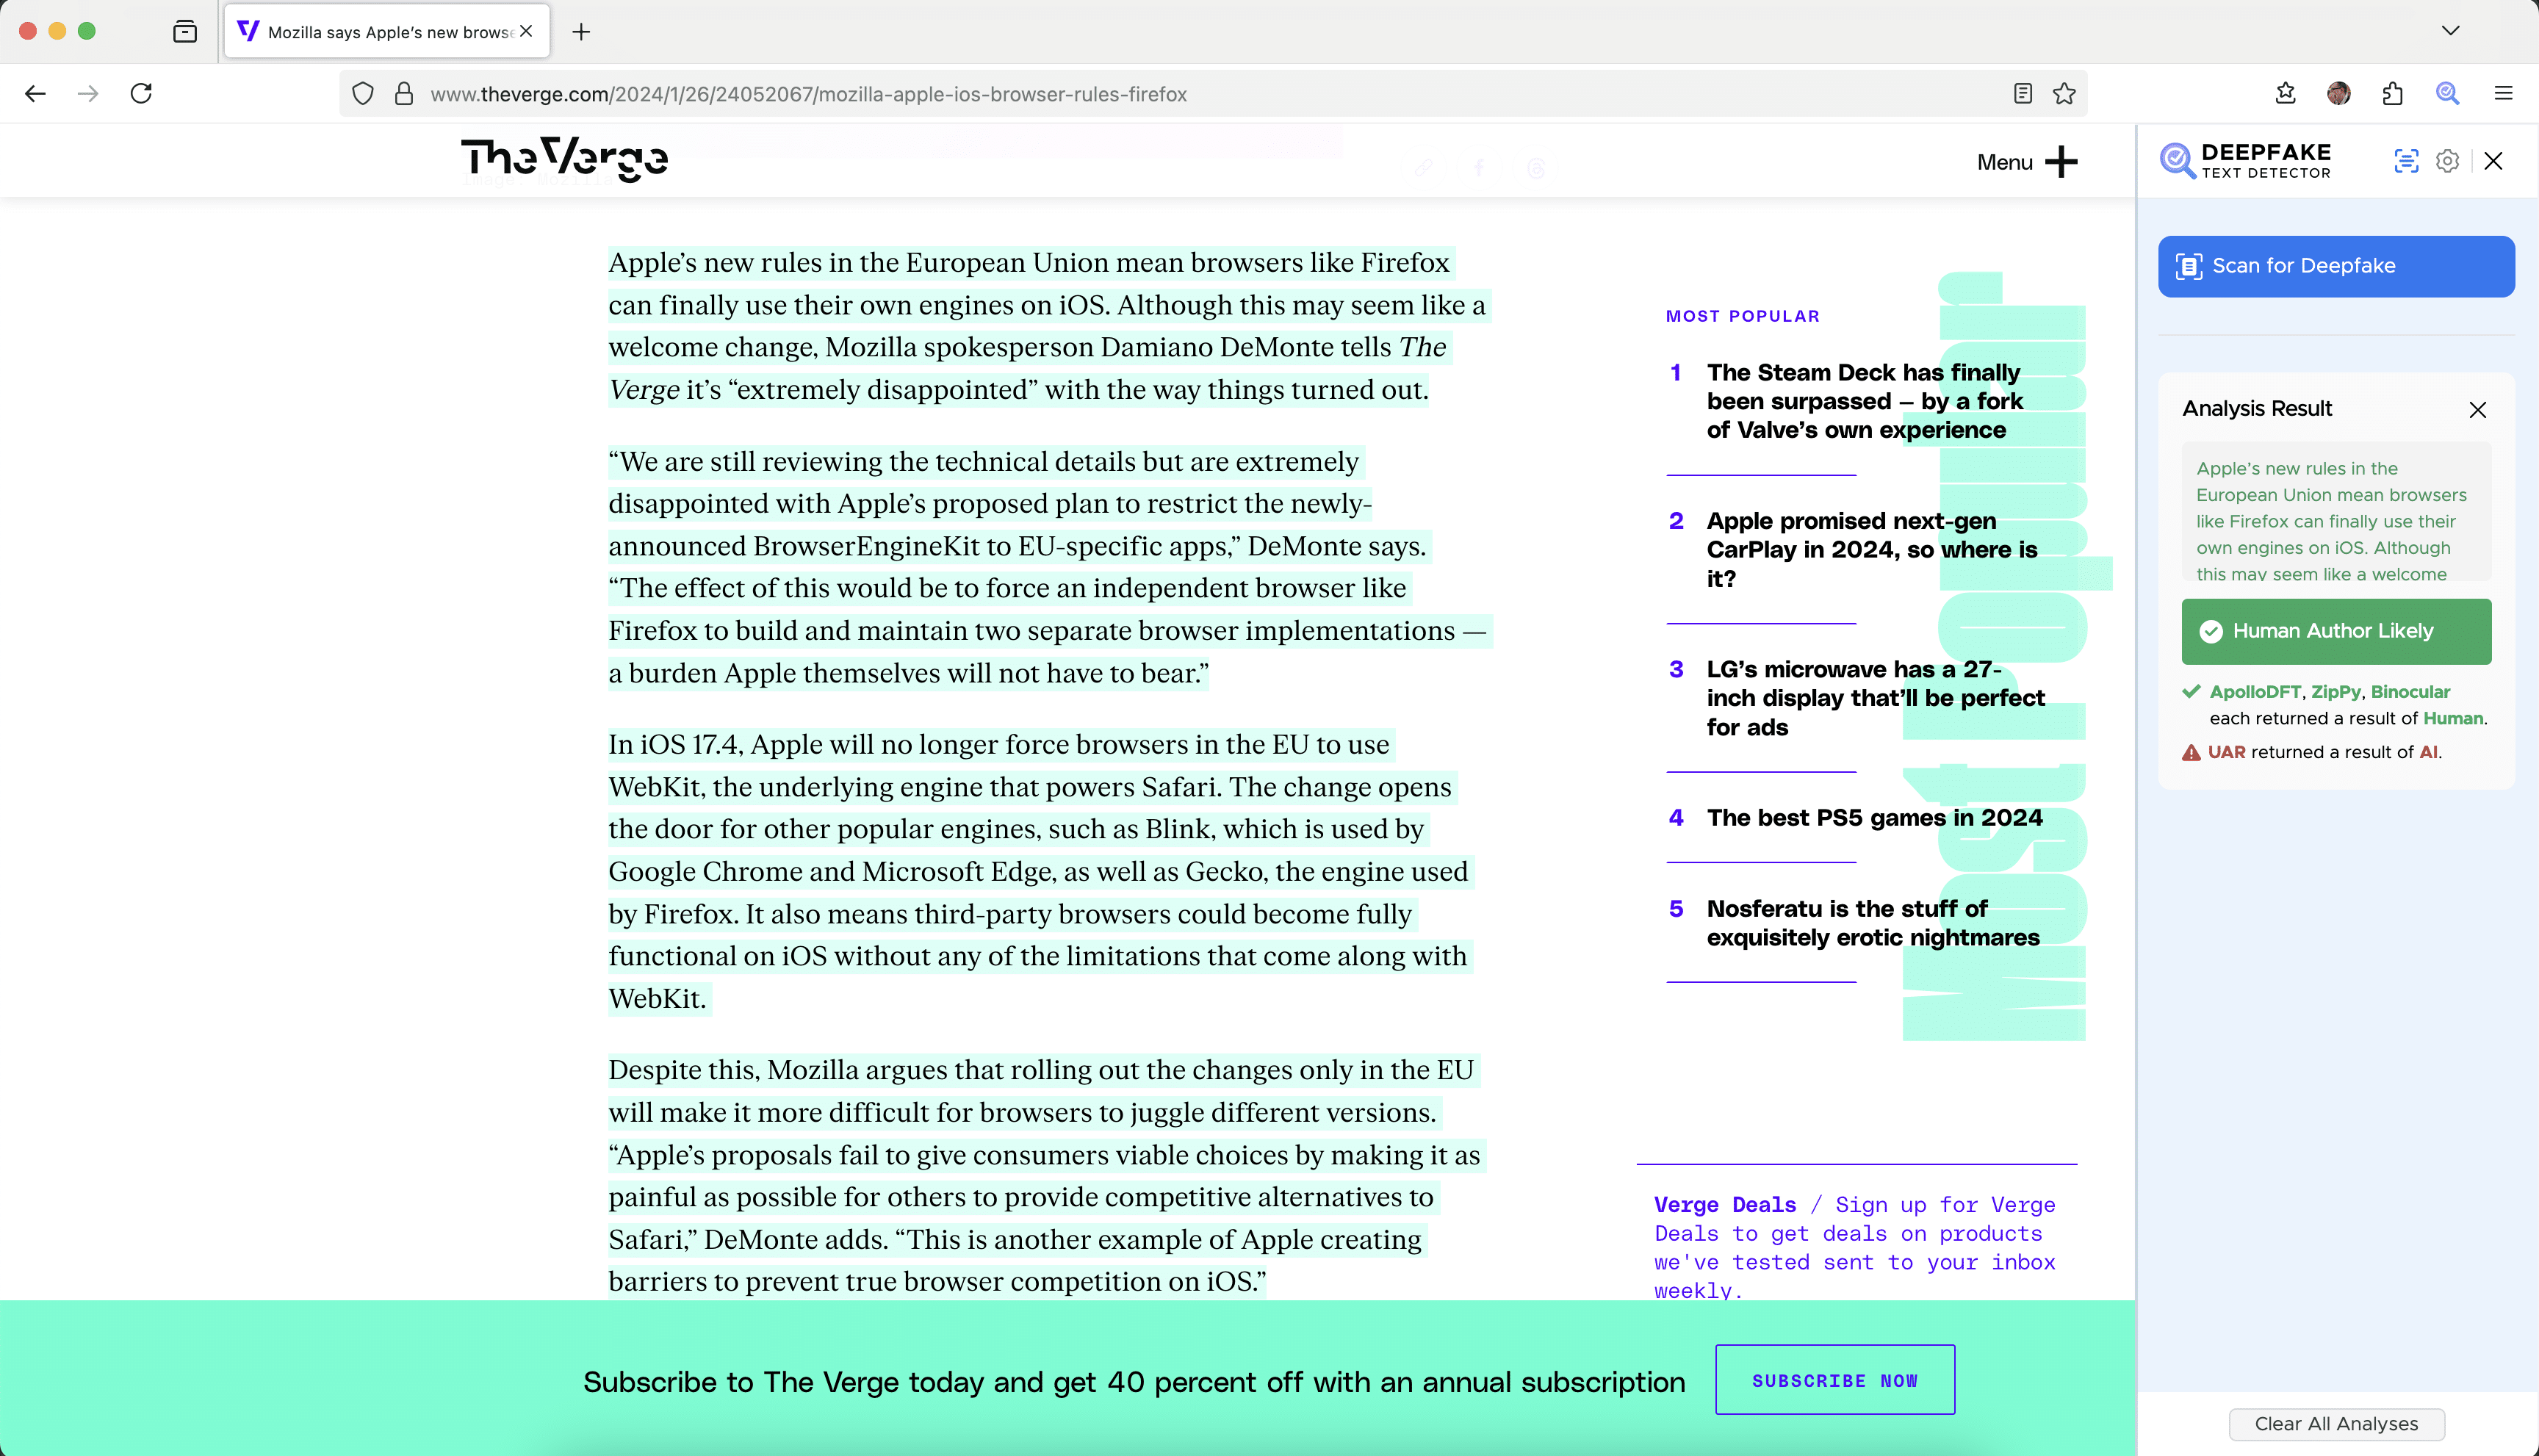
Der Fakespot Deep Fake Detector ist eine neue Firefox-Erweiterung von Mozilla, welche es dem Nutzer ermöglichen soll, mutmaßliche KI-Inhalte von Inhalten zu unterscheiden, die von echten Menschen geschaffen wurden.

Download Fakespot Deep Fake Detector

Künstliche Intelligenz (KI) erlebt in den letzten Jahren einen extremen Aufschwung – sowohl qualitativ als auch, was die Nutzung betrifft – und das längst auch im Mainstream-Bereich. Heute fällt es teilweise schwer, überhaupt noch zu erkennen, welche Inhalte von einer KI erzeugt worden sind und was das Werk echter Menschen ist.

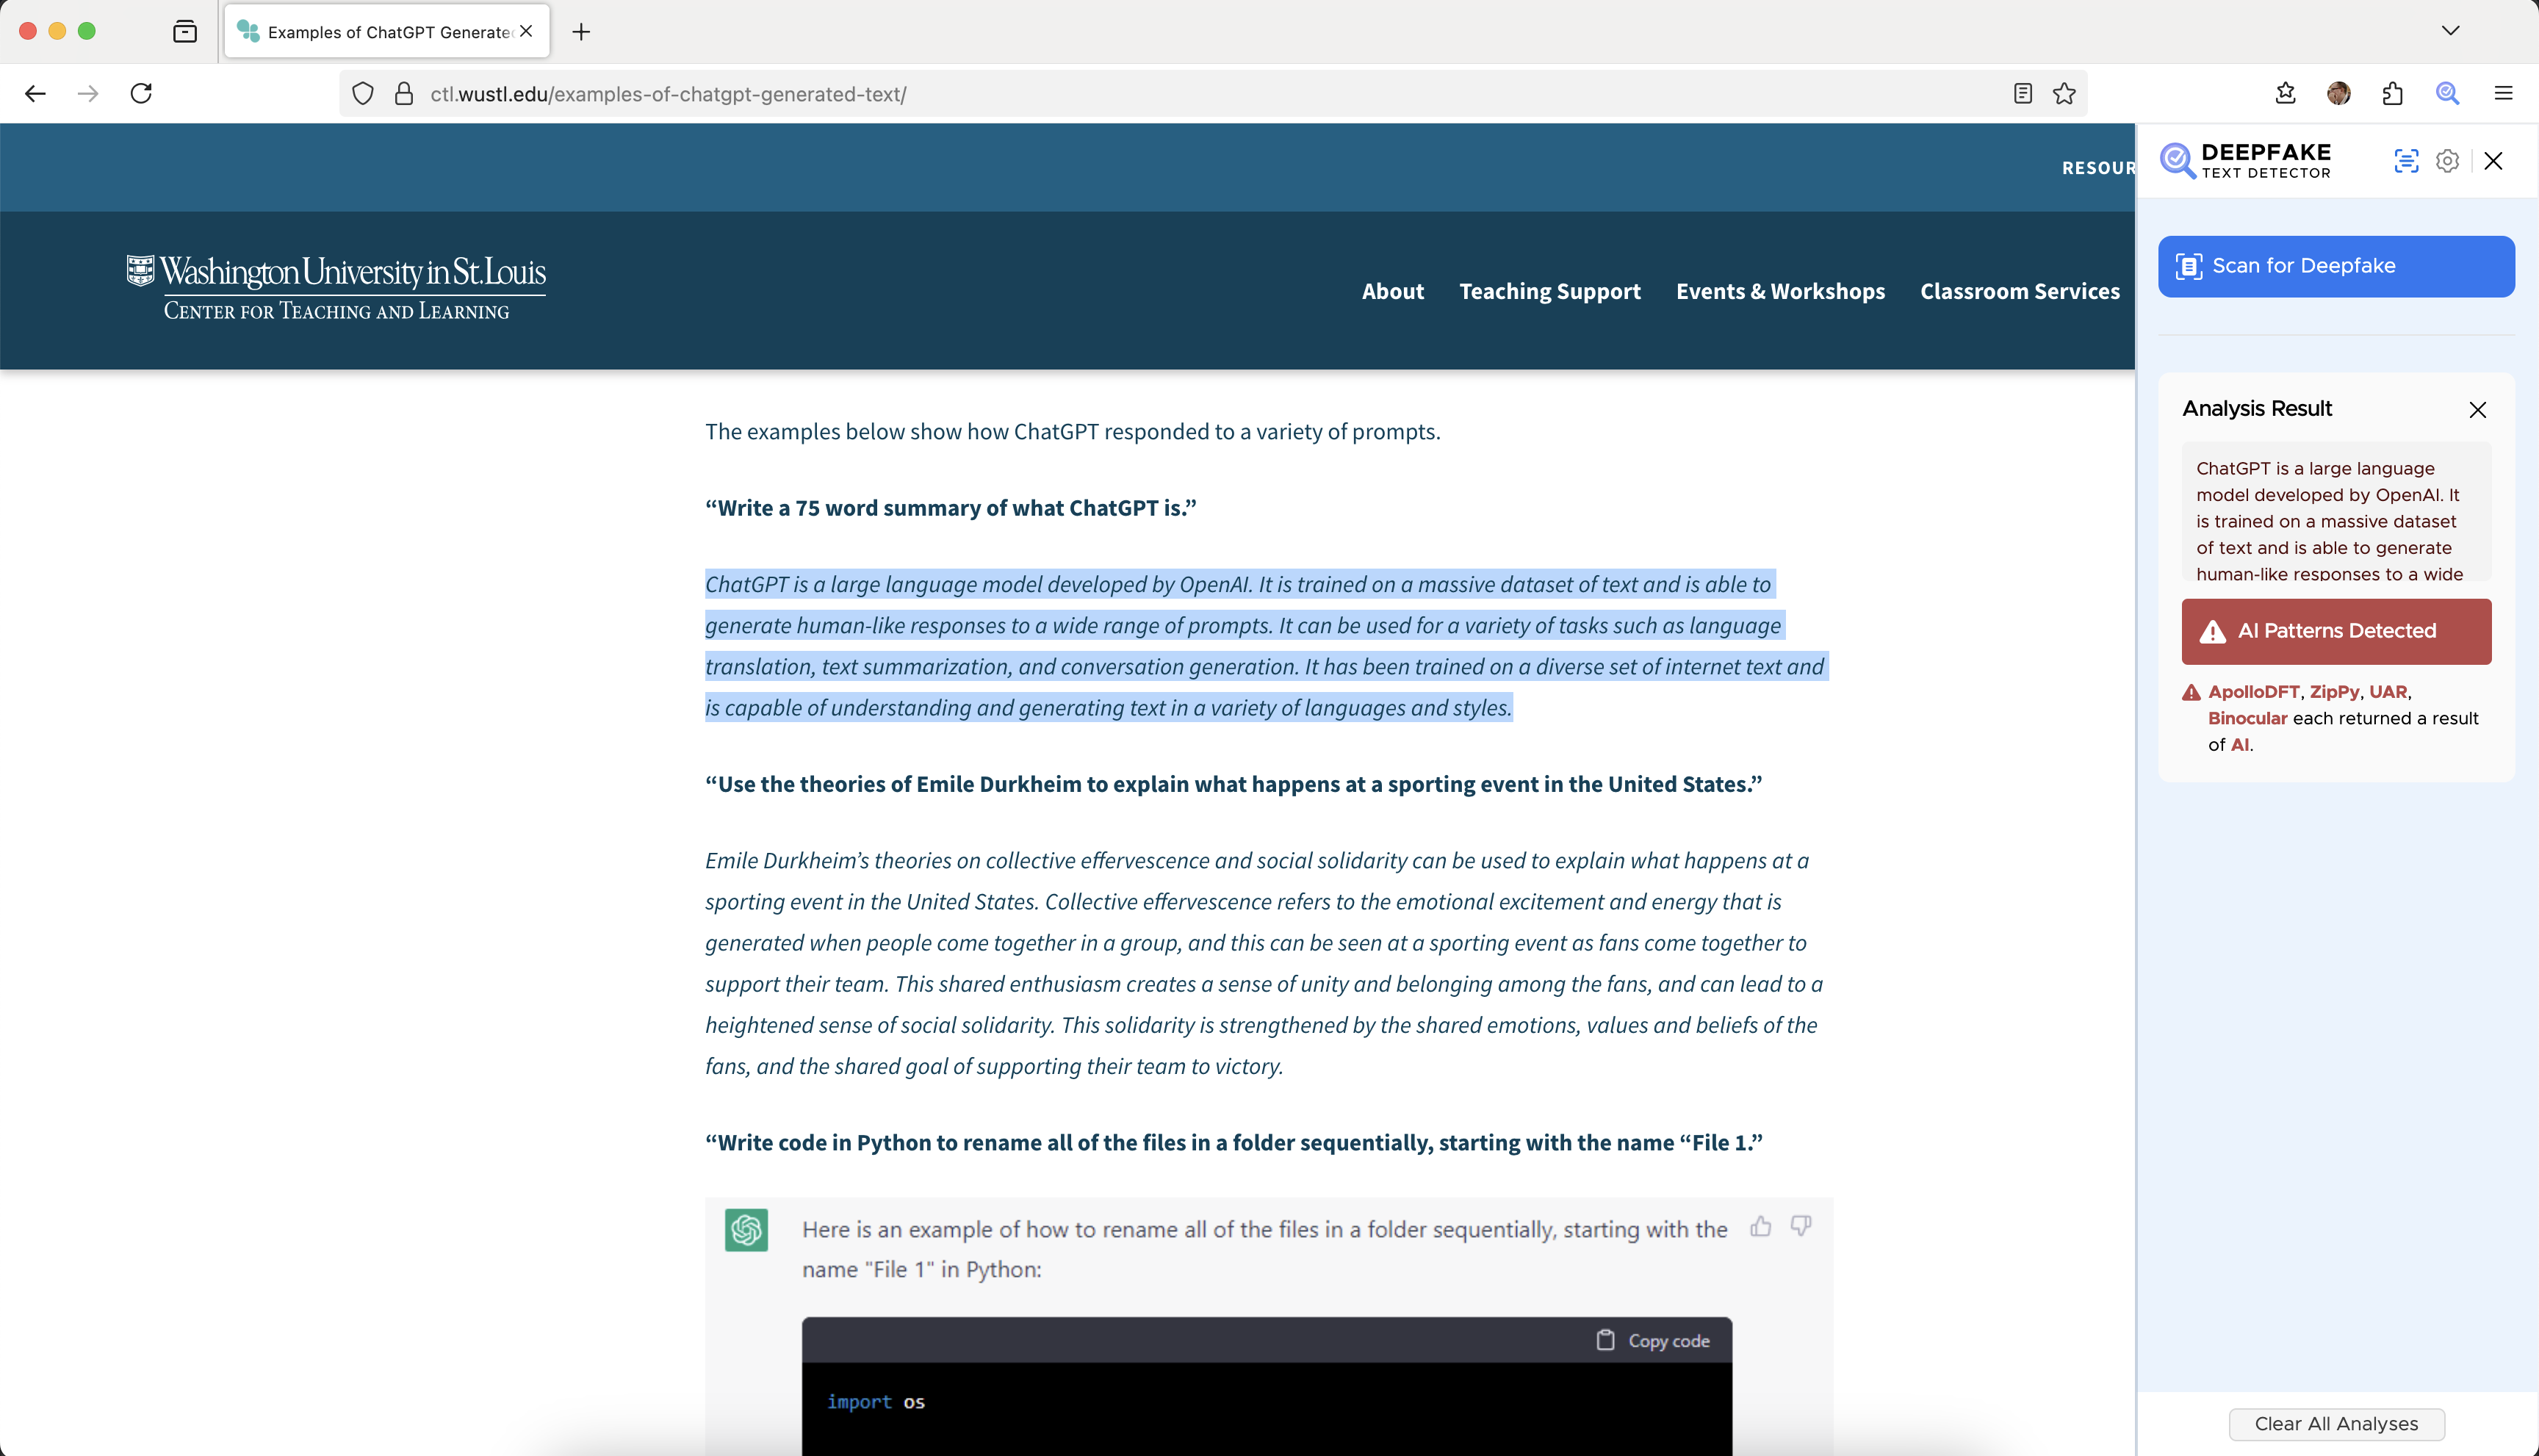
Mozilla möchte dieses Problem angehen – und zwar mit Hilfe Künstlicher Intelligenz. Der Fakespot Deep Fake Detector ist eine neue Browser-Erweiterung für Firefox, welche es erlaubt, markierten Text dahingehend zu analysieren. Alternativ kann Text auch ohne Browser-Erweiterung auf der dazugehörigen Website eingegeben werden.

Zu diesem Zeitpunkt werden ausschließlich englischsprachige Texte unterstützt. Bei Text soll es dabei nicht bleiben: In Zukunft soll der Fakespot Deep Fake Detector auch Videos und Bilder analysieren können.

Für eine bessere Zuverlässigkeit verlässt sich Mozilla nicht auf ein einzelnes Modell. Mit ApolloDFT, Binocular, UAR sowie ZipPy kommen derzeit gleich vier Modelle mit unterschiedlichen Stärken und Schwächen zum Einsatz, die auch beschrieben werden. Wenn es Unstimmigkeiten in der Bewertung gibt, erfährt der Nutzer, welches Modell zu welchem Ergebnis kam. Bei allen diesen Modellen handelt es sich um Open Source-Modelle, wobei ApolloDFT ein eigenes Modell von Fakespot ist.

Fakespot war ursprünglich ein eigenständiges KI-Unternehmen, welches sich auf die Erkennung sogenannter „Fake-Inhalte“ spezialisiert hat und im Mai 2023 von Mozilla übernommen worden ist. Am besten bekannt ist Fakespot für die Erkennung falscher Produktbewertungen beim Online-Shopping. Mittlerweile ist diese Funktionalität für Amazon, BestBuy und Walmart nativ in Firefox integriert.

Fakespot Deep Fake Detector Fakespot Deep Fake Detector

Der Beitrag Fakespot Deep Fake Detector: Neue Erweiterung von Mozilla erkennt Inhalte von KI vs. echten Menschen erschien zuerst auf soeren-hentzschel.at.

In der letzten Episode des Risikozone-Podcasts habe ich ganz kurz das Thema der verkürzten Hashwerte und auftretenden Kollisionen angesprochen. Jetzt gibt es ein Proof of Concept zu der Thematik.

Worum es geht

Ein kurzer Refresher, worum es in der Thematik überhaupt geht: Als Git entwickelt wurde, musste ein Weg gefunden werden, wie man die Referenzen auf Commits, die Dateien und die Dateibäume realisiert. In vielen Systemen wie z. B. Issue-Trackern werden aufsteigende Indizes verwendet. In einem verteilten System wie Git ist das aus verschiedenen Gründen der Synchronisation nicht so einfach möglich, da sonst Kollisionen, also gleiche IDs für unterschiedliche Objekte entstehen könnten. Eine Alternative wäre UUIDs, da die IDs einen randomisierten Anteil haben und die Wahrscheinlichkeit für Kollisionen gesenkt wird.

Noch besser als UUIDs ist allerdings Content-adressable Storage, bei dem Inhalte einzig durch ihren Inhalt adressiert werden. Das ist so, als würde man den gesamten Inhalt der Datei nochmal in den Dateinamen schreiben. Der Clou dabei ist jedoch, dass der gesamten Dateiinhalt gar nicht in den Dateinamen geschrieben werden muss, um die Datei durch ihren Inhalt identifizierbar zu machen.

Mit kryptographischen Hashfunktionen wie SHA-1 oder SHA-256 existiert ein Mittel, um einen beliebig langen Dateiinhalt zu einem immer gleich langen Wert, dem Hash, umzuwandeln. Dabei sind kryptographische Hashfunktionen so konstruiert, dass die Wahrscheinlichkeit für Kollisionen durch verschiedene Mechanismen stark minimiert wird. Ein SHA-1-Hash für den Dateiinhalt "Hallo Welt" wäre z. B. 28cbbc72d6a52617a7abbfff6756d04bbad0106a. Ein netter Nebeneffekt ist, dass Dateien mit gleichem Inhalt im Content-adressable Storage auch nur einmal abgespeichert werden, wodurch sogar Deduplikation ermöglicht wird.

Git nutzt dieses Verfahren, um die eingechekten Dateien abzuspeichern. Diese Dateien werden dann in Trees zusammengebunden und in Commits mit den jeweiligen Vorgänger-Commits (parents) in einem sog. Merkle-Tree verheiratet.

Commits werden somit auch durch einen SHA-1-Hash identifiziert, der im hexadezimalen Format 40 Zeichen lang ist.

Das Problem

Das Problem bei dem Verfahren liegt jetzt darin, dass dieser Hash üblicherweise noch weiter abgekürzt wird, um ihn benutzerfreundlicher in Oberflächen oder E-Mails darzustellen. Damit wird natürlich die Wahrscheinlichkeit für Kollisionen erhöht.

Habe ich einen Hash 28cbbc72d6a52617a7abbfff6756d04bbad0106a und nutze nur 28cbbc zur Referenz, reicht das in den meisten kleinen Repositories aus, um einen Commit eindeutig zu referenzieren. In großen Repositories mit vielen Dateien und Commits kann es auf einmal passieren, dass ein weiterer Commit 28cbbcc00aa8ef4e80596c16ecfdb4bc92656cd3 auftaucht, sodass 28cbbc nicht mehr eindeutig einen Commit beschreibt.

Um das Risiko zu verringern, sollte die Mindestanzahl der Zeichen für einen abgekürzten Commit erhöht werden.

Das Kernel-Repository

Genau darum geht es in der aktuellen Diskussion. Aktuell nutzen die Linux-Entwickler zur Referenz von Commits in ihren E-Mails 12 Zeichen lange Hashes. Die Diskussion dreht sich um die Frage, ob die Zahl weiter erhöht werden sollte. Linus Torvalds ist bisher dagegen, weil er das Risiko für Kollisionen gering sieht und er die Position vertritt, dass ein Commit immer mit dem Commit Message Title angegeben werden sollte, was ungewollte Kollisionen ausreichend verhindere.

Gestern veröffentlichte Kees Cook einen Blogpost, indem er eine Commit-Kollision mit dem Werkzeug lucky-commit bewusst herbeiführte, um darauf aufmerksam zu machen, dass die Git- und Kernel-Entwicklungstools mit solchen Situationen klarkommen sollten. Es ist unwahrscheinlich, dass solche Kollisionen bei 12 Zeichen versehentlich entstehen, aber ein Angreifer könnte dies ausnutzen.

Dies sollte ein Apell an alle Entwickler sein, deren Tooling auf abgekürzte Commit-Hashes setzt. Schauen wir mal, wie sich das weiterentwickelt.

Ein Kommentar zu SHA-1

Abschließend ein Kommentar noch zu SHA-1. Wie viele von euch wissen, ist SHA-1 selbst nicht mehr vertretbar kollisionssicher. Das bedeutet, es kann passieren, dass auf einmal zwei Dateiinhalte sich doch den gleichen Hash teilen könnten, wenn ein Angreifer es drauf anlegt.

Da dies natürlich Git massiv stören könnte, gibt es schon Bestrebungen, das Verfahren auf SHA-2 zu aktualisieren, wodurch sich die Hashlänge auch vergrößert. Das ist aber gar nicht so einfach, da SHA-1 an vielen Stellen in die Struktur eines Git-Repos hartkodiert wurde.

Hier geht es aber nicht um das unsichere SHA-1. Durch die Abkürzung des Hashes von 40 auf 12 Zeichen wird die Kollisionssicherheit bewusst und massiv zugunsten der Benutzerfreundlichkeit geschwächt. Und das erfordert immer eine regelmäßige Evaluation, welches Niveau noch vertretbar ist.

30. Dezember 2024

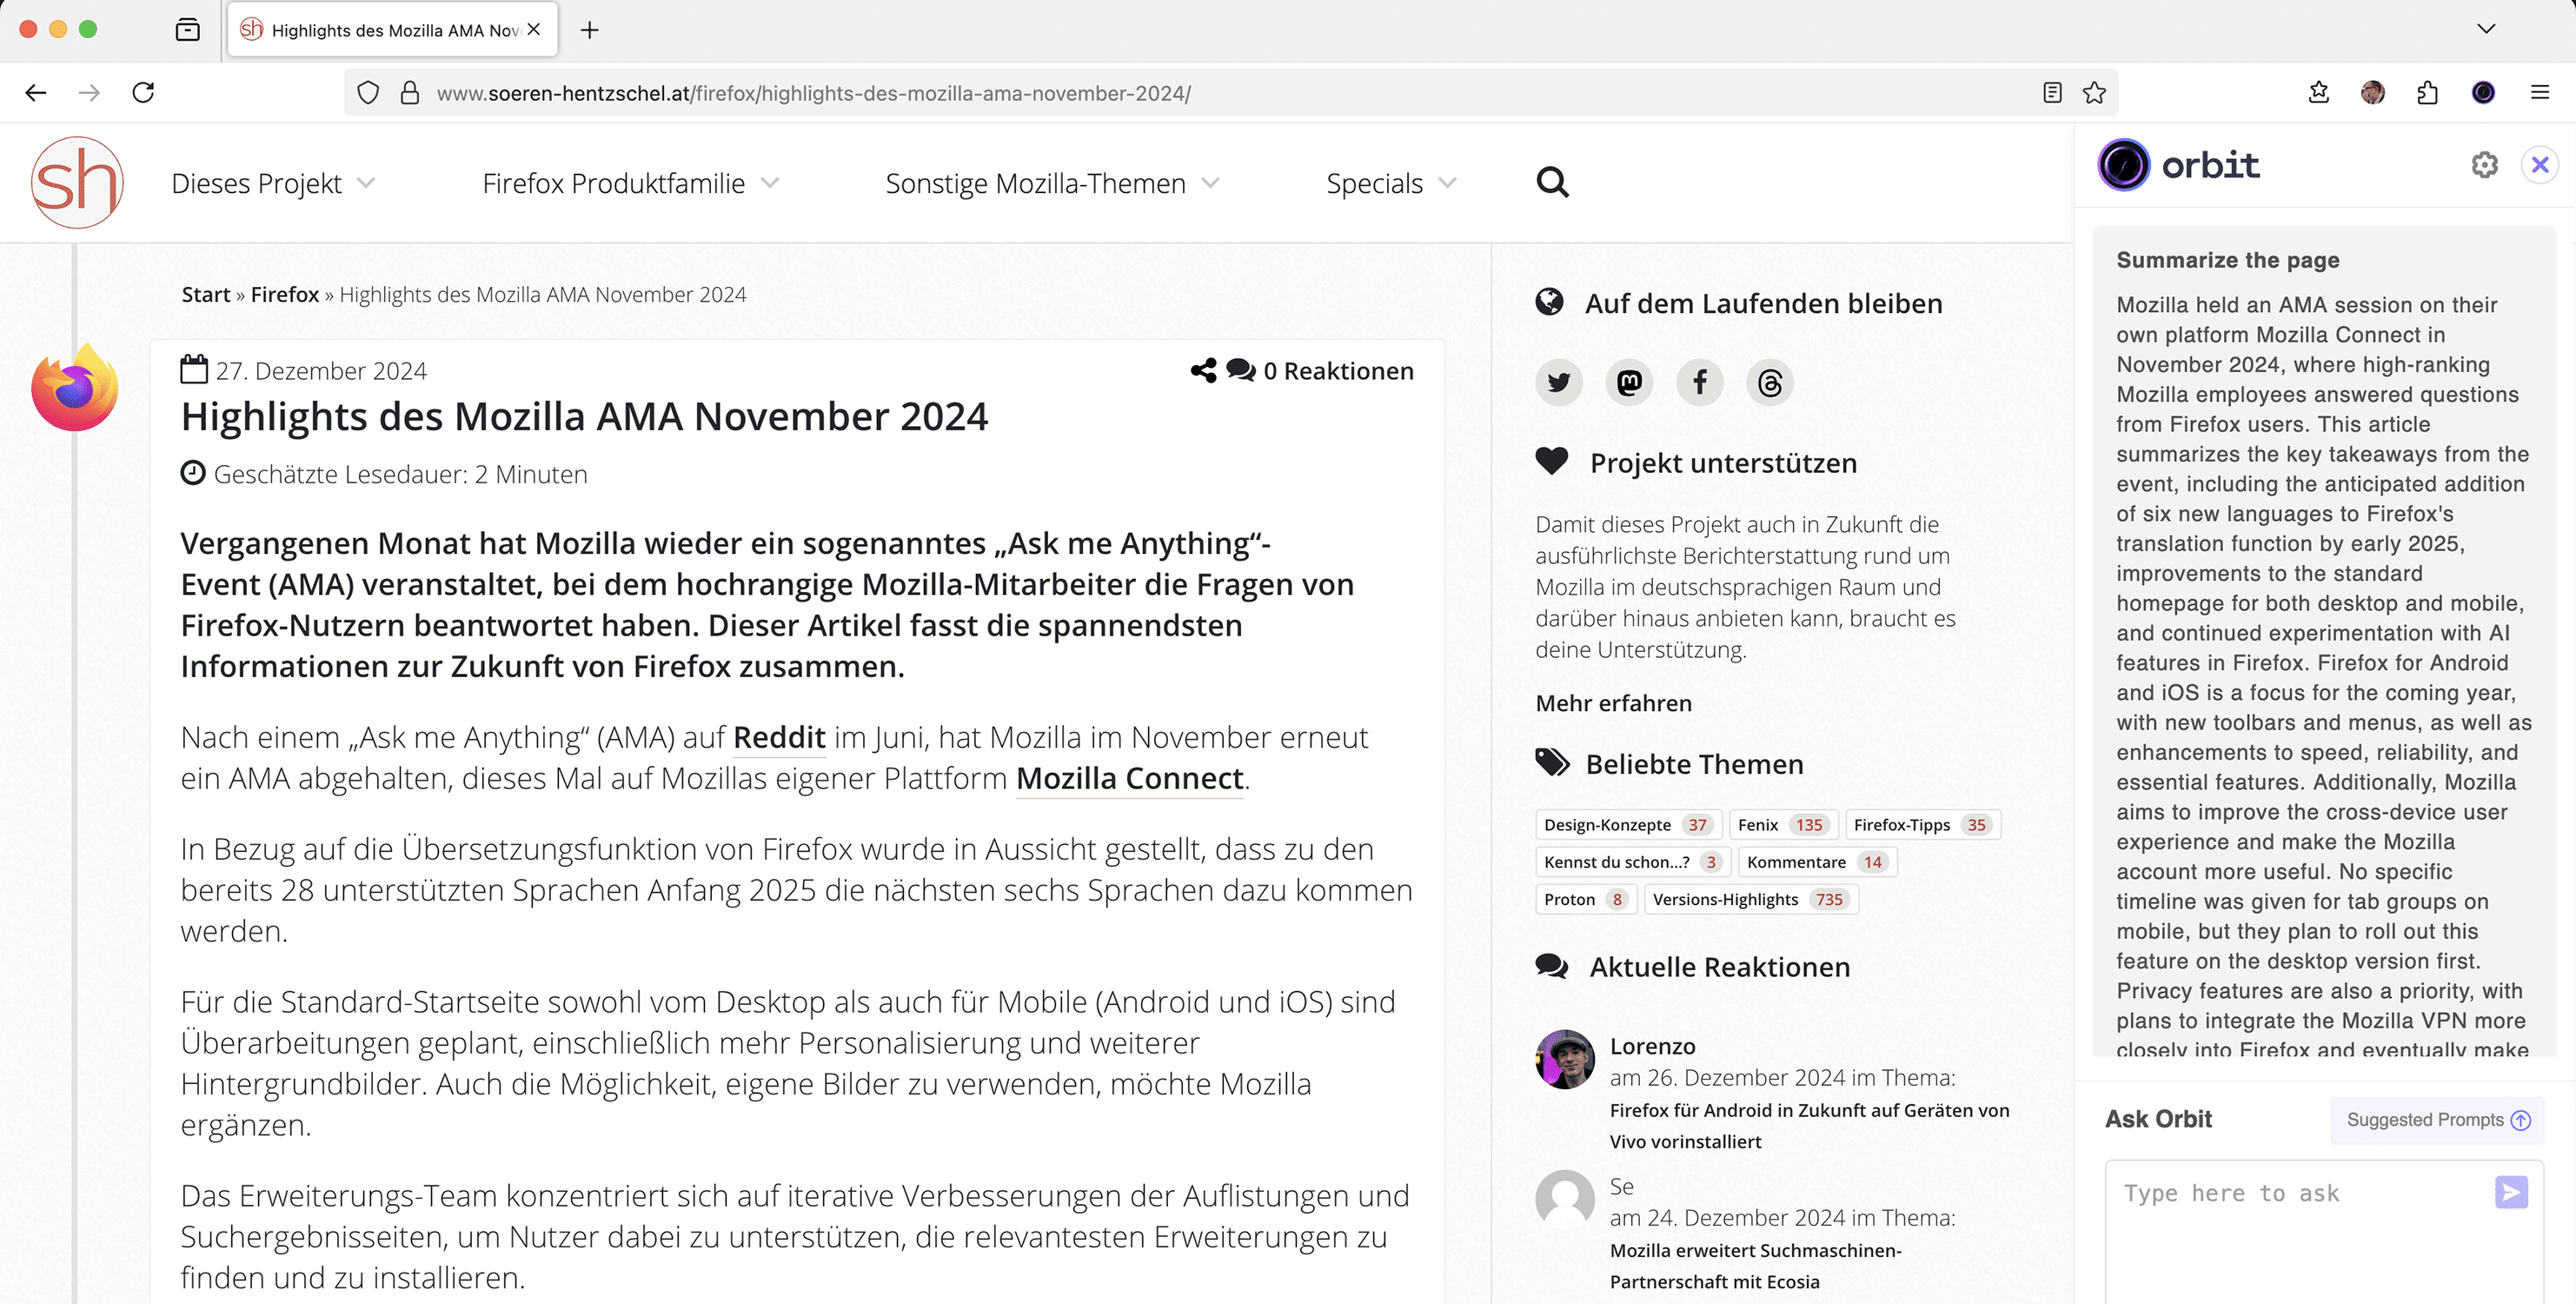
Orbit by Mozilla ist eine Firefox-Erweiterung von Mozilla, welche den Browser um einen KI-Assistenten erweitert, der Texte und Videos zusammenfassen kann und dabei die Privatsphäre der Nutzer respektiert.

Download Orbit by Mozilla für Firefox

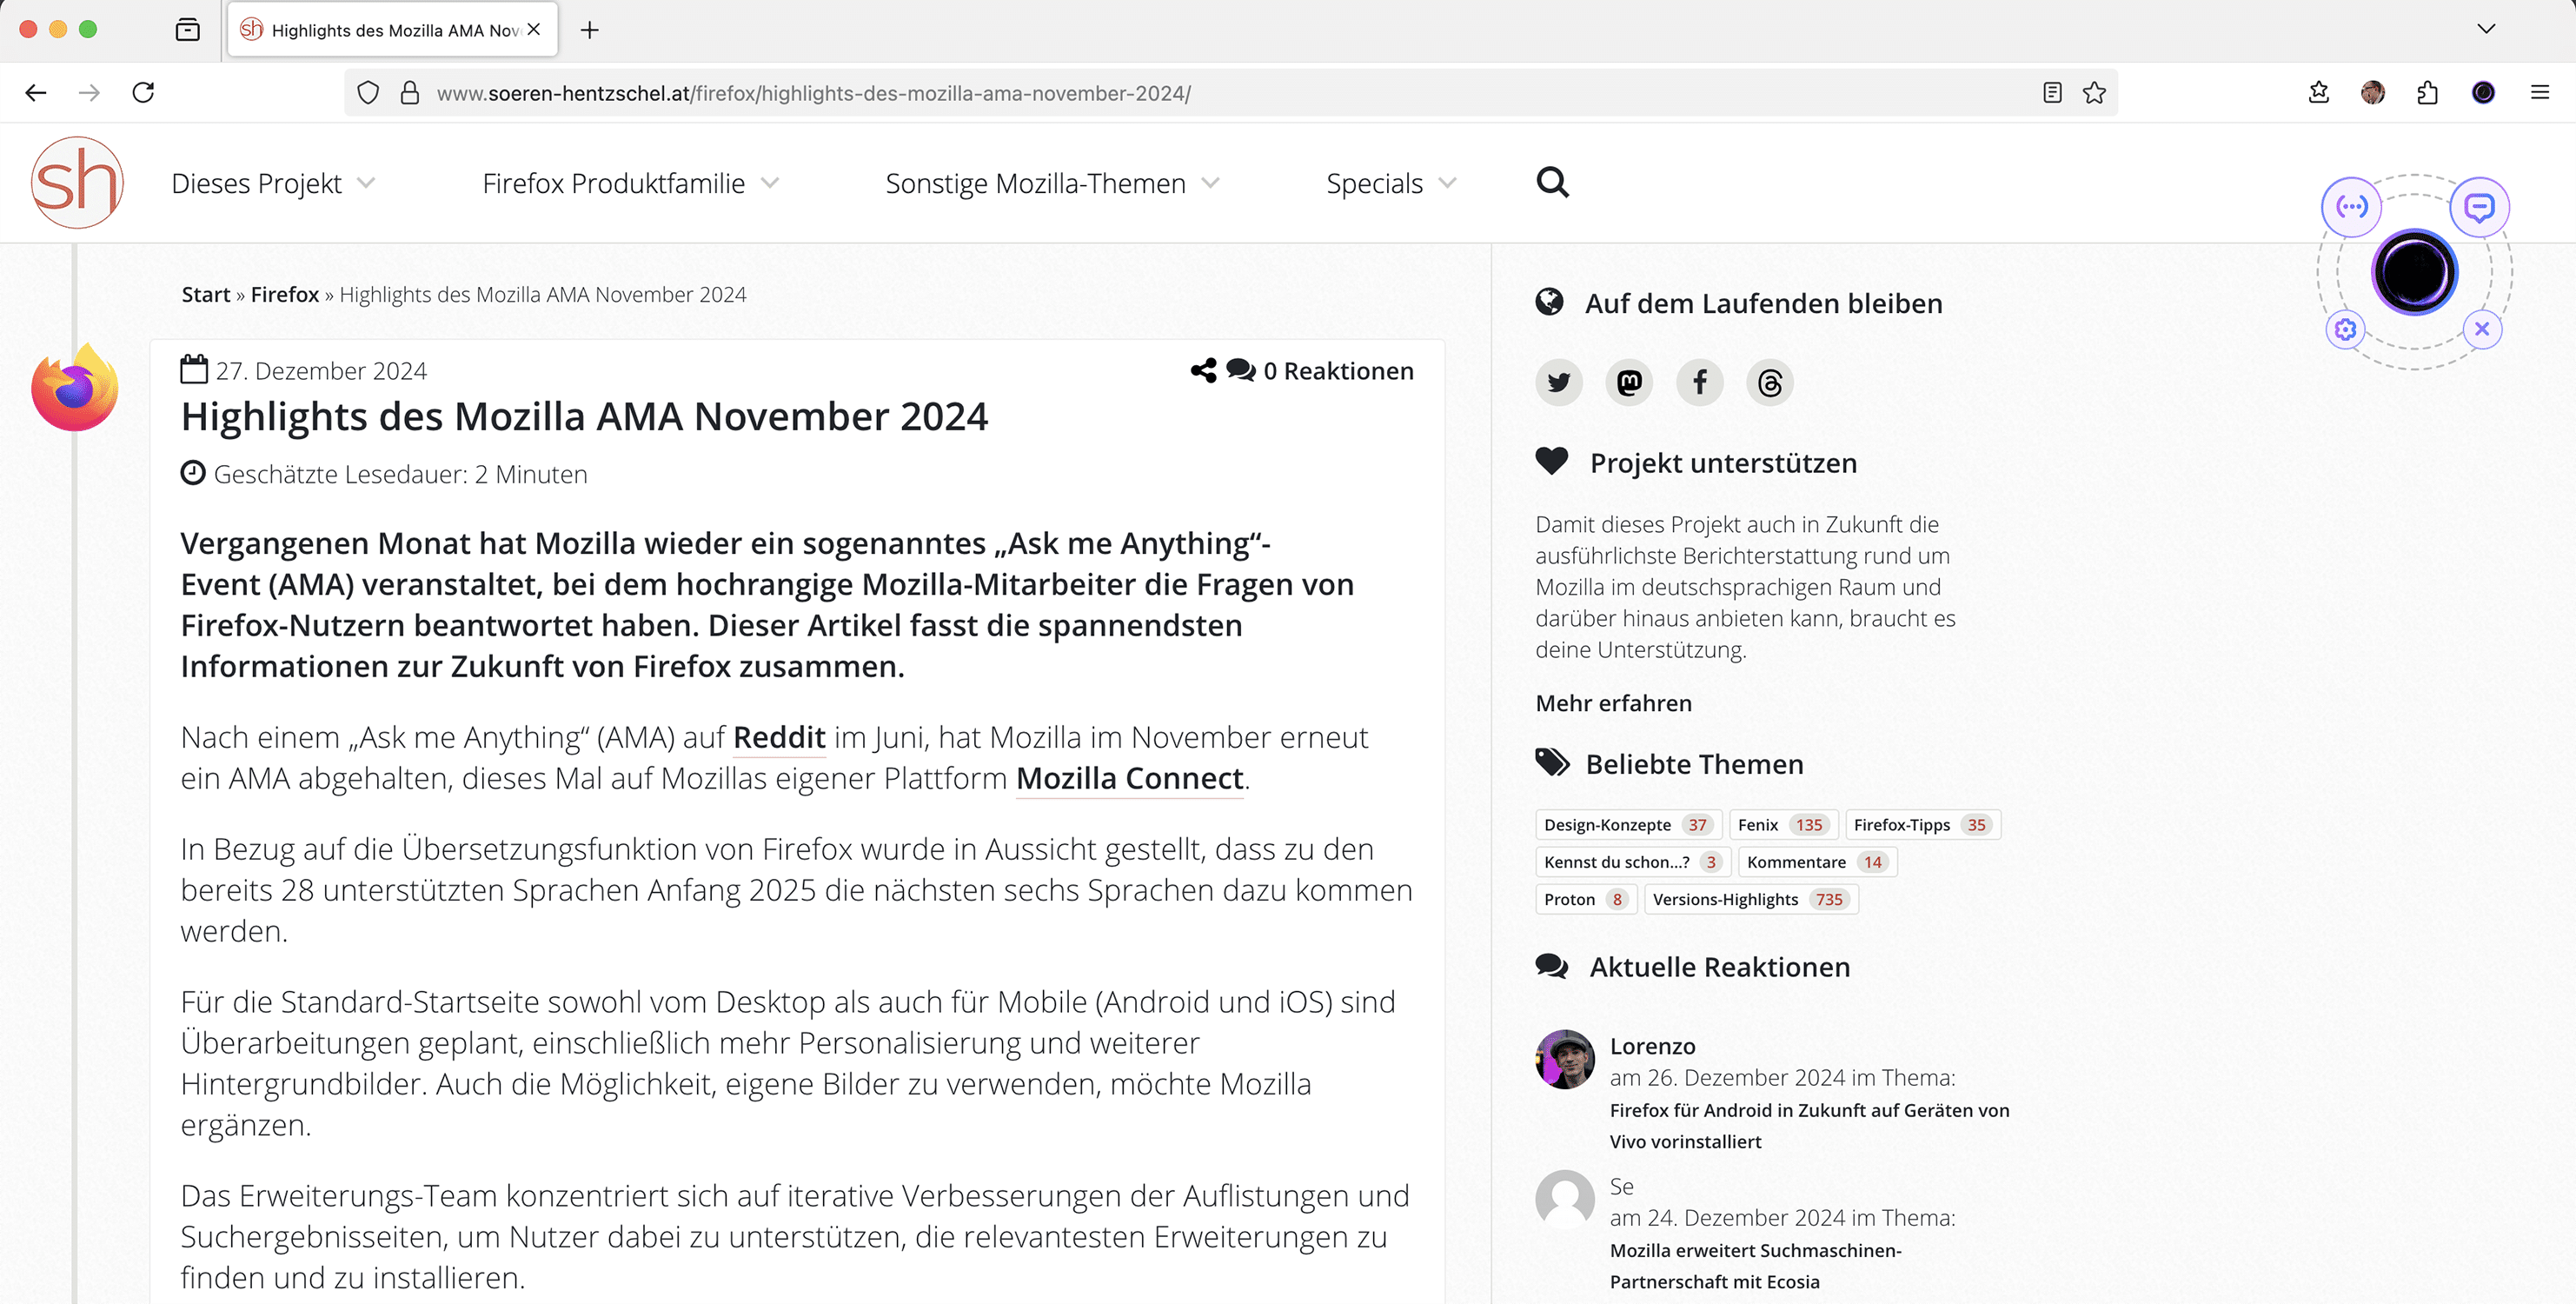
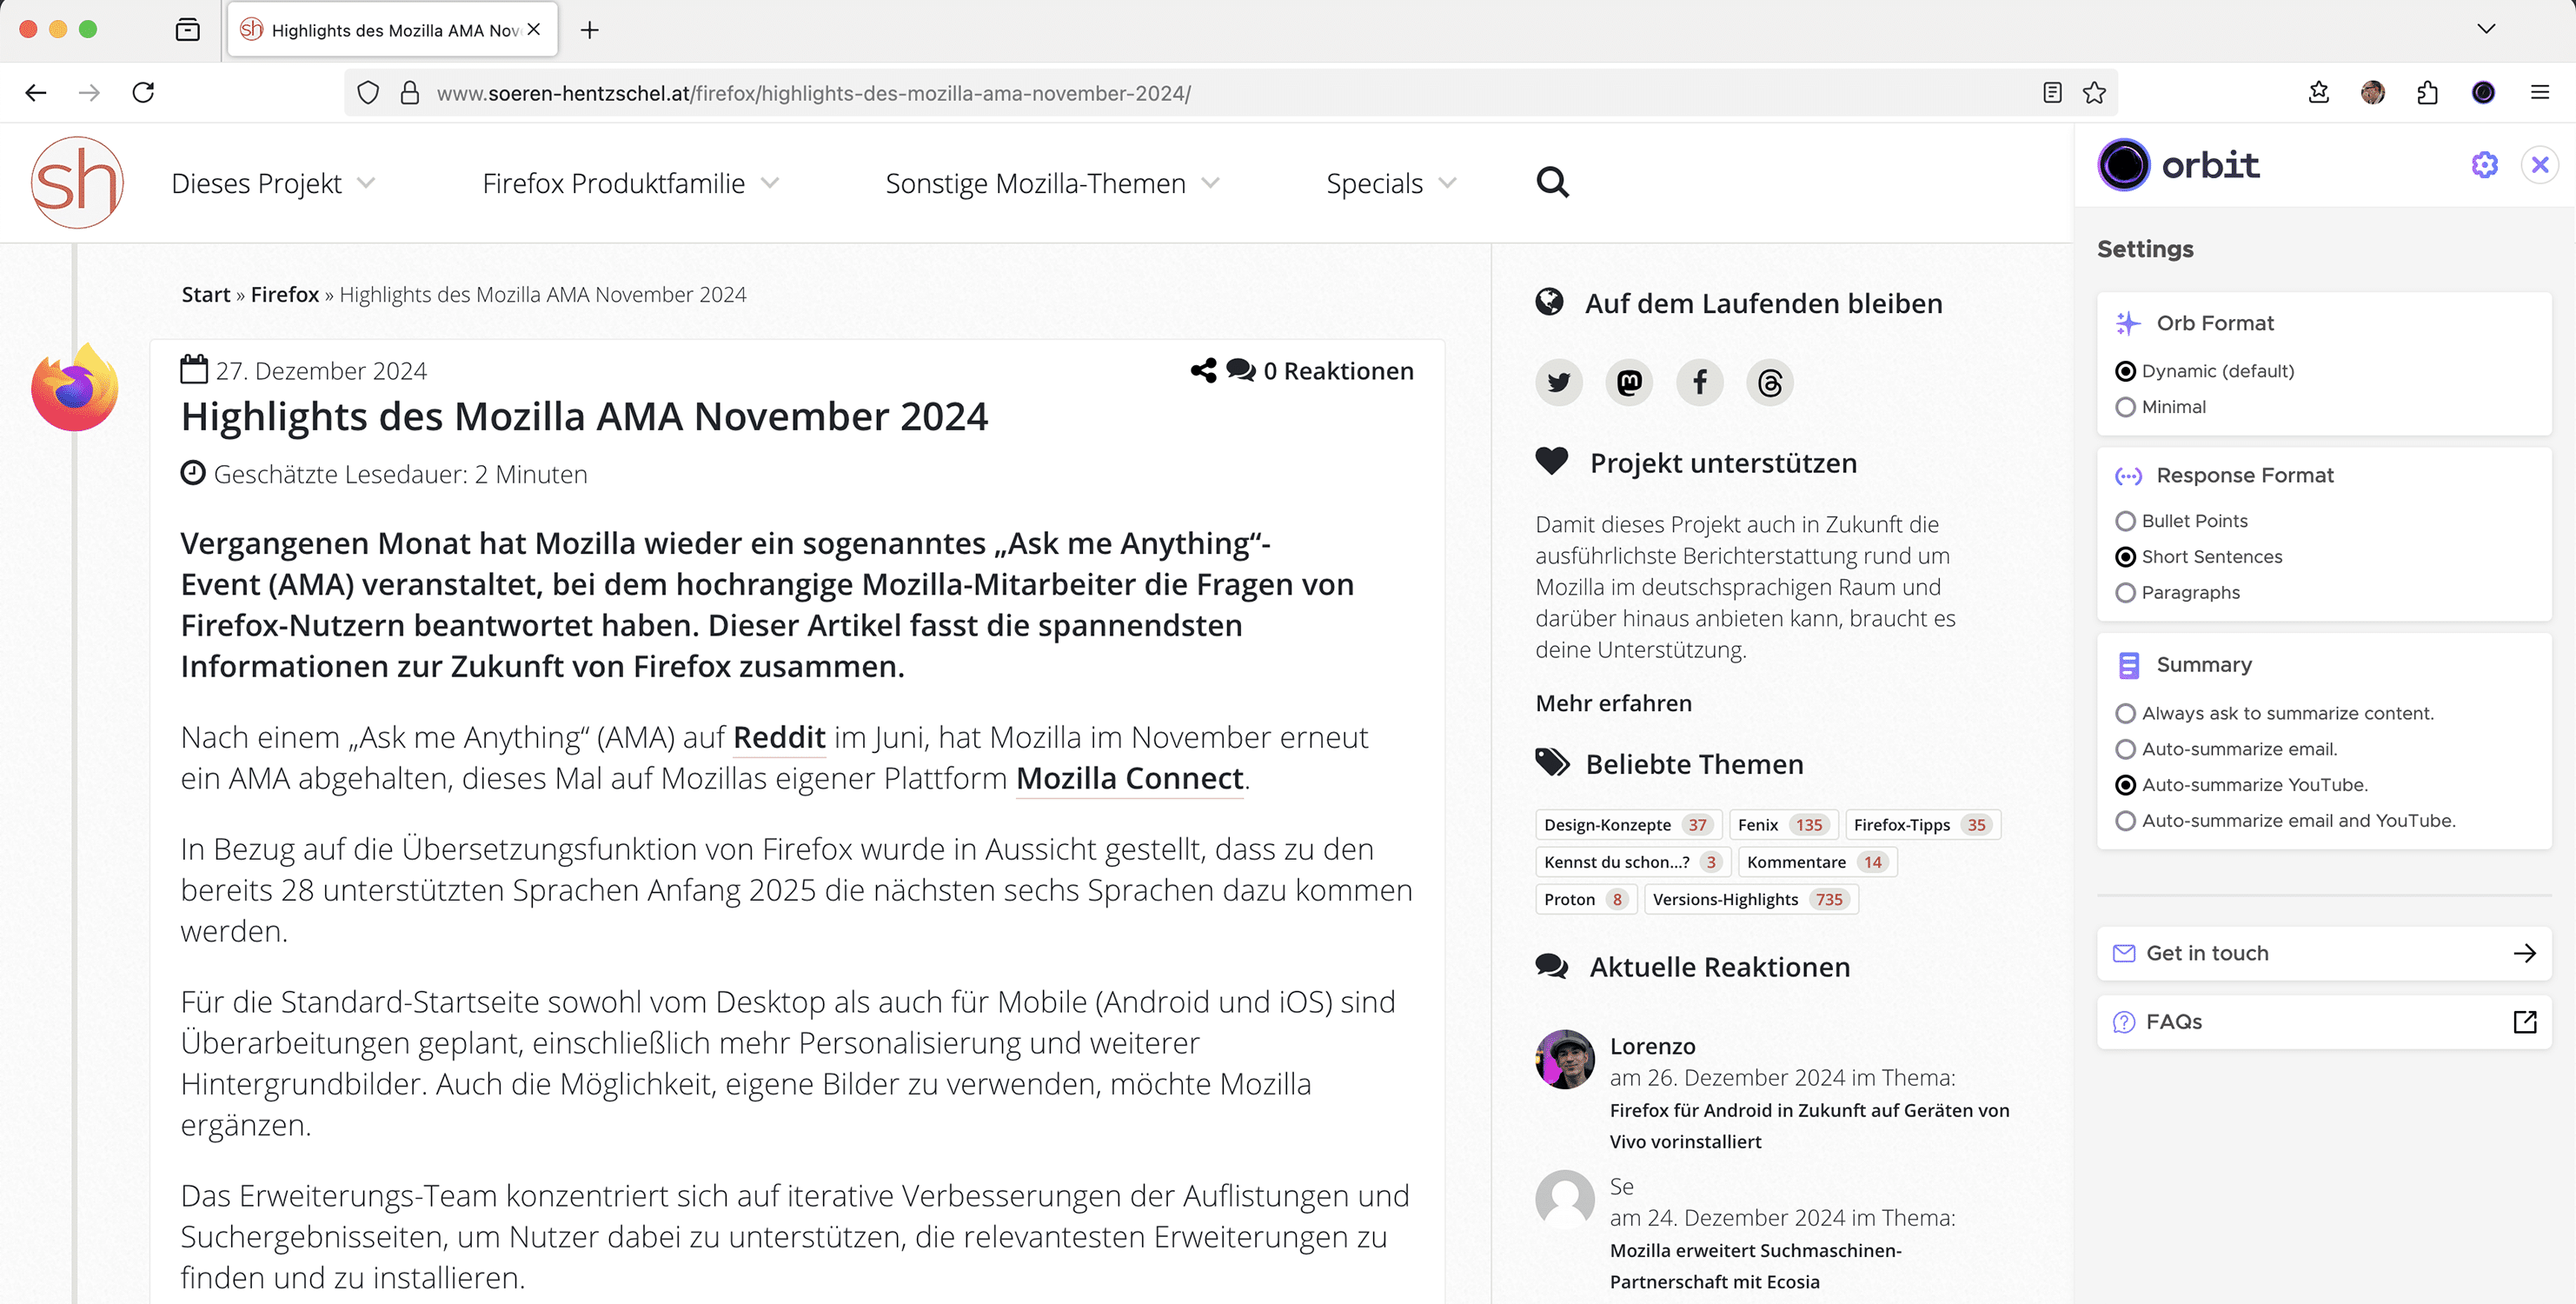
Die Firefox-Erweiterung Orbit by Mozilla, derzeit noch „Beta“ gekennzeichnet, legt standardmäßig ein graphisches Element über alle Websites, welches aber auch an eine beliebige andere Stelle gezogen werden kann. Fährt man mit der Maus über das Element, hat man die Optionen, sich den Inhalt der aktuellen Seite zusammenfassen zu lassen, einen Chatbot zum Inhalt zu befragen, die Einstellungen der Erweiterung zu öffnen oder das Element auszublenden.

In den Einstellungen der Erweiterung lässt sich eine wesentlich minimalistischere Darstellung auswählen, ob Zusammenfassungen automatisch erfolgen sollen und ob man die Zusammenfassungen in Stichpunkten, kurzen Sätzen oder ganzen Absätzen erhalten möchte.

Orbit by Mozilla funktioniert nicht nur für Textdokumente, sondern über die Transkriptionen auch für Videoportale wie YouTube, liefert aktuell aber ausschließlich Ergebnisse in englischer Sprache.

Orbit by Mozilla Orbit by Mozilla Orbit by Mozilla

Für die Verwendung von Orbit by Mozilla wird kein Benutzerkonto benötigt. Als Sprachmodell kommt derzeit Mistral 7B zum Einsatz, welches auf einem Mozilla-Server gehostet wird. Es werden keine Daten mit Dritten geteilt und Orbit by Mozilla vergisst die übermittelten Informationen umgehend, sobald man auf eine andere Seite navigiert. Da keine Daten mit Mistral geteilt werden, findet durch die Nutzung der Erweiterung auch kein Training des Sprachmodells statt und die Informationen bleiben wirklich privat.

Der Beitrag Orbit by Mozilla: KI-Assistent als Firefox-Erweiterung erschien zuerst auf soeren-hentzschel.at.

Zum Jahresende möchte ich kurz zurückblicken und reflektieren, wie dieses Jahr für meinen kleinen Blog verlaufen ist.

Anzahl veröffentlichter Artikel

Behandelte Themen

Thematisch haben sich fast alle Artikel mit Freier Software und Open Source beschäftigt oder waren daran angelehnt. Wie auch in den vorangegangenen Jahren habe ich keine bewussten Themenschwerpunkte gesetzt, sonder über die Themen geschrieben, dich mich in der jeweiligen Zeit interessierten und mich beschäftigt haben.

Zu Beginn des Jahres hatte es mir das Thema IPv6 angetan, wozu vier Beiträge erschienen sind:

Das Thema begleitet mich auch weiterhin, jedoch gibt es bisher keine spannenden Neuigkeiten, die ich für berichtenswert halte. Ich fürchte, IPv6 wird sobald nicht die Weltherrschaft an sich reißen.

Ein Thema, welches mir sehr wichtig war und ist, ist die Dokumentation für den Notfall bzw. das digitale Erbe. Wie die Kommentare zu diesem Artikel bezeugen, bin ich nicht der Einzige, der sich darum Gedanken macht. Leider bin ich 2024 kaum damit vorangekommen und schiebe es weiter vor mir her. Dies ärgert mich etwas, da ich mir wünsche, mich für ein so wichtiges Thema besser aufraffen zu können.

In 2024 wurden wir auf allen Kanälen mit Künstlicher Intelligenz, Maschinellem Lernen und großen Sprachmodellen überflutet. Es fällt schon fast schwer noch irgendeine Anwendung oder ein Produkt ohne AI kaufen zu können. Abseits des Hypes habe ich mich ebenfalls mit dem Thema beschäftigt und zwei Beiträge ( [1] und [2]) dazu geschrieben. Ich bin überzeugt, dass die verschiedenen Spielarten der künstlichen Intelligenz unser Leben und unsere Art zu Arbeiten stark beeinflussen und verändern werden. Daher werde auch ich hier am Ball zu bleiben, um nicht von der laufenden Entwicklung abgehängt zu werden.

Fazit

Damit sind 2024 insgesamt 26 Artikel erschinen. Das sind 19 weniger als in 2023. Mein selbst gestecktes Ziel, jeden Monat mindestens zwei Artikel zu veröffentlichen habe ich ebenfalls nicht erreicht. Da dies mein Hobby ist und mir primär Freude bereiten soll, setze ich mich durch diese Zielverfehlung nicht unter Druck.

Das Jahr 2025 lasse ich ohne große Ziele und Bestrebungen auf diesen Blog zukommen. Nur eines ist sicher, ich werde meine Texte weiterhin selbst und ohne KI-Unterstützung schreiben. Denn damit würde ich mir nur selbst die Freude am Bloggen nehmen.

Ich freue mich, wenn ich auch 2025 wieder interessantes Wissen in meinen Texten mit euch teilen kann. Ich wünsche euch einen guten Rutsch ins Jahr 2025!