staging.inyokaproject.org

19. Januar 2022

Mi, 19. Januar 2022, Lioh Möller

Die chinesische Linux-Distribution deepin wurde in Version 20.4 veröffentlicht. Der LTS-Kernel wurde auf Version 5.10.83 aktualisiert und der Stable-Kernel ist in Version 5.15.6 enthalten.

Die Logik zur Erstellung von Partitionen wurde überarbeitet. Bei einer bereits vorhandenen EFI Partition wird diese nicht neu erstellt. Der mitgelieferte Chromium-basierte Browser wurde aktualisiert und erweitert. Es lassen sich erstmals Sammlungen von Webseiten erstellen und Tabs gruppieren.

Das bereits zuvor integrierte Monitoring zur Feststellung der Systemlast, erlaubt es Maximalwerte festzulegen, bei deren Überschreitung eine Warnung generiert werden soll.

Die integrierte Suche erlaubt es bei einem Klick mit gehaltener Ctrl-Taste den Speicherort einer Datei zu öffnen.

Eine vollständige Übersicht der Änderungen ist in der Release-Ankündigung zu finden.

Download: https://www.deepin.org/en/download/

17. Januar 2022

Mo, 17. Januar 2022, Lioh Möller

Das openSUSE Projekt hat seine jährliche Community Umfrage gestartet. Sie richtet sich an Nutzer und Entwickler der Distribution. Eigentlich hätte diese bereits Ende letzten Jahres veröffentlicht werden sollen, aufgrund der sonst parallel laufenden openSUSE Board Umfrage wurde dies allerdings verschoben.

In der Umfrage wird unter anderem abgefragt, welche openSUSE Variante (Leap, Tumbleweed, microOS) am häufigsten genutzt wird, welche Paketformate bevorzugt verwendet werden (RPM/Zypper, Flatpak, AppImage ...) und in welchem Kontext die Distribution auf Desktops und Servern zum Einsatz kommt.

Wie üblich können direkt Verbesserungsvorschläge eingegeben werden. Das Projekt bemüht sich sehr diese zu analysieren und in zukünftige Entwicklungen einfliessen zu lassen.

Ankündigung: https://news.opensuse.org/2022/01/17/os-begins-annual-survey/
Umfrage: https://survey.opensuse.org/

Inspiriert durch die Artikel von Ricardo Geradi [1] und Alex Callejas [3] schreibe ich diesen, um zu erklären, wie mithilfe von Ansible eine Labor-Umgebung bestehend aus einer oder mehreren virtuellen Maschinen (VMs) auf einem KVM-Hypervisor provisioniert werden kann.

Dabei handelt es sich weniger um ein Tutorial, sondern mehr um eine exemplarische Beschreibung einer möglichen Vorgehensweise, die euch als Vorlage für die eigene Umgebung dienen kann.

Ich gehe nicht darauf ein, wie KVM oder Ansible installiert werden. Hierzu verweise ich auf die Dokumentation der jeweiligen Projekte und der verwendeten Linux-Distributionen.

Motivation

Um Anwendungen zu testen, benötigt man in der Regel ein Betriebssystem, auf welchem diese ausgeführt werden können. Ein Betriebssystem läuft dieser Tage meist innerhalb einer virtuellen Maschine (VM). Um bei Tests stets gleiche Rahmenbedingungen zu haben, wird empfohlen, für jeden Test eine neue VM mit einer definierten Konfiguration zu provisionieren, die geplanten Tests durchzuführen, die Ergebnisse zu sichern und die VM zu dekommissionieren.

Möchte man Infrastrukturdienste testen, werden häufig gleich mehrere VMs benötigt. Diese werden auch als Labor-Umgebung bezeichnet.

Um nicht unnötig Zeit mit der Provisionierung der VMs zu verlieren — immerhin möchte man ja seine Anwendungen bzw. Dienste testen — bietet es sich an, diesen Prozess zu automatisieren.

Doch warum mit Ansible und nicht mit [hier Lieblings-Werkzeug eurer Wahl einsetzen]?

Viele Wege führen nach Rom. Und es gibt vermutlich ähnlich viele Werkzeuge, um eine Labor-Umgebung in KVM zu provisionieren. Ich habe mich in diesem Fall für Ansible entschieden, da:

  • Ich fast täglich damit arbeite.
  • Mit ansible-galaxy role init erstellte Rollen meiner bescheidenen Meinung nach (mbMn) eine schöne Struktur zur Organisation des Codes vorgeben.
  • Mit ansible-vault ein Werkzeug dabei ist, um Dateien mit sensiblen Informationen zu verschlüsseln und diese im weiteren Verlauf einfach zu nutzen.
  • Ich meine YAML-Dateien nächstes Jahr leichter lesen und verstehen kann als meine Shell-Skripte.
  • Ich in einem zukünftigen Artikel zeigen möchte, wie man mit Ansible eine Labor-Umgebung in einem VMware vSphere Cluster provisioniert.

Umgebung

KVM-Hypervisor: Debian 11 Bullseye

Die .qcow2-Image-Dateien für die VMs werden auf dem KVM-Hypervisor im Verzeichnis /var/lib/libvirt/images/ vorgehalten.

Getestete Ansible Versionen:

  • ansible 2.10.8 ( auf Debian 11 Bullseye)
  • ansible [core 2.12.1] (auf Fedora 35)

Die Verzeichnisstruktur für meine Ansible-Umgebung entspricht der aus dem Artikel Linux-Benutzerkonten mit Ansible verwalten, wie sie im dortigen Abschnitt Vorbereitung beschrieben ist.

Die im Laufe dieses Artikels provisionierte Labor-Umgebung wird aus einer RHEL-7 und einer RHEL-8-VM bestehen. Selbstverständlich ist es möglich, durch einfache Anpassungen weitere VMs sowie andere Linux-Distributionen zu provisionieren.

Vorarbeit

Ricardo Geradi [1] und Alex Callejas [3] beziehen in ihren Artikeln die qcow2-Images, welche sie als Vorlage (engl. Template) für weitere VMs verwenden, aus diversen Internet-Quellen. Ich bin kein Freund davon, mir Images aus dem Netz zu laden und zu nutzen, für die es keine ordentliche Dokumentation gibt, mit welchen Paketen und Einstellungen diese erzeugt wurden.

Wer kauft schon gern die Katze im Sack? Daher erstelle ich mir meine Vorlagen selbst. Dazu führe ich für jede Distribution, für die ich eine Vorlage erstellen möchte, eine manuelle Installation durch. Um die Vorlagen unter all den anderen VMs leicht identifizieren zu können, gebe ich ihnen Namen wie z.B.:

  • rhel7-template
  • rhel8-template
  • debian11-template

Dabei hinterlege ich beim User root bereits den SSH-Public-Key, den ich später mit Ansible verwenden möchte, um diese Systeme weiter zu konfigurieren. Dies tue ich zwar bisher. Es ist für die Verwendung der hier beschriebenen Rolle nicht erforderlich.

Möchte ich eine Vorlage aktualisieren, fahre ich die dazugehörige VM hoch, führe ein Paket-Update durch, fahre die VM wieder herunter und bin fertig. Dies mache ich in der Regel alle paar Monate, wenn mir das Paket-Update bei neu provisionierten VMs zu lange dauert und spätestens nach Erscheinen eines neuen Minor-Release.

Die Ansible-Rolle

Eine Ansible-Rolle wird mit dem Befehl ansible-galaxy role init role_name initialisiert. In meinem Fall sieht dies wie folgt aus:

$ ansible-galaxy role init kvm_provision_lab
- Role kvm_provision_lab was created successfully
$ tree kvm_provision_lab
kvm_provision_lab
├── defaults
│   └── main.yml
├── meta
│   └── main.yml
├── README.md
├── tasks
│   └── main.yml
├── templates
└── vars
    └── main.yml

In obiger Ausgabe fehlen die Verzeichnisse Files und Handlers. Diese hatte ich bereits gelöscht, da sie nicht benötigt werden. Die erstellte Verzeichnisstruktur kann, je nach verwendeter Version von ansible-galaxy, leicht unterschiedlich aussehen. Benötigt werden in diesem Beispiel nur die oben dargestellten Verzeichnisse und Dateien. Streng genommen können das Verzeichnis meta und die Datei README.md ebenfalls entfernt werden, wenn man nicht vorhat, die Rolle zu veröffentlichen. Ich behalte beide bei und nutze die Dateien zur Dokumentation der Rolle.

Variablen

Es ist gute Praxis alle Variablen, die von einer Ansible-Rolle verarbeitet werden, in der Datei defaults/main.yml zu dokumentieren und mit Standardwerten zu versehen. Genannte Datei hat hier folgenden Inhalt:

$ cat -n defaults/main.yml 
     1	---
     2	libvirt_pool_dir: "/var/lib/libvirt/images"
     3	vm_root_pass: "123456"
     4	ssh_key: "/path/to/ssh-pub-key"
     5	
     6	guests:
     7	  test:
     8	    vm_ram_mb: 512
     9	    vm_vcpus: 1
    10	    vm_net: default
    11	    os_type: rhel7
    12	    file_type: qcow2
    13	    base_image_name: rhel7-template
    14	    vm_template: "rhel7-template"
    15	    second_hdd: false
    16	    second_hdd_size: ""
    17	  test2:
    18	    vm_ram_mb: 512
    19	    vm_vcpus: 1
    20	    vm_net: default
    21	    os_type: rhel8
    22	    file_type: qcow2
    23	    base_image_name: rhel8-template
    24	    vm_template: "rhel8-template"
    25	    second_hdd: true
    26	    second_hdd_size: "100M"

In Zeile 2-4 werden Variablen definiert, die unabhängig von einzelnen VMs für die gesamte Rolle gelten. Dies sind der Speicherort für Image-Dateien, das Passwort für den Root-Benutzer der VMs, sowie der Pfad zu dem SSH-Public-Key, welcher beim Root-Benutzer hinterlegt werden soll.

In Zeile 6 beginnt ein sogenanntes Ansible-Dictionary (siehe [6]) namens guests. Es enthält als Keys die Namen der VMs (hier test und test2) und ordnet diesen diverse Variablen als Werte zu (z.B. vm_ram_mb). Die hierfür gewählten Strings müssen gültige Ansible-Variablen sein (siehe [7]).

Die einzelnen Variablen kurz erklärt:

  • vm_ram_mb gibt die Größe des Gast-Arbeitsspeichers in Megabyte (MB) an.
  • vm_vcpus spezifiziert die Anzahl CPUs der VM.
  • vm_net bezeichnet das KVM-Netzwerk, mit dem die VM verbunden wird.
  • os_type wird aktuell noch nicht verwendet.
  • file_type gibt den Typ der Image-Datei an.
  • base_image_name verweist auf den Namen der zu verwendenden Vorlage, die zuvor manuell installiert wurde.
  • vm_template referenziert eine Jinja2-Template-Datei, welche wir uns im nächsten Abschnitt anschauen werden.
  • second_hdd kann auf true oder false gesetzt werden und bestimmt, ob einer VM eine zweite Festplatte hinzugefügt werden soll.
  • second_hdd_size gibt die Größe der zweiten Festplatte in Megabyte (MB) an.

Führt man diese Rolle mit einem Playbook aus, ohne eigene Variablen zu definieren, werden also zwei VMs mit den Namen test und test2 sowie den obigen Parametern erstellt.

Um die Rolle möglichst flexibel einsetzen und wiederverwenden zu können, werden die gewünschten Labor-Umgebungen in separaten Dateien definiert. Für mein RHEL-Lab habe ich die benötigten Variablen in die Datei vars/rhel_lab.yml geschrieben, welche ich mit ansible-vault create vars/rhel_lab.yml erstellt habe. So bleiben mein gewähltes Passwort sowie Pfad zu und Name von meinem SSH-Public-Key vor neugierigen Blicken geschützt. Der Inhalt der Datei entspricht vom Aufbau her jedoch dem aus obigem Code-Block der defaults/main.yml. Wie die Datei rhel_lab.yml genutzt wird, wird in Abschnitt „Das Playbook“ erläutert.

Templates

In der KVM-Terminologie wird eine VM auch als Gast-Domain (engl. guest domain) bezeichnet. Die Definition der Gast-Domain kann in Form einer XML-Datei erfolgen. In diesem Abschnitt werde ich zeigen, wie man die Konfiguration einer bestehenden VM in eine XML-Datei schreibt, um diese anschließend als Template für neue VMs zu benutzen.

Im Vorfeld habe ich die VMs rhel7-template und rhel8-template manuell installiert. Diese werde ich nun nutzen, um daraus Jinja2-Templates abzuleiten, welche ich innerhalb der Rollen-Verzeichnisstruktur im Verzeichnis templates ablege. Der folgende Codeblock zeigt den Befehl exemplarisch für das rhel7-template:

$ sudo virsh dumpxml rhel7-template >templates/rhel7-template.xml.j2

Das rhel8-template.xml.j2 wird auf die gleiche Weise erzeugt. Der Inhalt wird im Folgenden auszugsweise dargestellt:

<domain type='kvm'>
  <name>rhel8-template</name>
  <uuid>cb010068-fe32-4725-81e8-ec24ce237dcb</uuid>
  <metadata>
    <libosinfo:libosinfo xmlns:libosinfo="http://libosinfo.org/xmlns/libvirt/domain/1.0">
      <libosinfo:os id="http://redhat.com/rhel/8-unknown"/>
    </libosinfo:libosinfo>
  </metadata>
  <memory unit='KiB'>2097152</memory>
  <currentMemory unit='KiB'>2097152</currentMemory>
  <vcpu placement='static'>1</vcpu>
[...]
  <devices>
    <emulator>/usr/bin/qemu-system-x86_64</emulator>
    <disk type='file' device='disk'>
      <driver name='qemu' type='qcow2'/>
      <source file='/var/lib/libvirt/images/rhel8-template.qcow2'/>
      <target dev='vda' bus='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x06' function='0x0'/>
    </disk>
    <disk type='file' device='cdrom'>
      <driver name='qemu' type='raw'/>
      <target dev='hdb' bus='ide'/>
      <readonly/>
      <address type='drive' controller='0' bus='0' target='0' unit='1'/>
    </disk>
[...]
    <interface type='network'>
      <mac address='52:54:00:0c:8d:05'/>
      <source network='default'/>
      <model type='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x03' function='0x0'/>
    </interface>
[...]
  </devices>
</domain>

Die Template-Dateien sind zu bearbeiten, um aktuell statisch konfigurierte Werte durch Variablen zu ersetzen. Die zu bearbeitenden Zeilen sehen anschließend wie folgt aus:

  • <name>{{ item.key }}</name>
  • <memory unit='MiB'>{{ item.value.vm_ram_mb }}</memory>
  • <vcpu placement='static'>{{ item.value.vm_vcpus }}</vcpu>
  • <source file='{{ libvirt_pool_dir }}/{{ item.key }}.qcow2'/>
  • <source network='{{ item.value.vm_net }}'/>

Darüber hinaus sind weitere Zeilen, welche für jede VM einmalig sind, aus den Template-Dateien zu löschen:

  • <uuid>...</uuid>
  • <mac address='...'/>

In der fertigen rhel8-template.xml.j2-Datei sieht es dann wie folgt aus:

<domain type='kvm'>
  <name>{{ item.key }}</name>
  <metadata>
    <libosinfo:libosinfo xmlns:libosinfo="http://libosinfo.org/xmlns/libvirt/domain/1.0">
      <libosinfo:os id="http://redhat.com/rhel/8-unknown"/>
    </libosinfo:libosinfo>
  </metadata>
  <memory unit='MiB'>{{ item.value.vm_ram_mb }}</memory>
  <vcpu placement='static'>{{ item.value.vm_vcpus }}</vcpu>
[...]
  <devices>
    <emulator>/usr/bin/qemu-system-x86_64</emulator>
    <disk type='file' device='disk'>
      <driver name='qemu' type='qcow2'/>
      <source file='{{ libvirt_pool_dir }}/{{ item.key }}.qcow2'/>
      <target dev='vda' bus='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x06' function='0x0'/>
    </disk>
[...]
    <interface type='network'>
      <source network='{{ item.value.vm_net }}'/>
      <model type='virtio'/>
      <address type='pci' domain='0x0000' bus='0x00' slot='0x03' function='0x0'/>
    </interface>
[...]
  </devices>
</domain>

Solltet ihr zu diesem Abschnitt noch Fragen haben, weil z.B. etwas unverständlich ist, stellt diese bitte in den Kommentaren oder meldet euch per E-Mail. Ich werde den Abschnitt dann je nach Bedarf ergänzen.

Tasks

Als Nächstes stelle ich die Tasks vor, welche von dieser Rolle ausgeführt werden. Dabei beginne ich mit dem Inhalt der Datei tasks/main.yml, deren Inhalt ich nach dem folgenden Codeblock erläutern werde.

$ cat -n tasks/main.yml 
     1	---
     2	# tasks file for kvm_provision_lab
     3	- name: Ensure requirements are in place
     4	  apt:
     5	    name:
     6	      - libguestfs-tools
     7	      - python3-libvirt
     8	    state: present
     9	  become: yes
    10	
    11	- name: Get VMs list
    12	  community.libvirt.virt:
    13	    command: list_vms
    14	  register: existing_vms
    15	  changed_when: no
    16	
    17	- name: Copy base image
    18	  copy:
    19	    dest: "{{ libvirt_pool_dir }}/{{ item.key }}.{{ item.value.file_type }}"
    20	    src: "{{ libvirt_pool_dir }}/{{ item.value.base_image_name }}.{{ item.value.file_type }}"
    21	    force: no
    22	    remote_src: yes
    23	    mode: 0660
    24	    group: libvirt-qemu
    25	  register: copy_results
    26	  with_dict: "{{ guests }}"
    27	
    28	- name: Create VMs if not exist
    29	  include_tasks: create_vms.yml
    30	  when: "item.key not in existing_vms.list_vms"
    31	  with_dict: "{{ guests }}"

Der Task in Zeile 3-9 stellt sicher, dass die notwendigen Voraussetzungen erfüllt sind, um sich mit libvirt verbinden zu können. Der Paketname libguestfs-tools existiert unter CentOS Stream, Debian und RHEL. Unter Fedora heißt das Paket guestfs-tools. Der Name muss an die entsprechende Distribution angepasst werden.

In Zeile 11-15 wird das Modul community.libvirt.virt verwendet, um die Liste der bereits existierenden VMs abzurufen und in der Variablen existing_vms zu speichern. Diese wird später genutzt, um nur dann eine VM zu provisionieren, wenn nicht bereits eine VM mit dem gleichen Namen existiert. Es ist quasi ein schmutziger Trick, um der Rolle ein wenig Idempotenz einzuhauchen. Da mit diesem Task nur Informationen abgefragt werden, jedoch keinerlei Änderungen vorgenommen werden, setzt man changed_when: no.

Das Copy-Modul in Zeile 17-26 kopiert die qcow2-Image-Dateien an den vorgesehenen Zielort und setzt Zugriffsrechte entsprechend. Zeile 19 sorgt dafür, dass die Zieldatei den Namen der neuen VM beinhaltet. Da das Copy-Modul bereits idempotent arbeitet, werden die Dateien nur kopiert, wenn das Ziel nicht bereits existiert. Das Ergebnis des Kopiervorgangs wird in copy_results gespeichert.

Der letzte Task führt die Task-Datei create_vms.yml für die VMs aus, die nicht bereits existieren. Dafür sorgt die Bedingung when: "item.key not in existing_vms.list_vms", die diesem Task zu Idempotenz verhilft. Das Playbook selbst hat folgenden Inhalt:

$ cat -n tasks/create_vms.yml 
     1	---
     2	- name: Configure the image
     3	  command: |
     4	    virt-customize -a {{ libvirt_pool_dir }}/{{ item.key }}.qcow2 \
     5	    --hostname {{ item.key }} \
     6	    --root-password password:{{ vm_root_pass }} \
     7	    --ssh-inject 'root:file:{{ ssh_key }}' \
     8	    --uninstall cloud-init --selinux-relabel
     9	  when: copy_results is changed
    10	
    11	- name: Define VMs
    12	  community.libvirt.virt:
    13	    command: define
    14	    xml: "{{ lookup('template', '{{ item.value.vm_template }}.xml.j2') }}"
    15	
    16	- name: Create second disk images if needed
    17	  command: |
    18	    qemu-img create -f {{ item.value.file_type }} \
    19	    {{ libvirt_pool_dir }}/{{ item.key }}-vdb.{{ item.value.file_type }} {{ item.value.second_hdd_size }}
    20	  become: yes
    21	  when: item.value.second_hdd|bool == true
    22	
    23	- name : Attach second disk image to domain
    24	  command: |
    25	    virsh attach-disk {{ item.key }} \
    26	    --source "{{ libvirt_pool_dir }}/{{ item.key }}-vdb.{{ item.value.file_type }}" \
    27	    --target vdb \
    28	    --persistent
    29	  become: yes
    30	  when: item.value.second_hdd|bool == true
    31	
    32	- name: Ensure VMs are startet
    33	  community.libvirt.virt:
    34	    name: "{{ item.key }}"
    35	    state: running
    36	  register: vm_start_results
    37	  until: "vm_start_results is success"
    38	  retries: 15
    39	  delay: 2

Der Task in Zeile 2-9 konfiguriert den Inhalt der qcow2-Image-Datei. Die Bedingung when: copy_results is changed stellt sicher, dass dies nur passiert, wenn die Image-Datei zuvor an ihren Zielort kopiert wurde. Damit wird sichergestellt, dass nicht eine bereits vorhandene Image-Datei einer existierenden VM nochmals verändert wird. Der Task konfiguriert den Hostnamen, setzt das Root-Passwort und hinterlegt den SSH-Public-Key.

Der nächste Task ab Zeile 11 definiert/erstellt die neue VM aus den XML-Template-Dateien.

Die beiden Tasks in den Zeilen 16-30 fügen einer VM eine zweite Festplatte hinzu, wenn dies in defaults/main.yml bzw. vars/rhel_lab.yml entsprechend definiert wurde.

Der letzte Task sorgt schließlich dafür, dass die neu erstellten VMs eingeschaltet werden.

Das Playbook

Im Vergleich zu den Dateien mit den einzelnen Tasks fällt das Playbook eher kurz aus:

 cat -n kvm_provision_rhel_lab.yml 
     1	---
     2	- name: Provision RHEL lab VMs
     3	  hosts: localhost
     4	  vars_files:
     5	    - roles/kvm_provision_lab/vars/rhel_lab.yml
     6	  tasks:
     7	    - name: Run role kvm_provision_lab
     8	      include_role:
     9	        name: kvm_provision_lab

In Zeile 3 ist der KVM-Hypervisor anzugeben, auf dem die Rolle ausgeführt werden soll. Dies kann, wie in meinem Fall, der gleiche Host wie der Ansible-Control-Node sein.

In Zeile 4 und 5 wird die Datei geladen, welche die Variablen für die zu erstellende Laborumgebung enthält. Ohne diese Anweisung werden die Werte aus defaults/main.yml verwendet.

Abschließend wird die Ansible-Rolle inkludiert. Dies ist auch schon alles.

Zusammenfassung

Das Schreiben dieses Artikels hat deutlich länger gedauert als die Erstellung der eigentlichen Ansible-Rolle zur Erstellung einer Laborumgebung unter KVM.

Die einzelnen Abschnitte beschreiben das Vorgehen und die Bestandteile der Rolle im Detail. Ich hoffe, damit deren Funktionsweise deutlich gemacht zu haben.

Ich kann nun meine Labor-Umgebungen in Dateien wie rhel_lab.yml, debian_lab.yml, etc. definieren und die Rolle dazu verwenden, diese zu provisionieren. So steht mir in kurzer Zeit eine frische Testumgebung bereit. Und zwar jedes Mal aufs neue, wenn ich sie benötige.

Wenn euch dieser Artikel dabei hilft, eigene Labor-Umgebungen mithilfe von Ansible zu provisionieren freut mich dies umso mehr.

Quellen und weiterführende Links

  1. Build a lab in 36 seconds with Ansible. Ricardo Gerardi (Red Hat, Sudoer). Enable Sysadmin. 2021-10-22.
  2. 8 Linux virsh subcommands for managing VMs on the command line. Ricardo Gerardi (Red Hat, Sudoer). Enable Sysadmin. 2021-09.09.
  3. Build a lab in five minutes with three simple commands. Alex Callejas (Red Hat). Enable Sysadmin. 2021-08-20.
  4. Ansible Create KVM Guests
  5. community.libvirt.virt – Manages virtual machines supported by libvirt
  6. Ansible Dictionary Variables. URL: https://docs.ansible.com/ansible/latest/user_guide/playbooks_variables.html#dictionary-variables
  7. Creating valid variable names. URL: https://docs.ansible.com/ansible/latest/user_guide/playbooks_variables.html#creating-valid-variable-names

16. Januar 2022

Ich dachte ja eigentlich, dass ich mich Jahr 2022 mit solchen Details nicht mehr auseinandersetzen müsste, aber da habe ich mich wohl geirrt.

Worum geht's?

Die nicht mehr ganz so jungen Generationen erinnern sich, Festplatten hatten historisch bedingt eine Sektorgröße von 512 Byte. Mit Aufkommen des Advanced Format (AF) hatte man das auf 4096 Byte (4K) geändert. Vorteil war, dass man mit einer Leseoperation die 8-fache Menge an Daten bekam, das Ganze besser zur Größe der Speicherseite („page size“) moderner Prozessoren passt, insgesamt bessere Performance liefert, und generell auch erlaubt mehr Daten bei gleicher Adressierung anzusprechen. Seit ca. 2011 unterstützt so ziemlich jeder Datenträger (ausgenommen microSD-Karten/USB-Sticks und anderes eher Low-Level Flash-Gedöns) dieses Format.

Und wie immer gibt's einen fetten Haken an der Sache: Aufgrund der Abwärtskompatibilität können die meisten (wenn nicht alle) dieser Datenträger auch mit 512 Byte Sektorgröße umgehen, womit auch alle oben genannten Vorteile verschwinden.

Und mein Dateisystem möchte?

Und da wird's jetzt unangenehm. Es ist nämlich so, dass moderne Dateisysteme mit Sektorgrößen von 4K arbeiten, d.h. eine Sektorgröße von 512 Byte auf dem Datenträger, der intern eigentlich auch 4K verwendet, ergibt mal so überhaupt gar keinen Sinn.

Ich hab mal für die IMHO gebräuchlichsten Dateisysteme nachgesehen:

  • btrfs will mindestens 4K
  • ext4 will mindestens 1K (Standard ist trotzdem 4K)
  • f2fs 512 Byte (was insofern Sinn ergibt, weil es eher für Flashspeicher in microSD-Karten und USB-Sticks konzipiert ist)
  • ZFS nutzt mindestens 4K
  • XFS will mindestens 512 Byte, nutzt aber 4K falls möglich
  • NTFS nutzt ab Windows 7 durchgängig mindestens 4K
  • FAT (FAT16/32) nutzt ab 128MB Größe der Partition auch 4K
  • ...und exFAT nutzt ebenfalls Sektorgrößen ab 4K aufwärts

Sektorgrößen auslesen

Mittels parted -l lassen sich Sektorgrößen ausgeben, sieht bei einer SATA-SSD bspw. wie folgt aus:

[root:~] # parted -l
Modell: ATA SK hynix SC311 S (scsi)
Festplatte  /dev/sda:  256GB
Sektorgröße (logisch/physisch): 512B/4096B
Partitionstabelle: gpt
Disk-Flags:
[…]

Bei einer NVMe-SSD sieht's etwas anders aus, diese lassen sich in der Regel intern umformatieren. Heißt: Die Ausgabe von parted -l zeigt bspw. folgendes an:

[root:~] # parted -l
Modell: TOSHIBA-RC100 (nvme)
Festplatte  /dev/nvme0n1:  240GB
Sektorgröße (logisch/physisch): 4096B/4096B
Partitionstabelle: gpt
[…]

In Wahrheit kann das Ding aber viel mehr, je nach Konfiguration. Das bekommt man mittels smartctl -a /dev/<device> heraus:

[root:~] # smartctl -a /dev/nvme0n1
smartctl 7.2 2020-12-30 r5155 [x86_64-linux-5.15.12-200.fc35.x86_64] (local build)
Copyright (C) 2002-20, Bruce Allen, Christian Franke, www.smartmontools.org

=== START OF INFORMATION SECTION ===
[…]
Namespace 1 Formatted LBA Size:     4096

[…]

Supported LBA Sizes (NSID 0x1)
Id Fmt  Data  Metadt  Rel_Perf
 0 +    4096       0         0
 1 -     512       0         3

[…]

[root:~] # 

Wie man sehen kann, nutzt die NVMe-SSD aktuell eine Sektorgröße von 4K, könnte aber auch 512 Byte. Was man hier nicht sieht: Die 512 Byte waren ursprünglich vorkonfiguriert, aufgrund der AbWäRtSkOmPaTiBiLiTäT, was mal eben die Datenrate von 1,4GB/s auf nicht ganz so schöne 700MB/s halbiert. Kannste dir nicht ausdenken, dass sowas als Standard ausgeliefert wird...

Noch schöner finde ich in der Tabelle hinten den Eintrag Rel_Perf, der gibt nämlich schon an, dass 4K Sektorgröße deutlich schneller sind als 512 Byte Sektorgröße. Warum man dann trotzdem 512 Byte als Standard anbietet, wenn literally jedes Betriebssystem heutzutage mit 4K umgehen kann? Keine Ahnung.

Aber zumindest LUKS nutzt 4K, ja?

Noch lustiger wird's allerdings, weil meine Datenträger alle verschlüsselt sind. Man würde jetzt denken, hey, wenn logisch 512 Byte angegeben sind, und physisch 4K, dann nimmt doch LUKS auf jeden Fall auch 4K Sektorgröße, nicht? Oder noch besser: Standardmäßig einfach immer 4K nehmen, weil insgesamt die bessere Wahl? Vor allem, wenn das Dateisystem, welches sich später innerhalb der LUKS-Partition befindet, mit unglaublich hoher Wahrscheinlichkeit ebenfalls 4K Sektorgrößen verwendet? Denkste.

Aufgrund der oben genannten AbWäRtSkOmPaTiBiLiTäT nutzt LUKS, wenn's die Wahl hat, auch lieber 512 Byte.

Bevor man weitermacht…

Um's nochmal kurz zu umreißen: Wer ein Dateisystem mit 4K Sektorgröße einsetzt, und evtl. auch noch LUKS, auf einer SSD die angibt mit 512 Byte Sektorgröße zu arbeiten, kann durch Umstellung auf 4K etwas mehr Datenrate herausholen.

„etwas mehr“ bedeutet hierbei, soweit ich das ermitteln konnte, zwischen 0 und 100 Prozent. Eine Umstellung bringt im schlechtesten Falle also nichts, im besten Falle verdoppelt sich die Datenrate (wie bei mir geschehen).

Vorher empfiehlt sich wie immer ein Backup zu machen, und natürlich auch zu schauen womit die Hardware und womit die Software wirklich arbeitet (via parted -l, cryptsetup luksDump, und dateisystemspezifischen Tools zum Auslesen der Sektorgröße).

LUKS-Partition auf SATA-SSDs umstellen

Das Gute: LUKS-Partitionen auf SATA-SSDs lassen sich im laufenden Betrieb von 512 Byte auf 4K umstellen. Dazu muss zwar die komplette Partition gelesen und neu verschlüsselt werden, aber LUKS ist in der Hinsicht wirklich durchdacht, denn auch ein Absturz des Rechners richtet hier i.d.R. keinen Schaden an. Man kann den Prozess jederzeit unterbrechen und später fortsetzen.

Zuerst sollte man aber prüfen, ob LUKS nicht doch schon zufälligerweise die richtige Sektorgröße verwendet:

[root:~] # cryptsetup luksDump /dev/sdxY
LUKS header information
Version:       	2
[…]
Data segments:
  0: crypt
	offset: 16777216 [bytes]
	length: (whole device)
	cipher: aes-xts-plain64
	sector: 512 [bytes]
[…]

Wie man sehen kann ist das nicht der Fall. Eine Umstellung kann mittels cryptsetup reencrypt erfolgen:

[root:~] # cryptsetup --type luks2 --sector-size 4096 reencrypt /dev/sdxY

Wichtig: Der Vorgang kann (muss aber nicht) das darin befindliche Dateisystem unbrauchbar machen. Ich hab's bei insgesamt vier Partitionen getestet (mit darin befindlichem btrfs-Dateisystem), und hatte keine Probleme.

NVMe-SSDs neu formatieren auf 4K

Bei NVMe-SSDs sieht die Sache etwas anders aus, hier muss man nämlich erst die interne Sektorgröße umstellen, was bei mir zum Verlust aller Daten geführt hat. Mittels nvme id-ns kann man die unterstützten LBA-Größen auswählen, und dann mittels nvme format die NVMe-SSD entsprechend formatieren:

[root:~] # nvme id-ns /dev/nvme0n1 | grep lbaf
[…]
lbaf  0 : ms:0   lbads:12 rp:0
lbaf  1 : ms:0   lbads:9  rp:0x3 (in use)

[root:~] # nvme format --lbaf 0 /dev/nvme0n1
[…]

[root:~] # nvme id-ns /dev/nvme0n1 | grep lbaf
[…]
lbaf  0 : ms:0   lbads:12 rp:0 (in use)
lbaf  1 : ms:0   lbads:9  rp:0x3

Dann eine neue Partitionstabelle erstellen, eine LUKS-Partition mit Sektorgröße 4K anlegen, und darin dann das gewünschte Dateisystem erstellen. Gut, und Daten zurückspielen, die man vorher natürlich™ gesichert hat.

Wie sieht's bei HDDs aus?

Kann ich ehrlich nicht beantworten. Ich kann mir vorstellen, dass HDDs in der Hinsicht wie SATA-SSDs funktionieren: Intern also 4K verwenden, logisch aber 512 Byte angeben. Tests dazu habe ich aber noch nicht gemacht - ich habe zur Zeit HDDs ausschließlich als Storage im Einsatz, d.h. mit relativ langsamen Datenraten und dafür relativ groß. Diese im laufenden Betrieb neu zu formatieren ist mir dann doch etwas zu heikel - da muss sich erst die Chance ergeben günstig irgendwo eine 4TB-Platte zu erwerben, die ich dann auch gleich meinem RAID hinzufügen kann. Ich kann aber sagen, dass die Ausgabe von parted -l für meine 4TB-Platten 512/4096 ausgibt, und für meine 1TB-Platte aus dem Jahr 2009 512/512 (was logisch ist, da das eingangs erwähnte Advanced Format 2009 noch nicht standardisiert war - hier waren 512 Byte Sektorgrößen noch der Standard).

Fazit

Anregung zu dem Artikel hat übrigens dieser Post auf Reddit gegeben. Ich persönlich ärgere mich ja, dass mir das zum einen nicht früher aufgefallen ist (normalerweise™ teste ich meine Hardware vor Inbetriebnahme, aber bei meinem aktuellen ThinkPad war damals keine Zeit, und dann habe ich einfach alle Defaults übernommen), zum anderen verstehe ich nicht ganz, warum man im Jahr 2022 überhaupt noch Datenträger bekommt die etwas von 512 Byte vorgaukeln. Abgesehen davon hat die Umstellung von 512 Byte auf 4K die Datenrate auf meiner NVMe-SSD verdoppelt.

Nerdige Notiz am Rande: Ich habe selbstverständlich nicht ein extra Backup meiner NVMe-SSD gemacht (generell Backups existieren natürlich schon), diese dann neu formatiert, und alle Daten zurückgespielt. Da ich btrfs verwende habe ich einfach die Daten im laufenden Betrieb auf eine andere SSD geschoben, dann die NVMe-SSD formatiert, und dann wieder zurückgeschoben. Alles im laufenden Betrieb. Zero Downtime 😎

Und die restlichen LUKS-Partitionen auf den SATA-SSDs wurden auch im laufenden Betrieb konvertiert. Alles andere wäre ja langweilig 😉

Ich dachte ja eigentlich, dass ich mich Jahr 2022 mit solchen Details nicht mehr auseinandersetzen müsste, aber da habe ich mich wohl geirrt.

Worum geht's?

Die nicht mehr ganz so jungen Generationen erinnern sich, Festplatten hatten historisch bedingt eine Sektorgröße von 512 Byte. Mit Aufkommen des Advanced Format (AF) hatte man das auf 4096 Byte (4K) geändert. Vorteil war, dass man mit einer Leseoperation die 8-fache Menge an Daten bekam, das Ganze besser zur Größe der Speicherseite („page size“) moderner Prozessoren passt, insgesamt bessere Performance liefert, und generell auch erlaubt mehr Daten bei gleicher Adressierung anzusprechen. Seit ca. 2011 unterstützt so ziemlich jeder Datenträger (ausgenommen microSD-Karten/USB-Sticks und anderes eher Low-Level Flash-Gedöns) dieses Format.

Und wie immer gibt's einen fetten Haken an der Sache: Aufgrund der Abwärtskompatibilität können die meisten (wenn nicht alle) dieser Datenträger auch mit 512 Byte Sektorgröße umgehen, womit auch alle oben genannten Vorteile verschwinden.

Und mein Dateisystem möchte?

Und da wird's jetzt unangenehm. Es ist nämlich so, dass moderne Dateisysteme mit Sektorgrößen von 4K arbeiten, d.h. eine Sektorgröße von 512 Byte auf dem Datenträger, der intern eigentlich auch 4K verwendet, ergibt mal so überhaupt gar keinen Sinn.

Ich hab mal für die IMHO gebräuchlichsten Dateisysteme nachgesehen:

  • btrfs will mindestens 4K
  • ext4 will mindestens 1K (Standard ist trotzdem 4K)
  • f2fs 512 Byte (was insofern Sinn ergibt, weil es eher für Flashspeicher in microSD-Karten und USB-Sticks konzipiert ist)
  • ZFS nutzt mindestens 4K
  • XFS will mindestens 512 Byte, nutzt aber 4K falls möglich
  • NTFS nutzt ab Windows 7 durchgängig mindestens 4K
  • FAT (FAT16/32) nutzt ab 128MB Größe der Partition auch 4K
  • ...und exFAT nutzt ebenfalls Sektorgrößen ab 4K aufwärts

Sektorgrößen auslesen

Mittels parted -l lassen sich Sektorgrößen ausgeben, sieht bei einer SATA-SSD bspw. wie folgt aus:

[root:~] # parted -l
Modell: ATA SK hynix SC311 S (scsi)
Festplatte  /dev/sda:  256GB
Sektorgröße (logisch/physisch): 512B/4096B
Partitionstabelle: gpt
Disk-Flags:
[…]

Bei einer NVMe-SSD sieht's etwas anders aus, diese lassen sich in der Regel intern umformatieren. Heißt: Die Ausgabe von parted -l zeigt bspw. folgendes an:

[root:~] # parted -l
Modell: TOSHIBA-RC100 (nvme)
Festplatte  /dev/nvme0n1:  240GB
Sektorgröße (logisch/physisch): 4096B/4096B
Partitionstabelle: gpt
[…]

In Wahrheit kann das Ding aber viel mehr, je nach Konfiguration. Das bekommt man mittels smartctl -a /dev/ heraus:

[root:~] # smartctl -a /dev/nvme0n1
smartctl 7.2 2020-12-30 r5155 [x86_64-linux-5.15.12-200.fc35.x86_64] (local build)
Copyright (C) 2002-20, Bruce Allen, Christian Franke, www.smartmontools.org

=== START OF INFORMATION SECTION ===
[…]
Namespace 1 Formatted LBA Size:     4096

[…]

Supported LBA Sizes (NSID 0x1)
Id Fmt  Data  Metadt  Rel_Perf
 0 +    4096       0         0
 1 -     512       0         3

[…]

[root:~] # 

Wie man sehen kann, nutzt die NVMe-SSD aktuell eine Sektorgröße von 4K, könnte aber auch 512 Byte. Was man hier nicht sieht: Die 512 Byte waren ursprünglich vorkonfiguriert, aufgrund der AbWäRtSkOmPaTiBiLiTäT, was mal eben die Datenrate von 1,4GB/s auf nicht ganz so schöne 700MB/s halbiert. Kannste dir nicht ausdenken, dass sowas als Standard ausgeliefert wird...

Noch schöner finde ich in der Tabelle hinten den Eintrag Rel_Perf, der gibt nämlich schon an, dass 4K Sektorgröße deutlich schneller sind als 512 Byte Sektorgröße. Warum man dann trotzdem 512 Byte als Standard anbietet, wenn literally jedes Betriebssystem heutzutage mit 4K umgehen kann? Keine Ahnung.

Aber zumindest LUKS nutzt 4K, ja?

Noch lustiger wird's allerdings, weil meine Datenträger alle verschlüsselt sind. Man würde jetzt denken, hey, wenn logisch 512 Byte angegeben sind, und physisch 4K, dann nimmt doch LUKS auf jeden Fall auch 4K Sektorgröße, nicht? Oder noch besser: Standardmäßig einfach immer 4K nehmen, weil insgesamt die bessere Wahl? Vor allem, wenn das Dateisystem, welches sich später innerhalb der LUKS-Partition befindet, mit unglaublich hoher Wahrscheinlichkeit ebenfalls 4K Sektorgrößen verwendet? Denkste.

Aufgrund der oben genannten AbWäRtSkOmPaTiBiLiTäT nutzt LUKS, wenn's die Wahl hat, auch lieber 512 Byte.

Bevor man weitermacht…

Um's nochmal kurz zu umreißen: Wer ein Dateisystem mit 4K Sektorgröße einsetzt, und evtl. auch noch LUKS, auf einer SSD die angibt mit 512 Byte Sektorgröße zu arbeiten, kann durch Umstellung auf 4K etwas mehr Datenrate herausholen.

„etwas mehr“ bedeutet hierbei, soweit ich das ermitteln konnte, zwischen 0 und 100 Prozent. Eine Umstellung bringt im schlechtesten Falle also nichts, im besten Falle verdoppelt sich die Datenrate (wie bei mir geschehen).

Vorher empfiehlt sich wie immer ein Backup zu machen, und natürlich auch zu schauen womit die Hardware und womit die Software wirklich arbeitet (via parted -l, cryptsetup luksDump, und dateisystemspezifischen Tools zum Auslesen der Sektorgröße).

LUKS-Partition auf SATA-SSDs umstellen

Das Gute: LUKS-Partitionen auf SATA-SSDs lassen sich im laufenden Betrieb von 512 Byte auf 4K umstellen. Dazu muss zwar die komplette Partition gelesen und neu verschlüsselt werden, aber LUKS ist in der Hinsicht wirklich durchdacht, denn auch ein Absturz des Rechners richtet hier i.d.R. keinen Schaden an. Man kann den Prozess jederzeit unterbrechen und später fortsetzen.

Zuerst sollte man aber prüfen, ob LUKS nicht doch schon zufälligerweise die richtige Sektorgröße verwendet:

[root:~] # cryptsetup luksDump /dev/sdxY
LUKS header information
Version:       	2
[…]
Data segments:
  0: crypt
	offset: 16777216 [bytes]
	length: (whole device)
	cipher: aes-xts-plain64
	sector: 512 [bytes]
[…]

Wie man sehen kann ist das nicht der Fall. Eine Umstellung kann mittels cryptsetup reencrypt erfolgen:

[root:~] # cryptsetup --type luks2 --sector-size 4096 reencrypt /dev/sdxY

Wichtig: Der Vorgang kann (muss aber nicht) das darin befindliche Dateisystem unbrauchbar machen. Ich hab's bei insgesamt vier Partitionen getestet (mit darin befindlichem btrfs-Dateisystem), und hatte keine Probleme.

NVMe-SSDs neu formatieren auf 4K

Bei NVMe-SSDs sieht die Sache etwas anders aus, hier muss man nämlich erst die interne Sektorgröße umstellen, was bei mir zum Verlust aller Daten geführt hat. Mittels nvme id-ns kann man die unterstützten LBA-Größen auswählen, und dann mittels nvme format die NVMe-SSD entsprechend formatieren:

[root:~] # nvme id-ns /dev/nvme0n1 | grep lbaf
[…]
lbaf  0 : ms:0   lbads:12 rp:0
lbaf  1 : ms:0   lbads:9  rp:0x3 (in use)

[root:~] # nvme format --lbaf 0 /dev/nvme0n1
[…]

[root:~] # nvme id-ns /dev/nvme0n1 | grep lbaf
[…]
lbaf  0 : ms:0   lbads:12 rp:0 (in use)
lbaf  1 : ms:0   lbads:9  rp:0x3

Dann eine neue Partitionstabelle erstellen, eine LUKS-Partition mit Sektorgröße 4K anlegen, und darin dann das gewünschte Dateisystem erstellen. Gut, und Daten zurückspielen, die man vorher natürlich™ gesichert hat.

Wie sieht's bei HDDs aus?

Kann ich ehrlich nicht beantworten. Ich kann mir vorstellen, dass HDDs in der Hinsicht wie SATA-SSDs funktionieren: Intern also 4K verwenden, logisch aber 512 Byte angeben. Tests dazu habe ich aber noch nicht gemacht - ich habe zur Zeit HDDs ausschließlich als Storage im Einsatz, d.h. mit relativ langsamen Datenraten und dafür relativ groß. Diese im laufenden Betrieb neu zu formatieren ist mir dann doch etwas zu heikel - da muss sich erst die Chance ergeben günstig irgendwo eine 4TB-Platte zu erwerben, die ich dann auch gleich meinem RAID hinzufügen kann. Ich kann aber sagen, dass die Ausgabe von parted -l für meine 4TB-Platten 512/4096 ausgibt, und für meine 1TB-Platte aus dem Jahr 2009 512/512 (was logisch ist, da das eingangs erwähnte Advanced Format 2009 noch nicht standardisiert war - hier waren 512 Byte Sektorgrößen noch der Standard).

Fazit

Anregung zu dem Artikel hat übrigens dieser Post auf Reddit gegeben. Ich persönlich ärgere mich ja, dass mir das zum einen nicht früher aufgefallen ist (normalerweise™ teste ich meine Hardware vor Inbetriebnahme, aber bei meinem aktuellen ThinkPad war damals keine Zeit, und dann habe ich einfach alle Defaults übernommen), zum anderen verstehe ich nicht ganz, warum man im Jahr 2022 überhaupt noch Datenträger bekommt die etwas von 512 Byte vorgaukeln. Abgesehen davon hat die Umstellung von 512 Byte auf 4K die Datenrate auf meiner NVMe-SSD verdoppelt.

Nerdige Notiz am Rande: Ich habe selbstverständlich nicht ein extra Backup meiner NVMe-SSD gemacht (generell Backups existieren natürlich schon), diese dann neu formatiert, und alle Daten zurückgespielt. Da ich btrfs verwende habe ich einfach die Daten im laufenden Betrieb auf eine andere SSD geschoben, dann die NVMe-SSD formatiert, und dann wieder zurückgeschoben. Alles im laufenden Betrieb. Zero Downtime 😎

Und die restlichen LUKS-Partitionen auf den SATA-SSDs wurden auch im laufenden Betrieb konvertiert. Alles andere wäre ja langweilig 😉

Im April diesen Jahres ist es wieder soweit. Ubuntu und die offiziellen Derivate veröffentlichen eine neue LTS der beliebten Distribution. Mithin das wichtigste Ereignis im Linux-Kalender. Zeit mal einen kleinen Ausblick zu nehmen.

Das Release der neuen LTS von Ubuntu hat sicherlich die größte Breitenwirkung aller Linux-Distributionen. Die große Mehrheit der Linux-Anwender nutzt Ubuntu, eines der offiziellen Derivate oder eines jener inoffiziellen Derivate wie beispielsweise Linux Mint oder elementary OS. Hier treffen zwei Jahre Entwicklung am Linux-Desktop auf den Anwender und damit die Wirklichkeit.

Noch ist einiges im Fluss, denn der Feature Freeze steht erst am 24. Februar an, aber einige Aussagen lassen sich bereits jetzt treffen. Große Umbrüche sind dieses Jahr nicht zu erwarten, aber einige Änderung an der Oberfläche der jeweiligen Derivate und unter der Haube stehen an.

Die größte und wichtigste Neuerung. Es wird nach Jahren einen neuen Installer geben. Unter der Haube lässt man es hingegen eher bedächtig angehen und wird den Linux Kernel 5.15 nutzen, der bereits jetzt bei vielen Rolling Release-Distributionen zum Einsatz kommt. Allerdings ist das wenig dramatisch, weil Ubuntu traditionell im Laufe des Lebenszyklus der Distribution neuere Kernel-Versionen an die Anwender verteilt.

Das Hauptderviat Ubuntu wird standardmäßig Wayland nutzen und damit die endgültige Abkehr von X.org einleiten. Es dürfte sicherlich spannend werden, ob Wayland wirklich schon reif für den produktiven Einsatz bei Massen von normalen Anwendern ist. Bei der Desktopumgebung fährt man eine Zwischenmethode, die bereits bei früheren Releases zum Einsatz kam. Eine aktuelle GNOME Shell (vermutlich 42) wird mit älteren Apps kombiniert, da Ubuntu noch nicht auf Gtk4-Apps umsteigen möchte. Optisch gestaltet man die Shell weiterhin im Stil von Unity. Anwender müssen sich also nicht umorientieren. Firefox ist standardmäßig als Snap enthalten. In den Paketquellen ist aber immer noch ein normales Firefox-Paket im Bereich main enthalten. Die Anwender haben also die Wahl. Ansonsten gibt es nur wenige Änderungen gegenüber Ubuntu 21.10 – was aber für ein LTS-Release nicht unüblich ist.

Kubuntu aktualisiert wie üblich KDE Frameworks, KDE Plasma und die Programmsammlung KDE Gear. KDE Gear wird vermutlich in der Version 21.12 aus dem vergangenen Dezember ausgeliefert werden. KDE Plasma ist bereits in einer Vorschauversion von 5.24 enthalten. Diese Version wird es somit mit Sicherheit ins Release schaffen. Diese Version könnte möglicherweise wieder eine LTS-Version mit Upstream-Unterstützung werden. Mit Sicherheit ist Kubuntu 22.04 die letzte LTS-Version mit einer Qt 5-Basis. Anwender dürfte dies freuen, da KDE gegen Ende eines Releasezyklus meist die besten Produkte ausliefert, bevor man wieder von vorne anfängt. Kubuntu liefert ebenso Firefox als Snap aus und bleibt bei der Abkehr von KDEPIM zugunsten von Thunderbird.

Ubuntu MATE modernisiert leicht sein Design verglichen mit der Version 20.04. Dabei orientiert man sich am Yaru-Theme des Hauptderivats, das in das charakteristische Grün gefärbt wird. Ubuntu MATE unterscheidet sich hierdurch stark von anderen Distributionen, die MATE ausliefern. Auffällig ist die stärkere Bezugnahme auf GNOME-Programme wie Rhythmbox oder Shotwell. Firefox liegt noch nicht in der Snap-Version bei, aber vermutlich sind die Arbeiten hier nur noch nicht abgeschlossen, da Ubuntu MATE traditionell bereits Snaps ausliefert.

Wenig Neues zu berichten gibt es bei den Derivaten Xubuntu, Lubuntu und Ubuntu Budgie. Das liegt schlicht daran, dass die entsprechenden Desktopumgebungen kaum Veränderungen erfahren haben. Hier integriert man lediglich die neuen Versionen der Desktopumgebungen, welche so aber auch schon in beispielsweise 21.10 enthalten waren. Auffällig ist der vollständige Verzicht auf Snaps bei Xubuntu und Lubuntu. Ubuntu Budgie nutzt gegenwärtig Snaps nur Testweise für den Welcome-Screen.

Insgesamt hat die kommende Version 22.04 das Potenzial wieder ein stabiles und unaufgeregtes LTS-Release zu werden. Bei keinem Derivat sind momentan schwierige Strukturen oder potenziell problematische technische Umbrüche zu erwarten. Allerdings ist bis zum Feature Freeze noch ein wenig Zeit und somit kann das nur als erster Ausblick gewertet werden.

Der Artikel (x)Ubuntu 22.04 (Jammy Jellyfish) im Ausblick erschien zuerst auf [Mer]Curius

Vor ein paar Wochen hatte ich einen langsam steigenden Load auf dem Server entdeckt.

Was auffiel, war ein schlechtes Antwortverhalten verschiedener CMS Systeme.

Scheinbar besonders betroffen waren Sites mit relativ vielen Redirects.

Es hat eine Weile gedauert, bis ich den Übeltäter fand.

Die inotify Log-Datei war riesige 27GB groß!

Da die Partition voll lief, hat mich mein Monitoring freundlich darauf hingewiesen und ein ncdu -x / hat mir den Übeltäter offenbart.

Sobald die Logdatei gelöscht war, lief alles wieder mit voller Geschwindigkeit.  Maldet und inotify war nicht in den Log-Rotationsprozess eingebunden, also habe ich dies getan, um die inotify Logdatei rotieren zu lassen.

Dazu habe ich den  Vorschlag verwendet. War zu faul mir selbst etwas auszudenken :-)

Auch  Load ist wieder Prima.


Vor ein paar Wochen hatte ich einen langsam steigenden Load auf dem Server entdeckt.

Was auffiel, war ein schlechtes Antwortverhalten verschiedener CMS Systeme.

Scheinbar besonders betroffen waren Sites mit relativ vielen Redirects.

Es hat eine Weile gedauert, bis ich den Übeltäter fand.

Die inotify Log-Datei war riesige 27GB groß!

Da die Partition voll lief, hat mich mein Monitoring freundlich darauf hingewiesen und ein ncdu -x / hat mir den Übeltäter offenbart.

Sobald die Logdatei gelöscht war, lief alles wieder mit voller Geschwindigkeit.  Maldet und inotify war nicht in den Log-Rotationsprozess eingebunden, also habe ich dies getan, um die inotify Logdatei rotieren zu lassen.

Dazu habe ich den  Vorschlag verwendet. War zu faul mir selbst etwas auszudenken :-)

Auch  Load ist wieder Prima.


Pi-Hole ist eine nette Software um Tracking und Werbung zu blockieren. Das Prinzip ist einfach. Pi Hole wird als Standard DNS Server im lokalen Netzwerk konfiguriert und liefert für Werbedomains eine unbrauchbare IP. Die Domainlisten werden von freundlichen Internet Personen gepflegt und das System updated diese regelmäßig. Ich habe die Software seit Jahren ohne Probleme auf einem alten RaspberryPi gehostet bis die SD Karte vor 4 Stunden kaputt ging.

Inzwischen können RaspberryPi’s Container ausführen und es gibt Kubernetes Distributionen die wunderbar auf darauf laufen. Ich nutze MicroK8S auf einem einzelnen 4GB Raspberry Pi4.

Eine komplette Anleitung zu schreiben macht wenig Sinn und sprengt jegliche Rahmen, ich möchte Dir grob erklären, wo man die Dokumentationen findet und was ungefähr im Hintergrund passiert. Schreib mir gerne einen Kommentar wenn Du mehr über Kubernetes und Container Images wissen möchtest.

Setup

System + Kubernetes

Installier erst Ubuntu auf dem Raspberry und dann nach dieser Anleitung MicroK8s.

Helm, MetalLB und Pi-Hole

Helm

Helm ist ein Package Manager für Kubernetes. Er besteht nur aus einem Binary, welches sich gegen einen Cluster verbindet und dort Konfigurationsdateien ablegt. Kubernetes erzeugt aus diesen Konfigurationen Ressourcen in denen am Ende die Container und damit Anwendungen laufen. Helm zieht diese Konfigurationen (Helm Charts) aus Repos im Internet. Helm managed Installation, Updates und Deinstallationen über Annotationen in Kubernetes Resourcen:

kubectl get deployments.apps -n pihole -oyaml |head
apiVersion: v1
items:
- apiVersion: apps/v1
  kind: Deployment
  metadata:
    annotations:
      deployment.kubernetes.io/revision: "4"
      meta.helm.sh/release-name: pihole
      meta.helm.sh/release-namespace: pihole
    creationTimestamp: "2022-01-15T17:51:07Z"

Wenn Du direkt auf dem Pi arbeitest kannst Du das Binary via Snap installieren. Doku

MetalLB

MetalLB ist ein LoadBalancer für Kubernetes. Ich nutze den OSI Layer 2 Mode um IPs im lokalen Netzwerk zu erzeugen auf denen die Kubernetes Services dann verfügbar sind.

Installation

# actually apply the changes, returns nonzero returncode on errors only
kubectl get configmap kube-proxy -n kube-system -o yaml | \
sed -e "s/strictARP: false/strictARP: true/" | \
kubectl apply -f - -n kube-system

kubectl apply -f https://raw.githubusercontent.com/metallb/metallb/v0.10.3/manifests/namespace.yaml
kubectl apply -f https://raw.githubusercontent.com/metallb/metallb/v0.10.3/manifests/metallb.yaml

Konfiguration

Hier müßt Ihr selbst Hand anlegen. Mein Netz zu Hause hat die Range 192.168.178/24 und MetalLB soll in der Range 1192.168.178.240-192.168.178.250 erzeugen.

192.168.178.240-192.168.178.250

cat <<EOF | kubectl apply -f -
apiVersion: v1
kind: ConfigMap
metadata:
  namespace: metallb-system
  name: config
data:
  config: |
    address-pools:
    - name: default
      protocol: layer2
      addresses:
      - 192.168.178.240-192.168.178.250
EOF

Pi Hole

Ich nutze das Helm Chart von mojo2600.

Diese 3 Befehle reichen auführen:

cat <<EOT >> pihole-values.yaml 
serviceWeb:
	type: LoadBalancer
serviceDns:
	type: LoadBalancer
EOT

helm repo add mojo2600 https://mojo2600.github.io/pihole-kubernetes/

helm upgrade --install pihole  mojo2600/pihole -n pihole -f pihole-values.yaml 

Was passiert hier?

  1. Wir fügen analog zu apt-add-repository für APT einen neuen Kanal für Software hinzu.
  2. Wir legen eine Konfigurationsdatei an welche die Default Values für ServiceWeb & ServiceDns des Charts überschreibt.
  3. Wir installieren mojo2600/pihole in den Namespace (-n) pihole und nennen die Installation auch PißHole und referenzieren die erzeugte Values Datei.

Wir können die Installation überprüfen indem wir schauen ob der Container läuft und was es so an Logs gibt:

kubectl get pods -n pihole
NAME                      READY   STATUS    RESTARTS   AGE
pihole-545cb64d94-zsgxn   1/1     Running   0          4h17m
kubectl logs -n pihole pihole-545cb64d94-zsgxn  |head
[s6-init] making user provided files available at /var/run/s6/etc...exited 0.
[s6-init] ensuring user provided files have correct perms...exited 0.
[fix-attrs.d] applying ownership & permissions fixes...
[fix-attrs.d] 01-resolver-resolv: applying... 
[fix-attrs.d] 01-resolver-resolv: exited 0.
[fix-attrs.d] done.
[cont-init.d] executing container initialization scripts...
[cont-init.d] 20-start.sh: executing... 
 ::: Starting docker specific checks & setup for docker pihole/pihole

sieht gut aus. Nun brauchen wir noch die IP des Pi Hole DNS Service um unseren Router zu konfigurieren:

kubectl get service -n pihole
NAME             TYPE           CLUSTER-IP       EXTERNAL-IP       PORT(S)                      AGE
pihole-dhcp      NodePort       10.105.187.249   <none>            67:30482/UDP                 4h54m
pihole-dns-tcp   LoadBalancer   10.105.227.20    192.168.178.243   53:31115/TCP                 4h54m
pihole-dns-udp   LoadBalancer   10.103.205.155   192.168.178.244   53:31516/UDP                 4h54m
pihole-web       LoadBalancer   10.106.223.39    192.168.178.245   80:30713/TCP,443:32113/TCP   4h54m

In meinem Fall muß ich den DNS im Router auf die 192.168.178.244 konfigurieren – DNS läuft Traditionell auf Port 53 und ich mag UDP.

Router Setup

Das ist der Punkt an dem Ihr euch selbst schlau machen müßt. Für AVM Geräte ist hier eine nette Anleitung https://docs.pi-hole.net/routers/fritzbox-de/

Warum der ganze Overhead? Das hätte ich auch schnell mit dem SH Installer machen können!

Guter Punkt. So habe ich meine letzte Installation von Pi-hole vor ein paar Jahren auch gemacht und man spart sich die Installation von viel Software. Die Vorteile merkt man wenn auf dem Kubernetes Cluster weitere Software läuft. Upgrades sind standardisiert ( helm upgrade –install) und wenn man GitOps mit z.B. ArgoCD macht hat man direkt ein Backup aller Softwareinstallationen und Konfigurationen in einem Git Repository. Ich muß mir nicht merken wie der Upgrade Prozess für Software XY läuft sondern aktualisiere Charts oder ändere das Tag eines Images – ich verwende gerne die Metapher „Leg einfach die Floppydisk mit der neuesten Version ein. Wenn Dein Kubernetes Cluster aus mehreren Rechnern besteht läuft Pi-hole auch noch wenn einer ausfällt – Kubernetes sorgt automatisch dafür, dass die Container umgezogen werden und wenn Du einen Monitoring / Alerting Stack installiert hast bekommst Du eine nette Nachricht. Natürlich verbraucht der Kubernetes Stack mehr Ressourcen als eine triviale Pi-hole Installation aber mittel- langfristig überwiegen meiner Meinung nach die Vorteile.

Der Beitrag Pi Hole auf dem Raspberry Pi + Kubernetes Hosten erschien zuerst auf Unerklärliches am Rande.

15. Januar 2022

Das Kool Desktop Environment war mal gestartet als Versuch „den“ Linux-Desktop zu erschaffen. Nach Jahren des schleichenden Niedergangs kann man sich nun hinter GNOME in der zweiten Reihe neben Xfce, MATE und anderen einreihen.

KDE konnte letztes Jahr sein 25-jähriges Jubiläum feiern und sieht sich natürlich selbst auf der Erfolgsspur. Das kann man auch anders sehen und wo, wenn nicht in diesem Blog, wo bekanntermaßen immer alles schlecht gemacht wird – vor allem Linux und hier insbesondere KDE und Debian – sollte man so eine Geschichte schreiben.

Bei der Recherche bin ich auf die Meldung zum 10-Jährigen Jubiläum von KDE gestoßen. Das deckt sich fast mit meinem persönlichen Linux-Einstieg, deshalb lassen wir diese Geschichte 2006 beginnen.

Wir schreiben das Jahr 2006. Smartphones brauchen noch ein paar Jahre und Microsoft hat gerade mit Windows Vista ein richtiges Fiasko erlebt. Im Linux-Land wittert man Morgenluft und tatsächlich wechseln merkbar enttäuschte Windows-Nutzer ins Linux-Lager. Passenderweise hatte sich kurz zuvor ein ambitionierter Unternehmer namens Mark Shuttleworth aufgemacht, eine Linux-Distribution zu erschaffen, die für normale Anwender benutzbar sein soll. Leider mit GNOME und hier gehts los.

Im Jahr 2006 gibt es im wesentlichen drei Linux-Desktops. KDE, GNOME und für Anwender mit geringeren Ressourcen und Anforderungen Xfce. Dazu natürlich noch eine Menge Windowmanager und andere Lösungen, aber die machen zusammen nicht nennenswert Marktanteile aus. GNOME und KDE haben sich bereits in den 1990ern parallel entwickelt, weil Qt nicht frei war und Alternativen schön sind. Mal so ganz stark verkürzt ausgedrückt.

2006 ist die Sache aber nicht entschieden. Die berühmten Desktopwars bestimmen die Diskussion und KDE und GNOME dürften in etwa gleich viele Nutzer auf sich vereinen. Es gibt regionale Schwerpunkte, auch abhängig von regionalen Schwerpunkten entsprechender Distributionen. KDE ist auf dem Höhepunkt des Entwicklungszweiges der Version 3.5. Bis heute eine der Versionen, an die sich viele Anwender gerne zurückerinnern. KDE ist so wichtig, dass Canonical nicht umhinkommt mit Version 6.06 KDE bzw. Kubuntu den gleichen Status wie dem Hauptderivat Ubuntu zuzusprechen und mit Jonathan Riddell einen Entwickler dafür hauptamtlich anzustellen.

Danach beginnt der Niedergang. Im Jahr 2008 veröffentlicht KDE die Version 4. Ein Debakel sondergleichen in der öffentlichen Wahrnehmung. Obwohl nur als Vorschauversion gedacht, kommuniziert man derart schlecht, dass der Ruf nachhaltig leidet. Denn die Software ist funktional nicht ausgereift und strotzt nur so vor Fehlern. Wohlmeinende Anwender bleiben bei 3.5, andere wenden sich enttäuscht ab.

Ewig können die Distributoren aber nicht an KDE 3.5 festhalten. In den Folgejahren stellen nach und nach die Distributionen um. Der Support von Kubuntu 8.04 endet beispielsweise bereits im Oktober 2009, weil Kubuntu angesichts der Entwicklung auf LTS-Support verzichten musste – gewissermaßen das erste KDE-Opfer, bei dem man hinter der offiziellen Hauptvariante zurückstecken musste. Nahezu zeitgleich erscheint openSUSE 11.2 ohne KDE 3.5. Die Nutze können nun nur noch migrieren, aber KDE SC 4 ist zu diesem Zeitpunkt immer noch von Alltagstauglichkeit weit entfernt. Entsprechend verschieben sich die Nutzerzahlen bei den Anwender und Distributionen.

Weil KDE es nicht hinbekommt, die Destopumgebung und die zugehörigen Programme ausreichend zu stabilisieren und die Nachfrage sinkt, ziehen die Distributoren Konsequenzen. War KDE bei SUSE Linux Enterprise bereits im Jahr 2009 mit Version 11 optional geworden, fliegt es in Version 12 im Jahr 2014 komplett aus der Distribution. 2012 degradiert Canonical Kubuntu zu einem normalen Derivat, in der Folge verlässt Jonathan Riddel Canonical. Mandriva und seine diversen Nachfolgelösungen als KDE-Hochburg gerät ebenso in Schwierigkeiten und verliert nachhaltig an Bedeutung. Zuletzt gab im Jahr 2018 Red Hat bekannt, dass KDE nicht mehr in der Enterprise-Distribution RHEL enthalten sein würde. Linux-Desktops im professionellen bzw. Enteprise-Umfeld sind nun durchweg GNOME-Desktops. Wer hätte das 2006 gedacht.

Die KDE-Entwickler sehen diese katastrophale Entwicklung. Man startet man eine beispiellose Kampagne, um die letzte Hochburg von KDE als Standarddesktop zu bewahren: openSUSE. Es gelingt KDE als Standarddesktop durchzudrücken. Ein kurzer Erfolg, denn nach einigen Umstrukturierungen hat openSUSE von vielen unbemerkt wieder den Verzicht auf einen Standarddesktop beschlossen.

Im Zuge der Querelen zwischen Kubuntu und Canonical kommt man 2016 auf die Idee, mit KDE neon eine eigene Distribution zu erschaffen. Die letzten verblieben Distributoren mit KDE-Schwerpunkt sind nachhaltig irritiert durch diese Aktion. Ein großer Erfolg wird KDE neon nicht, sondern dient eher als Anschauungsbeispiel für die aktuelle KDE-Version.

2022 gibt es keine verbreitete Distribution mit KDE als Standarddesktop. Wichtige Linux-Distributionen wie Debian, Ubuntu oder Fedora setzen standardmäßig auf GNOME oder haben von GNOME abgeleitete Alternativen entwickelt, wie z. B. Mint oder Pop OS!. KDE-Software spielt vor allem bei Rolling Release Distributionen noch eine nennenswerte Rolle und erfreut sich bei Arch Linux und Manjaro einiger Beliebtheit. Zudem kann es natürlich optional bei vielen Distributionen genutzt werden. Hiermit steht es aber auf einer ähnlichen Stufe wie die Xfce, MATE, LXQt und andere kleinere Lösungen.

Für einen solchen Niedergang gibt es keine einfachen Erklärungen. Dahinter stehen sicherlich auch Entwicklungen außerhalb der Reichweite der KDE-Entwickler und Verschiebungen im Distributonssegment. Aber einige Punkte kann man dennoch feststellen:

  • Schlechte Kommunikation der Entwicklung in Richtung der Distributionen und Anwender.
  • Auf Kritik reagierten die KDE-Entwickler mit einer Wagenburg-Mentalität.
  • Aus der Wagenburg-Mentalität folgte das konsequente Ignorieren der Bedarfe von stabilen Distributionen und vor allem der LTS-Distributionen, die von der Masse der Anwender genutzt werden. Das hat zu einer nachhaltigen Entfremdung zwischen Distributionen und KDE geführt.
  • Aus der Wagenburg-Mentalität folgte das konsequente Ignorieren der Anwenderbedarfe nach einer halbwegs stabilen, logisch zu bedienenden Desktopumgebung. Das hat nachhaltig Anwender vertrieben. Wir erinnern uns an fehlende Icons auf dem Desktop, eine Erdnuss in der Desktopecke, ein bis heute wackeliges KDEPIM. Irgendwann sind die KDE-Entwickler meist eingeknickt, nachdem der Kollateralschaden bereits gewaltig war. KDE ist immer noch damit beschäftigt Anwender zurück zu gewinnen, die man nach 2008 verloren hat.
  • Die KDE-Entwickler haben sehr oft lieber tolle Konzepte entwickelt als an Funktionen für die Anwender gedacht. Wir erinnern uns an aRts, Phonon, Nepomuk, Sonnet, Akonadi, KDE Frameworks.
  • Zig Umbennenung von KDE zu KDE SC zu KDE Plasma, von KDE zu KDE Applications zu nichts und zurück zu KDE Gear waren sicherlich nicht hilfreich für das Marketing.

Im Grunde genommen ist das schade, weil KDE Plasma gegenwärtig eine sehr stabil und funktional gut zu benutzende Desktopumgebung ist. Viele der Programme aus dem KDE-Umfeld sind funktional allen anderen Alternativen im Linux-Bereich überlegen. Sofern man von einer manchmal irrlichternden VDG und ihren Missetaten absieht, liefert KDE heute eine tolle Desktopumgebung aus und diese wird natürlich weiter eine Zukunft haben.

Aber Entwicklungen lassen sich nicht umkehren und KDE wird nicht mehr die Bedeutung von 2006 erreichen. Als man sich am Ende des 4er-Releasezyklus hinsichtlich Funktionen und Qualität gefangen hatte, waren die Distributoren als wichtige Mittler zwischen Upstream und den Nutzern bereits umgeschwenkt oder die Anwender hatten sich andere Distributionen gesucht. Einmal verlorene Marktanteile zurückzugewinnen, ist ein sehr hartes Unterfangen. Zu viele im Open Source-Segment unterschätzen dies.

Zu viele Fehler, zu viele schlechte Entscheidungen und ein auf GNOME ausgerichtetes Gesamtökosystem haben sich zementiert. KDE wird es weiter geben, das Projekt liefert gute Software. In einem Atemzug mit GNOME muss man es aber vermutlich nicht mehr nennen.

Der Artikel KDE – Eine kleine Niedergangsgeschichte erschien zuerst auf [Mer]Curius

14. Januar 2022

Mozilla hat mit Firefox 96.0.1 ein Update außer der Reihe für seinen Desktop-Browser veröffentlicht.

Download Mozilla Firefox 96.0.1

Am gestrigen Morgen kam es zu einem zeitweisen Ausfall von Firefox für zahlreiche Nutzer. Grund hierfür war ein bereits länger existierender, aber bislang nicht bekannter Fehler in der HTTP/3-Implementierung von Firefox, der durch eine Konfigurationsänderung eines externen Hosting-Dienstleisters ausgelöst worden war. Da Mozilla diesen Dienstleister für das Load Balancing einer seiner Dienste nutzt, konnte das Problem bei potentiell jedem Nutzer auftreten, sobald Firefox eine Verbindung zu diesem hergestellt hat. Aber auch der Aufruf einer entsprechenden Website konnte das Problem auslösen, in dessen Folge Firefox in eine Endlosschleife geriet und nicht länger in der Lage war, Website-Anfragen zu beantworten.

Die Konfigurationsänderung des externen Dienstleisters wurde ca. eine Stunde nach der ersten Meldung bei Mozilla rückgängig gemacht, denn gestern um ca. 10.20 Uhr war das Problem genauso plötzlich wieder verschwunden, wie es gekommen war. Spätestens nach einem Neustart von Firefox funktionierte Mozillas Browser wieder für betroffene Nutzer.

Mit Firefox 96.0.1 hat Mozilla den Fehler im Firefox-Code behoben, der dieses Problem verursachte. An einer weiteren Verbesserung, damit Firefox selbst bei einem solchen Fehler nicht erneut in eine Endlosschleife gerät, arbeitet Mozilla bereits für ein kommendes Update.

Außerdem hat Mozilla mit Firefox 96.0.1 das Problem behoben, dass der Browser unter Windows bei Verwendung der Option, die Proxy-Einstellungen des Systems zu verwenden, die Ausnahmen nicht mehr berücksichtigte.

Der Beitrag Mozilla veröffentlicht Firefox 96.0.1 erschien zuerst auf soeren-hentzschel.at.

Debian verliert einen wichtigen Leistungsträger und ist daran nicht unschuldig. KDE-Nutzer sollten zur Kenntnis nehmen, dass sich Norbert Preining zurückzieht.

Debian hat Probleme. Nicht nur die Sicherheit, nicht nur in den verknöchterten Strukturen, es knirscht an vielen Stellen. Seit Jahren treten jedes Jahr Projektleiter an mit großen Agenden und nichts passiert. Die Strukturen, die das Projekt stabilisieren sollten, scheinen jede Bewegung zu verhindern, oft dienen sie nur noch der Blockade durch Minderheiten, die irgendetwas aufhalten wollen und dann in mühsamen Prozessen überstimmt werden müssen.

Norbert Preining ist seit einiger Zeit die Säule der Paketierung von KDE in Debian. Ohne ihn hätte man die aktuelle Stable-Version nicht mit halbwegs aktuellen KDE-Paketen ausgeliefert worden. Nun hat Norbert Preining seinen Rückzug angekündigt. Zwischen ihm und dem Debian-Projekt bzw. Menschen im Debian-Projekt knirscht es ja seit Längerem, deshalb musste er auch bereits in der Vergangenheit viel seiner Arbeit in OBS auslagern.

Der Verlust für Debian ist gewaltig. Die Liste der Pakete und die sachliche Analyse von Norbert Preining machen das deutlich. Einiges hat sicher eine Zukunft, aber vor allem für alles, was mit KDE zu tun hat und für Cinnamon in Debian sieht es nun düster aus. Norbert Preining legt zudem den Finger in eine Wunde, die viele ignorieren. Die vielen „Gruppen“ bei der Paketbetreuung sind oft nur eine Illusion und letztlich steht dahinter oft nur ein aktiver Betreuer – wie bei vielen „Teamarbeiten“ eben sonst auch.

Die Geschichte erinnert mich an Michael Stapelberg und seinen Rückzug aus Debian 2019. Dieser ist übrigens genau wie Norbert Preining zu Arch Linux gewechselt, aber das nur am Rande.

Debian brüstet sich immer mit seinen vielen Maintainern und Entwicklern, aber die Zahl der Leistungsträger im Desktop-Bereich ist überschaubar und große Weggänge gehen unweigerlich zulasten der Aktualität und Qualität. Darunter leiden übrigens auch abgeleitete Distributionen, wenn sie die Pakete nur übernehmen und die betroffenen Bereiche nicht selbst paketieren. Das Problem reicht deshalb über Debian hinaus.

Debian hat ein Problem, auch wenn nun wieder alle Debian-Nutzer standhaft leugnen und böse Kommentare im Stil von „Ach, der Gerrit mag Debian nicht“ schreiben werden. Vor allem Anwender von KDE Plasma und Cinnamon sollten die Entwicklung von Debian Testing im Auge behalten und sich mental darauf vorbereiten, beim nächsten Stable-Release eine neue Heimat zu suchen und bis dahin hoffen, dass nichts sicherheitsrelevantes für die Versionen in Stable passiert. Denn mir ist nicht klar, wer dort nun noch verantwortlich zeichnet.

Nachtrag 14.01.2022:

Nun hat auch Ferdinand bei Linuxnews berichtet, der ja ein guter Kenner der Debian-Gemeinschaft ist. Dort finden sich auch die Informationen zum Ablauf der Degradierung vor einiger Zeit und was für Mechanismen bei Debian hinter den Kulissen laufen.

Der Artikel KDE-Nutzer bei Debian aufgepasst! erschien zuerst auf [Mer]Curius

13. Januar 2022

Do, 13. Januar 2022, Lioh Möller

Das Ubuntu Projekt hat seine Pläne bezüglich des GNOME-Desktops für die kommende LTS-Version 22.04 konkretisiert.

Laut Aussagen von Sebastien Bacher wird aktuell an der Implementierung von GNOME 41 gearbeitet, das Ziel ist es aber für die nächste LTS Version GNOME 42 anbieten zu können.

Auf der Applikationsseite wird zunächst auf einen Wechsel auf GTK4 verzichtet.

Da im GNOME Projekt bereits ein Wechsel auf libadwaita stattfindet, arbeitet Ubuntu eng mit den Upstream-Entwicklern zusammen, um auch zukünftig eine Anpassung des Erscheinungsbildes gewährleisten zu können.

Ein Wechsel auf GTK4 soll nach dem Erscheinen von Ubuntu LTS 22.04 stattfinden.

Quelle: https://discourse.ubuntu.com/t/ubuntu-desktop-gnome-plans-for-the-incoming-lts/26156

Do, 13. Januar 2022, Lioh Möller 

Patrick Volkerding hat im Changelog des Entwicklerzweiges der Slackware-Distribution die Verfügbarkeit des dritten und letzten Veröffentlichungskandidaten der kommenden Version 15.0 angekündigt.

Wed Jan 12 22:04:33 UTC 2022
Good hello, and welcome to the third and final release candidate for Slackware 15.0. We're 99% frozen at this point and are mostly looking for regression or other bug reports that might be able to be addressed before this goes stable.

Of course, the management here reserves the right to make exceptions... that 5.15.15 kernel version has a nice ring to it. If your requests didn't make it into this iteration, perhaps we will revisit them for the next -current cycle. Some were just a little too late but will more than likely be needed next time (I'm looking at Didier's grubconfig), while others are just out of scope for the main tree where I like to abide by YAGNI as much as possible.

Anyway, let's get some testing done and we'll be there soon. Enjoy! :-)

Demnach wurde der Entwicklungsstand bereits zu 99% eingefroren und es werden aktuell keine neuen Funktionen mehr aufgenommen. Slackware folgt dabei den YAGNI Prinzipien, welche besagen, dass neue Features erst implementiert werden sollten, wenn diese wirklich benötigt werden.

Quelle: http://www.slackware.com/changelog/current.php?cpu=x86_64

12. Januar 2022

Die MZLA Technologies Corporation hat mit Thunderbird 91.5 ein planmäßige Update für seinen Open Source E-Mail-Client veröffentlicht.

Neuerungen von Thunderbird 91.5

Mit dem Update auf Thunderbird 91.5 hat die MZLA Technologies Corporation ein planmäßiges Update für seinen Open Source E-Mail-Client veröffentlicht und behebt damit aktuelle Sicherheitslücken. Darüber hinaus bringt das Update diverse Fehlerbehebungen der Versionsreihe 91, welche sich in den Release Notes (engl.) nachlesen lassen.

Der Beitrag Thunderbird 91.5 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

Manjaro ist im Rolling Release-Segment vielleicht das, was bei den stabilen Distributionen Linux Mint ist. Der Anspruch ist eine einfach zu verwendende, nutzerfreundlichen Distribution, selbst wenn es mal ideologisch oder konzeptionell nicht ganz sauber ist. Höchste Zeit für einen Test.

Einordnung

Manjaro ist eine sehr beliebte Distribution. Seit sie vor knapp 10 Jahren aus der Taufe gehoben wurde, hat sie immer mehr Anhänger gewonnen und es sieht nicht so aus, als ob sich das schnell ändern wird. Denn diese Beliebtheit hat Gründe, wie sich zeigen wird.

Manjaro ist ein Abkömmling von Arch Linux. Im Grunde genommen nehmen die Manjaro-Entwickler die Arch-Paketquellen und fügen einige eigene Pakete und Metapakete hinzu. Hinzu kommt eine Installationsroutine und eigene Live-Medien. Das Ganze wird dann ein wenig entschleunigt, denn während bei Arch mitunter mehrmals täglich Updates kommen, verfolgt Manjaro – ähnliche wie beispielsweise openSUSE Tumbleweed – ein Snapshot-Modell, bei dem Updates immer in einem größeren Schwung alle paar Tage/Wochen an den Anwender weiter gegeben werden. Idealerweise dann schon ein bisschen besser getestet als bei Arch, wo – wenn auch selten – mal ein kleiner oder größerer Fehler bei den hochfrequenten Updates erfolgen kann.

Arch-Nutzer sagen gerne, dass niemand Manjaro bräuchte, weil man alles mit Arch selbst erledigen könnte. So wie auch Ubuntu-Anhänger behaupten, niemand bräuchte Linux Mint und Debian-Anhänger finden gerne, dass sowieso alle Derivate von Debian überflüssig seien. Das ist eine ewige Diskussion. Letztlich finden die Distributionen Anhänger und das hat Gründe.

Manjaro mit KDE Plasma im Test

Varianten und Installationsmedien

Die Manjaro-Entwickler unterstützen offiziell die drei Desktopumgebungen Xfce, KDE Plasma und GNOME. Hinzu kommt Community-Support von Budgie bis Sway. Leider ist die Pantheon Shell nicht dabei, obwohl sie mittlerweile in Arch Linux angekommen ist. Für den Test entschied ich mich deshalb für KDE Plasma.

Es gibt Live-/Installationsmedien für alle Desktopumgebungen. Jeweils aufgeteilt in eine vollständige und eine minimale Variante. Hierbei ist zu beachten, dass die minimale Variante keineswegs so minimal ist. Wer sich ein bisschen mit Linux auskennt und seine Programme überwiegend selbst zusammen stellen möchte, der sollte sich für die minimale Variante entscheiden.

Installation

Manjaro beherrscht kein Secure Boot. Das ist bedauerlich und verglichen mit anderen Distributionen schade. Es ist aber auch nicht überraschend, da Arch Linux dieses ebenso nicht unterstützt. Daher muss man – so noch nicht geschehen – in den UEFI-Einstellungen vor der Installation Secure Boot abschalten.

Anschließend bootet das Live-Medium. Hier kann man wie üblich erst die Distribution testen oder gleich installieren. Als Installationsroutine verwendet Manjaro Calamares. Dabei handelt es sich um eine distributionsübergreifend verfügbare Installationsroutine, die sich zunehmender Beliebtheit erfreut.

Ich finde Calamares etwas sparsam bei den Funktionen, aber man bekommt damit die Installation hin. Seit meinem letzten Test von Calamares bei KDE neon hat man die Verschlüsselung offenkundig verbessert, womit mein schlimmster Kritikpunkt ausgeräumt ist.

Bei der Installation wähle ich mein persönlich präferiertes Setup mit einer unverschlüsselten Boot-Partition und einer verschlüsselten Btrfs-Partition ohne weitere Trennung in Root und Home. Die unverschlüsselte Boot-Partition nutze ich, da bei einer verschlüsselten Boot-Partition die Entsperrung von GRUB bei meinen Notebooks sehr lange dauert und der Sicherheitsgewinn den Komfortverlust nicht ausgleicht.

Manjaro verlangt bei der Installation neben der obligatorischen Anlage eines Benutzers auch die Vergabe eines root-Kennworts. Damit sträubt man sich gegen den Trend. Nachdem Ubuntu lange Jahre mit seinem sudo-Konzept allein auf weiter Flur stand, haben sich zuletzt Debian und Fedora dem angeschlossen und bieten ebenfalls die Möglichkeit den root-Account zu deaktivieren.

Die Installation ist dann schnell erledigt.

Erster Eindruck

Nach einem Neustart begrüßt den Anwender KDE-Plasma in einem angepassten Design Namens „Breath“.

Die Entwickler der Desktopumgebungen hassen das ja bekanntermaßen und GNOME bekämpft dies inzwischen aktiv, aber ich mag das gerne. Ich finde es schön, wenn Distributionen versuchen, ein gemeinsames Corporate Design über alle Desktopumgebungen zu legen und den Anwendern vermitteln „Du benutzt nicht irgendeine Distribution mit KDE Plasma, sondern Manjaro“. Wenn es einem nicht gefällt, kann man es ja ändern.

Die Softwareauswahl ist dann gar nicht so minimal und leider auch etwas inkonsistent. Neben Plasma und den wichtigsten KDE-Tools ist auch Firefox dabei. Warum ich aber Okular und Evince vorinstalliert brauche, erschließt sich mir nicht. Ebenso ist unter der Haube einiges an Gerümpel. Dazu zähle ich die vorinstallierte Multilib-Umgebung (Lib32-Bibliotheken), die auf dem System gar nicht benötigt werden und einiges weiteres.

Bei der Gelegenheit fragte ich mich mal wieder, warum Arch eigentlich als schlankes System gilt. Natürlich hat ein Setup mit meiner gewohnten KDE-Umgebung bei Arch bzw. Manjaro nur knapp 1000 Pakete, während es bei openSUSE oder debianoiden Systemen eher >2000 sind. Das liegt aber nicht daran, dass openSUSE oder Debian „fetter“ wären, sondern daran, dass die Arch-Paketierung ziemlich grobschlächtig ist. So enthält z.B. das Paket firewalld auch gleich die GTK-GUI zur Konfiguration oder pinentry alle Oberflächen, was bei openSUSE und Debian in eigene Pakete ausgelagert ist. Arch ist also sogar ganz im Gegenteil eher ziemlich fett. Dafür kann aber natürlich Manjaro nichts und ist letztlich auch eine Frage der Gewohnheit.

Nichtsdestoweniger sollten Anwender nach der Installation erst einmal aufräumen, unnützes entfernen und vielleicht auch manches nachinstallieren. So setzt Manjaro nach der Installation immer noch auf X.org und der Anwender muss die Wayland-Session erst nachinstallieren und aktivieren. Am Ende hat man dann aber eine konsistente Arbeitsumgebung, auf der sich weiter aufbauen lässt.

Manjaro macht vieles anders

Manjaro macht vieles anderes. Das reicht von Kleinigkeiten bis zu einem Rollback-System für das Betriebssystem. Beginnen wir mit den Kleinigkeiten. Der Screenshot zeigt es schon: Manjaro verwendet standardmäßig nicht die Bash, sondern zsh mit einem hübschen, aber durchaus eigenwilligen Design.

Ebenso eigene Wege geht man bei den verfügbaren Programmen. In den Paketquellen findet sich auch so etwas wie SoftMaker Office oder Vivaldi. Hier steht Pragmatismus und gute Angebote für die Anwender über ideologischen Abwägungen.

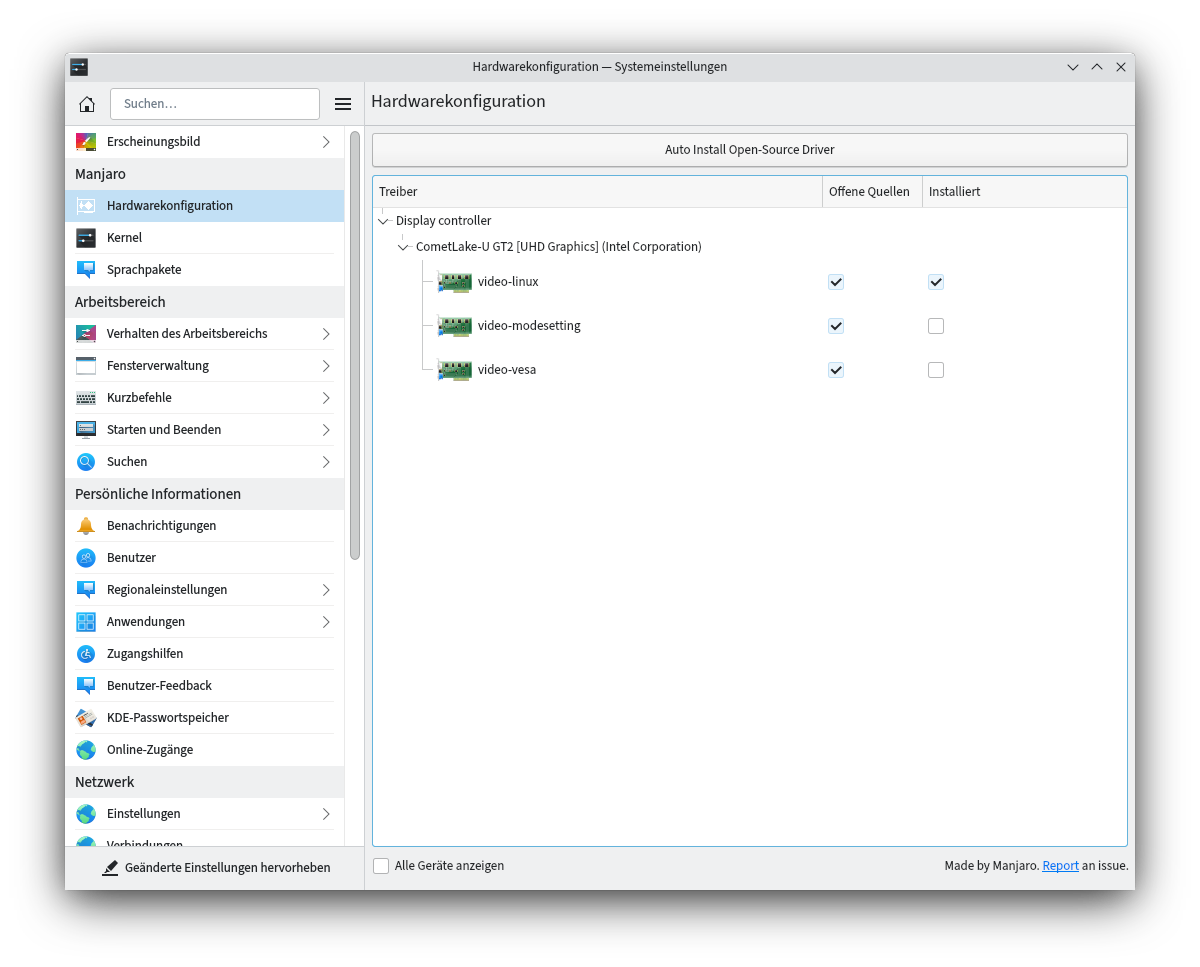
Natürlich kann man Manjaro ebenso wie Arch komplett auf der Kommandozeile administrieren. Im Unterschied zu Arch bietet man den Anwendern aber grafische Konfigurationswerkzeuge. Diese integrieren sich bei KDE durchaus ansehnlich in die Systemeinstellungen als sogenannte KCM. Dazu gehört die Hardwarekonfiguration, die grafische Installation von verschiedenen Kerneln und die Verwaltung von Sprachpaketen.

Zusätzlich kann man noch nette grafische Paketmanager wie Octopi einsetzen, das im Gegensatz zum vorinstallierten Pamac eine Qt-Oberfläche hat und sich gut in KDE Plasma integriert. Mit ein wenig Nacharbeit entsteht so ein konsistenter Desktop mit guten grafischen Verwaltungstools.

Wirklich besonders ist an Manjaro aber der konsequente Einsatz von Timeshift. Das Ganze funktioniert Out-of-the-Box mit bei einem Brtrfs-Dateisystem-Layout. Das legt die Manjaro Installationsroutine gleich mit einem passenden Subvolume-Schema an:

# /etc/fstab: static file system information.
#
# Use 'blkid' to print the universally unique identifier for a device; this may
# be used with UUID= as a more robust way to name devices that works even if
# disks are added and removed. See fstab(5).
#
# <file system>             <mount point>  <type>  <options>  <dump>  <pass>
UUID=1F65-2EB8                            /boot/efi      vfat    umask=0077 0 2
UUID=2da043ef-a76c-4a18-8e2e-27969be465f4 /boot          xfs     defaults,noatime 0 2
/dev/mapper/luks-305fb0b6-ced0-403a-978c-1831b5d32f7e /              btrfs   subvol=/@,defaults,noatime,autodefrag,compress=zstd 0 0
/dev/mapper/luks-305fb0b6-ced0-403a-978c-1831b5d32f7e /home          btrfs   subvol=/@home,defaults,noatime,autodefrag,compress=zstd 0 0
/dev/mapper/luks-305fb0b6-ced0-403a-978c-1831b5d32f7e /var/cache     btrfs   subvol=/@cache,defaults,noatime,autodefrag,compress=zstd 0 0
/dev/mapper/luks-305fb0b6-ced0-403a-978c-1831b5d32f7e /var/log       btrfs   subvol=/@log,defaults,noatime,autodefrag,compress=zstd 0 0

Timeshift legt nun vollautomatisiert regelmäßige Schnappschüsse des Systems an. Das Home-Subvolume wird dabei ausgeklammert, kann aber optional ebenfalls einbezogen werden. Dabei nutzt Timeshift die in Btrfs integrierte Schnappschussfunktion.

Geht mal etwas schief, kann man in GRUB einfach einen älteren Schnappschuss booten. Das klappt auch bei einer verschlüsselten System-Partition mit unverschlüsselter Boot-Partition. Hier ist man sogar openSUSE voraus, wo das dort zum Einsatz kommende Snapper mit diesem Setup nicht zurechtkommt.

Probleme und Kritik

Vor allem im Bereich der Sicherheit gibt es einige problematische Bereiche. Das erste sind die Verzögerungen bei den Updates. Hier müsste man schauen, ob sicherheitsrelevante Aktualisierungen schneller durch gereicht werden als normale Updates, bei denen es letztlich egal ist, ob sie eine Woche früher oder später kommen.

Deutlich negativer fällt da das Fehlen vieler Sicherheitsmaßnahmen auf (die Spannbreite dessen habe ich hier mal dargestellt), die anderswo bereits Standard sind. Nicht nur verzichtet man auf eine vorinstallierte Firewall wie z. B. firewalld oder ufw (beides kann man natürlich nachinstallieren). Man installiert noch nicht mal konsequent ein Sicherheitsframework wie AppArmor. Dies wird nur bei der vollständigen und nicht bei der minimalen Installation eingerichtet. Angesichts der alles andere als minimalen Ausstattung der Minimal-Version in anderen Bereichen ist das unverständlich. Das ist ansonsten doch schon ziemlicher Standard und kommt von Debian bis openSUSE überall zum Einsatz. Hier sehe ich deutliches Verbesserungspotenzial, zumal AppArmor natürlich in den Paketquellen vorhanden ist und vom Anwender eingerichtet werden kann. Bei der Zielgruppe werden das nur leider zu wenige tun.

Zusammengefasst

Manjaro macht einen richtig guten Eindruck. Ich bin selten nach einem Distributionstest so positiv überrascht. Manjaro liefert ein sehr rundes Gesamtpaket aus und mit ein bisschen Nacharbeit bekommt man ein wirklich gutes Desktopsystem.

Ich bin mit Arch Linux nie wirklich warm geworden, was zu einem guten Teil auch an der Community lag, die ich als arrogant und überheblich wahrgenommen habe. Manjaro baut zwar auf bewährten Arch-Prinzipien auf, macht aber vieles anders, manches besser und wirkt sehr sympathisch.

Manjaro ist eine Distribution, die es geschafft hat in die engere Wahl dessen, was ich so an Linux-Distributionen berücksichtige, aufgenommen zu werden.


Nachtrag vom 15.01.2022:

Präzisierung der Passage zu AppArmor wegen Unterschiede bei der Installation mit minimaler und vollständiger Variante.

Der Artikel Manjaro im Test – Rolling Release mit Sicherungsnetz erschien zuerst auf [Mer]Curius

Mi, 12. Januar 2022, Niklas

In der Debian Community wurde sehr heftig und lange über einen möglichen Wechsel zu systemd gestritten. Als man sich letztendlich dafür entschied, waren darüber viele verärgert und starteten Ende 2014 den Fork Devuan. Dieser bietet nicht nur weiterhin das bisher verwendete SysVInit an, sondern gibt dem Nutzer die Wahlfreiheit mit OpenRC, runit und Upstart als mögliche Alternativen.

Devuan ist eine der bekanntesten und verbreitetsten systemd-freien Distributionen, die inzwischen als Basis für 18 Derivate dient, die ebenfalls ohne systemd auskommen und weitere Besonderheiten bringen. Darunter befinden sich beispielsweise Exe GNU/Linux, das den KDE 3 Fork Trinity als Desktop mitbringt, Maemo Leste, eine freie Weiterentwicklung von Nokias Debian-basiertem Handybetriebssystem Maemo und Heads, eine Art Tails ohne systemd und mit Linux-libre Kernel.

Devuan bietet eine Vielzahl verschiedener Installations- und Live-Images an. Neben dem bei modernen Computern verbreiteten x86_64 werden auch noch 32Bit Images angeboten. Zudem unterstützt Devuan eine grosse Auswahl verschiedenster ARM Geräte, wie beispielsweise den Raspberry Pi und andere Einplatinencomputer, und die PowerPC64 Architektur.

Ich lade mir das 1,2 GB grosse desktop-live ISO herunter. Dieses bringt Xfce, Devuans Standard-Desktopumgebung mit. Ausserdem nutzt es Devuans Standard Init System SysVinit. Das System startet schnell in eine grafische Oberfläche. Einige nützliche Programme wie Firefox ESR und LibreOffice sind bereits im live System vorhanden. Es wird allerdings auch hier wieder ein OverlayFS benutzt, was bedeutet, dass alle Änderungen nach einem Neustart verloren gehen.

Ich starte also eine Installation auf einen zweiten USB-Stick, damit meine Einstellungen dauerhaft gespeichert werden können. Dafür ist bereits eine Verknüpfung namens Install Devuan auf dem Desktop vorhanden, hinter dem sich der Refracta Installer, ein grafisches Installationsprogramm, verbirgt.

Bereits im zweiten Schritt zeigt es an, dass es /dev/sda2 als Boot Partition erkannt hat. Das ist falsch. Ich bekomme schon ein ungutes Gefühl, aber mache zunächst weiter. In den nächsten Schritten kann ich ein paar Einstellungen vornehmen und mit GParted meinen USB-Stick partitionieren. Ich lege eine 100 MB grosse FAT32 Partition für den Bootloader an und nutze den restlichen Platz für eine Ext4 Partition für Devuan.

Ich kann anschliessend die Ext4 Partition für das System auswählen, habe jedoch im gesamten Prozess nicht die Möglichkeit, die Partition für den Bootloader zu wechseln. Auf der Seite mit der Zusammenfassung breche ich die Installation ab. /dev/sda2 liegt auf der internen Festplatte, ich würde mir so den Bootloader meiner FreeBSD Installation überschreiben.

Tipp: Für die, die Devuan gerne auf dem Computer installieren möchten, empfehle ich nach dieser Erfahrung nicht die Nutzung des Live ISOs, sondern eines ISOs mit Installation über das Terminal. Hier bietet sich zum Beispiel das Netinstall ISO an. Dort kommt Debians Installationsprogramm zum Einsatz, welches euch die Bootloader-Partition frei auswählen lässt.

Ich führe meine weiteren Tests mit dem live System durch. Die relativ umfangreiche live Umgebung von Devuan scheint mir dafür ausreichend. Im Terminal-Installationsprogramm habt ihr übrigens auch die Möglichkeit, schon während der Installation eure bevorzugte Desktopumgebung und euer bevorzugtes Init System auszuwählen.

Mit aktueller Software punktet Devuan erwartungsgemäss nicht. Nach einem vollständigen Update mittels sudo apt-get update && sudo apt-get dist-upgrade habe ich beispielsweise die Firefox Version 78.15.0 ESR, die seit Oktober dieses Jahres nicht mehr unterstützt wird - und das sogar, obwohl die aktuelle Devuan Version Chimaera erst 9 Tage nach dem letzten Update für Firefox 78 ESR veröffentlicht wurde. Bei Debian selbst kommt die gleiche veraltete Version zum Einsatz.

Die Auswahl an Software im Devuan Repository ist in höchstem Masse enttäuschend. Zum Surfen im Internet bekomme ich den normalen Firefox, keine datenschutzfreundlichen Forks wie LibreWolf, IceCat oder Iceweasel. Ausserdem nicht den leichtgewichtigeren Otter Browser. Native Matrix Clients wie Fractal (GTK) oder NeoChat (Qt) vermisse ich ebenfalls. Für Tox ist der Client qTox vorhanden. Retroshare fehlt. Einziger Lichtblick ist, dass ich das Textverarbeitungsprogramm AbiWord im Repository finden kann.

Wenn man Devuan als Server benutzen will, sieht es nicht viel besser aus. Ich habe zwar die freie Auswahl zwischen Apache2, Nginx und lighttpd. Die Programmiersprache PHP ist jedoch nur in Version 7.4 vorhanden, aktuell wäre 8.1. PHP 7.4 erhält zwar noch Updates, für bessere Kompatibilität mit moderner Software ist es allerdings nicht sinnvoll, eine Major Version zurückzuliegen. Der Matrix Server Synapse ist gar nicht vorhanden, für XMPP/Jabber steht mir sowohl Ejabberd als auch Prosody zur Verfügung.

Wirklich überraschend kommt das nicht. Die Aktualität und Auswahl im Debian Repository ist ähnlich ernüchternd. Dort setzt man oft auf fremde Repositorys, die man bei Devuan ebenfalls nutzen kann. Hierbei gibt es allerdings immer die Gefahr, dass Pakete nicht optimal mit dem System kompatibel sind oder Chaos anrichten, was bei offiziellen Repositorys der Distribution in der Regel nicht vorkommt.

Devuan herunterladen

Fazit: Wer Debian mag, wird auch Devuan mögen. Die beiden Distributionen sind sehr ähnlich. Der grösste Unterschied ist die freie Wahl des Init Systems bei Devuan. Wer mit Debian allerdings nichts anfangen kann, sollte sich lieber eine andere systemd-freie Distribution anschauen. Ich persönlich bin nicht besonders angetan von Devuan, hatte jedoch auch keine hohe Erwartungshaltung, da mir Debian ebenfalls nicht zusagt.

Quellen:

11. Januar 2022

Mozilla hat Firefox 96 und damit das erste Firefox-Update des Jahres 2022 für Windows, Apple macOS und Linux veröffentlicht. Dieser Artikel fasst die wichtigsten Neuerungen zusammen – wie immer auf diesem Blog weit ausführlicher als auf anderen Websites.

Download Mozilla Firefox für Microsoft Windows, Apple macOS und Linux

Automatisches Entladen inaktiver Tabs auch für Linux

Firefox auf Windows kann seit Version 93 in Situationen, in denen der zur Verfügung stehende Arbeitsspeicher knapp wird, automatisch Tabs entladen und auf diese Weise RAM freigeben. Dabei berücksichtigt Firefox verschiedene Faktoren wie den Zeitpunkt der letzten Nutzung, den RAM-Verbrauch des jeweiligen Tabs oder eine aktive Medienwiedergabe, so dass nach Möglichkeit keine Tabs entladen werden, welche vom Nutzer gerade verwendet werden.

Durch das Entladen inaktiver Tabs kann die Wahrscheinlichkeit für sogeannte Out-of-Memory-Abstürze reduziert werden. Bei dieser Art von Absturz handelt es sich um eine der häufigsten Arten von Firefox-Abstürzen.

Firefox 96 bringt dieses Feature auch auf Linux.

about:compat zeigt SmartBlock-Korrekturen

Mit dem Schutz vor Aktivitätenverfolgung besitzt Firefox ein Feature, welches Scripts von bekannten Trackern blockiert, um so die Privatsphäre der Nutzer zu schützen. Positiver Nebeneffekt: Häufig führt dies auch zu einer besseren Geschwindigkeit. Was in der Theorie simpel klingt, kann in der Praxis allerdings Kompatibilitätsprobleme verursachen, wenn der Website-Code das korrekte Laden blockierter Scripts voraussetzt.

Mit Firefox 87 hat Mozilla den sogenannten SmartBlock-Mechanismus für Nutzer, welche den strengen Schutz aktiviert haben, sowie in privaten Fenstern eingeführt. Dabei ersetzt Firefox die Scripts bekannter Tracking-Dienste durch eine Art Ersatz-Script, welches sicherstellt, dass die Website-Kompatibilität nicht beeinträchtigt wird, während die eigentliche Funktionalität außer Kraft gesetzt wird. So können beispielsweise seitens Website Funktionen aufgerufen werden, welche Google Analytics voraussetzen, ohne dass diese tatsächlich ausgeführt werden und ohne dass es, anders als ohne SmartBlock, Script-Fehler gibt, weil Google Analytics von Firefox blockiert wird.

Firefox 96 zeigt auf der Seite about:compat nach Anpassungen des User-Agents und Code-Eingriffen jetzt auch aktive SmartBlock-Korrekturen an und lässt diese einzeln deaktivieren.

about:compat in Firefox 96

Webplattform: Großes WebRTC-Update

WebRTC ist eine Sammlung von Schnittstellen für Videotelefonie, Teilen von Bildschirminhalten und mehr. Mit Firefox 96 hat Mozilla ein großes Update seines WebRTC-Codes durchgeführt, welches diverse Verbesserungen und Fehlerbehebungen in Zusammenhang mit Diensten bringen sollte, welche den WebRTC-Standard nutzen. Mozilla nennt unter anderem signifkante Verbesserungen bei der Rauschunterdrückung und automatischen Anpassung der Mikrofonempfindlichkeit des Teilnehmers sowie leichte Verbesserungen bei der Echounterdrückung. Auch Probleme wie eine reduzierte Auflösung beim Teilen von Bildschirminhalten und Probleme mit der Videoqualität sollen der Vergangenheit angehören.

Weitere Verbesserungen der Webplattform

Farben in CSS können auf verschiedene Weisen angegeben werden, unter anderem in hexadezimaler Schreibweise, als rgb()- oder auch als hsl()-Funktion. Firefox 96 unterstützt auch hwb()-Funktionen.

Neu ist auch die Unterstützung der CSS-Eigenschaft color-scheme. Außerdem unterstützt die CSS-Eigenschaft counter-reset nun die reversed()-Funktion.

Auf Seiten von JavaScript ist insbesondere die Unterstützung der Web Locks API nennenswert. Und der IntersectionObserver-Konstruktor wirft nicht länger einen Fehler, wenn ein leerer String als rootMargin-Wert übergeben wird.

Außerdem besitzt Firefox jetzt einen WebP-Encoder, womit es für canvas-Elemente nun möglich ist, den Inhalt als WebP zu exportieren.

Eine Übersicht über alle Verbesserungen der Webplattform gibt es wie immer in den MDN web docs.

Sicherheit: Neue Standard-Richtlinie für Cookies

Als zusätzliche Schutzmaßnahme gegen Cross-Site Request Forgery-Attacken (CSRF) setzt Firefox ab sofort auf Lax als Standardwert für das SameSite-Attribut von Cookies, sofern von der Website nicht anders definiert. Bisher war None der Standard. In Zusammenhang mit der SameSite-Richtlinie werden gleiche Domains unter http:// und https:// außerdem ab sofort als unterschiedliche Websites betrachtet.

Update: Auf Grund von Problemen mit der Webkompatibilität wurde diese Neuerung vorrübergehend abgeschaltet.

Sicherheit: Geschlossene Sicherheitslücken

Auch in Firefox 96 wurden wieder mehrere Sicherheitslücken geschlossen. Alleine aus Gründen der Sicherheit ist ein Update auf Firefox 96 daher für alle Nutzer dringend empfohlen.

Sonstige Neuerungen von Firefox 96

Die Funktion zum Importieren von Daten aus anderen Browsern erlaubt jetzt auch den Import aus dem Brave-Browser.

Mittels CSS @page können Websites unter anderem Abstände für die Druckansicht anpassen. Machte eine Website in der Vergangenheit davon Gebrauch, konnte der Nutzer die Abstände in der Druckvorschau von Firefox nicht überschreiben. Dies ist ab Firefox 96 möglich.

Verbessert wurde bei Verwendung eines Themes die Erkennung, ob dieses hell oder dunkel ist, was sich auf das Farbschema interner Firefox-Seiten auswirken kann.

Auf macOS lässt ein Klick auf Links in Google Mail bei gedrückter Cmd-Taste diese jetzt wie erwartet in einem neuen Tab öffnen.

Änderungen in Firefox 95 sollten zu einem reduzierten Stromverbrauch von Software-dekodierten Videos auf macOS führen, vor allem im Vollbild. Diese Änderungen wurden in Firefox 96 temporär rückgängig gemacht, da es damit zu verschiedenen Problemen kommen konnte.

Die Screenshot-Funktion speichert Screenshots jetzt immer als PNG-Datei und macht das Dateiformat nicht länger von der Größe des Bildes abhängig.

Nach der Einstellung der Firefox Lockwise App für Android und iOS zeigt die Passwort-Verwaltung von Firefox, die unter about:logins zu finden ist, nicht länger das Logo von Firefox Lockwise.

Hardware-WebRender ist jetzt auch auf Systemen mit Intel-CPU der sechsten Generation aktiviert.

Natürlich kamen auch in Firefox 96 Fehlerbehebungen sowie sonstige Verbesserungen unter der Haube dazu.

Der Beitrag Mozilla veröffentlicht Firefox 96 erschien zuerst auf soeren-hentzschel.at.

Di, 11. Januar 2022, Niklas

Klein, einfach, sicher. So beschreibt sich Alpine Linux selbst auf seiner Webseite. Es ist eine unabhängige, nicht-kommerzielle Linux Distribution, die sich gezielt an Poweruser richtet. Als Init System wird OpenRC vom Gentoo Projekt genutzt. Als Standard-C-Bibliothek setzt Alpine auf musl, was wir bereits mit Void Linux vorgestellt haben. Alpine Linux ist ausserdem die Basis für postmarketOS, einer Linux Distribution für Handys, die durch das PinePhone bekannt wurde.

Eine weitere Besonderheit von Alpine Linux ist, dass BusyBox statt den GNU Coreutils für die gängigen Terminalfunktionen zum Einsatz kommt. BusyBox ist wesentlich kleiner als die GNU Coreutils, bringt aber ähnliche Funktionen mit. Viele andere Pakete werden von Alpine Linux in kleinere Teile aufgeteilt, sodass man nur das installieren muss, was man wirklich braucht.

Um die Sicherheit zu erhöhen, werden alle Pakete im Userland als Position Independent Executables (PIE) mit stack smashing protection kompiliert. Das verhindert eine Vielzahl von Zero-Day-Exploits und anderen Sicherheitslücken.

Alpine Linux ist extrem klein. Das normale ISO für x86_64 Systeme ist gerade mal 159 MB gross. Dieses bringt allerdings nur eine Terminalumgebung mit. Installationsmedien mit vorinstalliertem Desktop bietet Alpine Linux nicht an. Es sind viele verschiedene Downloads für verschiedene Anwendungszwecke, Hardware und CPU Architekturen verfügbar, unter anderem sogar für alle Versionen des Raspberry Pi. Für mein Review wähle ich die Standardvariante für einen normalen x86_64 Computer.

Alpine Linux kann mit dem Befehl setup-alpine installiert werden. Das Programm ist sehr einfach gehalten, es stellt nur Eingabeaufforderungen im Terminal dar, ohne irgendeine Art Fenster oder Menü darzustellen. Trotzdem ist  es relativ einfach zu bedienen. Es stellt die wichtigsten Fragen und erledigt den Rest vollautomatisch.

Anschliessend starte ich in mein frisch installiertes Alpine Linux. Obwohl es so leichtgewichtig ist, startet es spürbar langsamer, als beispielsweise Void Linux. Ich habe zunächst nur den Root Account. Einen normalen Benutzer kann ich mit adduser anlegen (nicht useradd, wie bei den meisten anderen Distributionen). Sudo ist nicht vorinstalliert, kann aber aus dem Repository installiert werden.

Um Dateien im Terminal einfacher bearbeiten zu können, installiere ich mir den Terminal-Dateimanager Midnight Commander. Leider ist dieser auf Alpine Linux im TTY Terminal unbrauchbar. Keine Tastenkombination funktioniert, nur Befehle in Textform werden angenommen. Schon die Darstellung des Dateimanagers ist merkwürdig: Das Terminal scheint nur schwarz/weiss zu unterstützen. Sowas habe ich bisher bei keiner anderen Distribution gesehen. Vermutlich hängt es mit einer der minimalistischen Alternativen zu den gängigen Systemprogrammen zusammen, die Alpine Linux standardmässig einsetzt.

Nun möchte ich eine grafische Desktopoberfläche installieren. Die Auswahl ist hier ziemlich eingeschränkt. Nur KDE Plasma, GNOME, Xfce und Mate stehen zur Auswahl. Ich bin überrascht, bei einer Distribution, die so viel Wert auf leichtgewichtige Software legt, nicht die minimalistischen Desktopumgebungen LXDE und LXQt zu finden. Ich entscheide mich für den weiteren Test für KDE Plasma.

Mit setup-xorg-base und apk install plasma kann es installiert werden. Der SDDM Display Manager wird in der Plasma Gruppe automatisch mitinstalliert und muss nur noch mit rc-update add sddm aktiviert werden. Nach einem Reboot startet Alpine automatisch in den grafischen Loginscreen. Wichtig ist, hier von Wayland auf Xorg umzustellen, andernfalls landet man nach Eingabe des Passworts immer wieder beim Loginscreen. Leider kann Wayland nicht gänzlich deinstalliert werden.

Nachdem Alpine Linux so weit eingerichtet ist, schaue ich mir die verfügbare Software an. Neben den gängigen Standardpaketen hat Alpine für den Desktopnutzer nicht viel zu bieten. Ich finde alle KDE Programme, den Firefox Browser und das Textverarbeitungsprogramm AbiWord im Repository. Nicht vorhanden sind beispielsweise der leichtgewichtigere Otter Browser, Chatclients für Tox, Retroshare oder datenschutzfreundliche Firefox-Forks wie LibreWolf, IceCat oder Iceweasel.

Vermutlich ist Alpine Linux für den Einsatz auf Servern besser geeignet. Ich finde mit Apache2, Nginx und lighttpd alle drei grossen Webserver im Repository, sowie Synapse als Matrix Server und Prosody als Jabber/XMPP Server. Das waren natürlich nur stichprobenartige Tests anhand von Software, die bei einigen Distributionen zu finden ist und die ich regelmässig installiere.

Alpine Linux herunterladen

Fazit: Von Alpine Linux habe ich mir mehr erwartet. Die Geschwindigkeit sowie die Verfügbarkeit von Paketen für den Einsatz als Computer lassen zu wünschen übrig. Mit seiner kleinen Basisinstallation kann Alpine auf Geräten mit wenig Speicherplatz punkten, aber sobald man KDE installiert, hat sich das auch erledigt. Ich sehe die Bestimmung von Alpine Linux mehr auf Servern, wofür es einige relevante Pakete im Angebot hat.

Quellen:

Di, 11. Januar 2022, Niklas

In diesem Beitrag geht es ausschliesslich darum, welche Änderungen an Haiku selbst vorgenommen wurden. Es gibt einige weitere spannende Entwicklungen, die ausserhalb von Haikus Git Repository stattgefunden haben, wie der X11 Kompatibilitätslayer Xlibe (wir berichteten) oder der experimentelle Wine Port (wir berichteten), aber das kann nicht alles in nur einem Artikel zusammengefasst werden.

Zum Ende des Jahres wurden wieder einmal die Beteiligungsstatistiken für Haiku und Haikuports ausgewertet. Dort sieht man die Anzahl der Commits pro Jahr, die Anzahl der Mitwirkenden und viele weitere Statistiken. Erstaunlicherweise zeigt die Statistik für Haiku die kleinste Anzahl an Commits in der Geschichte von Haiku und die wenigsten Mitwirkenden seit 2016, obwohl so viele grosse Fortschritte erzielt wurden.

Haikuports, das Repository für Haiku Pakete, hat dieses Problem nicht. Sowohl die Anzahl der Änderungen als auch die Zahl der Mitwirkenden steigt, letztere erreicht mit 75 einen neuen Rekord. Es gibt aktuell 3037 Rezepte für Pakete im Haikuports Repository und mit der Verfügbarkeit von Xlibe und Wine ist damit zu rechnen, dass die Zahl im neuen Jahr stark steigen könnte.

Die Grösse des Haiku Codes bleibt seit 2015 stabil bei etwa 30000 Dateien, die insgesamt rund 5,5 Millionen Zeilen ausmachen. Von den 30000 Dateien sind 16000 Quellcode, die anderen 14000 eine Mischung aus Dokumentation, Übersetzungen, Kataloge für locale kit, Scripts für das Build System und verschiedene Binärdateien für Icons, Programmressourcen und anderes.

Nun aber zu den Neuigkeiten bei Haiku. Einen überwältigenden Teil machen im Dezember die Treiber aus. Wie schon in den letzten Monaten wurde fleissig an den Grafiktreibern gearbeitet. Der Intel Grafiktreiber unterstützt jetzt PLL Programmierung auf Skylake Chips, erste Unterstützung für das DDI Interface und eine Implementierung von Interrupt Handling für neuere Hardwaregenerationen. Das verbessert die Unterstützung für modernere Intel Chips und für verschiedene Anschlüsse (DVI, DisplayPort und eDP brauchen alle eine spezielle Handhabung im Treiber).

Auch am AMD Radeon Grafiktreiber wurden Verbesserungen vorgenommen. Dieser unterstützt jetzt modernere Hardware, ausserdem wurden ein paar fehlende Teile hinzugefügt. Bei Laptops mit AMD Radeon Grafik kann jetzt die Bildschirmhelligkeit eingestellt werden.

Ausserdem wird an den Treibern für Eingabegeräte gearbeitet. Die Treiber für USB und I2C Tastaturen sollen wieder vereinheitlicht werden. Ursprünglich war die Datei für I2C eine Kopie der Datei für USB mit ein paar Änderungen. Durch die Zusammenführung wird verhindert, dass sich die Treiber auseinanderentwickeln, wenn Änderungen nur an einem davon vorgenommen werden. Des Weiteren wurde das Output des B_GET_DEVICE_NAME ioctl bei diesen Treibern verbessert. Über weitere Verbesserungen wird aktuell beraten.

Fortschritte gibt es auch beim ARM Port. Im Dezember wurden mehrere Patches für ein besseres Interrupt Handling überprüft und in das Haiku Repository übernommen. Die Bootstrap Pakete sind jetzt ausreichend stabil und wurden auf den Buildserver hochgeladen. Das bedeutet, es ist jetzt möglich, ein nicht-Bootstrap Build des ARM Ports zu testen. Momentan wird das allerdings nur zu einem Bootscreen führen, der ein paar Icons anzeigt und wurde hauptsächlich in QEMU getestet. Der nächste Schritt wird sein, einen Treiber für Massenspeicher hinzuzufügen, damit der Boot Prozess einen Schritt weiter kommt. Dazu wird am virtio Treiber gearbeitet. Vielleicht wird auch der SDHCI Treiber für SD und MMC Karten zuerst fertig.

Am RISC-V Port wird ebenfalls weiterhin gearbeitet. Die erste Implementierung für SMP (Unterstützung für mehrere CPU Kerne) wurde diesen Monat in den Haiku Code übernommen. Der Code war schon länger vorhanden, musste aber noch geprüft und aufgeräumt werden.

Im Kernel wurden verschiedene Probleme mit der neuen condition_variable Implementation behoben. Es sollte jetzt weniger Fehler haben und trotzdem noch etwas schneller sein, als die vorherige Version. Ausserdem wurde ein Fehler bei der Metadata Checksum Unterstützung im Ext2/3/4 Dateisystemtreiber behoben.

Der EFI Bootloader wurde optimiert, um auch auf 32Bit x86 Systemen zu funktionieren. Das ist für Geräte nützlich, die kein 64Bit EFI Unterstützen, wie einige ältere Apple Geräte und x86 Tablets. Der EFI Bootloader wurde dadurch so umgebaut, dass es in Zukunft einfacher wird, ihn auf neue Architekturen zu portieren.

Netzwerkstack und POSIX-Kompatibilität haben ebenfalls Verbesserungen erhalten. In der UDP Implementation wurde ein Double Free behoben. Im TCP Stack und der XSI Semaphore Implementation wurden Fehler behoben, die durch die NSPR Testsuite gefunden wurden. Im DHCP Client wurde ein Problem mit dem Timeout Management behoben. Vorher konnte er nicht mit längeren Lease-Zeiten als einer Stunde umgehen und überschwemmte das Netzwerk manchmal mit DHCP Anfragen.

Im app_server wurde ein Problem im Umgang mit Bitmap Cursors behoben. Es war möglich, app_server zum Absturz zu bringen, wenn man ihm beim Setzen eines anderen Cursors ungültige Parameter gab. In der B_OP_COPY drawing mode Implementierung wurde ein Fehler behoben, der dazu führte, dass das Auswahlrechteck in Wonderbrush weiss statt durchsichtig war. Im Schriftartenmanagement wurde ein Fehler behoben, der dazu führte, dass falsche Schriftmetriken benutzt wurden, wenn ungewöhnliche Styles in der Schriftart verfügbar sind.

Es gab auch einige Änderungen bei den Programmen und beim User Interface. Auf der russischen Tastatur wurde das Rubel-Symbol an die richtige Stelle verschoben. In WebPositive wurde die Höhe des Ladebalkens der Statusleiste angepasst (abhängig von der Schriftgrösse). ActivityMonitor kann jetzt die aktuelle CPU Frequenz anzeigen, ausserdem wurde die Performance verbessert, sodass beim Neuzeichnen der Graphen weniger CPU Last entsteht. Ausserdem wurden benutzerdefinierte Icons für Ordner im Tracker repariert.

Bei den Debugging-Tools hat strace einige Verbesserungen erhalten. Es unterstützt jetzt pull und select calls und kann mehr ioctl Konstanten dekodieren. Ausserdem wurde die Möglichkeit hinzugefügt, mehrere Syscalls von verschiedenen Prozessen gleichzeitig auszuführen. Strace ist ein Tool, das ein Programm ausführt und alle Aufrufe an den Kernel aufzeichnet, sodass man verstehen kann, was das Programm tut.

Zu guter Letzt wurde auch am Build System gearbeitet. Es wurden verschiedene Probleme mit den Compiler Flags für den Bootloader behoben. Der Bootloader ist etwas Besonderes im Build System, weil er nicht als Haiku Programm kompiliert wird, sondern als das, was von der Plattform zum Boot gebraucht wird (EFI Executable, OpenFirmware Executable oder etwas, was vom BIOS gestartet werden kann). Das wurde nicht korrekt umgesetzt und manche Befehle wurden mit den falschen Flags ausgeführt oder sogar mit der falschen Executable. Das wurde besonders beim ARM Port zum Problem, wo der Bootloader sehr unterschiedliche Compiler Flags benötigt.

Es wurden verschiedene Probleme im Code behoben, um zu ermöglichen, dass Haiku mit GCC 11 kompiliert werden kann. Das ist jetzt der Standard und ersetzt GCC 8.3. Danach wurden einige Compiler Warnings behoben, die nach der Umstellung aufgetaucht sind. Ausserdem wurden Fehler in der Konfiguration von LGTM behoben. LGTM ist ein Static Code Analyzer, der den Quellcode von Haiku auf mögliche Probleme scannt.

Quelle: https://www.haiku-os.org/blog/pulkomandy/2022-01-06-activity-report/

10. Januar 2022

Mo, 10. Januar 2022, Niklas

Void Linux ist kein Fork einer anderen Distribution, sondern wurde von Grund auf neu geschrieben und hat seinen eigenen Paketmanager namens XBPS. Die Distribution ist ein Community-Projekt, welches vollständig von Freiwilligen gepflegt wird. Es handelt sich um eine Rolling-Release-Distribution, die trotzdem viel Stabilität verspricht.

Eine Besonderheit der Distribution ist, dass man die Auswahl zwischen glibc und musl als Standard-C-Bibliothek hat. Die meisten Distributionen setzen vollständig auf glibc, ein paar andere vollständig auf musl. Durch die Auswahlmöglichkeit sind alle Pakete doppelt im Repository vorhanden, jeweils als glibc oder musl Variante. Beim Init System gibt es hingegen keine Auswahl, hier setzt Void Linux ganz auf runit.

Eine weitere Besonderheit von Void Linux ist die besonders gute Unterstützung für das Anonymisierungsnetzwerk Tor. Der XBPS Paketmanager versteht die SOCKS_PROXY Umgebungsvariable, um Tor als Proxy zu nutzen und bietet sogar einen offiziellen Mirrorserver unter einer Tor .onion Domain an.

Wenn ich Void Linux ausprobieren möchte, habe ich die Wahl zwischen einem Basissystem ohne GUI oder einem vorinstallierten Xfce Desktop, jeweils mit glibc oder musl. Ich entscheide mich für die Variante mit Xfce und musl, da ich das System nur kurz ausprobieren möchte und mir so den Aufwand der manuellen Desktop-Installation erspare. Neben der klassischen x86_64 Variante wird Void Linux auch für ältere 32Bit Systeme sowie alle vier Versionen des Raspberry Pi angeboten.

Mit 858 MB ist der Download überraschend klein für ein live System mit vorinstalliertem Desktop. Ich schreibe das System auf einen USB-Stick, es bootet in Sekundenschnelle. Leider ist auch hier das live System schreibgeschützt, ich installiere es also wieder auf einen zweiten USB-Stick, um eine beschreibbare Root Partition zu bekommen. Die Installation verläuft reibungslos. Void Linux hat ein Installationsprogramm, welches ein User Interface im Terminal darstellt. Es ist ein relativ einfach verständlicher Prozess, das so installierte System funktioniert einwandfrei.

Anschliessend starte ich ein vollständiges Systemupdate. Dank Rolling Releases habe ich schnell ein aktuelles System mit den neuesten Paketen. Allgemein ist die Auswahl an Paketen im Void Linux Repository ziemlich gut. Ich finde hier zum Beispiel Venom, ein GTK-basierter Tox Chatclient und Retroshare direkt im offiziellen Repository. Bei Arch Linux müsste ich diese aus dem AUR holen.

Punktabzug gibt es nur für das Fehlen von LibreWolf, IceCat, Iceweasel und Ungoogled Chromium, aber da bin ich vermutlich inzwischen zu verwöhnt von den komplett freien Distributionen. Eine solche ist Void Linux ausdrücklich nicht. Als Kernel steht wahlweise der normale Linux Kernel in verschiedenen Versionen oder dessen LTS Version zur Verfügung.

Obwohl als fertiges Image nur Xfce bereitsteht, bietet Void Linux eine breite Auswahl an verschiedenen Desktopumgebungen an. Ich finde im Repository beispielsweise auch KDE Plasma, Cinnamon und Enlightenment. Diese können nachträglich installiert werden.

Abgesehen vom fehlenden systemd fühlt sich Void Linux nach einer ganz gewöhnlichen Linux Distribution an. Sie ist vor allem interessant für alle, die ohne grosse Umgewöhnung auf systemd verzichten wollen. Da sich Void Linux voll und ganz auf runit als Init System konzentriert, sind alle Pakete so optimiert, dass sie ohne weiteres damit funktionieren. Zusatzpakete mit -openrc, -runit oder ähnlicher Endung wie bei Artix sind hier nicht notwendig.

Void Linux herunterladen

Fazit: Void Linux ist ein solides System, das einen sehr schnellen und schlanken Eindruck macht. Es geht nicht ganz so viele Sonderwege wie einige vorher vorgestellte Distributionen, weshalb sich das Fachwissen, das man braucht, um Void Linux zu bedienen, in Grenzen hält. Void punktet mit einem grossen Softwareangebot im Repository und einen Mirror mit Tor Hidden Service.

Quellen:

Im ersten Schritt wird der aktuell laufende MySQL Server gestoppt:
sudo /etc/init.d/mysql stop

Anschliessend wird sichergestellt das /var/run/mysqld existiert und die richtigen Zugriffsrecht hat:
sudo mkdir /var/run/mysqld
sudo chown mysql /var/run/mysqld

Nun wird MySQL im sicheren Modus und unter umgehung der Kennwörter gestatet:
sudo mysqld_safe –skip-grant-tables&

Einmal Enter drücken damit man wieder an der Shell ist.

Anmeldnung bei MySQL ohne Kennwort mit vollen Rechten:
sudo mysql –user=root mysql

Am SQL Prompt geben wir nun der Reihe nach folgende Befehle ein:
UPDATE mysql.user SET authentication_string=null WHERE User=’root’;
flush privileges;
ALTER USER ‘root’@’localhost’ IDENTIFIED WITH mysql_native_password BY ‘NeuesKennwortHier’;
flush privileges;
exit

Anschliessend wird MySQL neu gestartet:
sudo /etc/init.d/mysql start

Die Anleitung habe ich auf Ubuntu 20.04 Server getestet. Allerdings habe ich den “root” Account freigeschaltet so das ich kein sudo benötige. Interessant finde ich das bei einer mysql Installation nicht mehr nach einem root Kennwort gefragt wird. Bei alten Debian Versionen war es durchaus üblich im Rahmen der apt installation (oder aptitude) nach dem root Kennwort für die Datenbank zu fragen.

Ich selbst lese gern, womit andere Blogger dienstlich und privat arbeiten. Heute schreibe ich auf, wie dies Anfang 2022 bei mir aussieht. Dieser Artikel ist für euch. Viel Spaß beim Lesen.

Smartphone

Mein nahezu ständiger Begleiter ist das Smartphone Sony Xperia XZ2 Compact. Dieses nutze ich bereits seit Mai 2018 und es wird mir hoffentlich noch ein paar Jahre gute Dienste leisten. Als potenziellen Nachfolger habe ich ein Fairphone ins Auge gefasst. Ich nutzte das Gerät:

  • Um Bilder und Videos von meiner entzückenden Familie zu machen (meine Frau bestand auf diesen sehr wichtigen Hinweis)
  • Zum Telefonieren
  • Als Terminkalender
  • Für Chat und Kurznachrichten mit Matrix über Element (dienstlich), SMS und Threema (bevorzugt)
  • Zur E-Mail-Kommunikation mit K-9-Mail
  • Die Internetrecherche mit Firefox, Firefox Klar und dem Tor Browser
  • Zum Konsum von RSS-Feeds mit Feedly
  • Nutzung diverser sozialer Netzwerkwerke wie Facebook, LinkedIn, Mastodon, Twitter und XING
  • Mit bestimmt drei Dutzend weiteren Apps

Tablet

Vom Telefonieren und den Kurznachrichten abgesehen verwende ich für die gleichen Zwecke wie oben seit Mitte 2019 auch ein Samsung T830 Galaxy Tab S4 Wi-Fi Tablet. Durch seine 10,5 Zoll (ca. 27 cm) Bildschirmdiagonale, das geringe Gewicht und mit der App ReadEra eignet es sich hervorragend zum Lesen von PDF-Dateien und E-Books. Darüber hinaus nutze ich auf dem Tablet häufig den Android-Terminal-Emulator Termux. Zusammen mit der Tastatur-Hülle von Fintie dient es mir regelmäßig als Laptop-Ersatz. Dabei finde ich besonders das Preis-/Leistungs-Verhältnis der Tastatur-Hülle unschlagbar gut. Ich habe zuvor nicht wirklich daran geglaubt so gut auf einer doch sehr kleinen und günstigen Tastatur schreiben zu können.

Die Bedienung mit dem S-Pen ist nicht ganz so gut wie die von Apple, doch durchaus gut zu nutzen. Allerdings bin ich wieder dazu übergegangen längere Notizen und Gedanken mit Tinte in einem Notizbuch aus Papier festzuhalten. Das Schreiben mit der Hand auf Papier gefällt mir gut und ist eine Abwechslung zum ständigen Tippen.

Auf dem Tablet habe ich sicher nochmal ein Dutzend mehr Apps, als auf dem Smartphone. Doch möchte ich hier nicht alle auflisten. Die wichtigsten habe ich, glaube ich, genannt.

Laptop

In 2021 neu hinzugekommen ist ein Lenovo ThinkPad T14s (AMD). Auf diesem läuft aktuell Fedora 35. Zu den meistgenutzten Anwendungen zählen:

  • Thunderbird für E-Mail, Kalender und Aufgaben
  • Chromium für Videokonferenzen
  • Firefox für den Rest vom Web
  • Das Gnome-Terminal
  • Der beste Editor überhaupt: Vim
  • Rambox als Sammelecke für:
    • Element
    • Threema
    • Slack
    • XING
    • LinkedIn
    • Feedly
    • Mastodon
  • Lokale Instanz von LanguageTool, um auf Rechtschreibung und Grammatik aufzupassen
  • TeX Live zum Erstellen von allem, was mal in PDF oder auf Papier gebannt werden soll; als Editor nutze ich Vim.

An Letztem schätze ich, dass ich die ganzen Chat-, Nachrichten und Sozialen-Medien in einem separaten Fenster habe, wo ich sie insgesamt oder selektiv stumm schalten kann.

Insgesamt macht das T14s soviel Spaß, dass ich das Tablet tatsächlich nur noch fast ausschließlich zum Lesen verwende und sämtliche Schreib-, Programmier- und Recherche-Arbeiten an diesem Gerät verrichte.

Desktop/Server-PC

In meinem häuslichen Arbeitszimmer steht noch ein PC der Marke Eigenbau unter dem Schreibtisch. Ein Debian Bullseye verwaltet darin die folgenden Komponenten:

  • Motherboard: MSI MS-7C56/B550-A PRO
  • CPU: AMD Ryzen 5 PRO 4650G with Radeon Graphics
  • 32 GB RAM
  • 240 GB SSD und 1 TB HDD
working-space
Mein Arbeitsplatz 2022, mit höhenverstellbarem Schreibtisch, privater Workstation und Kabelmonster unter der Arbeitsplatte sowie dazugehöriger Ein- und Ausgabegeräte darauf (links im Bild). Rechts davon meine dienstlichen Arbeitsmittel.

Von Rambox abgesehen verwende ich auf diesem Gerät die gleichen Anwendungen wie auf dem Laptop. Zusätzlich dient mir dieser Rechner als KVM-/QEMUHypervisor. Die darin betriebenen virtuellen Maschinen dienen mir als Heimlabor, Entwicklungs- und Test-Umgebung. Produktive Dienste hoste ich darauf aktuell nicht.

Sonstige Geräte im Netzwerk

Seit nunmehr über 15 Jahren halten mein Netzwerk-Drucker und -Scanner Brother DCP-540CN und ich uns gegenseitig die Treue. Die Tintenpatronen sind seit Jahren für sehr geringe Preise zu bekommen und das Gerät verrichtet zuverlässig seinen Dienst. Die lange Laufzeit ist in meinen Augen ein Beweis für die Qualität dieses Gerätes. Zum Scannen unter Linux verwende ich die Anwendung XSane. Über die Jahre hat die Einrichtung unter verschiedenen Distributionen und Releases immer mal wieder etwas gehakt. Doch insgesamt bin ich wirklich sehr zufrieden mit dem Gerät und der Unterstützung unter Linux.

Nicht ganz so lange begleitet mich die Synology Diskstation DS213air. Ausschlaggebend für den Kauf war damals die integrierte WLAN-Unterstützung. Seit einigen Jahren nehmen die zu einem RAID-1 verbundenen Toshiba DT01ACA300 3 TB HDDs verschiedenste Daten auf. Das NAS dient als:

  • Backup-Ziel für diverse weitere Geräte im LAN
  • Netzwerk-Speicher für gemeinsam genutzte Dateien
  • Host für einige Git-Repos
  • Audio-, Foto- und Video-Station

Die Daten, die nicht bereits Backups darstellen, werden auf eine direkt angeschlossene 2,5 Zoll USB-HDD sowie mit einem Reverse-SSH-Tunnel offsite gesichert.

Dann gibt es da noch einen Pi-Hole auf einem Raspberry Pi 2 Model B, welcher für DHCP und DNS verantwortlich ist. Dann gibt es da noch einen Pi der ersten Generation. Dieser hostet FHEM und ruft einige Parameter meiner PV-Anlage ab.

Übrigens sind keine Geräte in meinem LAN aus dem Internet erreichbar. Auch nicht per VPN. Es steht also keine Tür offen, durch die der Schmutz aus dem Internet hereinwehen kann. Den Datenverkehr, der das LAN verlässt, möchte ich zukünftig ebenfalls limitieren. Hier suche ich noch nach einer geeigneten Lösung.

Irgendetwas as a Service

Diesen WordPress-Blog betreibe ich selbst auf einem Virtual Private Server (VPS) von Contabo. Als Betriebssystem kommt Debian Bullseye zum Einsatz und NGINX ist der Webserver meiner Wahl. Auf diesem System läuft auch eine Rootless-Podman-Installation, welche ich nutze, um mich mit Linux-Containern vertraut zu machen.

Um E-Mails, Termine und Aufgaben kümmert sich bereits seit einigen Jahren Mailbox.org. Die genannten Dienste nutze ich auf meinen Endgeräten in den Programmen Thunderbird, K-9-Mail sowie mit den Apps:

  • OX Sync App
  • OX Tasks
  • OX Drive

Maibox.org nutze ich ebenfalls für gelegentliche Videokonferenzen im Webbrowser mit 3-5 Teilnehmern.

Meine Domain und die dazugehörige DNS-Verwaltung liegen seit Jahren bei ClouDNS. Die Zonen-Updates sind schnell und ich hatte bisher noch nie Probleme mit dem Dienst.

Und ich bin noch einer der Ewig-gestrigen, die TeamDrive 3 auf Laptop, Tablet und PC nutzen. Der dazugehörige TeamDrive Personal Server läuft ebenfalls auf meinem VPS.

Zusammenfassung

Wie ihr gelesen habt, nutze ich mit wenigen Ausnahmen alte bis uralte Hardware, welche jedoch noch tadellos ihren Dienst verrichtet und meinen Ansprüchen voll und ganz genügt.

Grundsätzlich suche ich meine Geräte danach aus, dass sie meine Anforderungen erfüllen und den Eindruck erwecken, möglichst lange Unterstützung (Garantie, Updates, Ersatzteilverfügbarkeit, etc.) zu erhalten. Das muss kein Dogma sein. So gönne ich mir auch gerne mal etwas Neues wie z.B. das T14s. Deshalb landen die älteren Modelle T410 und X201 nicht auf dem Müll, sondern werden einem neuen Verwendungszweck zugeführt.

Ich hoffe, der Artikel hat euch ein wenig unterhalten. Lasst mich gern in einem Kommentar wissen, ob und wie euch diese Art von Artikeln gefallen. Kommt gut in die neue Woche.

9. Januar 2022

Pipewire ist vereinfacht gesagt eine sogenannte Zwischenschicht für Audio, Midi und Video zwischen Hardware/Treiber und den Endanwendungen wie z.B. ein Firefox Webbrowser, einer Webcam, Screensharing oder VLC Videoplayer. Pipewire ist wesentlich latenzärmer (schneller) als JackAudio und kann Software (Clients) vorgaukeln, dass es ein Jackserver, Pulseaudioserver oder eine ALSA Schnittstelle ist.


Diese Pipewire Zwischenschicht kann wie ein Wasserverteilungssystem verstanden werden. Es gibt verschiedene Quellen, die alle mit allen Zielen (Audio/Video) gleichzeitig verbunden werden können. Zum Beispiel könnte man eine Webcam für eine Videokonferenz nutzen, gleichzeitig für eine lokale Aufnahme, einen Livestream und auf einen großen Monitor bringen. Ein abgespieltes Lied könnte gleichzeitig auf verschiedenen Soundkarten/Audiointerfaces geroutet, in den Livestream, auf Festplatte aufgenommen werden


Und das geht gleichzeitig. Ein Vorteil davon ist, dass keine Endanwendung mehr einen exklusiven Zugriff auf eine Hardware haben kann. Jede Audioquelle kann mit jedem Audioziel und jede Videoquelle kann mit jedem Videoziel verbunden werden. Z.b. können einzelne Firefox Tabs mit einer oder verschiedenen Ausgaben verbunden werden. Wirklich alle mit allen! Extrem cool!


Vor ein paar Tagen hatte ich euch um Hilfe bei meiner Suche nach einem Nachfolger für Synology Note Station gebeten. Viele von euch haben geantwortet. Letztlich habe ich mich jetzt für Joplin entschieden.

Interessant für mich war, dass meine Unzufriedenheit über die Rechercheergebnisse in dem Bereich von einigen geteilt wurde. Ich hatte bis dahin gar nicht auf dem Schirm, dass Linux im Bereich der Notizen noch Luft nach oben hätte.

Ohne die Kommentare von euch jetzt statistisch ausgewertet zu haben, würde ich festhalten, dass die meisten von euch entweder auf Nextcloud Notes oder Joplin setzen. Zusätzlich gab es natürlich noch ganz viele andere Lösungen. Viele davon sind interessant und ich habe mir einiges genauer angesehen. Sehr geholfen hat mir auch dieses YouTube-Video, in dem einige der Möglichkeiten aus den Kommentaren detaillierter vorgestellt wurden.

Die Wahl fiel dann im Ausschlussverfahren. Ich habe gegenwärtig keine Nextcloud im Einsatz, weil mir die integrierten Funktionen meines Synology DSM reichen und ich mich in der Vergangenheit häufiger über hakelige Updates bei Nextcloud geärgert hatte. Dadurch fiel diese Option weg.

Aus diesem Grund gebe ich nun Joplin eine Chance. Liebe auf den ersten Blick ist es nicht. Die Apps sind keine nativen Programmen und sowohl auf dem Desktop als auch auf meinem Android eher behäbig und integrieren sich nur leidlich in die jeweiligen Systeme. Aber funktional bietet Joplin alles was ich benötige und ich kann es via WebDAV über mein Synology NAS synchronisieren.

Überzeugt haben mich dann vor allem die umfassenden Exportmöglichkeiten, wodurch kein Lock-in Effekt entsteht. Denn sollte es Bewegung in dem Bereich geben und neue Alternativen auf den Markt kommen, könnte ich mir sehr gut vorstellen, Joplin wieder den Rücken zu kehren.

Der Artikel Notizen – Es ist Joplin geworden erschien zuerst auf [Mer]Curius