staging.inyokaproject.org

2023 Woche 33

20. August 2023

SUSE ist mal wieder in schwerem Fahrwasser. Gut zwei Jahre nach dem Börsenstart kauft EQT die Kleinanleger voraussichtlich am Oktober raus und nimmt SUSE wieder von der Börse.

Der Aktienkurs war schon länger sehr schwach und auch die Zahlen sprachen nicht für sich. Ich wundere mich immer wieder, wie ein Unternehmen mit einer soliden Kundenbasis und Linux-Know-how in Zeiten der allgegenwärtigen Digitalisierung keine Erfolgsstory sein kann.

SUSE befindet sich mitten im Umbau. Das Enterprise-System soll auf ALP umgestellt werden, wobei es da auch widersprüchliche Signale gibt und die Zukunft von openSUSE ist noch unklar. Daneben bandelt man irgendwie mit enttäuschten Red Hat-Kunden an, aber das System dahinter versteht niemand so recht.

Der Plan von EQT ist unklar. Sie müssen bis 2028 etwas mit SUSE machen, weil der Fonds dann ausläuft. Ursprünglich gingen die meisten davon aus, dass der Börsengang von SUSE die Vorbereitung für einen Komplettverkauf sei. Angesichts des sinkenden Aktienkurses hat EQT aber schon vor einiger Zeit davon Abstand genommen, weitere Anteile an den Markt zu bringen. Die ursprüngliche Monetarisierungsstrategie ist also gescheitert und mit dem Rückkauf versucht man nun offenbar, neue Handlungsoptionen zu eröffnen. Man darf gespannt sein, was sie als nächstes vorhaben.

Bezahlen muss das Ganze natürlich SUSE selbst – wie im Private-Equity-Geschäft üblich. Das Unternehmen nimmt also zusätzliche Schulden auf, um den Rückkauf zu finanzieren. Geld, das bei einer möglichen Neuausrichtung und strategischen Weiterentwicklung sicherlich fehlen wird.

Keine gute Entwicklung für Linux insgesamt. Die Perspektive von Red Hat ist unklar und mit SUSE wackelt eine der letzten originären Linux-Firmen. Zwar gibt es in der deutschsprachigen Linux-Community viele SUSE-Feinde, die der Firma irgendwelchen Kram von vor 20 Jahren nachtragen (was angesichts einer zunehmend überalterten Community immer häufiger zu beobachten ist), aber eigentlich kann niemand wollen, dass mit SUSE eine weitere Säule der Linux-Entwicklung wegbricht.


Der Transparenz halber: Ich persönlich habe damals zwei Aktien zum Spaß gekauft. Wenn ich sie zum angekündigten Preis zurückkaufe, mache ich 29 € Verlust.

Der Artikel EQT nimmt SUSE von der Börse erschien zuerst auf Curius

Die MZLA Technologies Corporation hat mit Thunderbird 115.1.1 ein Update für seinen Open Source E-Mail-Client veröffentlicht.

Neuerungen von Thunderbird 115.1.1

Mit dem Update auf Thunderbird 115.1.1 hat die MZLA Technologies Corporation ein Update für seinen Open Source E-Mail-Client veröffentlicht und behebt damit mehrere Probleme, welche sich in den Release Notes (engl.) nachlesen lassen.

Updates von Thunderbird 102 und älter sind zu diesem Zeitpunkt noch nicht aktiv. Nutzer älterer Versionen können sich Thunderbird 115.1.1 aber über die offizielle Website herunterladen und über die bestehende Version installieren.

Der Beitrag Thunderbird 115.1.1 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

19. August 2023

Eigentlich heisst der Vortrag

“WSP.NRW: Vielfältiger Einsatz von Open-Source-Anwendungen in der öffentlichen Verwaltung
Innovation durch Partizipation: Wie vielseitige Open-Source-Technologien die Transformation der öffentlichen Verwaltung vorantreiben”

aber der Einsatz oder Realisierung von OpenSource Software geht praktischerweise gut einher mit der Digitalisierung.

Für Interessierte ein wirklich sehr guter Vortrag, der teilweise mit guten Beispielen in die Tiefe geht und auch zeigt, dass das Problem nicht nur Software ist, sondern sehr viel auch Prozess und Organisationsstandardisierung, die dann wiederum durch Software gestützt wird.

Herzlichen Dank für diesen Einblick ! Und hier der Link zum Vortrag. Oder direkt unten auf das Video aus der Mediathek des CCC klicken und anschauen.

Views: 0

18. August 2023

Seit gestern ist es für Firefox-Nutzer nicht mehr möglich, kopierten Text in der Webversion von WhatsApp einzufügen. WhatsApp hat das Problem erkannt, die entsprechende Korrektur wird nach dem Wochenende ausgeliefert werden.

Firefox-Nutzer wundern sich seit gestern unter Umständen, wieso sie auf web.whatsapp.com keine kopierten Nachrichten mehr in das Textfeld einfügen können. Grund dafür ist eine Änderung seitens WhatsApp, die so in Firefox nicht funktioniert. Das Problem wurde seitens WhatsApp bereits erkannt und behoben. Eine Auslieferung der Korrektur erfolgt allerdings erst am Montag.

In der Zwischenzeit können sich betroffene Nutzer mit der Firefox-Erweiterung Absolute Enable Right Click & Copy behelfen. Wird diese installiert und in deren Erweiterungs-Panel die „Enable Copy“-Option aktiviert, funktioniert das Einfügen auf WhatsApp trotz des vorhandenen Fehlers.

Der Beitrag Kopierten Text einfügen funktioniert nicht mehr? WhatsApp bringt Firefox-Korrektur am Montag erschien zuerst auf soeren-hentzschel.at.

17. August 2023

Einleitung

Es gibt, oder es gab, ich weiss es ehrlich nicht genau, daher schreib ich mal in der Gegenwartsform, das Kommandozeilenprogramm youtube-dl oder andere Varianten wie yt-dlp oder ähnliche, mit denen es einfach möglich ist Videos herunter zu laden, um nicht von einer funktionierenden Internetleitung abhängig zu sein. Wer in Deutschland lebt, weiss, was ich meine.

Vor allem bei Lernmaterial ist das super, wenn es offline verfügbar ist und immer wieder angeschaut werden kann, ohne wieder und wieder durch das Streaming CO2 zu erzeugen.

Viele dieser Lernvideos haben Kapitelmarken und auch Untertitel in verschiedenen Sprachen, die natürlich auch im offline Modus sehr hilfreich sind. Und nicht nur als Kapitel, sondern eventuell auch zur Zerteilung in einzelne Videoclips, so dass bei einer Suche direkt auf den entsprechenden Clip zugegriffen werden kann.

Wenn also ein Video legal runtergeladen werden darf, dann helfen folgende Parameter und folgender Workflow bei den entsprechenden Programmen, die ich jetzt einfach mal unter dem Programmnamen DLPGRM zusammenfasse

Verfügbare Formate auslesen

Um erst mal zu sehen, in welchen VIDEO und AUDIO Formaten die Quelle vorliegt, gibt es folgenden Befehl, mit dem eine Tabelle ausgegeben wird.

DLPGRM -F URL-Link

Am Anfang der Tabelle steht in jeder Zeile eine ID und rechts daneben jede Menge weiterer Parameter. Wichtig ist, sich hier die IDs für das gewünschte VIDEO und AUDIO Format zu notieren, denn das wird für den nächsten Schritt gebraucht.

Hinweis: Wenn es einfach nur ein Redebeitrag ist, ohne dass Dinge gezeigt werden, die wichtig sind, wäre es unter Umständen sogar sinnvoll, das als Audiodatei (weiter unten) zu speichern, oder wenigstens als Video mit einer sehr geringen Auflösung. Wenn die Lernvideos nur auf dem Smartphone gespeichert werden sollen, dann sind hohe Auflösungen eh meist sinnlos. Da kann dann schon mal 256x144, 426x240 oder 640x360 genommen werden. Das spart CO2 und zuletzt auch eine Menge Festplattenplatz.

Lernvideo mit Kapitelinformationen speichern

Ist also die ID Nummer für VIDEO und AUDIO ausgesucht, dann kann mit folgendem Befehl das Lernvideo gespeichert werden. Gleichzeitig werden die Kapitel und deutsche & englische Untertitel mit rein gepackt und als Datei kommt eine MP4 Datei heraus, die auf allen Endgeräten abspielbar ist.

DLPGRM -f VIDEO+AUDIO --merge-output mp4 --embed-chapters --sub-langs "de,en" --embed-subs --write-auto-subs --embed-metadata URL-LINK

Soll das Lernvideo als reine Audio Datei, z.B. mp3 gespeichert werden, dann geht das auch mit

DLPGRM -x --audio-format mp3 URL-LINK

Kapitel nachträglich auslesen

Die Kapitel können nachträglich aus der Videodatei mit ffmpeg ausgelesen werden. Genauer gesagt mit dem Tool ffprobe. Dazu muss einfach nur der Befehl

ffprobe -show_chapters VIDEODATEI

eingegeben werden und als Ergebnis kommt eine Textausgabe der Kapitel heraus. Allerdings im sehr ausführlichen ffmpeg Format, aus dem dann die entsprechenden Informationen entnommen werden können. Dieses Format sieht z.B. so aus

[CHAPTER] 
id=0
time_base=1/1000
start=0
start_time=0.000000
end=60000
end_time=60.000000
TAG:title=Einleitung
[/CHAPTER]
[CHAPTER]
id=1
time_base=1/1000
start=60000
start_time=60.000000
end=95000
end_time=95.000000
TAG:title=Kanäle / Tracks umschalten
[/CHAPTER]
[CHAPTER]
id=2
time_base=1/1000
start=95000
start_time=95.000000
end=177000
end_time=177.000000
TAG:title=Parameter ändern (Volume, Pan, Send Effekte/Kanäle) und resetten
[/CHAPTER]
[CHAPTER]
id=3
time_base=1/1000

Kapitel als einzelne Videos speichern

Soll das Lernvideo nun aber in einzelne kleinere und leichter auffindbare Dateien aufgeteilt werden, so würde das auch mit dem Programm gehen, allerdings gibt es da den einen oder anderen unschönen Seiteneffekt, der durch sogenannte fehlende Keyframes (ein komplettes Vollbild) an der richtigen Stelle entsteht, so dass es manchmal beim Beginn der Kapitel aussieht, als würde jemand mit Wasserfarben durchs Bild wischen, oder aber das Lernvideo muss komplett neu codiert werden. Und das kann ganz schön lange dauern.

Es gibt da einen kleinen Trick, der nicht nur schneller, sondern auch Resourcen schonender ist. Das Programm LossLessCut kann diverse Videoformate einfach zerteilen, ohne dass irgendwas neu berechnet werden muss. Und es bietet eine einfache und praktische Lösung zu dem Keyframe Problem an. Nämlich schaut es, wo das Kapitel beginnt und dann “spult” es so lange zurück, bis es das letzte Keyframe findet und legt den Anfang des Kapitels dorthin.

Dabei handelt es sich dann meist um eine Wiederholung maximal 1-3 Sekunden zum vorherigen Kapitel aber dafür mit einem klaren Bild.

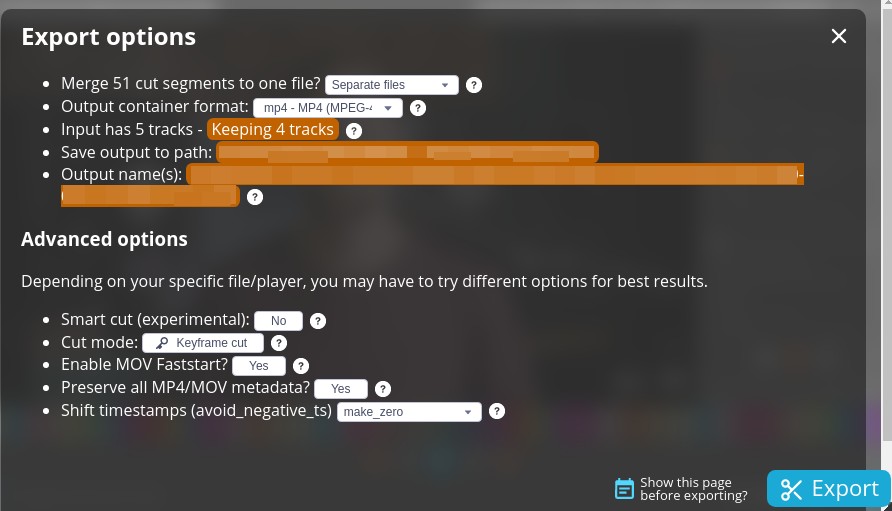
Also wird das Lernvideo in LossLessCut reingeladen und dann wird zuerst gefragt, ob die Segmente oder Chapters auch importiert werden sollen. Auf diese Frage mit Ja antworten. Danach kann gleich rechts unten auf den Export Knopf gedrückt werden und diese Einstellungen sollten übernommen werden.
Wichtig sind: Separate files, mp4, Cut mode=Keyframe cut, preserve all MP4/MOV metadata

Und nach 3 Sekunden liegen alle Kapitel als einzelne Videoclips vor.

Viel Spaß bei der Organisation eurer Lernvideos, die ihr jetzt noch viel effizienter ablegen könnt.

Es gibt, oder es gab, ich weiss es ehrlich nicht genau, daher schreib ich mal in der Gegenwartsform, das Kommandozeilenprogramm youtube-dl oder andere Varianten wie yt-dlp oder ähnliche, mit denen es einfach möglich ist Videos herunter zu laden, um nicht von einer funktionierenden Internetleitung abhängig zu sein. Wer in Deutschland lebt, weiss, was ich meine.

Vor allem bei Lernmaterial ist das super, wenn es offline verfügbar ist und immer wieder angeschaut werden kann, ohne wieder und wieder durch das Streaming CO2 zu erzeugen.

Viele dieser Lernvideos haben Kapitelmarken und auch Untertitel in verschiedenen Sprachen, die natürlich auch im offline Modus sehr hilfreich sind. Und nicht nur als Kapitel, sondern eventuell auch zur Zerteilung in einzelne Videoclips, so dass bei einer Suche direkt auf den entsprechenden Clip zugegriffen werden kann.

Wenn also ein Video legal runtergeladen werden darf, dann helfen folgende Parameter und folgender Workflow bei den entsprechenden Programmen, die ich jetzt einfach mal unter dem Programmnamen DLPGRM zusammenfasse

Verfügbare Formate auslesen

Um erst mal zu sehen, in welchen VIDEO und AUDIO Formaten die Quelle vorliegt, gibt es folgenden Befehl, mit dem eine Tabelle ausgegeben wird.

DLPGRM -F URL-Link

Am Anfang der Tabelle steht in jeder Zeile eine ID und rechts daneben jede Menge weiterer Parameter. Wichtig ist, sich hier die IDs für das gewünschte VIDEO und AUDIO Format zu notieren, denn das wird für den nächsten Schritt gebraucht.

Hinweis: Wenn es einfach nur ein Redebeitrag ist, ohne dass Dinge gezeigt werden, die wichtig sind, wäre es unter Umständen sogar sinnvoll, das als Audiodatei (weiter unten) zu speichern, oder wenigstens als Video mit einer sehr geringen Auflösung. Wenn die Lernvideos nur auf dem Smartphone gespeichert werden sollen, dann sind hohe Auflösungen eh meist sinnlos. Da kann dann schon mal 256×144, 426×240 oder 640×360 genommen werden. Das spart CO2 und zuletzt auch eine Menge Festplattenplatz.

Lernvideo mit Kapitelinformationen speichern

Ist also die ID Nummer für VIDEO und AUDIO ausgesucht, dann kann mit folgendem Befehl das Lernvideo gespeichert werden. Gleichzeitig werden die Kapitel und deutsche & englische Untertitel mit rein gepackt und als Datei kommt eine MP4 Datei heraus, die auf allen Endgeräten abspielbar ist.

DLPGRM -f VIDEO+AUDIO --merge-output mp4 --embed-chapters --sub-langs "de,en" --embed-subs --write-auto-subs --embed-metadata URL-LINK

Soll das Lernvideo als reine Audio Datei, z.B. mp3 gespeichert werden, dann geht das auch mit

DLPGRM -x --audio-format mp3 URL-LINK

Kapitel nachträglich auslesen

Die Kapitel können nachträglich aus der Videodatei mit ffmpeg ausgelesen werden. Genauer gesagt mit dem Tool ffprobe. Dazu muss einfach nur der Befehl

ffprobe -show_chapters VIDEODATEI

eingegeben werden und als Ergebnis kommt eine Textausgabe der Kapitel heraus. Allerdings im sehr ausführlichen ffmpeg Format, aus dem dann die entsprechenden Informationen entnommen werden können. Dieses Format sieht z.B. so aus

[CHAPTER] 
id=0
time_base=1/1000
start=0
start_time=0.000000
end=60000
end_time=60.000000
TAG:title=Einleitung
[/CHAPTER]
[CHAPTER]
id=1
time_base=1/1000
start=60000
start_time=60.000000
end=95000
end_time=95.000000
TAG:title=Kanäle / Tracks umschalten
[/CHAPTER]
[CHAPTER]
id=2
time_base=1/1000
start=95000
start_time=95.000000
end=177000
end_time=177.000000
TAG:title=Parameter ändern (Volume, Pan, Send Effekte/Kanäle) und resetten
[/CHAPTER]
[CHAPTER]
id=3
time_base=1/1000

Kapitel als einzelne Videos speichern

Soll das Lernvideo nun aber in einzelne kleinere und leichter auffindbare Dateien aufgeteilt werden, so würde das auch mit dem Programm gehen, allerdings gibt es da den einen oder anderen unschönen Seiteneffekt, der durch sogenannte fehlende Keyframes (ein komplettes Vollbild) an der richtigen Stelle entsteht, so dass es manchmal beim Beginn der Kapitel aussieht, als würde jemand mit Wasserfarben durchs Bild wischen, oder aber das Lernvideo muss komplett neu codiert werden. Und das kann ganz schön lange dauern.

Es gibt da einen kleinen Trick, der nicht nur schneller, sondern auch Resourcen schonender ist. Das Programm LossLessCut kann diverse Videoformate einfach zerteilen, ohne dass irgendwas neu berechnet werden muss. Und es bietet eine einfache und praktische Lösung zu dem Keyframe Problem an. Nämlich schaut es, wo das Kapitel beginnt und dann “spult” es so lange zurück, bis es das letzte Keyframe findet und legt den Anfang des Kapitels dorthin.

Dabei handelt es sich dann meist um eine Wiederholung maximal 1-3 Sekunden zum vorherigen Kapitel aber dafür mit einem klaren Bild.

Also wird das Lernvideo in LossLessCut reingeladen und dann wird zuerst gefragt, ob die Segmente oder Chapters auch importiert werden sollen. Auf diese Frage mit Ja antworten. Danach kann gleich rechts unten auf den Export Knopf gedrückt werden und diese Einstellungen sollten übernommen werden.
Wichtig sind: Separate files, mp4, Cut mode=Keyframe cut, preserve all MP4/MOV metadata

Und nach 3 Sekunden liegen alle Kapitel als einzelne Videoclips vor.

Viel Spaß bei der Organisation eurer Lernvideos, die ihr jetzt noch viel effizienter ablegen könnt.
Views: 0

Reguläre Ausdrücke (RegEx) sind DER Shit, wenn es darum geht extrem schnelle und auch sehr komplexe Dinge mit Texten bzw Strings oder einfach generell bei Suchen zu veranstalten.

Ein Anwendungsfall kommt immer wieder vor, nämlich das Suchen&Ersetzen.

Das Muster sieht so aus

:[range] s / [pattern] / [string] / [flags] [count]

[range]

  • bei range steht meist ein Prozentzeichen % das für den gesamten Text aka der gesamte Datei Inhalt.
  • hier können auch 1,$ = erste Zeile, erstes Zeichen bis letzte Zeile, letztes Zeichen
  • .,$ heisst von der aktuellen Zeile bis zum Ende
  • Von der aktuellen Zeile für weitere 10 Zeilen :.,.+10
  • {Nummer} - in Zeile Nummer sowieso z.B. :14 Zeile 14
  • Die Übersicht der schier unendlichen Bereichsangaben bekommst du, wenn du vim aufrufst und dann :h range eingibst

s (substitute)

  • Zwischen dem Range und dem s darf kein Leerzeichen sein! (häufiger Fehler)
  • Substitute ist die Suchen&Ersetzen Funktion. Wichtig zu wissen ist, dass alle Zeichen, die nicht in a-z und A-Z sind, müssen mit einem vorangestelltem Backslash \ “escaped” werden.
  • Also Zahlen, Punkte, Klammern und Sonderzeichen mit einem Backslash \ escaped werden.
  • Ein Backslash wird dann natürlich auch mit einem Backslash escaped \. Und ein Slash im Suchstring wird natürlich auch mit einem Backslash escaped \/ . Auch ein Leerzeichen bzw Blank wird mit einem Backslash escaped.
  • Der Grund dafür ist, dass viele dieser Zeichen selbst eine Funktion für die Suche darstellen. Und damit da keine Verwechselung entsteht muss extra “escaped” werden.

[pattern]

  • Pattern ist der zu suchende Text
  • Mit einem einleitenden `

Weitere Artikel hier zu vim

Reguläre Ausdrücke (RegEx) sind DER Shit, wenn es darum geht extrem schnelle und auch sehr komplexe Dinge mit Texten bzw Strings oder einfach generell bei Suchen zu veranstalten.

Ein Anwendungsfall kommt immer wieder vor, nämlich das Suchen&Ersetzen.

Das Muster sieht so aus

:[range] s / [pattern] / [string] / [flags] [count]

[range]

  • bei range steht meist ein Prozentzeichen % das für den gesamten Text aka alles steht
  • hier können auch 1,$ = erste Zeile, erstes Zeichen bis letzte Zeile, letztes Zeichen
  • .,$ heisst von der aktuellen Zeile bis zum Ende
  • {Nummer} – in Zeile Nummer sowieso z.B. Zeile 14
  • Die Übersicht der schier unendlichen Bereichsangaben bekommst du, wenn du vim aufrufst und dann :h range eingibst

s (substitute)

  • Substitute ist die Suchen&Ersetzen Funktion. Wichtig zu wissen ist, dass alle Zeichen, die nicht in a-z und A-Z sind, müssen mit einem vorangestelltem Backslash \ “escaped” werden.
  • Also Zahlen, Punkte, Klammern und Sonderzeichen mit einem Backslash \ escaped werden.
  • Ein Backslash wird dann natürlich auch mit einem Backslash escaped \\. Und ein Slash im Suchstring wird natürlich auch mit einem Backslash escaped \/ . Auch ein Leerzeichen bzw Blank wird mit einem Backslash escaped.
  • Der Grund dafür ist, dass viele dieser Zeichen selbst eine Funktion für die Suche darstellen. Und damit da keine Verwechselung entsteht muss extra “escaped” werden.

[pattern]

  • Pattern ist der zu suchende Text
  • In einem Pattern können auch wiederum Pattern-Funktionen eingefügt werden, wie z.B. ab dem 5. Zeichen (spalte/column) %5c oder bis zum 5. Zeichen %>5c und viele weitere.
  • in vim :help pattern

[string]

  • String ist der Text, der das gesuchte Pattern ersetzt werden soll.

[flags]

  • g (global) wiederholt das Suchen&Ersetzen, bis zum Ende des Textes. Wird g nicht angegeben, wird nach dem ersten Suchtreffer aufgehört.
  • c (confirm) zum Bestätigen des Ersetzens
  • i (ignore) um Groß/Kleinschreibung zu ignorieren

[count]

  • der Parameter count wird bei Bedarf in einer positiven ganzen Zahl wie z.B. 5 angegeben. Er wirkt sich auf das Suchen&Ersetzen so aus, dass z.B.
  • %s/blah/blubb/g 5 – vom Textanfang die ersten 5 Zeilen bearbeitet werden
  • 10,$ s/blah/blubb/g 5 – ab Zeile 10, die Zeilen 10, 11, 12, 13, 14, also insgesamt 5 Zeilen bearbeitet werden.

Slash / – das Slash “/” trennt die verschiedenen Parameter voneinander.

Will ich also den merkwürdigen String “Maier/(Schmidt)-Hans\Jens.Familie?” in meinem gesamten Text mit “Bullshit!“ersetzen, sähe der Aufruf so aus

:%s/Maier\/\(Schmidt\)\-Hans\\Jens\.Familie\?/Bullshit\\!/g

Einfach vor jedes nicht a-zA-Z Zeichen ein Backslash

Views: 7

Mit dem Bookmarks Organizer 4.1 steht ein neues Update für die Firefox-Erweiterung bereit, welche beim Aufräumen der Lesezeichen hilft. Die neue Version bringt unter anderem einen sogenannten Dark Mode.

Download Bookmarks Organizer 4.1 für Mozilla Firefox

Der Bookmarks Organizer soll dabei helfen, wieder Ordnung in die Lesezeichen zu bringen, indem nicht mehr funktionierende sowie doppelte Lesezeichen gefunden und Weiterleitungen korrigiert werden.

Unterstützung für Dark Mode

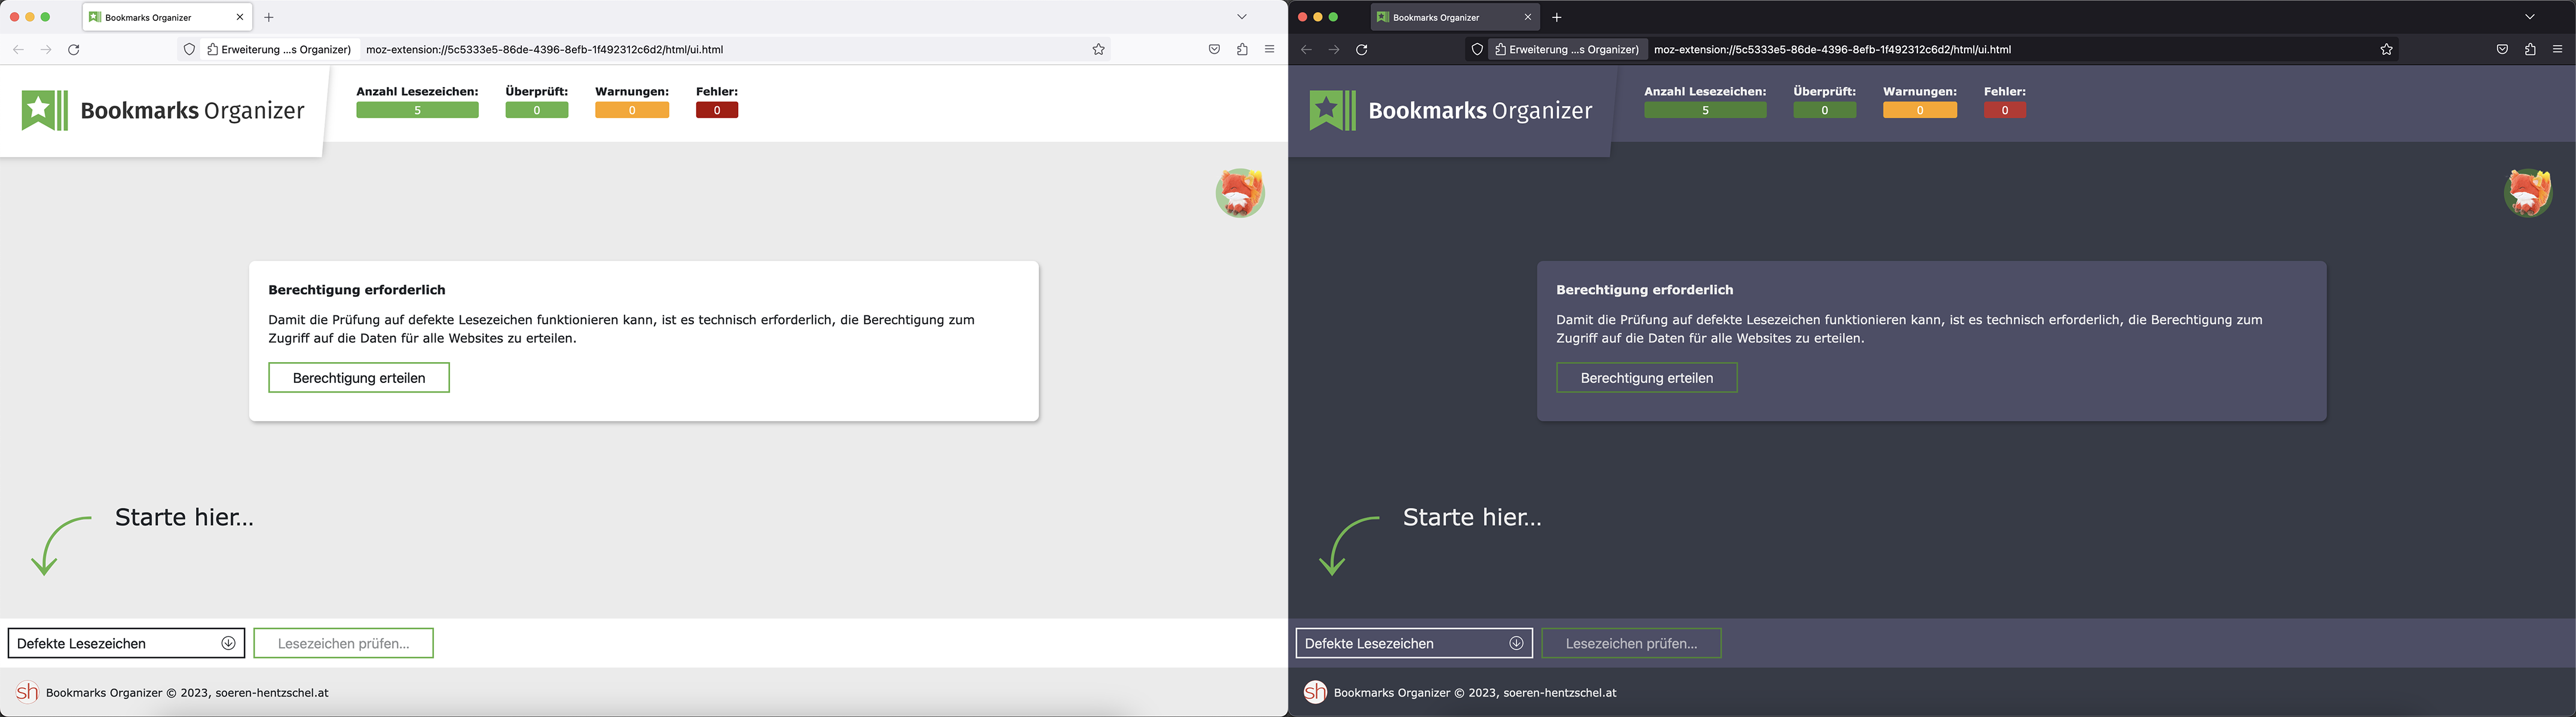
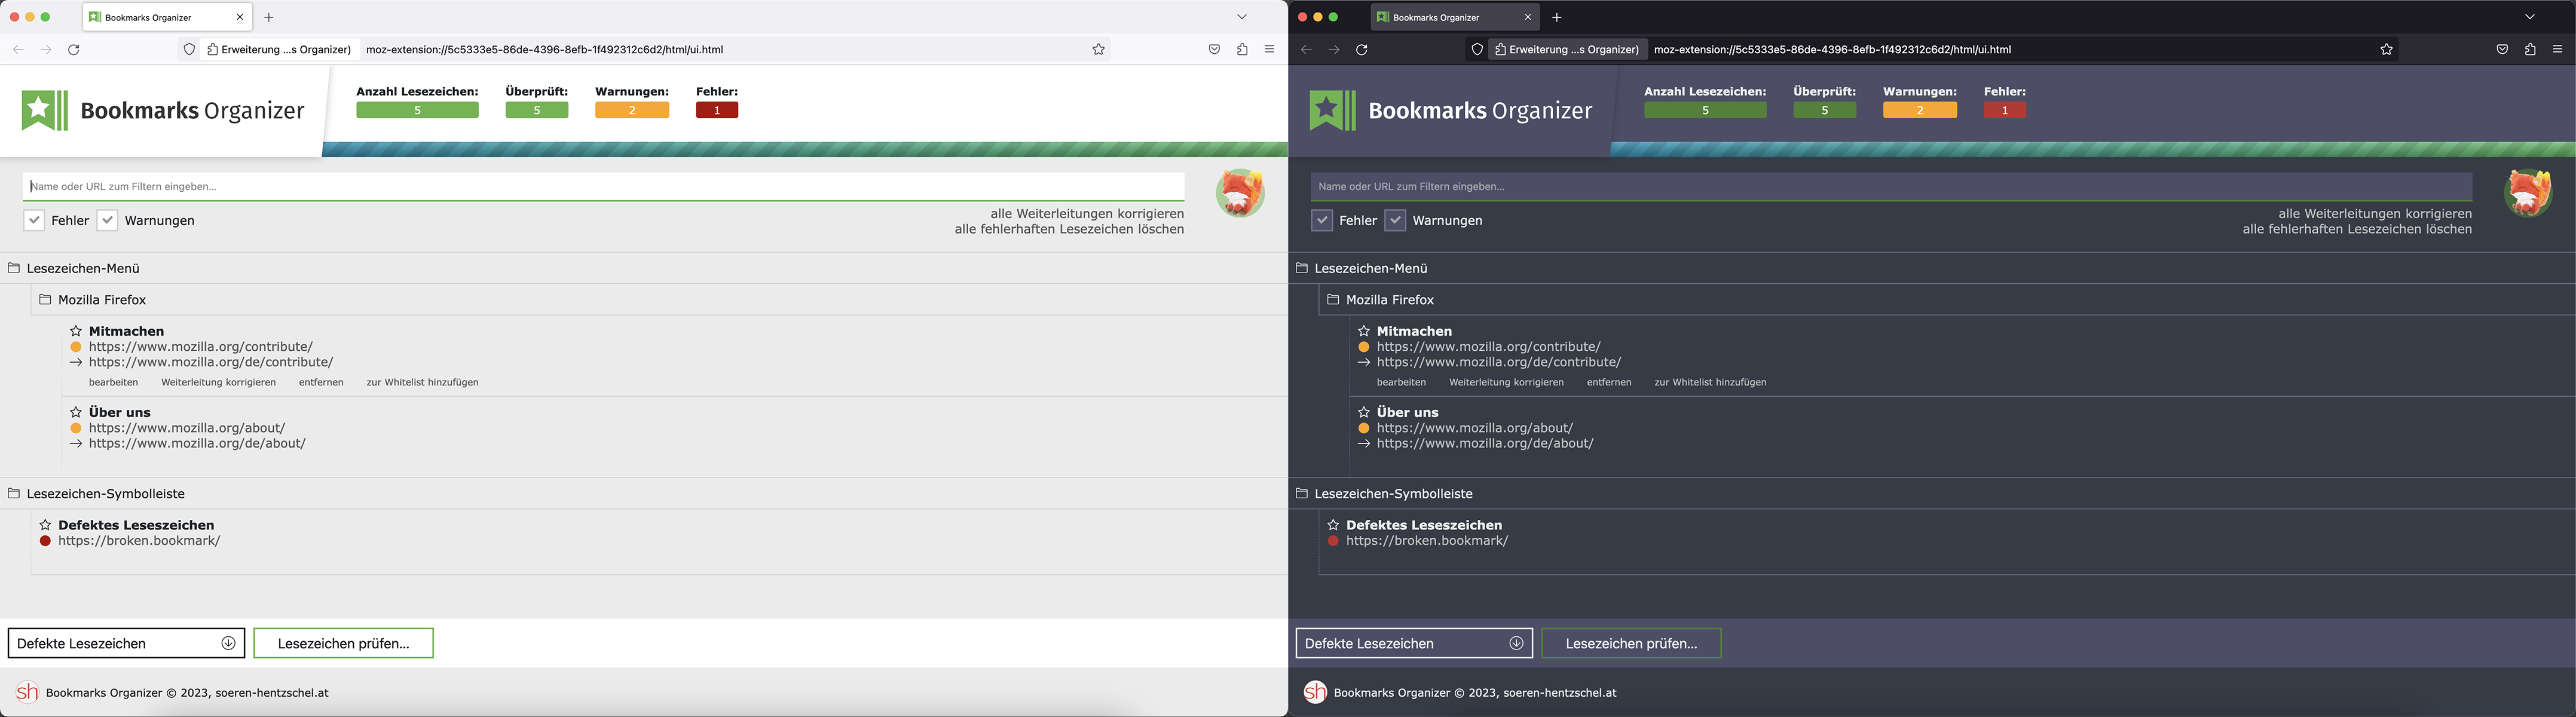
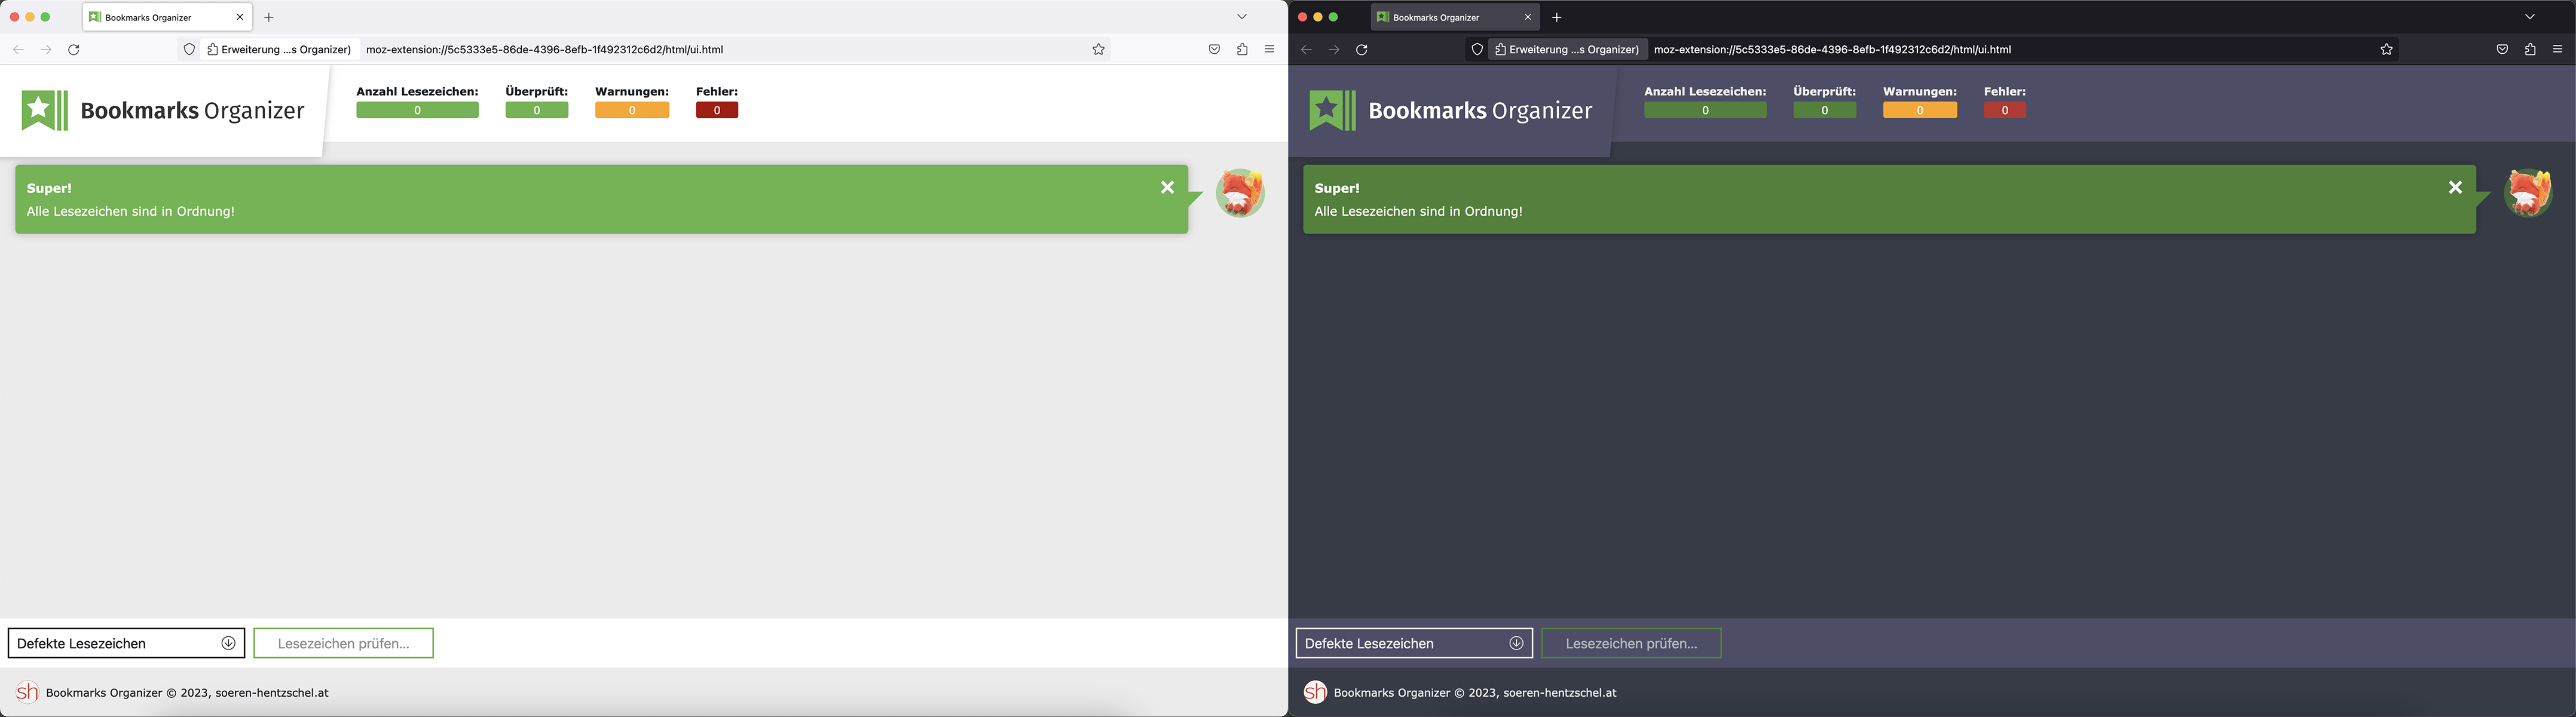
Bislang war das Erscheinungsbild vom Bookmarks Organizer immer hell, auch bei Verwendung eines dunklen Firefox-Themes. Bookmarks Organizer 4.1 bringt die Unterstützung für den sogenannten Dark Mode. Das heißt, dass auch die Oberfläche vom Bookmarks Organizer bei entsprechender Firefox-Konfiguration dunkel statt hell ist.

Bookmarks Organizer 4.1 Bookmarks Organizer 4.1 Bookmarks Organizer 4.1

Weitere Verbesserungen und Korrekturen

Die Domain facebook.com wurde auf die interne Liste von Domains hinzugefügt, welche bei der Prüfung auf defekte Lesezeichen grundsätzlich übersprungen werden, da entsprechende Lesezeichen nicht überprüft werden können und immer als fehlerhaft angezeigt worden waren.

Bestätigungsdialoge können jetzt mittels Enter-Taste bestätigt werden. Das Abbrechen via Esc-Taste war bereits möglich.

Die Ursache für einen massiven RAM-Anstieg sowie eine extrem hohe CPU-Auslastung, was sogar bis zum Absturz von Firefox führen konnte, beim Import vieler Lesezeichen wurde behoben.

Dazu kommen mehrere kleinere Code-Verbesserungen unter der Haube. Außerdem wurden sowohl die chinesische als auch die türkische Übersetzung aktualisiert.

Auf Grund erfolgter Code-Änderungen ist Bookmarks Organizer 4.1 nicht länger mit Firefox 109 bis 114 kompatibel. Neue Voraussetzung zur Installation ist Firefox 115 oder höher.

Gefällt? Unterstützung gerne gesehen!

Wer die Entwicklung des Add-ons unterstützen möchte, kann dies tun, indem er der Welt von Bookmarks Organizer erzählt und die Erweiterung auf addons.mozilla.org bewertet. Auch würde ich mich sehr über eine kleine Spende freuen, welche es mir ermöglicht, weitere Zeit in die Entwicklung dieses und weiterer Add-ons zu investieren.

Der Beitrag Firefox-Erweiterung Bookmarks Organizer 4.1 veröffentlicht erschien zuerst auf soeren-hentzschel.at.

16. August 2023

30 Jahre Debian - 30 Jahre felsenfeste Entwicklung und noch kein Ende in Sicht.

An diesem Tag vor 30 Jahren, am 16.08.1993, erschien in der Newsgroup comp.os.linux.development eine Ankündigung, die den Anfang eines der größten und langlebigsten Projekte im Linux-Ökosystem markieren sollte. Lasst uns für einen kurzen Moment zurückblicken.

Es ist nicht nur ein gepimptes SLS, es ist das "Debian Linux Release". Ian Murdock, der selbst mit der vermutlich ersten Linux-Distribution unzufrieden war und beschlossen hat, die Sache selbst in die Hand zu nehmen, hätte sich womöglich nie erträumen können, dass sein "brand-new Linux release", wie er es damals nannte, irgendwann seinen 30. Geburtstag feiern würde.

Begründer eines Distributionszweiges

Im Laufe der Jahre hat Debian bewiesen, dass es mehr als nur ein übereifriger Rebell unter den Betriebssystemen ist. Es hat die Grundlage für viele andere Distributionen wie z. B. Ubuntu gelegt. Es hat die Freiheit und Offenheit verkörpert, die das Herzstück der Open-Source-Bewegung bilden. Es hat glaubhafte Alternativen zu proprietären Betriebssystemen aufgezeigt und Zweifler zum Schweigen gebracht. Auch, wenn der letzte Punkt in der öffentlichen Diskussion nicht ganz offensichtlich ist, sprechen die Zahlen für sich: Debian ist ein fester Bestandteil vieler produktiver Serversetups.

Mit der tief verwurzelten Philosophie, die sich im Debian-Gesellschaftsvertrag widerspiegelt, unterstreicht das Projekt seine kompromisslose Haltung zugunsten freier Software, auch wenn über die Jahre insgesamt eine gewisse Toleranz gegenüber nachinstallierbarer unfreier Software Einzug gehalten hat.

Debian ist heute wichtiger denn je, da die Distribution den Test of Time bestand und sich zu einer Alternative zu Enterprise-Distributionen gemausert hat. Stabilität und Kontinuität sind entscheidende Faktoren, denn Debian baut auf klassischen Releases auf, von denen - je nach Zählweise - bereits 20 erschienen sind. Die Release werden seit Version 1.1 nach Toy-Story-Charakteren bezeichnet. Debian ist ein Leuchtturm, ein einsamer Fels in der Brandung einer Welt, die zunehmend von Anbietern dominiert wird, welche Daten und Freiheiten der Nutzer nicht beachten und sie an ihre Plattformen binden.

In diesem Sinne, lasst uns auf 30 Jahre technologischer Alternativen anstoßen. Herzlichen Glückwunsch, Debian! Auf 30 weitere Jahre der Innovation und Unabhängigkeit.

Die Personen hinter den Projekten sind wichtig.

Die GNU/Linux-Community hat heute den 30. Geburtstag der Debian-Distribution gefeiert, die am 16. August 1993 ihr Debüt gegeben hat. Alle Fachmedien haben diesen besonderen Tag ausführlich gewürdigt. Wer mehr über die Geschichte und den Jahrestag von Debian erfahren möchte, kann dies bei Linuxnews.de lesen, oder diese Suche verwenden. Ich möchte den Blick auf die Person hinter Debian lenken.

Ian Murdock starb am 28. Dezember 2015, im Alter von 42 Jahren, in San Francisco unter tragischen Umständen. Am 3. Februar hat Martin Michlmayr, der langjährige Debian Projektleiter, eine Laudatio für Ian bei der FOSDEM 2016 gehalten. Ich finde es wichtig, dass den Personen, die hinter Projekten stehen, mehr Aufmerksamkeit gegeben wird. Debian wäre eine leere Hülse, wenn sie nicht von den über Tausend Beteiligten gefüllt würde. Über die Namensgeberin und Frau von Ian Murdock, Debra Lynn, von der er 2008 geschieden wurde, ist leider wenig bekannt. Was sie über die Zeiten retten wird, ist die erste Namenshälfte von Deb+Ian.

Bildquelle: https://www.ecospoliticos.com/images/personaje/Murdock.jpg

Quelle: https://commons.wikimedia.org/wiki/File:FOSDEM_2016_Ian_Murdock_-_In_Memoriam.webm


GNU/Linux.ch ist ein Community-Projekt. Bei uns kannst du nicht nur mitlesen, sondern auch selbst aktiv werden. Wir freuen uns, wenn du mit uns über die Artikel in unseren Chat-Gruppen oder im Fediverse diskutierst. Auch du selbst kannst Autor werden. Reiche uns deinen Artikelvorschlag über das Formular auf unserer Webseite ein.

14. August 2023

Mozilla Ventures hat sein Portfolio an Investitionen weiter ausgebaut und mit Grasp in eine Online-Lernplattform aus Großbritannien investiert.

Das ist Mozilla Ventures

Mozilla Ventures ist ein anfänglich mit 35 Millionen USD ausgestatteter Risikokapitalfonds, über welchen Mozilla in Startups investiert, welche das Internet und die Tech-Industrie in eine bessere Richtung bringen.

Mozilla Ventures investiert in Grasp

Das neueste Unternehmen, in welches Mozilla Ventures investiert hat, ist Grasp. Dabei handelt es sich um eine Online-Lernplattform mit dem Ziel, die Lerngeschwindigkeit von Menschen zu erhöhen. Grasp befindet sich derzeit noch in der Betaphase, für deren Teilnahme man sich auf eine Warteliste setzen lassen kann.

Übersicht über Mozillas Investitionen und Übernahmen

Alleine in den letzten elf Monaten hat Mozilla drei Unternehmen vollständig übernommen und in zwölf weitere investiert. Auf soeren-hentzschel.at/mozilla-invests gibt es eine Übersicht über Mozillas Investitionen und Übernahmen seit 2012.

Der Beitrag Mozilla investiert in Lernplattform Grasp erschien zuerst auf soeren-hentzschel.at.

Open-Source-Software nachhaltig zu entwickeln, wird immer schwieriger. Willkommen im Zeitalter von "Nur schauen, nicht anfassen" für kommerzielle Rivalen.

Das in San Francisco ansässige Softwareunternehmen HashiCorp, bekannt für seine Cloud-Tools wie Terraform, Vagrant oder Vault, ändert seine Lizenzbedingungen. In einer Ankündigung wird der Wechsel von der Mozilla Public License 2.0 zur Business Source License mit der Gewährleistung kontinuerlicher Investitionen des Unternehmens in seine Community begründet.

HashiCorp hält weiterhin daran fest, seinen Quellcode frei verfügbar zu machen. Allerdings gibt die BSL dem Unternehmen mehr Kontrolle darüber, wer den Code kommerziell nutzen darf. Mit anderen Worten, wer Software von HashiCorp produktiv nutzt und sie für ein Konkurrenzprodukt einsetzen möchte, ist von nun an nicht nur bösen Blicken, sondern auch rechtlichen Hürden ausgesetzt.

In guter Gesellschaft

Einige Unternehmen haben diesen Schritt bereits vollzogen und sind auf unfreie Lizenzmodelle umgestiegen. Couchbase, Sentry und MariaDB MaxScale sind einige Beispiele dafür. Dies wirft natürlich die Frage auf, ob wir uns von der Idee freier Open-Source-Software verabschieden müssen. Die Omnipräsenz der Cloud-Industrie, die seit den 2010er-Jahren sich großer Beliebtheit erfreut, droht ernsthaft, die FOSS-Welt zu destabilisieren.

Stellt dir vor, du hast einen reichen Obstgarten erschaffen, in dem jeder sich frei der Früchte bedienen kann. Größzügig lädst du alle ein, sich nach Belieben zu bedienen und empfiehlst ihnen, selber Bäume zu pflanzen oder die Saaten weiterzuverbreiten. Eines Tages bemerkt ihr jedoch, dass einige Gäste die Früchte einsacken, sie auf eigenen Märkten verkaufen und die Profite einsacken, ohne selbst an die Ursprungscommunity etwas zurückzugegeben. Klingt unfair? Genau das passiert momentan in der Open-Source-Welt.

Damit wird Open Source zwar nicht von Tisch gewischt, sondern in eine Richtung gelenkt, die den freien ungehinderten Austausch unabhängig von gewerblichen Interessen einschränkt. Konkret wackelt dabei das 6. Kriterium der Open-Source-Definition (OSD), das eine Unterscheidung nach Einsatzfeldern ausschließt.

HashiCorp betont, dass es sich weiterhin seiner Community, seinen Partnern und Kunden verpflichtet sieht. Nur die Zeit wird zeigen, ob diese Lizenzänderungen die richtigen Schritte auf dem Weg dorthin sind. Einerseits werden Möglichkeiten von Forks eingeschränkt, andererseits ist niemandem geholfen, wenn die Weiterentwicklung durch HashiCorp auf dem Spiel steht, nur, weil externe Akteure bezogen auf die Einnahmen sinnbildlich das Wasser abgraben. Die Leute, die Software entwickeln, müssen auch von etwas bezahlt werden.

Edit (20:25 Uhr): MariaDB setzt die BSL für MaxScale ein, nicht jedoch für die Datenbank MariaDB Server. Danke für den Hinweis, Jens.

Update (20:30 Uhr): Ggfs. werde ich mich mit der BSL noch einmal in einem gesonderten Artikel beschäftigen, aber ein kleines Detail ist hierbei vllt. noch erwähnenswert, um den Blick auf die Sache zu ändern. Die von HashiCorp verwendete Form der BSL setzt auf eine Art Embargozeit. Nach 4 Jahren der Veröffentlichung eines nach BSL lizenzierten Werkes in einer spezifischen Version, greift folgender Passus:

Effective on the Change Date, or the fourth anniversary of the first publicly available distribution of a specific version of the Licensed Work under this License, whichever comes first, the Licensor hereby grants you rights under the terms of the Change License, and the rights granted in the paragraph above terminate.

Als Change License wurde die MPL 2.0 festgelegt.